
MYSQL80学习记录
安装和卸载
基础命令1
1.启动/停止mysql(管理员打开dos或powershow)
net start/stop mysql80(服务器名)一般手动启动mysql
quit(退出登录)
exit2.mysql登录账号
mysql -h 主机名 -P 端口号 -u 用户名 -p密码 u=username用户名
p=password密码
P=port端口号
h=localhost主机名
注意:
(1)-p与密码之间不能有空格,其他参数名与参数值之间可以有空格也可以没有空格。如:
mysql -hlocalhost -P3306 -uroot -pabc123(2)密码建议在下一行输入,保证安全
mysql -h localhost -P 3306 -u root -p
Enter password:****(3)客户端和服务器在同一台机器上,所以输入localhost或者IP地址127.0.0.1。同时,因为是连接本 机: -hlocalhost就可以省略,如果端口号没有修改:-P3306也可以省略 简写成:
mysql -u root -p
Enter password:****连接成功后,有关于MySQL Server服务版本的信息,还有第几次连接的id标识。 也可以在命令行通过以下方式获取MySQL Server服务版本的信息:
3.查看MySQL的版本
mysql --version
mysql -V(大写)或登录后,通过以下方式查看当前版本信息:
mysql> select version();4.查看所有数据库
show databases;“information_schema”是 MySQL 系统自带的数据库,主要保存 MySQL 数据库服务器的系统信息, 比如数据库的名称、数据表的名称、字段名称、存取权限、数据文件 所在的文件夹和系统使用的 文件夹,等等
“performance_schema”是 MySQL 系统自带的数据库,可以用来监控 MySQL 的各类性能指标。
“sys”数据库是 MySQL 系统自带的数据库,主要作用是以一种更容易被理解的方式展示 MySQL 数据 库服务器的各类性能指标,帮助系统管理员和开发人员监控 MySQL 的技术性能。
“mysql”数据库保存了 MySQL 数据库服务器运行时需要的系统信息,比如数据文件夹、当前使用的 字符集、约束检查信息,等等
5.创建数据库/表
create database 数据库名; 创建表格
create table 表名称(
字段名 数据类型,
字段名 数据类型
); 说明:如果是最后一个字段,后面就用加逗号,因为逗号的作用是分割每个字段。
#创建学生表
create table student(
id int,
name varchar(20) #说名字最长不超过20个字符
);use 数据库名;
use 数据库名;6.查看某个库的所有表格/查看一个表的数据
show tables from 数据库名;//查看某个库的所有表格
select * from 表名;//要事先use 数据库名;7.添加一条记录
insert into 表名 values (值列表),(值列表)...;8.查看表/库的创建信息
show create table/database 表名称/库名称\G9.删除数据库/表格
drop database 数据库名/表名;有一个疑问就是:某个数据库名可能与某个表格名重名,那么
10.查看编码
show variables like 'char_%';
show variables like 'character_%';
show variables like 'collation_%';select语句
1.SELECT....
select ....;#(没有任何子句)2.SELECT...FROM ...
SELECT 标识选择哪些列
FROM 标识从哪个表中选择*表示所有列(实际不建议使用,正常数据库列很多)
3.列的别名(AS)
紧跟列名,也可以在列名和别名之间加入关键字AS,别名使用双引号,以便在别名中包含空格或特 殊的字符并区分大小写。
AS 可以省略 建议别名简短,见名知意
#例
select killname as name,/*列名和别名之间加入关键字AS*/
uid id,/*紧跟列名*/
last_name "name"
from kills;4.去除重复行
默认情况下,查询会返回全部行,包括重复行。
在SELECT语句中使用关键字DISTINCT去除重复行
select distinct uid from kills; 注意:
SELECT DISTINCT department_id,salary
FROM employees;DISTINCT 其实是对后面所有列名的组合进行去重,你能看到最后的结果是 74 条,因为这 74 个部 门id不同,都有 salary 这个属性值。如果你想要看都有哪些不同的部门(department_id)
5. 空值参与运算
所有运算符或列值遇到null值,运算的结果都为null
在 MySQL 里面, 空值不等于空字符串。一个空字符串的长度是 0,而一个空值的长 度是空。而且,在 MySQL 里面,空值是占用空间的。
SELECT employee_id,salary,commission_pct,
12 * salary * (1 + commission_pct) "annual_sal"
FROM employees;#值为null6.关键字和自己命名一样用单引号‘’
#例kill是数据库的关键字
select order from kill;/*报语法错误*/
#例
select order from `kill`;/*对的*/要保证表中的字段、表名等没有和保留字、数据库系统或常用方法冲突。如果真的相同,请在 SQL语句中使用一对``(着重号)引起来。
7.显示表的结构
使用DESCRIBE 或 DESC 命令,表示表结构。
describe 表名;
或
desc 表名;其中,各个字段的含义分别解释如下:
Field:表示字段名称。
Type:表示字段类型,这里 barcode、goodsname 是文本型的,price 是整数类型的。
Null:表示该列是否可以存储NULL值。
Key:表示该列是否已编制索引。PRI表示该列是表主键的一部分;UNI表示该列是UNIQUE索引的一 部分;MUL表示在列中某个给定值允许出现多次。
Default:表示该列是否有默认值,如果有,那么值是多少。
Extra:表示可以获取的与给定列有关的附加信息,例如AUTO_INCREMENT等。
where过滤语句的应用
select 列名,...
from 表名
where 过滤子句;
#例
SELECT employee_id, last_name, job_id, department_id
FROM employees
WHERE department_id = 90 ;运算符(接where语句后)
一、比较运算符(最基础)
| 运算符 | 描述 | 示例 |
|---|---|---|
= |
等于 | WHERE age = 25 |
<> 或 != |
不等于 | WHERE status <> 1 |
> |
大于 | WHERE price > 100 |
< |
小于 | WHERE score < 60 |
>= |
大于等于 | WHERE quantity >= 10 |
<= |
小于等于 | WHERE age <= 18 |
二、范围运算符
| 运算符 | 描述 | 示例 |
|---|---|---|
BETWEEN...AND |
在范围内(包含边界) | WHERE age BETWEEN 18 AND 30 |
NOT BETWEEN |
不在范围内 | WHERE price NOT BETWEEN 50 AND 100 |
三、集合运算符
| 运算符 | 描述 | 示例 |
|---|---|---|
IN |
在指定值列表中 | WHERE id IN (1, 3, 5) |
NOT IN |
不在指定值列表中 | WHERE status NOT IN (0, 9) |
四、模糊匹配运算符
| 运算符 | 描述 | 示例 |
|---|---|---|
LIKE |
模式匹配 | WHERE name LIKE '张%' |
NOT LIKE |
不匹配模式 | WHERE email NOT LIKE '%@test.com' |
REGEXP 或 RLIKE |
正则表达式匹配 | WHERE name REGEXP '^[A-Z]' |
五、空值判断运算符
| 运算符 | 描述 | 示例 |
|---|---|---|
IS NULL |
是空值 | WHERE phone IS NULL |
IS NOT NULL |
不是空值 | WHERE email IS NOT NULL |
六、逻辑运算符(组合条件)
| 运算符 | 描述 | 示例 |
|---|---|---|
AND |
逻辑与 | WHERE age > 18 AND status = 1 |
OR |
逻辑或 | WHERE score >= 90 OR vip = 1 |
NOT |
逻辑非 | WHERE NOT deleted = 1 |
七、特殊运算符
| 运算符 | 描述 | 示例 |
|---|---|---|
<=> |
NULL安全的等于 | WHERE name <=> NULL |
XOR |
逻辑异或 | WHERE gender = 'M' XOR age < 20 |
八、JSON运算符(MySQL 5.7+)
| 运算符 | 描述 | 示例 |
|---|---|---|
-> |
JSON路径取值 | WHERE json_col->'$.name' = 'John' |
->> |
JSON路径取值(去除引号) | WHERE json_col->>'$.age' > 20 |
排序和分页
1.1单列排序
使用 ORDER BY 子句排序
ASC(ascend): 升序 (默认)
DESC(descend):降序
ORDER BY 子句在SELECT语句的结尾。
selcet last_name name ,uid
from student
order by uid asc;
/*查询列last_name 别名name 从student表,根据uid升序排序*/1.2多列排序
在order by 后用逗号隔开
# order by +属性+后面不写默认为升序
select device_id,gpa,age from user_profile order by gpa desc,age desc;# 这样才能让两个都降序
order by gpa,age desc; # 这里的代码跑出来的结果翻译应该是:gpa默认升序,age降序 所以不对select last_name,id ,uid
from student
order by id,uid desc;
/*第一列的last_name若都唯一则排不了序;
排序优先级为id,uid(根据书写的前后排)
*/2.分页或限制返回数量
背景1:查询返回的记录太多了,查看起来很不方便,怎么样能够实现分页查询呢?
背景2:表里有 4 条数据,我们只想要显示第 2、3 条数据怎么办呢?
语法
select * from 表名 limit startIndex,pageSize;
select * from 表名 limit pageSize;#(默认从第一条开始,即索引为0开始)--前10条记录:
SELECT * FROM 表名 LIMIT 0,10;
或者
SELECT * FROM 表名 LIMIT 10;
--第11至20条记录:
SELECT * FROM 表名 LIMIT 10,10;
--第21至30条记录:
SELECT * FROM 表名 LIMIT 20,10;
*分页显式公式:(当前页数-1)每页条数,每页条数
SELECT * FROM table
LIMIT(PageNo - 1)*PageSize,PageSize;在不同的 DBMS 中使用的关键字可能不同。在 MySQL、PostgreSQL、MariaDB 和 SQLite 中使用 LIMIT 关 键字,而且需要放到 SELECT 语句的最后面。
如果是 SQL Server 和 Access,需要使用 TOP 关键字,比如:
SELECT TOP 5 name, hp_max FROM heros ORDER BY hp_max DESC如果是 DB2,使用 FETCH FIRST 5 ROWS ONLY 这样的关键字:
SELECT name, hp_max FROM heros ORDER BY hp_max DESC FETCH FIRST 5 ROWS ONLY如果是 Oracle,你需要基于 ROWNUM 来统计行数:
SELECT rownum,last_name,salary FROM employees WHERE rownum < 5 ORDER BY salary DESC;多表查询
概念:
多表查询,也称为关联查询,指两个或更多个表一起完成查询操作。
前提条件:这些一起查询的表之间是有关系的(一对一、一对多),它们之间一定是有关联字段,这个 关联字段可能建立了外键,也可能没有建立外键。
比如:员工表和部门表,这两个表依靠“部门编号”进 行关联。
即员工表中有部门编号,部门表有部门编号,
#例(错误的):查询员工的姓名及其部门名称
select last_name ,department_id
from employees, departments;笛卡尔积错误。
SQL92中,笛卡尔积也称为 交叉连接 ,英文是 CROSS JOIN 。在 SQL99 中也是使用 CROSS JOIN表示交 叉连接。它的作用就是可以把任意表进行连接,即使这两张表不相关。在MySQL中如下情况会出现笛卡 尔积:
笛卡尔积的错误会在下面条件下产生:
1.省略多个表的连接条件(或关联条件)
2.连接条件(或关联条件)无效
3.所有表中的所有行互相连接
为了避免笛卡尔积, 可以在 WHERE 加入有效的连接条件。
加入连接条件后,查询语法:
SELECT table1.column, table2.column
FROM table1, table2
WHERE table1.column1 = table2.column2; #连接条件在 WHERE子句中写入连接条件。
在表中有相同列时,在列名之前加上表名前缀。
select 别名1.column,别名2.column
from table1 别名1,table2 别名2
where 别名1.column = 别名2.column2;
/*否则系统分辨不出是谁的列*/扩展1:区分重复的列名
多个表中有相同列时,必须在列名之前加上表名前缀。
在不同表中具有相同 列名的列可以用 表名 加以区分。可以加e.departments_id这不是单引号
select student.last_name,departments.name,employees.departments_id
from stduent,emlpoyees,department
where student.`departments_id`=employees.`departments_id`;
/*查找学生表的last_name ,部门表的name,员工表的员工id 当学生表的departments_id和员工表的departments_id相等时*/扩展2:表的别名
使用别名可以简化查询。
列名前使用表名前缀可以提高查询效率。
/*学生表别名s,部门表别名d,员工表别名e*/
select s.last_name,d.name,e.departments_id
from stduent s,emlpoyees e,department d
where student.departments_id=employees.departments_id;
/*查找学生表的last_name ,部门表的name,员工表的员工id 当学生表的departments_id和员工表的departments_id相等时*/【 强制 】对于数据库中表记录的查询和变更,只要涉及多个表,都需要在列名前加表的别名(或 表名)进行限定。
说明 :对多表进行查询记录、更新记录、删除记录时,如果对操作列没有限定表的别名(或表 名),并且操作列在多个表中存在时,就会抛异常。
正例 :select t1.name from table_first as t1 , table_second as t2 where t1.id=t2.id;
反例 :在某业务中,由于多表关联查询语句没有加表的别名(或表名)的限制,正常运行两年 后,最近在 某个表中增加一个同名字段,在预发布环境做数据库变更后,线上查询语句出现出 1052 异常:Column 'name' in field list is ambiguous。
扩展3:连接多个表
总结:连接 n个表,至少需要n-1个连接条件。比如,连接三个表,至少需要两个连接条件。
/*查找两个部门中的关系,用where子句筛选条件,n=2,连接条件为2-1=1*/where不同子句类型
等值连接 vs 非等值连接
等值连接:等于号
非等值连接:非等于号的where语句
自连接 vs 非自连接
自连接:例:主管是员工,普通员工也是员工。都有员工编号,同时员工有主管编号
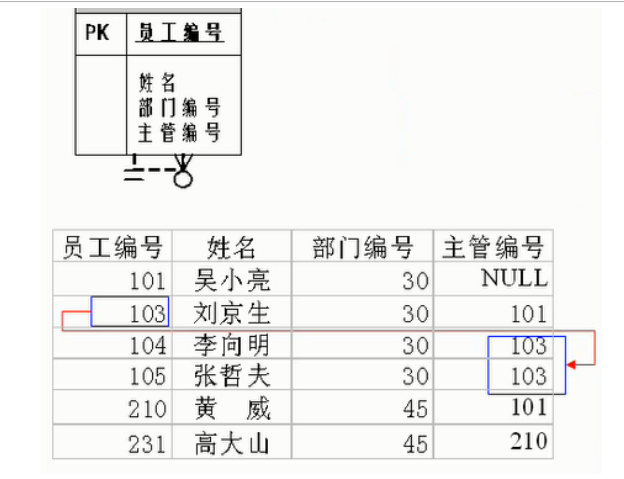
#练习:查询员工id,员工姓名及其管理者的id和姓名
SELECT emp.employee_id,emp.last_name,mgr.employee_id,mgr.last_name
FROM employees emp ,employees mgr
WHERE emp.`manager_id` = mgr.`employee_id`;
内连接(INNER JOIN) vs 外连接(OUTER JOIN)
内连接:
合并具有同一列的两个以上的表的行, 结果集中只包含一个表与另一个表匹配的行
平常使用的即内连接
如显示uid=id的列
where student.id =departments.uid;外连接:
合并具有同一列的两个以上的表的行, 结果集中除了包含一个表与另一个表匹配的行之外,
还查询到了左表 或 右表中不匹配的行。
SQL92:使用(+)创建外连接
1.在 SQL92 中采用(+)代表从表所在的位置。即左或右外连接中,(+) 表示哪个是从表。
2.Oracle 对 SQL92 支持较好,而 MySQL 则不支持 SQL92 的外连接。
3.而且在 SQL92 中,只有左外连接和右外连接,没有满(或全)外连接。
#左外连接
SELECT last_name,department_name
FROM employees ,departments
WHERE employees.department_id = departments.department_id(+);
#右外连接
SELECT last_name,department_name
FROM employees ,departments
WHERE employees.department_id(+) = departments.department_idSQL99语法实现多表查询
使用JOIN...ON子句创建连接的语法结构:
SELECT table1.column, table2.column,table3.column
FROM table1
JOIN table2 ON table1 和 table2 的连接条件
JOIN table3 ON table2 和 table3 的连接条件语法说明:
●可以使用 ON 子句指定额外的连接条件。
●这个连接条件是与其它条件分开的。
●ON 子句使语句具有更高的易读性。
●关键字 JOIN、INNER JOIN、CROSS JOIN 的含义是一样的,都表示内连接
内连接(INNER JOIN)的实现
SELECT 字段列表
FROM A表 INNER JOIN B表
ON 关联条件
WHERE 等其他子句外连接(OUTER JOIN)的实现
左外连接(LEFT OUTER JOIN)
#实现查询结果是A
SELECT 字段列表
FROM A表 LEFT JOIN B表
ON 关联条件
WHERE 等其他子句;右外连接(RIGHT OUTER JOIN)
#实现查询结果是B
SELECT 字段列表
FROM A表 RIGHT JOIN B表
ON 关联条件
WHERE 等其他子句;需要注意的是,LEFT JOIN 和 RIGHT JOIN 只存在于 SQL99 及以后的标准中,在 SQL92 中不存在, 只能用 (+) 表示。
满外连接(FULL OUTER JOIN)
●满外连接的结果 = 左右表匹配的数据 + 左表没有匹配到的数据 + 右表没有匹配到的数据。
●SQL99是支持满外连接的。使用FULL JOIN 或 FULL OUTER JOIN来实现。
●需要注意的是,MySQL不支持FULL JOIN,但是可以用 LEFT JOIN UNION RIGHT join代替。
UNION的使用
合并查询结果
利用UNION关键字,可以给出多条SELECT语句,并将它们的结果组合成单个结果集。
合并 时,两个表对应的列数和数据类型必须相同,并且相互对应。
各个SELECT语句之间使用UNION或UNION ALL关键字分隔。
SELECT column,... FROM table1
UNION [ALL]
SELECT column,... FROM table2union和 union all的区别
1.union 返回并集,去重
2.union all 返回并集,不去重
注意:执行UNION ALL语句时所需要的资源比UNION语句少。如果明确知道合并数据后的结果数据 不存在重复数据,或者不需要去除重复的数据,则尽量使用UNION ALL语句,以提高数据查询的效 率。
7种SQL JOINS的实现
交集(A*B),并集,左外连接,右外连接,A - A∩B,B-A∩B
,1-AB
交集(内连接):
语法:
select <select_list>
from tableA A inner join tableB B#inner join 与join与cross join等价
on A.key = B.key并集(满外连接)
语法:
select <select_list>
from TableA A full outer join TableB B
on A.key = B.key;左外连接(左外就是左边第一个表,写的第一个表)
语法
select <select_list>
from TableA A left join TableB B
on A.key = B.key;右外连接
语法
select <select_list>
from TableA A right join TableB B
on A.key = B.key;A - A∩B(在左外连接上加右表为空)
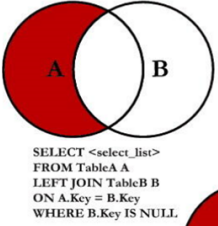
语法
select <select_list>
from TableA A left join TableB B
on A.key = B.key;
where B.key is null;B-A∩B(在右外连接上加左表为空)
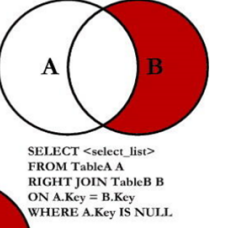
语法
select <select_list>
from TableA A right join TableB B
on A.key = B.key;
where A.key is null;1-AB
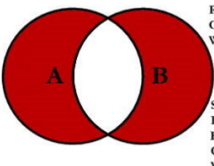
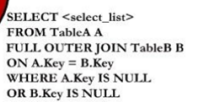
语法
select <select_list>
from TableA A full outer join TableB B
on A.key = B.key;
where A.key is null
or B.key is null;SQL99语法新特性
自然连接
SQL99 在 SQL92 的基础上提供了一些特殊语法,比如 NATURAL JOIN 用来表示自然连接。
我们可以把 自然连接理解为 SQL92 中的等值连接。它会帮你自动查询两张连接表中 所有相同的字段 ,然后进行 等值 连接 。
在SQL92标准中:
SELECT employee_id,last_name,department_name
FROM employees e JOIN departments d
ON e.`department_id` = d.`department_id`
AND e.`manager_id` = d.`manager_id`;在 SQL99 中你可以写成:
SELECT employee_id,last_name,department_name
FROM employees e NATURAL JOIN departments d;select <select_list>
from TableA A natural join TableB BUSING连接
当我们进行连接的时候,SQL99还支持使用 USING 指定数据表里的 同名字段 进行等值连接。
但是只能配 合JOIN一起使用。比如:
SELECT employee_id,last_name,department_name
FROM employees e JOIN departments d
USING (department_id);你能看出与自然连接 NATURAL JOIN 不同的是,USING 指定了具体的相同的字段名称,你需要在 USING 的括号 () 中填入要指定的同名字段。同时使用 JOIN...USING 可以简化 JOIN ON 的等值连接。它与下 面的 SQL 查询结果是相同的:
SELECT employee_id,last_name,department_name
FROM employees e ,departments d
WHERE e.department_id = d.department_id;
SELECT employee_id,last_name,department_name
FROM employees e ,departments d
on (department_id = d.department_id);表连接的约束条件可以有三种方式:WHERE, ON, USING
WHERE:适用于所有关联查询
ON :只能和JOIN一起使用,只能写关联条件。虽然关联条件可以并到WHERE中和其他条件一起 写,但分开写可读性更好。
USING:只能和JOIN一起使用,而且要求两个关联字段在关联表中名称一致,而且只能表示关联字 段值相等
#关联条件
#把关联条件写在where后面
SELECT last_name,department_name
FROM employees,departments
WHERE employees.department_id = departments.department_id;
#把关联条件写在on后面,只能和JOIN一起使用
SELECT last_name,department_name
FROM employees INNER JOIN departments
ON employees.department_id = departments.department_id;
SELECT last_name,department_name
FROM employees CROSS JOIN departments
ON employees.department_id = departments.department_id;
SELECT last_name,department_name
FROM employees JOIN departments
ON employees.department_id = departments.department_id;
#把关联字段写在using()中,只能和JOIN一起使用
#而且两个表中的关联字段必须名称相同,而且只能表示=
#查询员工姓名与基本工资
SELECT last_name,job_title
FROM employees INNER JOIN jobs USING(job_id);
#n张表关联,需要n-1个关联条件
#查询员工姓名,基本工资,部门名称
SELECT last_name,job_title,department_name
FROM employees,departments,jobs
WHERE employees.department_id = departments.department_id
AND employees.job_id = jobs.job_id;
SELECT last_name,job_title,department_name
FROM employees INNER JOIN departments INNER JOIN jobs
ON employees.department_id = departments.department_id
AND employees.job_id = jobs.job_id;我们要 控制连接表的数量 。多表连接就相当于嵌套 for 循环一样,非常消耗资源,会让 SQL 查询性能下 降得很严重,因此不要连接不必要的表。在许多 DBMS 中,也都会有最大连接表的限制。
【强制】超过三个表禁止 join。需要 join 的字段,数据类型保持绝对一致;多表关联查询时, 保 证被关联的字段需要有索引。 说明:即使双表 join 也要注意表索引、SQL 性能。
SQL92 和 SQL99 是经典的 SQL 标准,也分别叫做 SQL-2 和 SQL-3 标准。也正是在这两个标准发布之 后,SQL 影响力越来越大,甚至超越了数据库领域。现如今 SQL 已经不仅仅是数据库领域的主流语言, 还是信息领域中信息处理的主流语言。在图形检索、图像检索以及语音检索中都能看到 SQL 语言的使 用。
函数
1.单行函数:
●操作数据对象
●接受参数返回一个结果
●只对一行进行变换
●每行返回一个结果
● 可以嵌套
●参数可以是一列或一个值
1.1基本数值函数
| 函数名 | 功能 |
|---|---|
| abs(x) | 返回x的绝对值 |
| sign(x) | 返回X的符号。正数返回1,负数返回-1,0返回0 |
| pi() | 返回圆周率的值 |
| ceil(x),ceiling(x) | 返回大于或等于某个值的最小整数 |
| floor(x) | 返回小于或等于某个值的最大整数 |
| least(e1,e2,e3,.....) | 返回列表中的最小值 |
| greatest(e1,e2,e3,.....) | 返回列表中的最大值 |
| mod(x,y) | 返回X除以Y后的余数 |
| x mod y | 返回X除以Y后的余数 |
| x % y | 返回X除以Y后的余数 |
| rand() | 返回0~1的随机值 |
| rand(x) | 返回0~1的随机值,其中x的值用作种子值,相同的X值会产生相同的随机 数 |
| round(x) | 返回一个对x的值进行四舍五入后,最接近于X的整数 |
| round(x,y) | 返回一个对x的值进行四舍五入后最接近X的值,并保留到小数点后面Y位 |
| truncate(x,y) | 返回数字x截断为y位小数的结果 |
| sqrt(x) | 返回x的平方根。当X的值为负数时,返回NULL |
| radians(x) | 将角度转化为弧度,其中,参数x为角度值 |
| degrees(x) | 将弧度转化为角度,其中,参数x为弧度值 |
SELECT
ABS(-123),ABS(32),SIGN(-23),SIGN(43),PI(),CEIL(32.32),CEILING(-43.23),FLOOR(32.32),
FLOOR(-43.23),MOD(12,5)
FROM DUAL;
mysql文档中对于dual表的解释:
You are allowed to specify DUAL as a dummy table name in situations where no tables are referenced: 你可以在没有表的情况下指定一个虚拟的表名 mysql> SELECT 1 + 1 FROM DUAL; -> 2 DUAL is purely for the convenience of people who require that all SELECT statements should have FROM and possibly other clauses. MySQL may ignore the clauses. MySQL does not require FROM DUAL if no tables are referenced. DUAL是为了方便那些要求所有SELECT语句都应该具有FROM和其他子句的人。MySQL可能会忽略该条款。如果没有引用表,MySQL不需要从DUAL。
1.2三角函数
| 函数 | 用法 |
|---|---|
| SIN(x) | 返回x的正弦值,其中,参数x为弧度值 |
| ASIN(x) | 返回x的反正弦值,即获取正弦为x的值。如果x的值不在-1到1之间,则返回NULL |
| COS(x) | 返回x的余弦值,其中,参数x为弧度值 ACOS(x) 返回x的反余弦值,即获取余弦为x的值。如果x的值不在-1到1之间,则返回NULL |
| TAN(x) | 返回x的正切值,其中,参数x为弧度值 |
| ATAN(x) | 返回x的反正切值,即返回正切值为x的值 |
| ATAN2(m,n) | 返回两个参数的反正切值 |
| COT(x) | 返回x的余切值,其中,X为弧度值 |
| POW(x,y),POWER(X,Y) | 返回x的y次方 |
| EXP(X) | 返回e的X次方,其中e是一个常数,2.71828182845904 |
| LN(X),LOG(X) | 返回以e为底的X的对数,当X <= 0 时,返回的结果为NUL |
| LOG10(X) | 返回以10为底的X的对数,当X <= 0 时,返回的结果为NULL |
| LOG2(X) | 返回以2为底的X的对数,当X <= 0 时,返回NULL |
1.3进制间的转换
| 函数 | 用法 |
|---|---|
| BIN(x) | 返回x的二进制编码 |
| HEX(x) | 返回x的十六进制编码 |
| OCT(x) | 返回x的八进制编码 |
| CONV(x,f1,f2) | 返回f1进制数变成f2进制,x为f1的进制形式 |
1.4字符串函数
| 函数 | 用法 |
|---|---|
| ascll(s) | 返回字符串S中的第一个字符的ASCII码值 |
| char_length(s) | 返回字符串s的字符数。作用与CHARACTER_LENGTH(s)相同 |
| length(s) | 返回字符串s的字节数,和字符集有关 |
| concat(s1,s2,s3,....) | 连接s1,s2,......,sn为一个字符串 |
| concat_ws(x, s1,s2,......,sn) | 同CONCAT(s1,s2,...)函数,但是每个字符串之间要加上x |
| insert(str,idx,len,replacestr) | 将字符串str从第idx位置开始,len个字符长的子串替换为字符串replacestr |
| replace(str,a,b) | 用字符串b替换字符串str中所有出现的字符串a |
| upper(s)或ucase(s) | 将字符串s的所有字母转成大写字母 |
| lower(s)或lcase(s) | 将字符串s的所有字母转成小写字母 |
| left(str,n) | 返回字符串str最左边的n个字符 |
| right(str,n) | 返回字符串str最右边的n个字符 |
| lpad(str,len,pad) | 用字符串pad对str最左边进行填充,直到str的长度为len个字符 |
| rpad(str,len,pad) | 用字符串pad对str最右边进行填充,直到str的长度为len个字符 |
| ltrim(s) | 去掉字符串s左侧的空格 |
| rtrim(s) | 去掉字符串s右侧的空格 |
| trim(s) | 去掉字符串s开始与结尾的空格 |
| trim(s1 from s) | 去掉字符串s开始与结尾的s1 |
| trim(leading s1 from s) | 去掉字符串s开始处的s1 |
| trim(reailing s1 from s) | 去掉字符串s结尾处的s1 |
| repeat(str,n) | 返回str重复n次的结果 |
| space(n) | 返回n个空格 |
| strcmp(s1,s2) | 比较字符串s1,s2的ASCII码值的大小 |
| substr(s,index,len) | 返回从字符串s的index位置其len个字符,作用与SUBSTRING(s,n,len)、 MID(s,n,len)相同 |
| locate(substr,str) | 返回字符串substr在字符串str中首次出现的位置,作用于POSITION(substr IN str)、INSTR(str,substr)相同。未找到,返回0 |
| elt(m,s1,s2,…,sn) | 返回指定位置的字符串,如果m=1,则返回s1,如果m=2,则返回s2,如 果m=n,则返回sn |
| field(s,s1,s2,....,sn) | 返回字符串s在字符串列表中第一次出现的位置 |
| find_in_set(s1,s2) | 返回字符串s1在字符串s2中出现的位置。其中,字符串s2是一个以逗号分 隔的字符串 |
| reverse(s) | 返回s反转后的字符串 |
| nullif(value1,value2) | 比较两个字符串,如果value1与value2相等,则返回NULL,否则返回 value1 |
注意:MySQL中,字符串的位置是从1开始的。
1.5日期和时间函数
| 函数 | 用法 |
|---|---|
| curdate(),current_date() | 返回当前日期,只包含年、 月、日 |
| curtime(),current_time() | 返回当前时间,只包含时、 分、秒 |
| now()/sysdate()/current_timestamp()/localtime()/localtimestamp() | 返回当前系统日期和时间 |
| utc_date() | 返回UTC(世界标准时间) 日期 |
| utc_time | 返回UTC(世界标准时间) 时间 |
日期与时间戳的转换
| 函数 | 用法 |
|---|---|
| unix_timestamp() | 以UNIX时间戳的形式返回当前时间。SELECT UNIX_TIMESTAMP() - >1634348884 |
| unix_timestamp(date) | 将时间date以UNIX时间戳的形式返回。 |
| from_unixtime(timestamp) | 将UNIX时间戳的时间转换为普通格式的时间 |
mysql> SELECT UNIX_TIMESTAMP(now());
+-----------------------+
| UNIX_TIMESTAMP(now()) |
+-----------------------+
| 1576380910 |
+-----------------------+
1 row in set (0.01 sec)
mysql> SELECT UNIX_TIMESTAMP(CURDATE());
+---------------------------+
| UNIX_TIMESTAMP(CURDATE()) |
+---------------------------+
| 1576339200 |
+---------------------------+
1 row in set (0.00 sec)
mysql> SELECT UNIX_TIMESTAMP(CURTIME());
+---------------------------+
| UNIX_TIMESTAMP(CURTIME()) |
+---------------------------+
| 1576380969 |
+---------------------------+
1 row in set (0.00 sec)
mysql> SELECT UNIX_TIMESTAMP('2011-11-11 11:11:11')
+---------------------------------------+
| UNIX_TIMESTAMP('2011-11-11 11:11:11') |
+---------------------------------------+
| 1320981071 |
+---------------------------------------+
1 row in set (0.00 sec)
| FROM_UNIXTIME(1576380910) |
+---------------------------+
| 2019-12-15 11:35:10 |
+---------------------------+
1 row in set (0.00 sec)什么是[时间戳]
一个能表示一份数据在某个特定时间之前已经存在的、 完整的、 可验证的数据,通常是一个字符序列,唯一地标识某一刻的时间。
时间戳有什么用;
一般啊,在互联网公司都会在项目种使用时间戳,时间戳主要用于清理缓存,大多数用于版本更新;
获取月份、星期、星期数、天数等函数
| 函数 | 用法 |
|---|---|
| year(date)/month(date)/day(date) | 返回具体的日期值 |
| hour(time)/minute(time)/second(time) | 返回具体的时间值 |
| monthname(date) | 返回月份:January,... |
| dayname(date) | 返回星期几:MONDAY,TUESDAY.....SUNDAY |
| weekday(date) | 返回周几,注意,周1是0,周2是1,。。。周日是6 |
| quarter(date) | 返回日期对应的季度,范围为1~4 |
| week(date),weekofyear(date) | 返回一年中的第几周 |
| dayofyear(date) | 返回日期是一年中的第几天 |
| dayofmonth(date) | 返回日期位于所在月份的第几 |
| dayofweek(date) | 返回周几,注意:周日是1,周一是2,。。。周六是 7 |
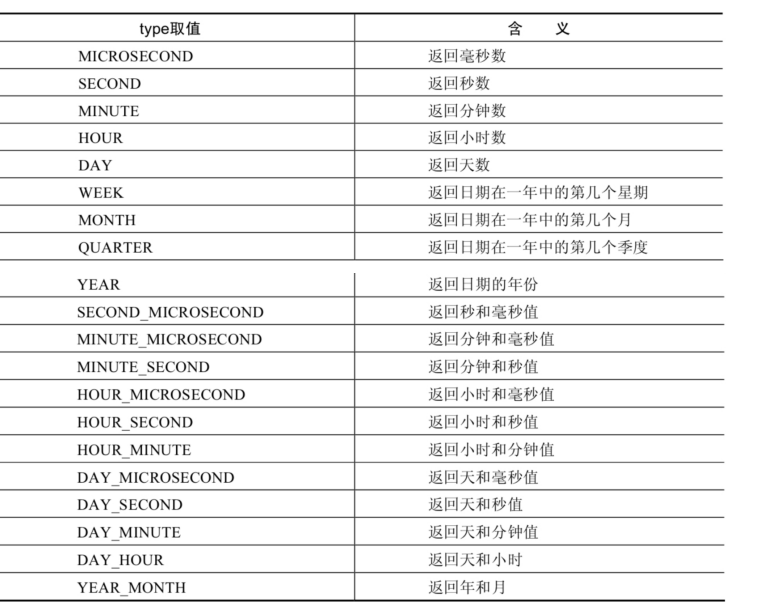
| extract(type from data) | 返回指定日期中特定的部分,type指定返回的值 |
EXTRACT(type FROM date)函数中type的取值与含义:
SELECT YEAR(CURDATE()),MONTH(CURDATE()),DAY(CURDATE()),
HOUR(CURTIME()),MINUTE(NOW()),SECOND(SYSDATE())
FROM DUAL;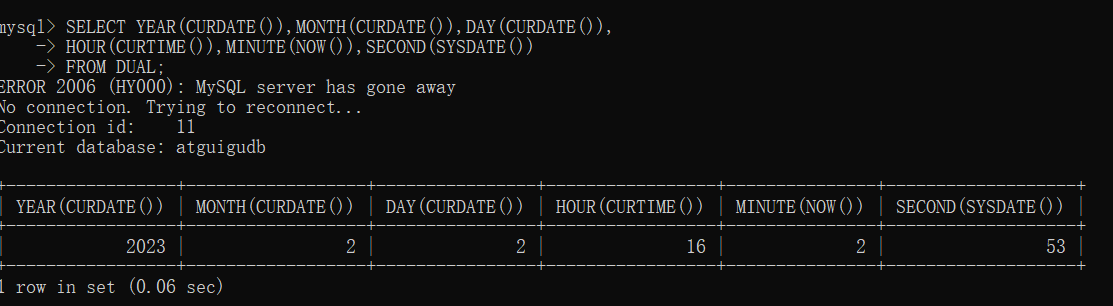
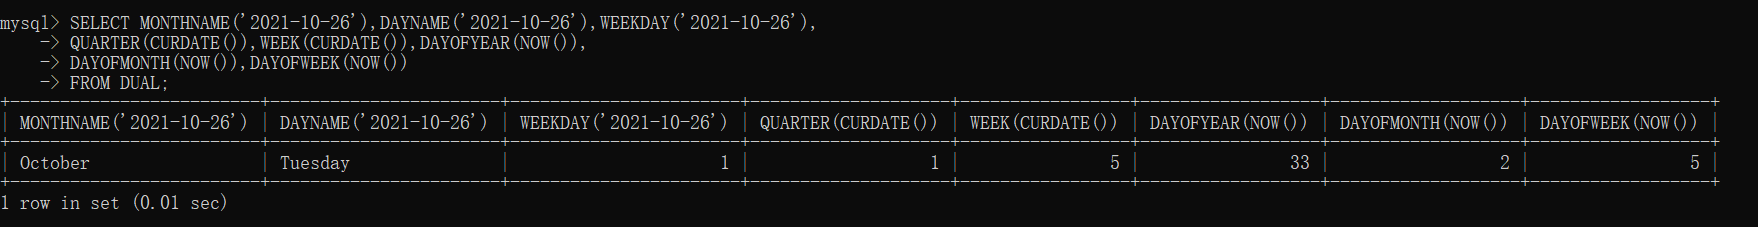
SELECT MONTHNAME('2021-10-26'),DAYNAME('2021-10-26'),WEEKDAY('2021-10-26'),
QUARTER(CURDATE()),WEEK(CURDATE()),DAYOFYEAR(NOW()),
DAYOFMONTH(NOW()),DAYOFWEEK(NOW())
FROM DUAL;
时间和秒钟转换的函数
| 函数 | 用法 |
|---|---|
| TIME_TO_SEC(time) | 将 time 转化为秒并返回结果值。转化的公式为: 小时*3600+分钟 *60+秒 |
| SEC_TO_TIME(seconds) | 将 seconds 描述转化为包含小时、分钟和秒的时间 |

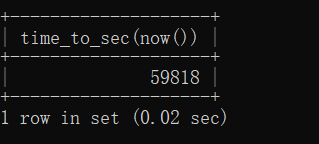
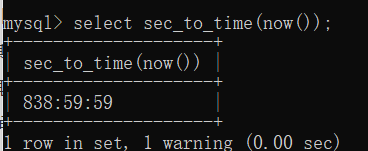
计算日期和时间的函数
| 函数 | 用法 |
|---|---|
| DATE_ADD(datetime, INTERVAL expr type), ADDDATE(date,INTERVAL expr type) | 返回与给定日期时间相差INTERVAL时 间段的日期时间 |
| DATE_SUB(date,INTERVAL expr type), SUBDATE(date,INTERVAL expr type) | 返回与date相差INTERVAL时间间隔的 日期 |
上述函数中type的取值:
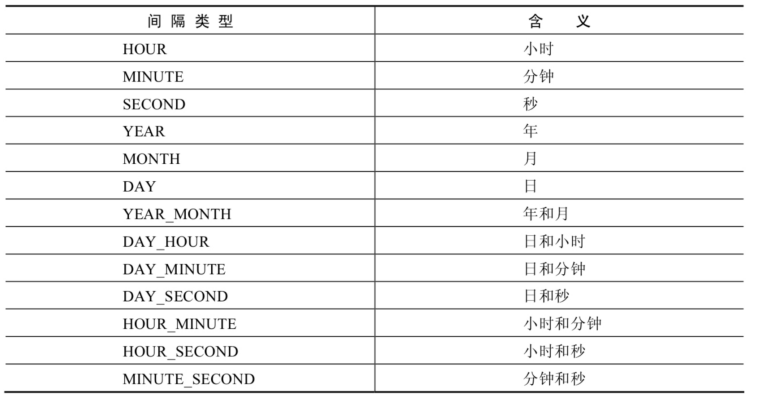
| 函数 | 用法 |
|---|---|
| ADDTIME(time1,time2) | 返回time1加上time2的时间。当time2为一个数字时,代表的是 秒 ,可以为负数 |
| SUBTIME(time1,time2) | 返回time1减去time2后的时间。当time2为一个数字时,代表的 是 秒 ,可以为负数 |
| DATEDIFF(date1,date2) | 返回date1 - date2的日期间隔天数 |
| TIMEDIFF(time1, time2) | 返回time1 - time2的时间间隔 |
| FROM_DAYS(N) | 返回从0000年1月1日起,N天以后的日期 |
| TO_DAYS(date) | 返回日期date距离0000年1月1日的天数 |
| LAST_DAY(date) | 返回date所在月份的最后一天的日期 |
| MAKEDATE(year,n) | 针对给定年份与所在年份中的天数返回一个日期 |
| MAKETIME(hour,minute,second) | 将给定的小时、分钟和秒组合成时间并返回 |
| PERIOD_ADD(time,n) | 返回time加上n后的时间 |
SELECT
ADDTIME(NOW(),20),SUBTIME(NOW(),30),SUBTIME(NOW(),'1:1:3'),DATEDIFF(NOW(),'2021-10-
01'),
TIMEDIFF(NOW(),'2021-10-25 22:10:10'),FROM_DAYS(366),TO_DAYS('0000-12-25'),
LAST_DAY(NOW()),MAKEDATE(YEAR(NOW()),12),MAKETIME(10,21,23),PERIOD_ADD(20200101010101,
10)
FROM DUAL;日期的格式化与解析
| 函数 | 用法 |
|---|---|
| DATE_FORMAT(date,fmt) | 按照字符串fmt格式化日期date值 |
| TIME_FORMAT(time,fmt) | 按照字符串fmt格式化时间time值 |
| GET_FORMAT(date_type,format_type) | 返回日期字符串的显示格式 |
| STR_TO_DATE(str, fmt) | 按照字符串fmt对str进行解析,解析为一个日期 |
上述 非GET_FORMAT 函数中fmt参数常用的格式符:
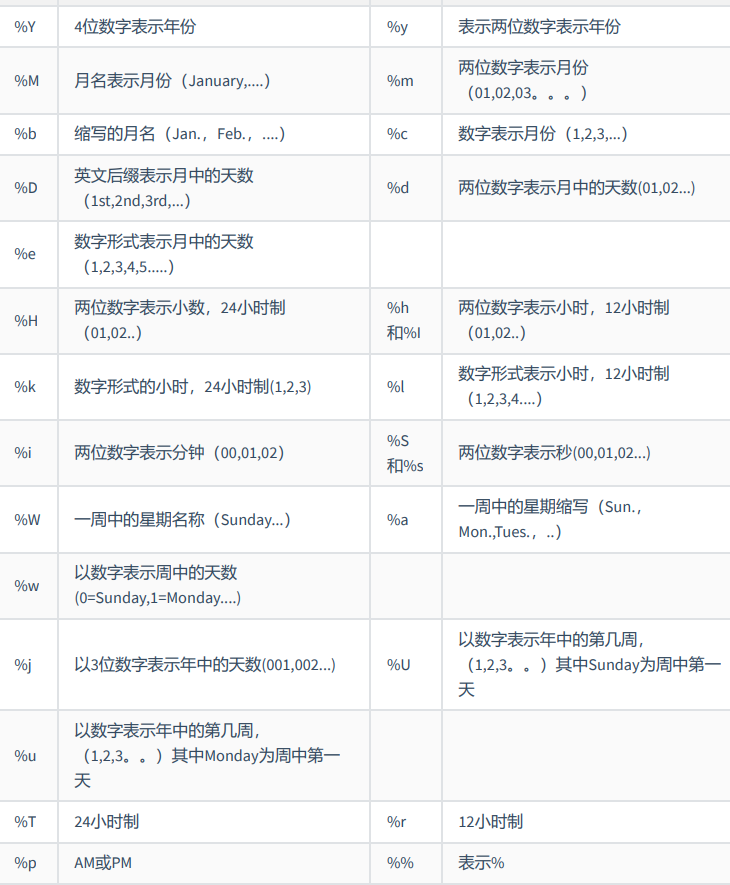
GET_FORMAT函数中date_type和format_type参数取值如下:
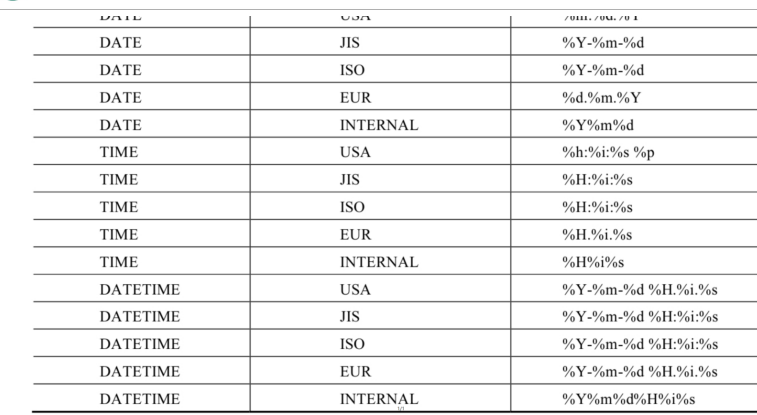
1.6 流程处理函数(控制流函数)
主要包括IF()、IFNULL()和CASE()函数。
| 函数 | 用法 |
|---|---|
| IF(value,value1,value2) | 如果value的值为TRUE,返回value1, 否则返回value2 |
| IFNULL(value1, value2) | 如果value1不为NULL,返回value1,否 则返回value2 |
| CASE WHEN 条件1 THEN 结果1 WHEN 条件2 THEN 结果2 .... [ELSE resultn] END | 相当于Java的if...else if...else... |
| CASE expr WHEN 常量值1 THEN 值1 WHEN 常量值1 THEN 值1 .... [ELSE 值n] END | 相当于Java的switch...case.. |
COALESCE : 用于返回第一个非空(非 NULL)的值。它可以用于处理可能包含 NULL 值的列,确保在结果中不出现 NULL。 SELECT COALESCE(NULL, NULL, 'First Non-NULL', 'Another Value') |
相当于替换NULL的异常处理 |
SELECT IF(1 > 0,'正确','错误')
->正确SELECT CASE
WHEN 1 > 0
THEN '1 > 0'
WHEN 2 > 0
THEN '2 > 0'
ELSE '3 > 0'
END
->1 > 0SELECT CASE 1
WHEN 1 THEN '我是1'
WHEN 2 THEN '我是2'
ELSE '你是谁'
END "描述"
SELECT employee_id,salary, CASE WHEN salary>=15000 THEN '高薪'
WHEN salary>=10000 THEN '潜力股'
WHEN salary>=8000 THEN '屌丝'
ELSE '草根' END "描述"
FROM employees;SELECT oid,`status`, CASE `status` WHEN 1 THEN '未付款'
WHEN 2 THEN '已付款'
WHEN 3 THEN '已发货'
WHEN 4 THEN '确认收货'
ELSE '无效订单'
END "描述"
FROM t_order;
COALESCE(value1, value2, ..., valueN)
-- 1. 基本用法
SELECT COALESCE(NULL, NULL, 'First Non-NULL', 'Another Value')
AS Result;-- 'First Non-NULL'
-- 2.处理列值
SELECT employee_id, COALESCE(phone_number, 'No Phone Number') AS phone
FROM employees;
-- 如果 phone_number 列的值是 NULL,则结果将是 'No Phone Number'。
-- 3.与其他函数配合使用
SELECT employee_id, COALESCE(start_date, CURRENT_DATE) AS start
FROM employees;
-- 如果 start_date 列的值是 NULL,则使用当前日期作为默认值。1.7加密与解密函数
加密与解密函数主要用于对数据库中的数据进行加密和解密处理,以防止数据被他人窃取。这些函数在 保证数据库安全时非常有用
| 函数 | 用法 |
|---|---|
| PASSWORD(str) | 返回字符串str的加密版本,41位长的字符串。加密结果 不可 逆 ,常用于用户的密码加密(8.0弃用) |
| MD5(str) | 返回字符串str的md5加密后的值,也是一种加密方式。若参数为 NULL,则会返回NULL |
| SHA(str) | 从原明文密码str计算并返回加密后的密码字符串,当参数为 NULL时,返回NULL。 SHA加密算法比MD5更加安全 。 |
| DECODE(value,password_seed) | 返回使用password_seed作为加密密码解密value |
| ENCODE(value,password_seed) | 返回使用password_seed作为加密密码加密value |
可以看到,ENCODE(value,password_seed)函数与DECODE(value,password_seed)函数互为反函数。
mysql> SELECT PASSWORD('mysql'), PASSWORD(NULL);
+-------------------------------------------+----------------+
| PASSWORD('mysql') | PASSWORD(NULL) |
+-------------------------------------------+----------------+
| *E74858DB86EBA20BC33D0AECAE8A8108C56B17FA | |
+-------------------------------------------+----------------+
1 row in set, 1 warning (0.00 sec)SELECT md5('123')
->202cb962ac59075b964b07152d234b70SELECT SHA('Tom123')
->c7c506980abc31cc390a2438c90861d0f1216d50mysql> SELECT ENCODE('mysql', 'mysql');
+--------------------------+
| ENCODE('mysql', 'mysql') |
+--------------------------+
| íg ¼ ìÉ |
+--------------------------+
1 row in set, 1 warning (0.01 sec)mysql> SELECT DECODE(ENCODE('mysql','mysql'),'mysql');
+-----------------------------------------+
| DECODE(ENCODE('mysql','mysql'),'mysql') |
+-----------------------------------------+
| mysql |
+-----------------------------------------+
1 row in set, 2 warnings (0.00 sec)1.8 MySQL信息函数
| 函数 | 用法 |
|---|---|
| version() | 返回当前MySQL的版本号 |
| connection_id() | 返回当前MySQL服务器的连接数 |
| database(),schema() | 返回MySQL命令行当前所在的数据库 |
| user(),current_user(),system_user(),session_user() | 返回当前连接MySQL的用户名,返回结果格式为 “主机名@用户名” |
| charset(value) | 返回字符串value自变量的字符集 |
| collation(value) | 返回字符串value的比较规则 |
其他:
| 函数 | 用法 |
|---|---|
| format(value,np;) | 返回对数字value进行格式化后的结果数据。n表示 四舍五入 后保留 到小数点后n位 |
| conv(value,from,to) | 将value的值进行不同进制之间的转换,from为value的进制,to是需要转换的进制 |
| inet_aton(ipvalue) | 将以点分隔的IP地址转化为一个数字 |
| inet_ntoa(value) | 将数字形式的IP地址转化为以点分隔的IP地址 |
| benchmark(n,expr) | 将表达式expr重复执行n次。用于测试MySQL处理expr表达式所耗费 的时间 |
| convert(value using char_code) | 将value所使用的字符编码修改为char_code |
# 如果n的值小于或者等于0,则只保留整数部分
mysql> SELECT FORMAT(123.123, 2), FORMAT(123.523, 0), FORMAT(123.123, -2);
+--------------------+--------------------+---------------------+
| FORMAT(123.123, 2) | FORMAT(123.523, 0) | FORMAT(123.123, -2) |
+--------------------+--------------------+---------------------+
| 123.12 | 124 | 123 |
+--------------------+--------------------+---------------------+
1 row in set (0.00 sec)
mysql> SELECT CONV(16, 10, 2), CONV(8888,10,16), CONV(NULL, 10, 2);
+-----------------+------------------+-------------------+
| CONV(16, 10, 2) | CONV(8888,10,16) | CONV(NULL, 10, 2) |
+-----------------+------------------+-------------------+
| 10000 | 22B8 | NULL |
+-----------------+------------------+-------------------+
1 row in set (0.00 sec)
mysql> SELECT INET_ATON('192.168.1.100');
+----------------------------+
| INET_ATON('192.168.1.100') |
+----------------------------+
| 3232235876 |
+----------------------------+
1 row in set (0.00 sec)
# 以“192.168.1.100”为例,计算方式为192乘以256的3次方,加上168乘以256的2次方,加上1乘以256,再加上
100。
| INET_NTOA(3232235876) |
+-----------------------+
| 192.168.1.100 |
+-----------------------+
1 row in set (0.00 sec)
mysql> SELECT BENCHMARK(1, MD5('mysql'));
+----------------------------+
| BENCHMARK(1, MD5('mysql')) |
+----------------------------+
| 0 |
+----------------------------+
1 row in set (0.00 sec)
mysql> SELECT BENCHMARK(1000000, MD5('mysql'));
+----------------------------------+
| BENCHMARK(1000000, MD5('mysql')) |
+----------------------------------+
| 0 |
+----------------------------------+
1 row in set (0.20 sec)
mysql> SELECT CHARSET('mysql'), CHARSET(CONVERT('mysql' USING 'utf8'));
+------------------+----------------------------------------+
| CHARSET('mysql') | CHARSET(CONVERT('mysql' USING 'utf8')) |
+------------------+----------------------------------------+
| utf8mb4 | utf8 |
+------------------+----------------------------------------+
1 row in set, 1 warning (0.00 sec)2.聚合函数
聚合函数作用于一组数据,并对一组数据返回一个值。
聚合函数类型:
●AVG()
只适用于数值类型的字段(或变量)
●SUM()
只适用于数值类型的字段(或变量)
●MAX()
适用于数值类型、字符串类型、日期时间类型的字段(或变量)
●MIN()
适用于数值类型、字符串类型、日期时间类型的字段(或变量)
●COUNT()
① 作用:计算指定字段在查询结构中出现的个数(不包含NULL值的)
SELECT COUNT(employee_id),COUNT(salary),COUNT(2 * salary),COUNT(1),COUNT(2),COUNT(*)
FROM employees ;② 注意:计算指定字段出现的个数时,是不计算NULL值的。
SELECT COUNT(commission_pct)
FROM employees;
SELECT commission_pct
FROM employees
WHERE commission_pct IS NOT NULL;#③ 公式:AVG = SUM / COUNT
SELECT AVG(salary),SUM(salary)/COUNT(salary),
AVG(commission_pct),SUM(commission_pct)/COUNT(commission_pct),
SUM(commission_pct) / 107
FROM employees;如何需要统计表中的记录数,使用COUNT(*)、COUNT(1)、COUNT(具体字段) 哪个效率更高呢?
如果使用的是MyISAM 存储引擎,则三者效率相同,都是O(1)
如果使用的是InnoDB 存储引擎,则三者效率:COUNT(*) = COUNT(1)> COUNT(字段)
Innodb引擎的表用count(*),count(1)直接读行数,复杂度是O(n),因为innodb真的要去数一遍。但好 于具体的count(列名)。
问题:能不能使用count(列名)替换count()? 不要使用 count(列名)来替代 count() , count() 是 SQL92 定义的标准统计行数的语法,跟数 据库无关,跟 NULL 和非 NULL 无关。 说明:count()会统计值为 NULL 的行,而 count(列名)不会统计此列为 NULL 值的行。
分组函数 GROUP BY 的使用
SELECT column, group_function(column)
FROM table
[WHERE condition]
[GROUP BY group_by_expression]
[ORDER BY column];结论1:
SELECT中出现的非组函数的字段必须声明在GROUP BY 中。
反之,GROUP BY中声明的字段可以不出现在SELECT中。
/*select中出现要查询的列可以写可以不写,但是group by中的要分组的列一定要写*/
select column1,column2,avg(column3)#column1,column2可以省略
from table
group by column1,column2;#不能省略column1,column2
结论2:
GROUP BY 声明在FROM后面、WHERE后面,ORDER BY 前面、LIMIT前面
结论3:
MySQL中GROUP BY中使用WITH ROLLUP
使用 WITH ROLLUP 关键字之后,在所有查询出的分组记录之后增加一条记录,该记录计算查询出的所 有记录的总和,即统计记录数量。
select department_id,avg(salary)
from employees
group by department_id with rollup;#说明:当使用ROLLUP时,不能同时使用ORDER BY子句进行结果排序,即ROLLUP和ORDER BY是互相排斥的。 #错误的:(在mysql8.0中不会报错)
过滤分组:HAVING子句
- 行已经被分组。
- 使用了聚合函数。
- 满足HAVING 子句中条件的分组将被显示。
- HAVING 不能单独使用,必须要跟 GROUP BY 一起使用。
要求1:如果过滤条件中使用了聚合函数,则必须使用HAVING来替换WHERE。否则,报错。 要求2:HAVING 必须声明在 GROUP BY 的后面。
非法使用聚合函数 : 不能在 WHERE 子句中使用聚合函数。
SELECT department_id, AVG(salary)
FROM employees
WHERE AVG(salary) > 8000
GROUP BY department_id;WHERE和HAVING的对比
**可以理解where子句不能用函数,having可以用函数,而group by 是接having一起用的 **
区别1:
WHERE 可以直接使用表中的字段作为筛选条件,但不能使用分组中的计算函数作为筛选条件; HAVING 必须要与 GROUP BY 配合使用,可以把分组计算的函数和分组字段作为筛选条件。
这决定了,在需要对数据进行分组统计的时候,HAVING 可以完成 WHERE 不能完成的任务。这是因为, 在查询语法结构中,WHERE 在 GROUP BY 之前,所以无法对分组结果进行筛选。HAVING 在 GROUP BY 之 后,可以使用分组字段和分组中的计算函数,对分组的结果集进行筛选,这个功能是 WHERE 无法完成 的。另外,WHERE排除的记录不再包括在分组中。
区别2:
如果需要通过连接从关联表中获取需要的数据,WHERE 是先筛选后连接,而 HAVING 是先连接 后筛选。
这一点,就决定了在关联查询中,WHERE 比 HAVING 更高效。因为 WHERE 可以先筛选,用一 个筛选后的较小数据集和关联表进行连接,这样占用的资源比较少,执行效率也比较高。HAVING 则需要 先把结果集准备好,也就是用未被筛选的数据集进行关联,然后对这个大的数据集进行筛选,这样占用 的资源就比较多,执行效率也较低。
WHERE 先筛选数据再关联,执行效率高 不能使用分组中的计算函数进行筛选 HAVING 可以使用分组中的计算函数 在最后的结果集中进行筛选,执行效率较低
开发中的选择:
WHERE 和 HAVING 也不是互相排斥的,我们可以在一个查询里面同时使用 WHERE 和 HAVING。包含分组 统计函数的条件用 HAVING,普通条件用 WHERE。这样,我们就既利用了 WHERE 条件的高效快速,又发 挥了 HAVING 可以使用包含分组统计函数的查询条件的优点。当数据量特别大的时候,运行效率会有很 大的差别。
SELECT的执行过程
#sql92语法:
SELECT ....,....,....(存在聚合函数)
FROM ...,....,....
WHERE 多表的连接条件 AND 不包含聚合函数的过滤条件
GROUP BY ...,....
HAVING 包含聚合函数的过滤条件
ORDER BY ....,...(ASC / DESC )
LIMIT ...,....
/*SQL99*/
SELECT ...,....,...
FROM ... JOIN ...
ON 多表的连接条件
JOIN ...
ON ...
WHERE 不包含组函数的过滤条件
AND/OR 不包含组函数的过滤条件
GROUP BY ...,...
HAVING 包含组函数的过滤条件
ORDER BY ... ASC/DESC
LIMIT ...,...
#其中:
#(1)from,join,:从哪些表中筛选
#(2)on:关联多表查询时,去除笛卡尔积
#(3)where:从表中筛选的条件
#(4)group by ,avg,sum...组函数:分组依据
#(5)having:在统计结果中再次筛选
# (6)select distinct 查找
#(7)order by:排序
#(8)limit:分页
先查表,再select 最后分页排序SELECT 查询时的两个顺序:
1.关键字的顺序是不能颠倒的:
SELECT ... FROM ... WHERE ... GROUP BY ... HAVING ... ORDER BY ... LIMIT...2.SELECT 语句的执行顺序(在 MySQL 和 Oracle 中,SELECT 执行顺序基本相同):
FROM -> WHERE -> GROUP BY -> HAVING -> SELECT 的字段 -> DISTINCT -> ORDER BY -> LIMITSELECT DISTINCT player_id, player_name, count(*) as num # 顺序 5
FROM player JOIN team ON player.team_id = team.team_id # 顺序 1
WHERE height > 1.80 # 顺序 2
GROUP BY player.team_id # 顺序 3
HAVING num > 2 # 顺序 4
ORDER BY num DESC # 顺序 6
LIMIT 2 # 顺序 7在 SELECT 语句执行这些步骤的时候,每个步骤都会产生一个 虚拟表 ,然后将这个虚拟表传入下一个步 骤中作为输入。需要注意的是,这些步骤隐含在 SQL 的执行过程中,对于我们来说是不可见的。
SQL 的执行原理
SELECT 是先执行 FROM 这一步的。在这个阶段,如果是多张表联查,还会经历下面的几个步骤:
- 首先先通过 CROSS JOIN 求笛卡尔积,相当于得到虚拟表 vt(virtual table)1-1;
- 通过 ON 进行筛选,在虚拟表 vt1-1 的基础上进行筛选,得到虚拟表 vt1-2;
- 添加外部行。如果我们使用的是左连接、右链接或者全连接,就会涉及到外部行,也就是在虚拟 表 vt1-2 的基础上增加外部行,得到虚拟表 vt1-3。 当然如果我们操作的是两张以上的表,还会重复上面的步骤,直到所有表都被处理完为止。这个过程得 到是我们的原始数据。
当然如果我们操作的是两张以上的表,还会重复上面的步骤,直到所有表都被处理完为止。这个过程得 到是我们的原始数据。
4.然后进入第三步和第四步,也就是 GROUP 和 HAVING 阶段 。在这个阶段中,实际上是在虚拟表 vt2 的 基础上进行分组和分组
过滤,得到中间的虚拟表 vt3 和 vt4 。
5.当我们完成了条件筛选部分之后,就可以筛选表中提取的字段,也就是进入到 SELECT 和 DISTINCT 阶段 。
6.首先在 SELECT 阶段会提取想要的字段,然后在 DISTINCT 阶段过滤掉重复的行,分别得到中间的虚拟表 vt5-1 和 vt5-2 。
7.当我们提取了想要的字段数据之后,就可以按照指定的字段进行排序,也就是 ORDER BY 阶段 ,得到 虚拟表 vt6 。
8.最后在 vt6 的基础上,取出指定行的记录,也就是 LIMIT 阶段 ,得到最终的结果,对应的是虚拟表 vt7 。
当然我们在写 SELECT 语句的时候,不一定存在所有的关键字,相应的阶段就会省略。
同时因为 SQL 是一门类似英语的结构化查询语言,所以我们在写 SELECT 语句的时候,还要注意相应的 关键字顺序,所谓底层运行的原理,就是我们刚才讲到的执行顺序。
子查询
子查询指一个查询语句嵌套在另一个查询语句内部的查询,这个特性从MySQL 4.1开始引入。 SQL 中子查询的使用大大增强了 SELECT 查询的能力,因为很多时候查询需要从结果集中获取数据,或者 需要从同一个表中先计算得出一个数据结果,然后与这个数据结果(可能是某个标量,也可能是某个集 合)进行比较。
本质是:查询语句中子句要通过查询得到,注意where语句是不能用函数的,group by 可以
语法:
select select_list
from table where expr operator
(select select_list
from table)子查询(内查询)在主查询之前一次执行完成。
子查询的结果被主查询(外查询)使用 。
注意事项
子查询要包含在括号内
将子查询放在比较条件的右侧
单行操作符对应单行子查询,多行操作符对应多行子查询
子查询的分类
分类方式1: 单行子查询 、 多行子查询
结果返回一条还是多条记录,将子查询分为 单行子查询 、 多行子查询
如何分析语句怎么查询:
子查询的编写技巧(或步骤):① 从里往外写 ② 从外往里写
例:查询工资大于149号员工工资的员工的名字和工资
拆:查询(工资大于149号员工工资)的员工的名字和工资
查询的员工的名字和工资:为主查询
工资大于149号员工工资:为子查询
主查询:
select last_name,salary
from employees
where salary >(子查询);
子查询:
select salary from employees where employee_id = 149
可以先分析子查询,在分析主查询
单行比较操作符:=,>,<,<=,>=,<>(为不等于)
<>等价!=
#查询工资大于149号员工工资的员工的名字和工资
select last_name,salary
from employees
where salary > (select salary from employees where employee_id = 149)having中的子查询:
having可以接函数
#查询(最低工资大于50号部门最低工资)的部门id和其最低工资
select department_id ,min(salary)
from employees
group by department_id
having min(salary) > (select min(salary) from employees where department_id = 50); case中的子查询:
case语句:
CASE case_value
WHEN when_value1 THEN statement_list1 #当为when_value1时,判定为statement_list1
WHEN when_value2 THEN statement_list2.....
ELSE statement_list #上面都不符合即为statement_list
END '别名';#显式员工的employee_id,last_name和location。其中,若员工department_id与location_id为1800
的department_id相同,则location为’Canada’,其余则为’USA’。
#1.显式员工的employee_id,last_name和location。
select employee_id, last_name,location
from employees;
#2.其中,若员工department_id与location_id为1800
的department_id相同,则location为’Canada’,其余则为’USA’。
case department_id
when (select department_id from departments where location_id =1800 then 'Canade' else 'USA' end) location
#3.总
select employee_id, last_name,
(case department_id when (select department_id from departments where location_id =1800) then 'Canade' else 'USA' end) location
from employees;注意:子查询是不返回任何行的,所以如果子查询没有查到信息,主查询返回null
使用单行子查询,其中子查询只能是一个数据,查出多个数据为多行数据,不能用单行比较操作符**:=,>,<,<=,>=,<>(为不等于)
SELECT employee_id, last_name FROM employees WHERE salary = /=错误/ (SELECT MIN(salary) FROM employees GROUP BY department_id);
多行子查询
●也称为集合比较子查询
● 内查询返回多行
●使用多行比较操作符
多行子查询的操作符: IN ANY ALL SOME(同ANY)
| 操作符 | 含义 |
|---|---|
| in | 等于列表中的任意一个 |
| any | 需要和单行比较操作符一起使用,和子查询返回的某一个值比较 |
| all | 需要和单行比较操作符一起使用,和子查询返回的所有值比较 |
| some | 实际上是ANY的别名,作用相同,一般常使用ANY |
在操作符前加not 表示反面
#返回其它job_id中比job_id为‘IT_PROG’部门任一工资低的员工的员工号、姓名、job_id 以及salary
#1子查询.job_id为‘IT_PROG’部门工资
select salary from employees where job_id = 'IT_PROG'
#2.其它job_id比IT_PROG的工资低的员工的员工号、姓名、job_id 以及salary
select employee_id ,last_name, job_id ,salary
from employees
from salary < any (job_id为‘IT_PROG’部门工资);
#3.总
select employee_id ,last_name, job_id ,salary
from employees
where salary < any (select salary from employees where job_id = 'IT_PROG')
and job_id <> 'IT_PROG';任一和所有的区别对应any和all的区别
2.例
#查询平均工资最低的部门id
#方式1:
SELECT department_id
FROM employees
GROUP BY department_id
HAVING AVG(salary) = (
SELECT MIN(avg_sal)
FROM (
SELECT AVG(salary) avg_sal
FROM employees
GROUP BY department_id
) dept_avg_sal
)/*错误,MySQL中聚合函数是不能嵌套使用的。orcl中可以使用*/
SELECT department_id
FROM employees
GROUP BY department_id
HAVING AVG(salary) <= ALL (
SELECT AVG(salary) avg_sal
FROM employees
GROUP BY department_id
)MySQL中聚合函数是不能嵌套使用的。orcl中可以使用
3.空值问题(where 查询是会查空值的)
SELECT last_name
FROM employees
WHERE employee_id NOT IN (
SELECT manager_id
FROM employees
#where manager_id != null
);分类方式2:相关(或关联)子查'询 和 不相关(或非关联)子查询 。
分类方式2查询工资大于149号员工工资的员工的信息:查询是否被执行多次,将子查询划分为 相关(或关联)子查询 和 不相关(或非关联)子查询 。
子查询从数据表中查询了数据结果,如果这个数据结果只执行一次,然后这个数据结果作为主查询的条 件进行执行,那么这样的子查询叫做不相关子查询。 (子查询条件不依赖父查询)
如果子查询需要执行多次,即采用循环的方式,先从外部查询开始,每次都传入子查询进行查 询,然后再将结果反馈给外部,这种嵌套的执行方式就称为相关子查询。(子查询条件依赖父查询)
重点为不相关子查询,关键字为outer
语法:
select select_list
from table1 outer
where colunm operator(
selcet colunm from table2 where expr1 = outer.expr2)说明:子查询中使用主查询中的列
#查询员工中工资大于本部门平均工资的员工的last_name,salary和其department_id
#相关子查询
select last_name,salary,department_id
from emlpoyees
where salary >(select avg(salary) from emlpoyees where department_id = outer.department_id);
#在 FROM 中使用子查询
select last_name,salary,e1.department_id
from emlpoyees e1,(select avg(salary) s1 from emlpoyees group by department_id) e2
where e1.'department_id' = e2.'department_id'
and e2.s1 < e1.salary;
/*from型的子查询:子查询是作为from的一部分,子查询要用()引起来,并且要给这个子查询取别
名, 把它当成一张“临时的虚拟的表”来使用。(空间换时间)*/在ORDER BY 中使用子查询:
结果是排序的:用 order by
#查询员工的id,salary,按照department_name 排序
select id ,salary
from employees e1
order by (select department_name from departments d1 where e1.department_id = d1.department_id )asc;#结论:在SELECT中,除了GROUP BY 和 LIMIT之外,其他位置都可以声明子查询!
/*
SELECT ....,....,....(存在聚合函数)
FROM ... (LEFT / RIGHT)JOIN ....ON 多表的连接条件
(LEFT / RIGHT)JOIN ... ON ....
WHERE 不包含聚合函数的过滤条件
GROUP BY ...,....
HAVING 包含聚合函数的过滤条件
ORDER BY ....,...(ASC / DESC )
LIMIT ...,....
*/#若employees表中employee_id与job_history表中employee_id相同的数目不小于2,
#输出这些相同id的员工的employee_id,last_name和其job_id
select employee_id,last_name,job_id
from employees e
where 2 <= (select count(*) from job_history j where e.`employee_id` = j.`employee_id`);e.employee_id
EXISTS 与 NOT EXISTS关键字
关联子查询通常也会和 EXISTS操作符一起来使用,用来检查在子查询中是否存在满足条件的行。
如果在子查询中不存在满足条件的行:
● 条件返回 FALSE
●继续在子查询中查找
如果在子查询中存在满足条件的行:
●不在子查询中继续查找
● 条件返回 TRUE
NOT EXISTS关键字表示如果不存在某种条件,则返回TRUE,否则返回FALSE。
#查询公司管理者的employee_id,last_name,job_id,department_id信息
#方式一:
select employee_id,last_name,job_id,department_id
from employees e1
where exists (select * from employees e2 where e1.manager_id = e2.employee_id );
#方式二:自连接
select distinct e1.employee_id,e1.last_name,e1.department_id
from employees e1 join employees e2
where e1.employee_id = e2.manager_id;
#方式三:多行子查询
select employee_id,last_name,job_id,department_id
from departments
where employee_id in (select manager_id from employees);相关更新和相关删除
相关更新
#使用相关子查询依据一个表中的数据更新另一个表的数据。
UPDATE table1 alias1
SET column = (SELECT expression
FROM table2 alias2
WHERE alias1.column = alias2.column);
#题目:在employees中增加一个department_name字段,数据为员工对应的部门名称
update employees e
set department_name = (select department_name from departments d where e.department_id = d.department_id );相关删除:
#使用相关子查询依据一个表中的数据删除另一个表的数据。
DELETE FROM table1 alias1
WHERE column operator (SELECT expression
FROM table2 alias2
WHERE alias1.column = alias2.column);
#题目:删除表employees中,其与emp_history表皆有的数据(department_id)
delete from employees e
where employee_id in (select employee_id from emp_history e_h where e_h.employee_id =e.employee_id )子查询和自连接哪种好?
自连接好
题目中可以使用子查询,也可以使用自连接。一般情况建议你使用自连接,因为在许多 DBMS 的处理过 程中,对于自连接的处理速度要比子查询快得多。 可以这样理解:子查询实际上是通过未知表进行查询后的条件判断,而自连接是通过已知的自身数据表 进行条件判断,因此在大部分 DBMS 中都对自连接处理进行了优化。
#例:谁的工资比Abel的高?
#方式1:自连接
select e1.last_name ,e1.salary from employees e1,employees e2
where e2.last_name = 'Abel' and e1.salary > e2.salary;
#方式2:子查询
select last_name ,salary
from employees
where salary > (select salary from employees where last_name = 'Abel') ;创建和管理表
基础知识
标识符命名规则
●数据库名、表名不得超过30个字符,变量名限制为29个
●必须只能包含 A–Z, a–z, 0–9, _共63个字符
●数据库名、表名、字段名等对象名中间不要包含空格
●同一个MySQL软件中,数据库不能同名;同一个库中,表不能重名;同一个表中,字段不能重名 必须保证你的字段没有和保留字、数据库系统或常用方法冲突。如果坚持使用,请在SQL语句中使 用`(着重号)引起来
●保持字段名和类型的一致性:在命名字段并为其指定数据类型的时候一定要保证一致性,假如数据 类型在一个表里是整数,那在另一个表里可就别变成字符型了
MySQL中的数据类型
| 类型 | 类型举例 |
|---|---|
| 整数类型 | tinyint、smallint、mediuint、int(integer)、bigint |
| 浮点类型 | float、double |
| 定点数类型 | decimal |
| 位类型 | bit |
| 日期时间类型 | year、time、date、datetime、timestamp |
| 文本字符串类型 | char、varchar、tinytext、text、mediumtext、longtext |
| 枚举类型 | enum |
| 二进制字符串类 型 | set |
| JSON类型 | bigary、varbinary、tinyblob、blob、mediumblob、longblob |
| 空间数据类型 | 单值:geometry、point、linestring、polygon.集合:multipoint、multilnestring、multipolygon、geometrcollection |
常见数据类型的属性,如下:
| MySQL关键字 | 含义 |
|---|---|
| null | 数据列可包含NULL值 |
| not null | 数据列不允许包含NULL值 |
| default | 默认值 |
| primary key | 主键 |
| auto_increment | 自动递增,适用于整数类型 |
| unsigned | 无符号 |
| character set name | 指定一个字符集 |
其中,常用的几类类型介绍如下:
| 数据类型 | 描述 |
|---|---|
| int | 从-2^31到2^31-1的整型数据。存储大小为 4个字节 |
| char(size) | 定长字符数据。若未指定,默认为1个字符,最大长度255 |
| varchar(size) | 可变长字符数据,根据字符串实际长度保存,必须指定长度 |
| float(m,d) | 单精度,占用4个字节,M=整数位+小数位,D=小数位。 D<=M<=255,0<=D<=30, 默认M+D<=6 |
| double(m,d) | 双精度,占用8个字节,D<=M<=255,0<=D<=30,默认M+D<=15 |
| decimal(m,d) | 高精度小数,占用M+2个字节,D<=M<=65,0<=D<=30,最大取值范围与DOUBLE 相同。 |
| date | 日期型数据,格式'YYYY-MM-DD' |
| blob | 二进制形式的长文本数据,最大可达4G |
| text | 长文本数据,最大可达4G |
M : 表示显示宽度,M的取值范围是(0, 255)。
例如,int(5):当数据宽度小于5位的时候在数字前面需要用 字符填满宽度。
该项功能需要配合“ ZEROFILL ”使用,表示用“0”填满宽度,否则指定显示宽度无效。 (zerifill)
如果设置了显示宽度,那么插入的数据宽度超过显示宽度限制,会不会截断或插入失败?
答案:不会对插入的数据有任何影响,还是按照类型的实际宽度进行保存,即 显示宽度与类型可以存储的值范围无关 。从MySQL 8.0.17开始,整数数据类型不推荐使用显示宽度属性。
整型数据类型可以在定义表结构时指定所需要的显示宽度,如果不指定,则系统为每一种类型指定默认 的宽度值。
ZEROFILL
ZEROFILL : 0填充,(如果某列是ZEROFILL,那么MySQL会自动为当前列添加UNSIGNED属性),如果指 定了ZEROFILL只是表示不够M位时,用0在左边填充,如果超过M位,只要不超过数据存储范围即可。zerofill
原来,在 int(M) 中,M 的值跟 int(M) 所占多少存储空间并无任何关系。 int(3)、int(4)、int(8) 在磁盘上都 是占用 4 bytes 的存储空间。也就是说,int(M),必须和UNSIGNED ZEROFILL一起使用才有意义。如果整 数值超过M位,就按照实际位数存储。只是无须再用字符 0 进行填充。
UNSIGNED
UNSIGNED : 无符号类型(非负),**所有的整数类型都有一个可选的属性UNSIGNED(无符号属性),无 符号整数类型的最小取值为0。**所以,如果需要在MySQL数据库中保存非负整数值时,可以将整数类型设 置为无符号类型.
int类型默认显示宽度为int(11),无符号int类型默认显示宽度为int(10)。
浮点类型
类型介绍: MySQL支持的浮点数类型,分别是 FLOAT、DOUBLE、REAL。
●FLOAT 表示单精度浮点数;
● DOUBLE 表示双精度浮点数;
●REAL默认就是 DOUBLE。如果你把 SQL 模式设定为启用“ REAL_AS_FLOAT ”,那 么,MySQL 就认为 REAL 是 FLOAT。如果要启用“REAL_AS_FLOAT”,可以通过以下 SQL 语句实现:
SET sql_mode = “REAL_AS_FLOAT”;**从MySQL 8.0.17开始,FLOAT(M,D) 和DOUBLE(M,D)用法在官方文档中已经明确不推荐使用,将来可 能被移除。**另外,关于浮点型FLOAT和DOUBLE的UNSIGNED也不推荐使用了,将来也可能被移除。
精度误差说明
浮点数类型有个缺陷,就是不精准。
那么,为什么会存在这样的误差呢?
问题还是出在 MySQL 对浮点类型数据的存储方式上。
MySQL 用 4 个字节存储 FLOAT 类型数据,用 8 个字节来存储 DOUBLE 类型数据。
无论哪个,都是采用二 进制的方式来进行存储的。比如 9.625,用二进制来表达,就是 1001.101,或者表达成 1.001101×2^3。如 果尾数不是 0 或 5(比如 9.624),你就无法用一个二进制数来精确表达。进而,就只好在取值允许的范 围内进行四舍五入。
在编程中,如果用到浮点数,要特别注意误差问题,因为浮点数是不准确的,所以我们要避免使用“=”来 判断两个数是否相等。同时,在一些对精确度要求较高的项目中,千万不要使用浮点数,不然会导致结 果错误,甚至是造成不可挽回的损失。那么,MySQL 有没有精准的数据类型呢?当然有,这就是定点数 类型: DECIMAL 。
定点数类型
MySQL中的定点数类型只有 DECIMAL 一种类型。
| 数据类型 | 字节数 | 含义 |
|---|---|---|
| decimal(M,D),dec,numeric | M+2字节 | 有效范围由M和D决定 |
适用场景
TINYINT :一般用于枚举数据,比如系统设定取值范围很小且固定的场景。
SMALLINT :可以用于较小范围的统计数据,比如统计工厂的固定资产库存数量等.
MEDIUMINT :用于较大整数的计算,比如车站每日的客流量等。
INT、INTEGER :取值范围足够大,一般情况下不用考虑超限问题,用得最多。比如商品.
BIGINT :只有当你处理特别巨大的整数时才会用到。比如双十一的交易量、大型门户网站点击量、证 券公司衍生产品持仓等。
使用 DECIMAL(M,D) 的方式表示高精度小数。其中,M被称为精度,D被称为标度。0<=M<=65, 0<=D<=30,D<M。例如,定义DECIMAL(5,2)的类型,表示该列取值范围是-999.99~999.99。
DECIMAL(M,D)的最大取值范围与DOUBLE类型一样,但是有效的数据范围是由M和D决定的。 DECIMAL 的存储空间并不是固定的,由精度值M决定,总共占用的存储空间为M+2个字节。也就是 说,在一些对精度要求不高的场景下,比起占用同样字节长度的定点数,浮点数表达的数值范围可 以更大一些。 定点数在MySQL内部是以 字符串 的形式进行存储,这就决定了它一定是精准的。 当DECIMAL类型不指定精度和标度时,
其默认为DECIMAL(10,0)。当数据的精度超出了定点数类型的 精度范围时,则MySQL同样会进行四舍五入处理。
浮点数 vs 定点数
浮点数相对于定点数的优点是在长度一定的情况下,浮点类型取值范围大,但是不精准,适用 于需要取值范围大,又可以容忍微小误差的科学计算场景(比如计算化学、分子建模、流体动 力学等
定点数类型取值范围相对小,但是精准,没有误差,适合于对精度要求极高的场景 (比如涉 及金额计算的场景)
由于 DECIMAL 数据类型的精准性,在我们的项目中,除了极少数(比如商品编号)用到整数类型 外,其他的数值都用的是 DECIMAL,原因就是这个项目所处的零售行业,要求精准,一分钱也不能 差。 ” ——来自某项目经理
位类型:BIT
本质是二进制
| 二进制字符串类型 | 长度 | 长度范围 | 占用空间 |
|---|---|---|---|
| BIT(M) | M | 1 <= M <= 64 | 约为(M + 7)/8个字节 |
BIT类型,如果没有指定(M),默认是1位。这个1位,表示只能存1位的二进制值。这里(M)是表示二进制的 位数,位数最小值为1,最大值为64。
使用SELECT命令查询位字段时,可以用 BIN() 或 HEX() 函数进行读取。
●正常读取是十六进制读取
●用bin(查询字段)查询的是二进制,
●hex(查询字段)查询的是十六进制
●查询字段+0 查询的是十进制
日期与时间类型
文本字符串类型
ENUM类型
SET类型
二进制字符串类型
JSON 类型
空间类型
小结及选择建议
创建和管理数据库
1.创建数据库
●方式1:创建数据库
create database 数据库名;●方式2:创建数据库并指定字符集
create database 数据库名 character set 字符集●方式3:判断数据库是否已经存在,不存在则创建数据库( 推荐 )
create database if not exists 数据库名;注意:DATABASE 不能改名。一些可视化工具可以改名,它是建新库,把所有表复制到新库,再删 旧库完成的。
2.使用数据库
●查看当前所有的数据库
show databases; #有一个S,代表多个数据库●查看当前正在使用的数据库
select database();#使用的一个 mysql 中的全局函数●查看指定库下所有的表
show tables from 数据库名;●查看数据库/表的创建信息
show create database/table 数据库名;
或者:
show create database/table 数据库名\G●使用/切换数据库
use 数据库名;注意:要操作表格和数据之前必须先说明是对哪个数据库进行操作,否则就要对所有对象加上“数 据库名.”。
3.修改数据库
●更改数据库字符集
alter database 数据库名 character set 字符集;#gbk,utf84.删除数据库
●方式:
drop database if exists 数据库名;创建表
条件:1.create table 权限 2. 存储空间
语法:
create table if not exists 表名(
字段1,数据类型 [约束条件][默认值]
......
);加上了IF NOT EXISTS关键字,则表示:如果当前数据库中不存在要创建的数据表,则创建数据表; 如果当前数据库中已经存在要创建的数据表,则忽略建表语句,不再创建数据表。
必须指定:
表名;列名,数据类型,长度
可选指定:
约束条件,默认值
#例
create table emp (
emp_id int ,
emp_name varchar(20),
salary double
emp_time date
);
DESC emp;DESCRIBE/DESC语句查看数据表结构
创建方式2:(关键字as)
#利用select 等语句,先查询,再把查询的数据形成新表
create table 表名 as
select * from student ;
#这样所有student的数据会放在新表名上
#那如何创建只有只有字段数据,无数据的表
create table 表名 as
select * from student
where 1=2;
#利用过滤条件where 1 = 2;即死条件查看数据表结构
MySQL支持使用 DESCRIBE/DESC 语句查看数据 表结构,也支持使用 SHOW CREATE TABLE 语句查看数据表结构。
desc 表名;
或:
show create table 表名;使用SHOW CREATE TABLE语句不仅可以查看表创建时的详细语句,还可以查看存储引擎和字符编码。
修改表
使用 ALTER TABLE 语句可以实现:
●向已有的表中添加列
alter table 表名 add [column] 字段名 字段类型 [first|after字段名]#例
alter table department
add job_id varchar(20)
after job;
/*first|after 表示放在存在字段的前|后*/●修改现有表中的列
修改列的数据类型,长度、默认值和位置
alter table 表名 modify [colunm] 字段1 字段类型 [default 默认值] [first|after 字段名2]#例
alter table kills modify last_name varchar(30) default 'kill';对默认值的修改只影响今后对表的修改
此外,还可以通过此种方式修改列的约束。这里暂先不讲。
●删除现有表中的列
alter table 表名 drop [colunm] 字段名#例
alter table departments
drop department_id ;●重命名现有表中的列
alter table 表名 change 【colunm】 列名 新列名 新数据类型#例
alter table department
change department_id depet_id varchar(20);重命名表
rename table 表名
to 新表名;alter table 表名
rename [to] 新表名;-- [TO]可以省略删除表
●在MySQL中,当一张数据表 没有与其他任何数据表形成关联关系 时,可以将当前数据表直接删除。
●数据和结构都被删除
●所有正在运行的相关事务被提交
●所有相关索引被删除
●语法:
drop table [if exists] 数据库1,...;IF EXISTS 的含义为:
如果当前数据库中存在相应的数据表,则删除数据表;
如果当前数据库中不存 在相应的数据表,则忽略删除语句,不再执行删除数据表的操作。
DROP TABLE 语句不能回滚
清空表
TRUNCATE TABLE语句:
删除表中所有的数据
释放表的存储空间
truncate table 表名;TRUNCATE语句不能回滚,而使用 DELETE 语句删除数据,可以回滚
DCL 中 COMMIT 和 ROLLBACK
COMMIT:提交数据。一旦执行COMMIT,则数据就被永久的保存在了数据库中,意味着数据不可以回滚。
ROLLBACK:回滚数据。一旦执行ROLLBACK,则可以实现数据的回滚。回滚到最近的一次COMMIT之后。
对比 TRUNCATE TABLE 和 DELETE FROM
相同点:都可以实现对表中所有数据的删除,同时保留表结构。
不同点:
TRUNCATE TABLE:一旦执行此操作,表数据全部清除。同时,数据是不可以回滚的。
DELETE FROM:一旦执行此操作,表数据可以全部清除(不带WHERE)。同时,数据是可以实现回滚的。
DDL 和 DML 的说明 ① DDL的操作一旦执行,就不可回滚。指令SET autocommit = FALSE对DDL操作失效。(因为在执行完DDL 操作之后,一定会执行一次COMMIT。而此COMMIT操作不受SET autocommit = FALSE影响的。)
② DML的操作默认情况,一旦执行,也是不可回滚的。但是,如果在执行DML之前,执行了 SET autocommit = FALSE,则执行的DML操作就可以实现回滚。
#例
commit;
语句....
rollback;阿里开发规范: 【参考】TRUNCATE TABLE 比 DELETE 速度快,且使用的系统和事务日志资源少,但 TRUNCATE 无 事务且不触发 TRIGGER,有可能造成事故,故不建议在开发代码中使用此语句。 说明:TRUNCATE TABLE 在功能上与不带 WHERE 子句的 DELETE 语句相同。
内容拓展
拓展1:阿里巴巴《Java开发手册》之MySQL字段命名
【 **强制 】**表名、字段名必须使用小写字母或数字,禁止出现数字开头,禁止两个下划线中间只出 现数字。数据库字段名的修改代价很大,因为无法进行预发布,所以字段名称需要慎重考虑。
正例:aliyun_admin,rdc_config,level3_name
反例:AliyunAdmin,rdcConfig,level_3_name
【 强制 】禁用保留字,如 desc、range、match、delayed 等,请参考 MySQL 官方保留字。
【 强制 】表必备三字段:id, gmt_create, gmt_modified。
说明:其中 id 必为主键,类型为BIGINT UNSIGNED、单表时自增、步长为 1。gmt_create, gmt_modified 的类型均为 DATETIME 类型,前者现在时表示主动式创建,后者过去分词表示被 动式更新
【 推荐 】表的命名最好是遵循 “业务名称_表的作用”。
正例:alipay_task 、 force_project、 trade_config
【 推荐 】库名与应用名称尽量一致。
【参考】合适的字符存储长度,不但节约数据库表空间、节约索引存储,更重要的是提升检索速 度。
拓展2:如何理解清空表、删除表等操作需谨慎?!
表删除 操作将把表的定义和表中的数据一起删除,并且MySQL在执行删除操作时,不会有任何的确认信 息提示,因此执行删除操时应当慎重。在删除表前,最好对表中的数据进行 备份 ,这样当操作失误时可 以对数据进行恢复,以免造成无法挽回的后果。
同样的,在使用 ALTER TABLE 进行表的基本修改操作时,在执行操作过程之前,也应该确保对数据进 行完整的 备份 ,因为数据库的改变是 无法撤销 的,如果添加了一个不需要的字段,可以将其删除;相 同的,如果删除了一个需要的列,该列下面的所有数据都将会丢失。
拓展3:MySQL8新特性—DDL的原子化
在MySQL 8.0版本中,InnoDB表的DDL支持事务完整性,即 DDL操作要么成功要么回滚 。DDL操作回滚日志 写入到data dictionary数据字典表mysql.innodb_ddl_log(该表是隐藏的表,通过show tables无法看到) 中,用于回滚操作。通过设置参数,可将DDL操作日志打印输出到MySQL错误日志中。
数据处理之增删改
插入数据(insert into )
方式1:直接用插入语句
insert into 表名 (column1,column2,...)#column为指定插入的字段名
values
(value1,value2,...)#对应column的数据类型
(value1,value2,...)使用INSERT同时插入多条记录时,MySQL会返回一些在执行单行插入时没有的额外信息,这些信息的含 义如下: ● Records:表明插入的记录条数。 ● Duplicates:表明插入时被忽略的记录,原因可能是这 些记录包含了重复的主键值。 ● Warnings:表明有问题的数据值,例如发生数据类型转换。
一个同时插入多行记录的INSERT语句等同于多个单行插入的INSERT语句,但是多行的INSERT语句 在处理过程中 效率更高 。因为MySQL执行单条INSERT语句插入多行数据比使用多条INSERT语句 快,所以在插入多条记录时最好选择使用单条INSERT语句的方式插入。
VALUES 也可以写成 VALUE ,但是VALUES是标准写法。
字符和日期型数据应包含在单引号中。
方式2:将查询结果插入到表中
INSERT INTO emp1(id,NAME,salary,hire_date)
#查询语句
SELECT employee_id,last_name,salary,hire_date # 查询的字段一定要与添加到的表的字段一一对应
FROM employees
WHERE department_id IN (70,60);说明:emp1表中要添加数据的字段的长度不能低于employees表中查询的字段的长度。
如果emp1表中要添加数据的字段的长度低于employees表中查询的字段的长度的话,就有添加不成功的风险。
●在 INSERT 语句中加入子查询。
● 不必书写 VALUES 子句。
●子查询中的值列表应与 INSERT 子句中的列名对应。
更新数据(update)
语法: UPDATE .... SET .... WHERE ...
UPDATE table_name
SET column1=value1, column2=value2, … , column=valueN
[WHERE condition]●可以一次更新多条数据。
●如果需要回滚数据,需要保证在DML前,进行设置:SET AUTOCOMMIT = FALSE
● 使用 WHERE 子句指定需要更新的数据。
● 如果省略 WHERE 子句,则表中的所有数据都将被更新。
更新中的数据完整性错误
UPDATE employees
SET department_id = 55
WHERE department_id = 110;说明:不存在 55 号部门
删除数据(delete)
删除数据 DELETE FROM .... WHERE....
delete from table_name [where <condition>];
#table_name指定要执行删除操作的表;“[WHERE ]”为可选参数,指定删除条件,如果没有WHERE子句,
DELETE语句将删除表中的所有记录。
#使用 WHERE 子句删除指定的记录。
delete from departments
where department_name = 'Finance';
#如果省略 WHERE 子句,则表中的全部数据将被删除
delete from departments;
#删除中的数据完整性错误
#在删除数据时,也有可能因为约束的影响,导致删除失败
DELETE FROM departments
WHERE department_id = 50;
#小结:DML操作默认情况下,执行完以后都会自动提交数据。
# 如果希望执行完以后不自动提交数据,则需要使用 SET autocommit = FALSE.#在删除数据时,也有可能因为约束的影响,导致删除失败
说明:You cannot delete a row that contains a primary key that is used as a foreign key in another table.
MySQL8新特性:计算列
什么叫计算列呢?简单来说就是某一列的值是通过别的列计算得来的。例如,a列值为1、b列值为2,c列 不需要手动插入,定义a+b的结果为c的值,那么c就是计算列,是通过别的列计算得来的。 在MySQL 8.0中,CREATE TABLE 和 ALTER TABLE 中都支持增加计算列。下面以CREATE TABLE为例进行讲 解。 举例:定义数据表tb1,然后定义字段id、字段a、字段b和字段c,其中字段c为计算列,用于计算a+b的 值。 首先创建测试表tb1,语句如下:
CREATE TABLE tb1(
id INT,
a INT,
b INT,
c INT GENERATED ALWAYS AS (a + b) VIRTUAL
);关键子:generated always as (计算式)
列名 类型
[GENERATED ALWAYS] AS (expr) [VIRTUAL | STORED]
[NOT NULL | NULL]
[UNIQUE [KEY]]
[[PRIMARY] KEY]
[COMMENT 'string']
说明: (1)AS(expr)用于生成计算列值的表达式。 (2)VIRTUAL或STORED关键字表示是否存储计算列的值: VIRTUAL:列值不存储,虚拟列不占用存储空间,默认设置为VIRTUAL。 STORED:在添加或更新行时计算并存储列值。存储列需要存储空间,并且可以创建索引
计算列表达式的要求
Generated column表达式必须遵循以下规则。如果表达式包含不允许的定义方式,则会发生错误。
(1)允许使用文本、内置函数和运算符,但不能使用返回值不确定的函数,比如NOW()。 (2)不允许使用存储函数和用户定义函数。 (3)不允许使用存储过程和函数参数。 (4)不允许使用变量(系统变量、用户定义变量和存储程序的局部变量)。 (5)不允许子查询。 (6)计算列在定义时可以引用其他的计算列,但只能引用表定义中较早出现的列。 (7)可以在计算列上创建索引,但不能在VIRTUAL类型的计算列上创建聚集索引。
约束
约束(constraint)概述
数据完整性(Data Integrity)是指数据的精确性(Accuracy)和可靠性(Reliability)。它是防止数据库中 存在不符合语义规定的数据和防止因错误信息的输入输出造成无效操作或错误信息而提出的。
为了保证数据的完整性,SQL规范以约束的方式对表数据进行额外的条件限制。从以下四个方面考虑:
实体完整性(Entity Integrity) :例如,同一个表中,不能存在两条完全相同无法区分的记录
域完整性(Domain Integrity) :例如:年龄范围0-120,性别范围“男/女”
引用完整性(Referential Integrity) :例如:员工所在部门,在部门表中要能找到这个部门
用户自定义完整性(User-defined Integrity) :例如:用户名唯一、密码不能为空等,本部门 经理的工资不得高于本部门职工的平均工资的5倍。
约束是表级的强制规定。 可以在创建表时规定约束(通过 CREATE TABLE 语句),或者在表创建之后通过 ALTER TABLE 语句规定 约束。
什么是约束
约束是表级的强制规定。
可以在创建表时规定约束(通过 CREATE TABLE 语句),或者在表创建之后通过 ALTER TABLE 语句规定 约束。
约束的分类
根据约束数据列的限制,约束可分为:
单列约束:每个约束只约束一列
多列约束:每个约束可约束多列数据
根据约束的作用范围,约束可分为:
列级约束:只能作用在一个列上,跟在列的定义后面
表级约束:可以作用在多个列上,不与列一起,而是单独定义
| 位置 | 支持的约束类型 | 是否可以起约束名 | |
|---|---|---|---|
| 列级约束: | 列的后面 | 语法都支持,但外键没有效果 | 不可以 |
| 表级约束: | 所有列的下面 | 默认和非空不支持,其他支持 | 可以(主键没有效果) |
根据约束起的作用,约束可分为:
●NOT NULL 非空约束,规定某个字段不能为空 无表级约束
●UNIQUE 唯一约束,规定某个字段在整个表中是唯一的
●PRIMARY KEY 主键(非空且唯一)约束
●FOREIGN KEY 外键约束
●CHECK 检查约束
●DEFAULT 默认值约束
注意: MySQL不支持check约束,但可以使用check约束,而没有任何效果
#information_schema数据库名(系统库)
#table_constraints表名称(专门存储各个表的约束)
SELECT * FROM information_schema.table_constraints
WHERE table_name = '表名称';非空约束
作用
限定某个字段/某列的值不允许为空
关键字
NOT NULL
特点
●默认,所有的类型的值都可以是NULL,包括INT、FLOAT等数据类型
●非空约束只能出现在表对象的列上,只能某个列单独限定非空,不能组合非空
●一个表可以有很多列都分别限定了非空
●空字符串''不等于NULL,0也不等于NUL
添加非空约束
#(1)建表时
#对某字段添加非空,在字段后加not null(列级约束)无表级标记约束
create table 表名(
字段名,数据类型 ,
字段名2,数据类型 not null,
字段3,数据类型 not null
);
#建表后
alter table 表名称 modify(
字段名1 数据类型 not null,
字段名2 数据类型 not null,
...
) ;删除非空约束
alter table 表名
modify 字段名 数据类型 null;
或
alter table 表名称
modify 字段名 数据类型; 唯一性约束
作用
用来限制某个字段/某列的值不能重复。
关键字
UNIQUE(unique),unique key 和unique是一样的,只是省略了key
特点
●同一个表可以有多,个唯一约束。
●唯一约束可以是某一个列的值唯一,也可以多个列组合的值唯一。
● 唯一性约束允许列值为空。
● 在创建唯一约束的时候,如果不给唯一约束命名,就默认和列名相同。
● MySQL会给唯一约束的列上默认创建一个唯一索引。
添加唯一约束
#(1)建表时
create table 表名称(
字段名 数据类型,
字段名 数据类型 unique,
字段名 数据类型 unique key,
字段名 数据类型
);
create table 表名称(
字段名 数据类型,
字段名 数据类型,
字段名 数据类型,
[constraint 约束名] unique key(字段名)#表级约束
);#例:列级约束
create table student (
s_id int unique,
s_tel char(11) unique
);
#表级约束
CREATE TABLE USER(
id INT NOT NULL,
NAME VARCHAR(25),
PASSWORD VARCHAR(16),
-- 使用表级约束语法
constraint uk_name_pwd UNIQUE(NAME,PASSWORD)#表示用户名和密码组合不能重复(复合约束)
);#建表后指定唯一键约束
#字段列表中如果是一个字段,表示该列的值唯一。如果是两个或更多个字段,那么复合唯一,即多个字段的组合是唯
一的
#方式1:
alter table 表名称 add unique key(字段列表);
#方式2:
alter table 表名称 modify 字段名 字段类型 unique;关于复合唯一约束
create table 表名称(
字段名 数据类型,
字段名 数据类型,
字段名 数据类型,
unique key(字段列表) #字段列表中写的是多个字段名,多个字段名用逗号分隔,表示那么是复合唯一,即多个字段的组合是唯一的
);
删除唯一约束
●添加唯一性约束的列上也会自动创建唯一索引。
●删除唯一约束只能通过删除唯一索引的方式删除。
● 删除时需要指定唯一索引名,唯一索引名就和唯一约束名一样。
● 如果创建唯一约束时未指定名称,如果是单列,就默认和列名相同;如果是组合列,那么默认和() 中排在第一个的列名相同。也可以自定义唯一性约束名。
ALTER TABLE test2
DROP INDEX last_name;#未指定名称
ALTER TABLE test2
DROP INDEX uk_test2_sal;#指定名称注意:可以通过 show index from 表名称; 查看表的索引
PRIMARY KEY 约束=主键约束
作用
用来唯一标识表中的一行记录。
关键字
primary key
特点
主键约束相当于唯一约束+非空约束的组合(unique+not null),主键约束列不允许重复,也不允许出现空值。
●一个表最多只能有一个主键约束,建立主键约束可以在列级别创建,也可以在表级别上创建。
●主键约束对应着表中的一列或者多列(复合主键)
● 如果是多列组合的复合主键约束,那么这些列都不允许为空值,并且组合的值不允许重复。
●MySQL的主键名总是PRIMARY,就算自己命名了主键约束名也没用。
● 当创建主键约束时,系统默认会在所在的列或列组合上建立对应的主键索引(能够根据主键查询 的,就根据主键查询,效率更高)。如果删除主键约束了,主键约束对应的索引就自动删除了。
●需要注意的一点是,不要修改主键字段的值。因为主键是数据记录的唯一标识,如果修改了主键的 值,就有可能会破坏数据的完整性
添加主键约束
#(1)建表时指定主键约束
create table 表名称(
字段名 数据类型 primary key, #列级模式
字段名 数据类型,
字段名 数据类型
);
create table 表名称(
字段名 数据类型,
字段名 数据类型,
字段名 数据类型,
[constraint 约束名] primary key(字段名) #表级模式
);
#(2)建表后增加主键约束
ALTER TABLE 表名称 ADD PRIMARY KEY(字段列表); #字段列表可以是一个字段,也可以是多个字段,如果是多个字段的话,是复合主键
关于复合主键
create table 表名称(
字段名 数据类型,
字段名 数据类型,
字段名 数据类型,
primary key(字段名1,字段名2) #表示字段1和字段2的组合是唯一的,也可以有更多个字段
);
删除主键约束
alter table 表名称 drop primary key;说明:删除主键约束,不需要指定主键名,因为一个表只有一个主键,删除主键约束后,非空还存 在。
自增列:AUTO_INCREMENT
作用
某个字段的值自增
关键字
auto_increment
特点和要求
(1)一个表最多只能有一个自增长列
(2)当需要产生唯一标识符或顺序值时,可设置自增长
(3)自增长列约束的列必须是键列(主键列,唯一键列)
(4)自增约束的列的数据类型必须是整数类型
(5)如果自增列指定了 0 和 null,会在当前最大值的基础上自增;如果自增列手动指定了具体值,直接 赋值为具体值。
如何指定自增约束
#(1)建表时
create table 表名称(
字段名 数据类型 primary key auto_increment,
字段名 数据类型 unique key not null,
字段名 数据类型 unique key,
字段名 数据类型 not null default 默认值,
);
create table 表名称(
字段名 数据类型 default 默认值 ,
字段名 数据类型 unique key auto_increment,
字段名 数据类型 not null default 默认值,,
primary key(字段名)
);
#例
create table employee (
eid int primary key auto_increment
ename varchar(20)
);
#(2)建表后
alter table 表名称 modify 字段名 数据类型 auto_increment;
#例
create table employee(
eid int primary key ,
ename varchar(20)
);
alter table employee modify eid int auto_increment;如何删除自增约束
#alter table 表名称 modify 字段名 数据类型 auto_increment;#给这个字段增加自增约束
alter table 表名称 modify 字段名 数据类型; #去掉auto_increment相当于删除
#例
alter table employee modify eid int;
MySQL 8.0新特性—自增变量的持久化
在MySQL 8.0之前,自增主键AUTO_INCREMENT的值如果大于max(primary key)+1,在MySQL重启后,会重 置AUTO_INCREMENT=max(primary key)+1,这种现象在某些情况下会导致业务主键冲突或者其他难以发 现的问题。
即插入数据后,删除中间某一字段,如1,2,3,4。删除3,然后再插入一个数据,本应该4往前变3,插入为4.但是mysql5.7版本插入为5,中间删除的3没有往前。在mysql8.0中是可以自增主键持久化,把中间删除的3往前分配的。
因为:在MySQL 5.7系统中,对于自增主键的分配规则,是由InnoDB数据字典 内部一个 计数器 来决定的,而该计数器只在 内存中维护 ,并不会持久化到磁盘中。当数据库重启时,该 计数器会被初始化。
FOREIGN KEY 约束=外键约束
作用
限定某个表的某个字段的引用完整性。 比如:员工表的员工所在部门的选择,必须在部门表能找到对应的部分。
关键字
FOREIGN KEY
主表和从表/父表和子表
主表(父表):被引用的表,被参考的表
从表(子表):引用别人的表,参考别人的表
例如:员工表的员工所在部门这个字段的值要参考部门表:部门表是主表,员工表是从表。
例如:学生表、课程表、选课表:选课表的学生和课程要分别参考学生表和课程表,学生表和课程表是 主表,选课表是从表。
特点
(1)从表的外键列,必须引用/参考主表的主键或唯一约束的列
为什么?因为被依赖/被参考的值必须是唯一的
(2)在创建外键约束时,如果不给外键约束命名,默认名不是列名,而是自动产生一个外键名(例如 student_ibfk_1;),也可以指定外键约束名。
(3)创建(CREATE)表时就指定外键约束的话,先创建主表,再创建从表
(4)删表时,先删从表(或先删除外键约束),再删除主表
(5)当主表的记录被从表参照时,主表的记录将不允许删除,如果要删除数据,需要先删除从表中依赖 该记录的数据,然后才可以删除主表的数据
(6)在“从表”中指定外键约束,并且一个表可以建立多个外键约束
(7)从表的外键列与主表被参照的列名字可以不相同,但是数据类型必须一样,逻辑意义一致。如果类 型不一样,创建子表时,就会出现错误“ERROR 1005 (HY000): Can't create table'database.tablename'(errno: 150)”。 例如:都是表示部门编号,都是int类型
(8)当创建外键约束时,系统默认会在所在的列上建立对应的普通索引。但是索引名是外键的约束 名。(根据外键查询效率很高)
(9)删除外键约束后,必须 手动 删除对应的索引
添加外键约束
(1)建表时
create table 主表名称(
字段1 数据类型 primary key,
字段2 数据类型
);
create table 从表名称(
字段1 数据类型 primary key,
字段2 数据类型,
[CONSTRAINT <外键约束名称>] FOREIGN KEY(从表的某个字段) references 主表名(被参考字段)
);
#(从表的某个字段)的数据类型必须与主表名(被参考字段)的数据类型一致,逻辑意义也一样
#(从表的某个字段)的字段名可以与主表名(被参考字段)的字段名一样,也可以不一样
-- FOREIGN KEY: 在表级指定子表中的列
-- REFERENCES: 标示在父表中的列
#例
create table dept( #主表
did int primary key, #部门编号
dname varchar(50) #部门名称
);
create table emp(#从表
eid int primary key, #员工编号
ename varchar(5), #员工姓名
deptid int, #员工所在的部门
foreign key (deptid) references dept(did) #在从表中指定外键约束
#emp表的deptid和和dept表的did的数据类型一致,意义都是表示部门的编号
);
/*说明:
(1)主表dept必须先创建成功,然后才能创建emp表,指定外键成功。
(2)删除表时,先删除从表emp,再删除主表dept*/
#(2)建表后
/*一般情况下,表与表的关联都是提前设计好了的,因此,会在创建表的时候就把外键约束定义好。不
过,如果需要修改表的设计(比如添加新的字段,增加新的关联关系),但没有预先定义外键约束,那
么,就要用修改表的方式来补充定义。
*/
ALTER TABLE 从表名 ADD [CONSTRAINT 约束名] FOREIGN KEY (从表的字段) REFERENCES 主表名(被引用
字段) [on update xx][on delete xx];#xx是约束等级演示问题
总结:约束关系是针对双方的
添加了外键约束后,主表的修改和删除数据受约束
添加了外键约束后,从表的添加和修改数据受约束
在从表上建立外键,要求主表必须存在
删除主表时,要求从表从表先删除,或将从表中外键引用该主表的关系先删除
约束等级
●Cascade方式 :在父表上update/delete记录时,同步update/delete掉子表的匹配记录
●Set null方式 :在父表上update/delete记录时,将子表上匹配记录的列设为null,但是要注意子 表的外键列不能为not null
●No action方式 :如果子表中有匹配的记录,则不允许对父表对应候选键进行update/delete操作
●Restrict方式 :同no action, 都是立即检查外键约束
●Set default方式 (在可视化工具SQLyog中可能显示空白):父表有变更时,子表将外键列设置 成一个默认的值,但Innodb不能识别
●如果没有指定等级,就相当于Restrict方式。
对于外键约束,最好是采用: ON UPDATE CASCADE ON DELETE RESTRICT 的方式。
#(1)演示1:on update cascade on delete set null 即on update (更新) cascade(联级)=主表和从表同步更新,on delete set null 主表数据删除,从表数据对应null
/*把修改操作设置为级联修改等级,把删除操作设置为set null等级,即主表的数据修改后,从表也一起修改,主表的数据删除后,从表的数据为null*/
create table dept(
did int primary key, #部门编号
dname varchar(50) #部门名称
);
create table emp(
eid int primary key, #员工编号
ename varchar(5), #员工姓名
deptid int, #员工所在的部门
foreign key (deptid) references dept(did) on update cascade on delete set null
#把修改操作设置为级联修改等级,把删除操作设置为set null等级
);
#(2)演示2:on update set null on delete cascad
/*把修改操作设置为set null等级,把删除操作设置为级联删除等级
主表的修改,从表不会变,主表的删除,从表也会删除
*/
create table dept(
did int primary key, #部门编号
dname varchar(50) #部门名称
);
create table emp(
eid int primary key, #员工编号
ename varchar(5), #员工姓名
deptid int, #员工所在的部门
foreign key (deptid) references dept(did) on update set null on delete cascade
#把修改操作设置为set null等级,把删除操作设置为级联删除等级
);
#(3)演示:on update cascade on delete cascade
create table dept(
did int primary key, #部门编号
dname varchar(50) #部门名称
);
create table emp(
eid int primary key, #员工编号
ename varchar(5), #员工姓名
deptid int, #员工所在的部门
foreign key (deptid) references dept(did) on update cascade on delete cascade
#把修改操作设置为级联修改等级,把删除操作也设置为级联删除等级
);
删除外键约束
#(1)第一步先查看约束名和删除外键约束
SELECT * FROM information_schema.table_constraints WHERE table_name = '表名称';#查看某个表的约束名
ALTER TABLE 从表名 DROP FOREIGN KEY 外键约束名;
#(2)第二步查看索引名和删除索引。(注意,只能手动删除)
SHOW INDEX FROM 表名称; #查看某个表的索引名
ALTER TABLE 从表名 DROP INDEX 索引名;开发场景
问题1:如果两个表之间有关系(一对一、一对多),比如:员工表和部门表(一对多),它们之间是否 一定要建外键约束? 答:不是的
问题2:建和不建外键约束有什么区别?
答:建外键约束,你的操作(创建表、删除表、添加、修改、删除)会受到限制,从语法层面受到限 制。例如:在员工表中不可能添加一个员工信息,它的部门的值在部门表中找不到。
不建外键约束,你的操作(创建表、删除表、添加、修改、删除)不受限制,要保证数据的 引用完整 性 ,只能依 靠程序员的自觉 ,或者是 在Java程序中进行限定 。例如:在员工表中,可以添加一个员工的 信息,它的部门指定为一个完全不存在的部门。
问题3:那么建和不建外键约束和查询有没有关系? 答:没有
在 MySQL 里,外键约束是有成本的,需要消耗系统资源。对于大并发的 SQL 操作,有可能会不适 合。比如大型网站的中央数据库,可能会 因为外键约束的系统开销而变得非常慢 。所以, MySQL 允 许你不使用系统自带的外键约束,在 应用层面 完成检查数据一致性的逻辑。也就是说,即使你不 用外键约束,也要想办法通过应用层面的附加逻辑,来实现外键约束的功能,确保数据的一致性。
阿里开发规范
【 强制 】不得使用外键与级联,一切外键概念必须在应用层解决。 说明:(概念解释)学生表中的 student_id 是主键,那么成绩表中的 student_id 则为外键。如果更新学 生表中的 student_id,同时触发成绩表中的 student_id 更新,即为级联更新。外键与级联更新适用于 单 机低并发 ,不适合 分布式 、 高并发集群 ;级联更新是强阻塞,存在数据库 更新风暴 的风险;外键影响 数据库的 插入速度 。
CHECK 约束
作用
检查某个字段的值是否符号xx要求,一般指的是值的范围
关键字
CHECK
说明:MySQL 5.7 不支持
MySQL5.7 可以使用check约束,但check约束对数据验证没有任何作用。添加数据时,没有任何错误或警 告 但是MySQL 8.0中可以使用check约束了
create table employee(
eid int primary key,
ename varchar(5),
gender char check ('男' or '女')
);
insert into employee values(1,'张三','妖');
DEFAULT约束
作用
给某个字段/某列指定默认值,一旦设置默认值,在插入数据时,如果此字段没有显式赋值,则赋值为默 认值。
关键字
DEFAULT
如何给字段加默认值
#(1)建表时
create table 表名称(
字段名 数据类型 primary key,
字段名 数据类型 unique key not null,
字段名 数据类型 unique key,
字段名 数据类型 not null default 默认值,
);
create table 表名称(
再举例:
字段名 数据类型 default 默认值 ,
字段名 数据类型 not null default 默认值,
字段名 数据类型 not null default 默认值,
primary key(字段名),
unique key(字段名)
);
#说明:默认值约束一般不在唯一键和主键列上加
#例:
create table employee(
eid int primary key,
ename varchar(20) not null,
gender char default '男',
tel char(11) not null default '' #默认是空字符串
);
#(2)建表后
alter table 表名称 modify 字段名 数据类型 default 默认值;
#如果这个字段原来有非空约束,你还保留非空约束,那么在加默认值约束时,还得保留非空约束,否则非空约束就被删除了
#同理,在给某个字段加非空约束也一样,如果这个字段原来有默认值约束,你想保留,也要在modify语句中保留默认值约束,否则就删除了
alter table 表名称 modify 字段名 数据类型 default 默认值 not null;
#例
alter table employee modify tel char(11) default '' not null;#给tel字段增加默认值约束,并保留非空约束
如何删除默认值约束
#例
alter table employee modify gender char; #删除gender字段默认值约束,如果有非空约束,也一并删除
alter table employee modify tel char(11) not null;#删除tel字段默认值约束,保留非空约束面试
面试1、为什么建表时,加 not null default '' 或 default 0
答:不想让表中出现null值。
面试2、为什么不想要 null 的值
答:
(1)不好比较。null是一种特殊值,比较时只能用专门的is null 和 is not null来比较。碰到运算符,通常返回null。
(2)效率不高。影响提高索引效果。因此,我们往往在建表时 not null default '' 或 default 0
面试3、带AUTO_INCREMENT约束的字段值是从1开始的吗?
在MySQL中,默认AUTO_INCREMENT的初始 值是1,每新增一条记录,字段值自动加1。设置自增属性(AUTO_INCREMENT)的时候,还可以指定第 一条插入记录的自增字段的值,这样新插入的记录的自增字段值从初始值开始递增,如在表中插入第一 条记录,同时指定id值为5,则以后插入的记录的id值就会从6开始往上增加。添加主键约束时,往往需要 设置字段自动增加属性。
面试4、并不是每个表都可以任意选择存储引擎?
外键约束(FOREIGN KEY)不能跨引擎使用。 MySQL支持多种存储引擎,每一个表都可以指定一个不同的存储引擎,需要注意的是:外键约束是用来 保证数据的参照完整性的,如果表之间需要关联外键,却指定了不同的存储引擎,那么这些表之间是不 能创建外键约束的。所以说,存储引擎的选择也不完全是随意的。
视图
常见的数据库对象
| 对象 | 描述 |
|---|---|
| 表(TABLE) | 表是存储数据的逻辑单元,以行和列的形式存在,列就是字段,行就是记录 |
| 数据字典 | 就是系统表,存放数据库相关信息的表。系统表的数据通常由数据库系统维护, 程序员通常不应该修改,只可查看 |
| 约束 (CONSTRAINT) | 执行数据校验的规则,用于保证数据完整性的规则 |
| 视图(VIEW) | 一个或者多个数据表里的数据的逻辑显示,视图并不存储数据 |
| 索引(INDEX) | 用于提高查询性能,相当于书的目录 |
| 存储过程 (PROCEDURE) | 用于完成一次完整的业务处理,没有返回值,但可通过传出参数将多个值传给调 用环境 |
| 存储函数 (FUNCTION) | 用于完成一次特定的计算,具有一个返回值 |
| 触发器 (TRIGGER) | 相当于一个事件监听器,当数据库发生特定事件后,触发器被触发,完成相应的 处理 |
视图概述
为什么使用视图?
视图一方面可以帮我们使用表的一部分而不是所有的表,另一方面也可以针对不同的用户制定不同的查询视图。比如,针对一个公司的销
售人员,我们只想给他看部分数据,而某些特殊的数据,比如采购的价格,则不会提供给他。再比如,人员薪酬是个敏感的字段,那么
只给某个级别以上的人员开放,其他 人的查询视图中则不提供这个字段。
刚才讲的只是视图的一个使用场景,实际上视图还有很多作用。最后,我们总结视图的优点。
视图的理解
视图是一种 虚拟表 ,本身是 不具有数据 的,占用很少的内存空间,它是 SQL 中的一个重要概念。
视图建立在已有表的基础上, 视图赖以建立的这些表称为基表。
视图的创建和删除只影响视图本身,不影响对应的基表。但是当对视图中的数据进行增加、删除和 修改操作时,数据表中的数据会相应地发生变化,反之亦然
向视图提供数据内容的语句为 SELECT 语句, 可以将视图理解为存储起来的 SELECT 语句
视图,是向用户提供基表数据的另一种表现形式。通常情况下,小型项目的数据库可以不使用视图,但是在大型项目中,以及数据表比较复杂的情况下,视图的价值就凸显出来了,它可以帮助我 们把经常查询的结果集放到虚拟表中,提升使用效率。理解和使用起来都非常方便。
创建视图
#在 CREATE VIEW 语句中嵌入子查询
CREATE [OR REPLACE]
[ALGORITHM = {UNDEFINED | MERGE | TEMPTABLE}]
VIEW 视图名称 [(字段列表)]
AS 查询语句
[WITH [CASCADED|LOCAL] CHECK OPTION]
#精简版
CREATE VIEW 视图名称
AS 查询语句创建单表视图
#例查询语句中字段的别名会作为视图中字段的名称出现
create view vu_depts
as
select employee_id,last_name,salary
from empts;
#在视图名称后添加字段名,对应as语句后的字段类型,创建的视图的名字为:视图名称后添加字段名
creat view vu_emp2(emp_id , name ,monthly_sal)
as
select employee_id,last_name,salary
from emps
where salary >8000;
#视图中的字段在基表中可能没有对应的字段
CREATE VIEW vu_emp_sal
AS
SELECT department_id,AVG(salary) avg_sal
FROM emps
WHERE department_id IS NOT NULL
GROUP BY department_id;创建多表联合视图
CREATE VIEW empview
AS
SELECT employee_id emp_id,last_name NAME,department_name
FROM employees e,departments d
WHERE e.department_id = d.department_id;
CREATE VIEW dept_sum_vu
(name, minsal, maxsal, avgsal)
AS
SELECT d.department_name, MIN(e.salary), MAX(e.salary),AVG(e.salary)
FROM employees e, departments d
WHERE e.department_id = d.department_id
GROUP BY d.department_name;
#利用视图对数据进行格式化
/*我们经常需要输出某个格式的内容,比如我们想输出员工姓名和对应的部门名,对应格式为
emp_name(department_name),就可以使用视图来完成数据格式化的操作:*/
CREATE VIEW emp_depart
AS
SELECT CONCAT(last_name,'(',department_name,')') AS emp_dept
FROM employees e JOIN departments d
WHERE e.department_id = d.department_id
基于视图创建视图
/*当我们创建好一张视图之后,还可以在它的基础上继续创建视图。
举例:联合“emp_dept”视图和“emp_year_salary”视图查询员工姓名、部门名称、年薪信息创建
“emp_dept_ysalary”视图。*/
CREATE VIEW emp_dept_ysalary
AS
SELECT emp_dept.ename,dname,year_salary
FROM emp_dept INNER JOIN emp_year_salary
ON emp_dept.ename = emp_year_salary.ename;查看视图
#语法1:查看数据库的表对象、视图对象
SHOW TABLES;
#语法2:查看视图的结构
DESC / DESCRIBE 视图名称;
#语法3:查看视图的属性信息
# 查看视图信息(显示数据表的存储引擎、版本、数据行数和数据大小等)
SHOW TABLE STATUS LIKE '视图名称'\G
/*执行结果显示,注释Comment为VIEW,说明该表为视图,其他的信息为NULL,说明这是一个虚表。*/
#语法4:查看视图的详细定义信息
SHOW CREATE VIEW 视图名称;更新视图的数据
一般情况
MySQL支持使用INSERT、UPDATE和DELETE语句对视图中的数据进行插入、更新和删除操作。当视图中的 数据发生变化时,数据表中的数据也会发生变化,反之亦然。
# update ... set ...
#delete from ....where
#insert into ....values()不可更新的视图
/*要使视图可更新,视图中的行和底层基本表中的行之间必须存在 一对一 的关系。另外当视图定义出现如
下情况时,视图不支持更新操作:
在定义视图的时候指定了“ALGORITHM = TEMPTABLE”,视图将不支持INSERT和DELETE操作;
视图中不包含基表中所有被定义为非空又未指定默认值的列,视图将不支持INSERT操作;
在定义视图的SELECT语句中使用了 JOIN联合查询 ,视图将不支持INSERT和DELETE操作;
在定义视图的SELECT语句后的字段列表中使用了 数学表达式 或 子查询 ,视图将不支持INSERT,也
不支持UPDATE使用了数学表达式、子查询的字段值;
在定义视图的SELECT语句后的字段列表中使用 DISTINCT 、 聚合函数 、 GROUP BY 、 HAVING 、
UNION 等,视图将不支持INSERT、UPDATE、DELETE;
在定义视图的SELECT语句中包含了子查询,而子查询中引用了FROM后面的表,视图将不支持
INSERT、UPDATE、DELETE;
视图定义基于一个 不可更新视图 ;
常量视图。*/
#例
mysql> CREATE OR REPLACE VIEW emp_dept
-> (ename,salary,birthday,tel,email,hiredate,dname)
-> AS SELECT ename,salary,birthday,tel,email,hiredate,dname
-> FROM t_employee INNER JOIN t_department
-> ON t_employee.did = t_department.did ;
Query OK, 0 rows affected (0.01 sec)
mysql> INSERT INTO emp_dept(ename,salary,birthday,tel,email,hiredate,dname)
-> VALUES('张三',15000,'1995-01-08','18201587896',
-> 'zs@atguigu.com','2022-02-14','新部门');
#ERROR 1393 (HY000): Can not modify more than one base table through a join view
'atguigu_chapter9.emp_dept'从上面的SQL执行结果可以看出,在定义视图的SELECT语句中使用了JOIN联合查询,视图将不支持更新 操作。
虽然可以更新视图数据,但总的来说,视图作为 虚拟表 ,主要用于 方便查询 ,不建议更新视图的 数据。对视图数据的更改,都是通过对实际数据表里数据的操作来完成的。
修改、删除视图
修改视图
#方式1:使用CREATE OR REPLACE VIEW 子句修改视图
#create or replace VIEW相当于创建视图,如果视图存在则替换视图
CREATE OR REPLACE VIEW empvu80
(id_number, name, sal, department_id)
AS
SELECT employee_id, first_name || ' ' || last_name, salary, department_id
FROM employees
WHERE department_id = 80;说明:CREATE VIEW 子句中各列的别名应和子查询中各列相对应。
#方式2:ALTER VIEW 修改视图的语法是:
alter view 视图名
as 查询语句删除视图
#删除视图只是删除视图的定义,并不会删除基表的数据。
#删除视图的语法是:
drop view if exists 视图名,....;说明:基于视图a、b创建了新的视图c,如果将视图a或者视图b删除,会导致视图c的查询失败。这 样的视图c需要手动删除或修改,否则影响使用。
总结
视图优点
- 操作简单
将经常使用的查询操作定义为视图,可以使开发人员不需要关心视图对应的数据表的结构、表与表之间 的关联关系,也不需要关心数据表之间的业务逻辑和查询条件,而只需要简单地操作视图即可,极大简 化了开发人员对数据库的操作。
- 减少数据冗余
视图跟实际数据表不一样,它存储的是查询语句。所以,在使用的时候,我们要通过定义视图的查询语 句来获取结果集。而视图本身不存储数据,不占用数据存储的资源,减少了数据冗余。
- 数据安全
MySQL将用户对数据的 访问限制 在某些数据的结果集上,而这些数据的结果集可以使用视图来实现。用 户不必直接查询或操作数据表。这也可以理解为视图具有 隔离性 。视图相当于在用户和实际的数据表之 间加了一层虚拟表。
同时,MySQL可以根据权限将用户对数据的访问限制在某些视图上,用**户不需要查询数据表,可以直接 通过视图获取数据表中的信息。**这在一定程度上保障了数据表中数据的安全性。
- 适应灵活多变的需求
当业务系统的需求发生变化后,如果需要改动数据表的结构,则工作量相对较 大,可以使用视图来减少改动的工作量。这种方式在实际工作中使用得比较多。
-
能够分解复杂的查询逻辑
数据库中如果存在复杂的查询逻辑,则可以将问题进行分解,创建多个视图获取数据,再将创建的多个视图结合起来,完成复杂的查询逻辑。
视图不足
如果我们在实际数据表的基础上创建了视图,那么,**如果实际数据表的结构变更了,我们就需要及时对相关的视图进行相应的维护。**特别是嵌套的视图(就是在视图的基础上创建视图),维护会变得比较复杂, 可读性不好 ,容易变成系统的潜在隐患。因为创建视图的 SQL 查询可能会对字段重命名,也可能包含复杂的逻辑,这些都会增加维护的成本。 实际项目中,如果视图过多,会导致数据库维护成本的问题。 所以,在创建视图的时候,你要结合实际项目需求,综合考虑视图的优点和不足,这样才能正确使用视图,使系统整体达到最优
存储过程与函数
1.存储过程概述
1.1理解
含义:存储过程的英文是 Stored Procedure (stored procedure) 。它的思想很简单,就是一组经过 预先编译 的 SQL 语句 的封装。
执行过程:存储过程预先存储在 MySQL 服务器上,需要执行的时候,客户端只需要向服务器端发出调用 存储过程的命令,服务器端就可以把预先存储好的这一系列 SQL 语句全部执行。
好处:
1、简化操作,提高了sql语句的重用性,减少了开发程序员的压力
2、减少操作过程中的失误,提高效率
3、减少网络传输量(客户端不需要把所有的 SQL 语句通过网络发给服务器)
4、减少了 SQL 语句暴露在 网上的风险,也提高了数据查询的安全性
和视图、函数的对比:
它和视图有着同样的优点,清晰、安全,还可以减少网络传输量。不过它和视图不同,视图是 虚拟表 , 通常不对底层数据表直接操作,而存储过程是程序化的 SQL,可以 直接操作底层数据表 ,相比于面向集 合的操作方式,能够实现一些更复杂的数据处理。
一旦存储过程被创建出来,使用它就像使用函数一样简单,我们直接通过调用存储过程名即可。相较于 函数,存储过程是 没有返回值 的。
1.2分类
存储过程的参数类型可以是IN、OUT和INOUT。根据这点分类如下:
1、没有参数(无参数无返回)
2、仅仅带 IN 类型(有参数无返回)
3、仅仅带 OUT 类型(无参数有返 回)
4、既带 IN 又带 OUT(有参数有返回)
5、带 INOUT(有参数有返回)
注意:IN、OUT、INOUT 都可以在一个存储过程中带多个。
2. 创建存储过程
2.1 语法分析
CREATE PROCEDURE 存储过程名(IN|OUT|INOUT 参数名 参数类型,...)
[characteristics ...]
BEGIN
存储过程体
END
说明:
1、参数前面的符号的意思
IN :当前参数为输入参数,也就是表示入参; 存储过程只是读取这个参数的值。如果没有定义参数种类, 默认就是 IN ,表示输入参数。
OUT :当前参数为输出参数,也就是表示出参; 执行完成之后,调用这个存储过程的客户端或者应用程序就可以读取这个参数返回的值了。
INOUT :当前参数既可以为输入参数,也可以为输出参数。
2、形参类型可以是 MySQL数据库中的任意类型。
3、 characteristics 表示创建存储过程时指定的对存储过程的约束条件,其取值信息如下:
LANGUAGE SQL
| [NOT] DETERMINISTIC
| { CONTAINS SQL | NO SQL | READS SQL DATA | MODIFIES SQL DATA }
| SQL SECURITY { DEFINER | INVOKER }
| COMMENT 'string'
●LANGUAGE SQL :说明存储过程执行体是由SQL语句组成的,当前系统支持的语言为SQL。
●[NOT] DETERMINISTIC :指明存储过程执行的结果是否确定。DETERMINISTIC表示结果是确定 的。每次执行存储过程时,相同的输入会得到相同的输出。NOT DETERMINISTIC表示结果是不确定 的,相同的输入可能得到不同的输出。如果没有指定任意一个值,默认为NOT DETERMINISTIC。
●{ CONTAINS SQL | NO SQL | READS SQL DATA | MODIFIES SQL DATA } :指明子程序使 用SQL语句的限制。
CONTAINS SQL表示当前存储过程的子程序包含SQL语句,但是并不包含读写数据的SQL语句;
NO SQL表示当前存储过程的子程序中不包含任何SQL语句;
READS SQL DATA表示当前存储过程的子程序中包含读数据的SQL语句;
MODIFIES SQL DATA表示当前存储过程的子程序中包含写数据的SQL语句。
默认情况下,系统会指定为CONTAINS SQL。
●SQL SECURITY { DEFINER | INVOKER } :执行当前存储过程的权限,即指明哪些用户能够执 行当前存储过程。
DEFINER 表示只有当前存储过程的创建者或者定义者才能执行当前存储过程;
INVOKER 表示拥有当前存储过程的访问权限的用户能够执行当前存储过程。
如果没有设置相关的值,则MySQL默认指定值为DEFINER。
●COMMENT 'string' :注释信息,可以用来描述存储过程。
4、存储过程体中可以有多条 SQL 语句,如果仅仅一条SQL 语句,则可以省略 BEGIN 和 END 编写存储过程并不是一件简单的事情,可能存储过程中需要复杂的 SQL 语句。
BEGIN…END:BEGIN…END 中间包含了多个语句,每个语句都以(;)号为结束符。
DECLARE:DECLARE 用来声明变量,使用的位置在于 BEGIN…END 语句中间,而且需要在其他语句使用之前进 行变量的声明。
SET:赋值语句,用于对变量进行赋值。
SELECT… INTO:把从数据表中查询的结果存放到变量中,也就是为变量赋值。
5、需要设置新的结束标记
DELIMITER 新的结束标记
因为MySQL默认的语句结束符号为分号‘;’。为了避免与存储过程中SQL语句结束符相冲突,需要使用 DELIMITER改变存储过程的结束符。 比如:“DELIMITER //”语句的作用是将MySQL的结束符设置为//,并以“END //”结束存储过程。存储过程定 义完毕之后再使用“DELIMITER ;”恢复默认结束符。DELIMITER也可以指定其他符号作为结束符。 当使用DELIMITER命令时,应该避免使用反斜杠(‘\’)字符,因为反斜线是MySQL的转义字符。
#示例:
DELIMITER $
CREATE PROCEDURE 存储过程名(IN|OUT|INOUT 参数名 参数类型,...)
[characteristics ...]
BEGIN
sql语句1;
sql语句2;
END $2.2 代码举例
举例1:创建存储过程select_all_data(),查看 emps 表的所有数据
delimiter $ #结束符为$
create procedure select_all_data()
begin
select * from emps;
end$ #结束
delimiter; #重新定义结束符为;不影响后面的语句
#2. 存储过程的调用
CALL select_all_data();举例2:创建存储过程avg_employee_salary(),返回所有员工的平均工资
delimiter $
create proudure avg_employee_salary()
begin
select avg(salary) as avg_salary from emps;
end $
delimiter ;举例3:创建存储过程show_max_salary(),用来查看“emps”表的最高薪资值。
delimiter $
create proudure show_max_salary()
language sql #用sql写的
not deterministic #结果不确定
contains sql #子程序包含SQL语句,但是并不包含读写数据的SQL语句
sql security definer#只有当前存储过程的创建者或者定义者才能执行当前存储过程
commint '查看最高薪资'
begin
select max(salary) as max_salary from emps;
end $
delimiter;举例4:创建存储过程show_min_salary(),查看“emps”表的最低薪资值。并将最低薪资通过OUT参数“ms” 输出
delimiter $
create procedure show_min_salary(out ms double )
begin
select min(salary) as min_salary from emps;
end $
delimiter $
#调用
CALL show_min_salary(@ms);
#查看变量值
SELECT @ms;类型3:带 IN 举例5:创建存储过程show_someone_salary(),查看“emps”表的某个员工的薪资,并用IN参数empname输入员工姓名。
delimiter $
create procedure show_someone_salary(in empname varchar(20))
begin
select salary from emps where last_name = empname;
end $
delimiter ;
#调用方式1
call show_min_salary('Abel');
#调用方式2
set @empname := 'Abel';
call show_min_salary('@empname');举例6:创建存储过程show_someone_salary2(),查看“emps”表的某个员工的薪资,并用IN参数empname 输入员工姓名,用OUT参数empsalary输出员工薪资。
delimiter $
create procedure show_someone_salary2(in empname varchar(20) ,out empsalary double )
begin
select salary into empsalary from emps where ename = empname;
end $
#调用
delimiter ;
set $empname = 'Abel';
call show_someone_salary2(@empname,@empsalary);举例7:创建存储过程show_mgr_name(),查询某个员工领导的姓名,并用INOUT参数“empname”输入员 工姓名,输出领导的姓名。
#类型5:带 INOUT
delimiter $
create procedure show_mgr_name(inout empname varchar(20))#这里有个点:设置的数据类型长度一定要比begin子句里面的长或者相等
begin
select last_name into empname
from emps
where e_id = (
select m_id from emps where last_name = empname
);
end $
delimiter ;
#调用
set @empname :='Abel';
call show_mgr_name(@empname);3. 调用存储过程
3.1 调用格式
存储过程有多种调用方法。存储过程必须使用CALL语句调用,并且存储过程和数据库相关,如果要执行 其他数据库中的存储过程,需要指定数据库名称,例如CALL dbname.procname。
CALL 存储过程名(实参列表)格式:
1、调用in模式的参数:
CALL 存储过程名('值');2、调用out模式的参数:
SET @name;
CALL 存储过程名(@name);
SELECT @name;3、调用inout模式的参数:
SET @name=值;
CALL sp1(@name);
SELECT @name;如果你用的是 Navicat 工具,那么在编写存储过程的时候,Navicat 会自动设置 DELIMITER 为其他符号, 我们不需要再进行 DELIMITER 的操作。
3.2 代码举例
3.3 如何调试
在 MySQL 中,存储过程不像普通的编程语言(比如 VC++、Java 等)那样有专门的集成开发环境。因 此,你可以通过 SELECT 语句,把程序执行的中间结果查询出来,来调试一个 SQL 语句的正确性。调试 成功之后,把 SELECT 语句后移到下一个 SQL 语句之后,再调试下一个 SQL 语句。这样 逐步推进 ,就可 以完成对存储过程中所有操作的调试了。当然,你也可以把存储过程中的 SQL 语句复制出来,逐段单独 调试。
4. 存储函数的使用
前面学习了很多函数,使用这些函数可以对数据进行的各种处理操作,极大地提高用户对数据库的管理 效率。MySQL支持自定义函数,定义好之后,调用方式与调用MySQL预定义的系统函数一样。
4.1 语法分析
学过的函数:LENGTH、SUBSTR、CONCAT等
create function 函数名(参数名 参数类型,...)
returns 返回值类型
[characteristics ...]
begin
函数体 #函数体中肯定有 return 语句
end说明:
1、参数列表:指定参数为IN、OUT或INOUT只对PROCEDURE是合法的,FUNCTION中总是默认为IN参 数。
2、RETURNS type 语句表示函数返回数据的类型;
RETURNS子句只能对FUNCTION做指定,对函数而言这是 强制 的。它用来指定函数的返回类型,而且函 数体必须包含一个 RETURN value 语句。
3、characteristic 创建函数时指定的对函数的约束。取值与创建存储过程时相同,这里不再赘述。
4、函数体也可以用BEGIN…END来表示SQL代码的开始和结束。如果函数体只有一条语句,也可以省略 BEGIN…END。
4.2 调用存储函数
在MySQL中,存储函数的使用方法与MySQL内部函数的使用方法是一样的。换言之,用户自己定义的存 储函数与MySQL内部函数是一个性质的。
区别在于,存储函数是 用户自己定义 的,而内部函数是MySQL 的 开发者定义 的。
select 函数名(实参列表)4.3 代码举例
举例1:创建存储函数,名称为email_by_name(),参数定义为空,该函数查询Abel的email,并返回,数据类型为 字符串型。
delimiter $
create function email_by_name()
returns varchar(25)
begin
return(select email from employees where last_name = 'Abel';)
end $
delimiter ;
#调用:
select email_by_name();举例2: 创建存储函数,名称为email_by_id(),参数传入emp_id,该函数查询emp_id的email,并返回,数据类型 为字符串型。
delimiter $
create function email_by_id(emp_id int)
returns varchar(20)
begin
return(
select email from employees where employee_id = emp_id
);
end $
delimiter ;
#调用
set @emp_id = 102;
select email_by_id(102);举例3: 创建存储函数count_by_id(),参数传入dept_id,该函数查询dept_id部门的员工人数,并返回,数据类型 为整型。
delimiter $
create function count_by_id(dept_id int )
returns int
begin
return(
select count(*) from departments where department_id = dept_id);
end $
delimiter ;
#调用
set @dept_id = 50;
select count_by_id(@dept_id);
注意:
若在创建存储函数中报错“ you might want to use the less safe log_bin_trust_function_creators variable ”,
错误原因
这是我们开启了bin-log, 我们就必须指定我们的函数是否是 1、DETERMINISTIC 不确定的 2、NO SQL 没有SQl语句,当然也不会修改数据 3、READS SQL DATA 只是读取数据,当然也不会修改数据 4、MODIFIES SQL DATA 要修改数据 5、CONTAINS SQL 包含了SQL语句
其中在function里面,只有 DETERMINISTIC, NO SQL 和 READS SQL DATA 被支持。 如果我们开启了 bin-log, 我们就必须为我们的function指定一个参数。
解决方案
思路:可以通过将变量 log_bin_trust_function_creators 的值设置为“开启”实现。
有两种处理方法:
方式1:加上必要的函数特性“[NOT] DETERMINISTIC”和“{CONTAINS SQL | NO SQL | READS SQL DATA MODIFIES SQL DATA}”
临时方案,MySQL服务重启会失效
SET GLOBAL log_bin_trust_function_creators = 1;
(永久方案,需要重启MySQL服务,配置才能生效) 在 my.cnf 配置文件中添加如下一行配置,然后重启MySQL服务
log_bin_trust_function_creators = 1
4.4 对比存储函数和存储过程
| 关键字 | 调用语法 | 返回值 | 应用场景 | |
|---|---|---|---|---|
| 存储过 程 | procedure | CALL 存储过 程() | 理解为有0个或 多个 | 一般用于更新 |
| 存储函 数 | function | SELECT 函数 () | 只能是一个 | 一般用于查询结果为一个值并 返回时 |
此外,存储函数可以放在查询语句中使用,存储过程不行。反之,存储过程的功能更加强大,包括能够 执行对表的操作(比如创建表,删除表等)和事务操作,这些功能是存储函数不具备的。
5. 存储过程和函数的查看、修改、删除错误原因
5.1 查看
创建完之后,怎么知道我们创建的存储过程、存储函数是否成功了呢?
MySQL存储了存储过程和函数的状态信息,用户可以使用SHOW STATUS语句或SHOW CREATE语句来查 看,也可直接从系统的information_schema数据库中查询。这里介绍3种方法。
- 使用SHOW CREATE语句查看存储过程和函数的创建信息
show create {procedure|function}存储过程名或函数名;- \3. 从information_schema.Routines表中查看存储过程和函数的信息
show {procedure|function}status {like 'pattern'}这个语句返回子程序的特征,如数据库、名字、类型、创建者及创建和修改日期。
[LIKE 'pattern']:匹配存储过程或函数的名称,可以省略。当省略不写时,会列出MySQL数据库中存在的 所有存储过程或函数的信息。
- 从information_schema.Routines表中查看存储过程和函数的信息
MySQL中存储过程和函数的信息存储在information_schema数据库下的Routines表中。可以通过查询该表 的记录来查询存储过程和函数的信息。其基本语法形式如下:
SELECT * FROM information_schema.Routines
WHERE ROUTINE_NAME='存储过程或函数的名' [AND ROUTINE_TYPE = {'PROCEDURE|FUNCTION'}];
说明:如果在MySQL数据库中存在存储过程和函数名称相同的情况,最好指定ROUTINE_TYPE查询条件来 指明查询的是存储过程还是函数。
5.2 修改
修改存储过程或函数,不影响存储过程或函数功能,只是修改相关特性。使用ALTER语句实现。
alter {procedure|function}存储过程或函数的名 [characteristic ...]其中,characteristic指定存储过程或函数的特性,其取值信息与创建存储过程、函数时的取值信息略有 不同。
{ CONTAINS SQL | NO SQL | READS SQL DATA | MODIFIES SQL DATA }
| SQL SECURITY { DEFINER | INVOKER }
| COMMENT 'string●CONTAINS SQL ,表示子程序包含SQL语句,但不包含读或写数据的语句。
●NO SQL ,表示子程序中不包含SQL语句。
●READS SQL DATA ,表示子程序中包含读数据的语句。
●MODIFIES SQL DATA ,表示子程序中包含写数据的语句。
●SQL SECURITY { DEFINER | INVOKER } ,指明谁有权限来执行。
DEFINER ,表示只有定义者自己才能够执行。 I
NVOKER ,表示调用者可以执行。
●COMMENT 'string' ,表示注释信息。
修改存储过程使用ALTER PROCEDURE语句,修改存储函数使用ALTER FUNCTION语句。但是,这两 个语句的结构是一样的,语句中的所有参数也是一样的。
5.3 删除
删除存储过程和函数,可以使用DROP语句,其语法结构如下:
drop {procedure |functon} [if exists] 存储过程或函数的名6. 关于存储过程使用的争议
尽管存储过程有诸多优点,但是对于存储过程的使用,一直都存在着很多争议,比如有些公司对于大型 项目要求使用存储过程,而有些公司在手册中明确禁止使用存储过程,为什么这些公司对存储过程的使 用需求差别这么大呢?
6.1 优点
1、存储过程可以一次编译多次使用。存储过程只在创建时进行编译,之后的使用都不需要重新编译, 这就提升了 SQL 的执行效率。
2、**可以减少开发工作量。**将代码 封装 成模块,实际上是编程的核心思想之一,这样可以把复杂的问题 拆解成不同的模块,然后模块之间可以 重复使用 ,在减少开发工作量的同时,还能保证代码的结构清 晰。
3、存储过程的安全性强。我们在设定存储过程的时候可以 设置对用户的使用权限 ,这样就和视图一样具 有较强的安全性。
4、**可以减少网络传输量。**因为代码封装到存储过程中,每次使用只需要调用存储过程即可,这样就减 少了网络传输量。
5、**良好的封装性。**在进行相对复杂的数据库操作时,原本需要使用一条一条的 SQL 语句,可能要连接 多次数据库才能完成的操作,现在变成了一次存储过程,只需要 连接一次即可 。
6.2 缺点
基于上面这些优点,不少大公司都要求大型项目使用存储过程,比如微软、IBM 等公司。但是国内的阿 里并不推荐开发人员使用存储过程,这是为什么呢?
阿里开发规范 【强制】禁止使用存储过程,存储过程难以调试和扩展,更没有移植性。
1、**可移植性差。**存储过程不能跨数据库移植,比如在 MySQL、Oracle 和 SQL Server 里编写的存储过 程,在换成其他数据库时都需要重新编写。
2、**调试困难。**只有少数 DBMS 支持存储过程的调试。对于复杂的存储过程来说,开发和维护都不容 易。虽然也有一些第三方工具可以对存储过程进行调试,但要收费。
3、**存储过程的版本管理很困难。**比如数据表索引发生变化了,可能会导致存储过程失效。我们在开发 软件的时候往往需要进行版本管理,但是存储过程本身没有版本控制,版本迭代更新的时候很麻烦。
4、**它不适合高并发的场景。**高并发的场景需要减少数据库的压力,有时数据库会采用分库分表的方 式,而且对可扩展性要求很高,在这种情况下,存储过程会变得难以维护, 增加数据库的压力 ,显然就 不适用了。
小结: 存储过程既方便,又有局限性。尽管不同的公司对存储过程的态度不一,但是对于我们开发人员来说, 不论怎样,掌握存储过程都是必备的技能之一
变量、流程控制与游标
1. 变量
在 MySQL 数据库中,变量分为 系统变量 以及 用户自定义变量 。
1.1 系统变量
1.1.1 系统变量分类
变量由系统定义,不是用户定义,属于 服务器 层面。启动MySQL服务,生成MySQL服务实例期间, MySQL将为MySQL服务器内存中的系统变量赋值,这些系统变量定义了当前MySQL服务实例的属性、特 征。这些系统变量的值要么是 编译MySQL时参数 的默认值,要么是 配置文件 (例如my.ini等)中的参数 值。大家可以通过网址 https://dev.mysql.com/doc/refman/8.0/en/server-systemvariables.html 查看MySQL文档的系统变量。
系统变量分为全局系统变量(需要添加 global 关键字)以及会话系统变量(需要添加 session 关键 字),有时也把全局系统变量简称为全局变量,有时也把会话系统变量称为local变量。如果不写,默认 会话级别。静态变量(在 MySQL 服务实例运行期间它们的值不能使用 set 动态修改)属于特殊的全局系 统变量。
1:全局系统变量针对于所有会话(连接)有效,但 不能跨重启
2:会话系统变量仅针对于当前会话(连接)有效。会话期间,当前会话对某个会话系统变量值的修 改,不会影响其他会话同一个会话系统变量的值。
3:会话1对某个全局系统变量值的修改会导致会话2中同一个全局系统变量值的修改
在MySQL中有些系统变量只能是全局的,例如 max_connections 用于限制服务器的最大连接数;有些系 统变量作用域既可以是全局又可以是会话,例如 character_set_client 用于设置客户端的字符集;有些系 统变量的作用域只能是当前会话,例如 pseudo_thread_id 用于标记当前会话的 MySQL 连接 ID。
1.1.2 查看系统变量
#查看所有或部分系统变量
#查看所有全局变量
show global variables;
#查看所有会话变量
show session variables;
#或
show variables ;(默认session变量)
#查看满足条件的部分系统变量。
show global variables like '%标识符%';
#查看满足条件的部分会话变量
show session variables like '%标识符%';查看指定系统变量
作为 MySQL 编码规范,MySQL 中的系统变量以 两个“@” 开头,其中“@@global”仅用于标记全局系统变 量,“@@session”仅用于标记会话系统变量。“@@”首先标记会话系统变量,如果会话系统变量不存在, 则标记全局系统变量。
#查看指定的系统变量的值
select @@global.变量名;
#查看指定的会话变量的值
select @@session.变量名;
#或
select @@变量名;
修改系统变量的值
有些时候,数据库管理员需要修改系统变量的默认值,以便修改当前会话或者MySQL服务实例的属性、 特征。具体方法:
方式1:修改MySQL 配置文件 ,继而修改MySQL系统变量的值(该方法需要重启MySQL服务)
方式2:在MySQL服务运行期间,使用“set”命令重新设置系统变量的值
#为某个系统变量赋值
#方式1:
SET @@global.变量名=变量值;
#方式2:
SET GLOBAL 变量名=变量值;
#为某个会话变量赋值
#方式1:
SET @@session.变量名=变量值;
#方式2:
SET SESSION 变量名=变量值;1.2 用户变量
1.2.1 用户变量分类
用户变量是用户自己定义的,作为 MySQL 编码规范,MySQL 中的用户变量以 一个“@” 开头。根据作用 范围不同,又分为 会话用户变量 和 局部变量 。
● 会话用户变量:作用域和会话变量一样,只对 当前连接 会话有效。
● 局部变量:只在 BEGIN 和 END 语句块中有效。局部变量只能在 存储过程和函数 中使用。
1.2.2 会话用户变量
#变量的定义
#方式1:“=”或“:=”
SET @用户变量 = 值;
SET @用户变量 := 值;
#方式2:“:=” 或 INTO关键字
SELECT @用户变量 := 表达式 [FROM 等子句];
SELECT 表达式 INTO @用户变量 [FROM 等子句];
#查看用户变量的值 (查看、比较、运算等)
SELECT @用户变量
1.2.3 局部变量
定义:可以使用 DECLARE 语句定义一个局部变量
作用域:仅仅在定义它的 BEGIN ... END 中有效
位置:只能放在 BEGIN ... END 中,而且只能放在第一句
begin
#声明局部变量
declare 变量名1 变量数据类型 [default 变量默认值];
declare 变量名2,变量名3,... 变量数据类型 [default 变量默认值];
#为局部变量赋值
set 变量1 = 值;
select 值 into 变量2 [from 子句];
#查看局部变量的值
select 变量1,....;
end #1.定义变量
declare 变量名 类型 [default 值]; # 如果没有DEFAULT子句,初始值为NULL
#2.变量赋值
#方式1:一般用于赋简单的值
SET 变量名=值;
SET 变量名:=值;
#方式2:一般用于赋表中的字段值
SELECT 字段名或表达式 INTO 变量名 FROM 表;
#3.使用变量(查看、比较、运算等)
SELECT 局部变量名;
举例1:声明局部变量,并分别赋值为employees表中employee_id为102的last_name和salary
delimiter $
create procedure set_value()
begin
declare emp_name varchar(25)
declare sal double(10,2)
select last_name, salary into emp_name ,sal
from employees
where employees_id = 102;
select emp_name, sal ;
end $
delimiter ;举例2:声明两个变量,求和并打印 (分别使用会话用户变量、局部变量的方式实现)
delimiter $
create procedure print_var()
begin
set @m=1;
set @n=2;
set @mn = @m+@n;
end $
delimiter ;举例3:创建存储过程“different_salary”查询某员工和他领导的薪资差距,并用IN参数emp_id接收员工 id,用OUT参数dif_salary输出薪资差距结果。
#声明
DELIMITER //
CREATE PROCEDURE different_salary(IN emp_id INT,OUT dif_salary DOUBLE)
BEGIN
#声明局部变量
DECLARE emp_sal,mgr_sal DOUBLE DEFAULT 0.0;
DECLARE mgr_id INT;
SELECT salary INTO emp_sal FROM employees WHERE employee_id = emp_id;
SELECT manager_id INTO mgr_id FROM employees WHERE employee_id = emp_id;
SELECT salary INTO mgr_sal FROM employees WHERE employee_id = mgr_id;
SET dif_salary = mgr_sal - emp_sal;
END //
DELIMITER ;
#调用
SET @emp_id = 102;
CALL different_salary(@emp_id,@diff_sal);
#查看
SELECT @diff_sal;1.2.4 对比会话用户变量与局部变量
| 作用域 | 定义位置 | 语法 | |
|---|---|---|---|
| 会话用户变量 | 当前会话 | 会话的任何地方 | 加@符号,不用指定类型 |
| 局部变量 | 定义它的BEGIN END中 | BEGIN END的第一句话 | 一般不用加@,需要指定类型 |
2. 定义条件与处理程序
定义条件 是事先定义程序执行过程中可能遇到的问题, 处理程序 定义了在遇到问题时应当采取的处理方 式,并且保证存储过程或函数在遇到警告或错误时能继续执行。这样可以增强存储程序处理问题的能 力,避免程序异常停止运行。
说明:定义条件和处理程序在存储过程、存储函数中都是支持的。
相当于try catch
2.1 案例分析
2.2 定义条件
定义条件就是给MySQL中的错误码命名,这有助于存储的程序代码更清晰。它将一个 错误名字 和 指定的 错误条件 关联起来。这个名字可以随后被用在定义处理程序的 DECLARE HANDLER 语句中。 定义条件使用DECLARE语句,语法格式如下:
declare 错误名称 condition for 错误码(或错误条件)错误码的说明:
MySQL_error_code 和 sqlstate_value 都可以表示MySQL的错误。
MySQL_error_code是数值类型错误代码。
sqlstate_value是长度为5的字符串类型错误代码。
例如,在ERROR 1418 (HY000)中,1418是MySQL_error_code,'HY000'是sqlstate_value。
例如,在ERROR 1142(42000)中,1142是MySQL_error_code,'42000'是sqlstate_value。
#举例1:定义“Field_Not_Be_NULL”错误名与MySQL中违反非空约束的错误类型是“ERROR 1048 (23000)”对应。
#使用MySQL_error_code
DECLARE Field_Not_Be_NULL CONDITION FOR 1048;
#使用sqlstate_value
DECLARE Field_Not_Be_NULL CONDITION FOR SQLSTATE '23000';
举例2:定义"ERROR 1148(42000)"错误,名称为command_not_allowed。
#使用MySQL_error_code
DECLARE command_not_allowed CONDITION FOR 1148;
#使用sqlstate_value
DECLARE command_not_allowed CONDITION FOR SQLSTATE '42000';
2.3 定义处理程序
可以为SQL执行过程中发生的某种类型的错误定义特殊的处理程序。定义处理程序时,使用DECLARE语句 的语法如下:
declare 处理方式 handler for 错误类型 处理语句处理方式:处理方式有3个取值:CONTINUE、EXIT、UNDO。(continue ,exit ,undo)
●continue:表示遇到错误不处理,继续执行。
●exit:表示遇到错误马上退出。
●undo:表示遇到错误后撤回之前的操作。MySQL中暂时不支持这样的操作。
错误类型(即条件)可以有如下取值:
●sqlstate '字符串错误码' :表示长度为5的sqlstate_value类型的错误代码;
●MySQL_error_code :匹配数值类型错误代码;
●错误名称 :表示DECLARE ... CONDITION定义的错误条件名称。
●SQLWARNING :匹配所有以01开头的SQLSTATE错误代码;
●NOT FOUND :匹配所有以02开头的SQLSTATE错误代码;
●SQLEXCEPTION :匹配所有没有被SQLWARNING或NOT FOUND捕获的SQLSTATE错误代码;
处理语句:如果出现上述条件之一,则采用对应的处理方式,并执行指定的处理语句。语句可以是 像“ SET 变量 = 值 ”这样的简单语句,也可以是使用 BEGIN ... END 编写的复合语句。
定义处理程序的几种方式,代码如下:
#方法1:捕获sqlstate_value
DECLARE CONTINUE HANDLER FOR SQLSTATE '42S02' SET @info = 'NO_SUCH_TABLE';
#方法2:捕获mysql_error_value
DECLARE CONTINUE HANDLER FOR 1146 SET @info = 'NO_SUCH_TABLE';
#方法3:先定义条件,再调用
DECLARE no_such_table CONDITION FOR 1146;
DECLARE CONTINUE HANDLER FOR NO_SUCH_TABLE SET @info = 'NO_SUCH_TABLE';
#方法4:使用SQLWARNING
DECLARE EXIT HANDLER FOR SQLWARNING SET @info = 'ERROR';
#方法5:使用NOT FOUND
DECLARE EXIT HANDLER FOR NOT FOUND SET @info = 'NO_SUCH_TABLE';
#方法6:使用SQLEXCEPTION
DECLARE EXIT HANDLER FOR SQLEXCEPTION SET @info = 'ERROR';2.4 案例解决
在存储过程中,定义处理程序,捕获sqlstate_value值,当遇到MySQL_error_code值为1048时,执行 CONTINUE操作,并且将@proc_value的值设置为-1。
DELIMITER //
CREATE PROCEDURE UpdateDataNoCondition()
BEGIN
#定义处理程序
DECLARE CONTINUE HANDLER FOR 1048 SET @proc_value = -1;
SET @x = 1;
UPDATE employees SET email = NULL WHERE last_name = 'Abel';
SET @x = 2;
UPDATE employees SET email = 'aabbel' WHERE last_name = 'Abel';
SET @x = 3;
END //
DELIMITER ;
#调用过程:
mysql> CALL UpdateDataWithCondition();
Query OK, 0 rows affected (0.01 sec)
mysql> SELECT @x,@proc_value;
+------+-------------+
| @x | @proc_value |
+------+-------------+
| 3 | -1 |
+------+-------------+
1 row in set (0.00 sec)
3. 流程控制
解决复杂问题不可能通过一个 SQL 语句完成,我们需要执行多个 SQL 操作。流程控制语句的作用就是控 制存储过程中 SQL 语句的执行顺序,是我们完成复杂操作必不可少的一部分。只要是执行的程序,流程 就分为三大类:
顺序结构 :程序从上往下依次执行
分支结构 :程序按条件进行选择执行,从两条或多条路径中选择一条执行
循环结构 :程序满足一定条件下,重复执行一组语句
针对于MySQL 的流程控制语句主要有 3 类。注意:只能用于存储程序。
条件判断语句 :IF 语句和 CASE 语句
循环语句 :LOOP、WHILE 和 REPEAT 语句
跳转语句 :ITERATE 和 LEAVE 语句
3.1 分支结构之 IF
IF 表达式1 THEN 操作1
[ELSEIF 表达式2 THEN 操作2]……
[ELSE 操作N]
END IF
#根据表达式的结果为TRUE或FALSE执行相应的语句。这里“[]”中的内容是可选的。
#特点:① 不同的表达式对应不同的操作 ② 使用在begin end中3.2 分支结构之 CASE
#情况一:类似于switch
CASE 表达式
WHEN 值1 THEN 结果1或语句1(如果是语句,需要加分号)
WHEN 值2 THEN 结果2或语句2(如果是语句,需要加分号)
...
ELSE 结果n或语句n(如果是语句,需要加分号)
END [case](如果是放在begin end中需要加上case,如果放在select后面不需要)
#情况二:类似于多重if
CASE
WHEN 条件1 THEN 结果1或语句1(如果是语句,需要加分号)
WHEN 条件2 THEN 结果2或语句2(如果是语句,需要加分号)
...
ELSE 结果n或语句n(如果是语句,需要加分号)
END [case](如果是放在begin end中需要加上case,如果放在select后面不需要)3.3 循环结构之LOOP
LOOP循环语句用来重复执行某些语句。LOOP内的语句一直重复执行直到循环被退出(使用LEAVE子 句),跳出循环过程。
[loop_label:] LOOP
循环执行的语句
END LOOP [loop_label]其中,loop_label表示LOOP语句的标注名称,该参数可以省略。
#使用LOOP语句进行循环操作,id值小于10时将重复执行循环过程。
DECLARE id INT DEFAULT 0;
add_loop:LOOP
SET id = id +1;
IF id >= 10 THEN LEAVE add_loop;
END IF;
END LOOP add_loop;3.4 循环结构之WHILE
WHILE语句创建一个带条件判断的循环过程。WHILE在执行语句执行时,先对指定的表达式进行判断,如 果为真,就执行循环内的语句,否则退出循环。WHILE语句的基本格式如下:
[while_label:] WHILE 循环条件 DO
循环体
END WHILE [while_label];
while_label为WHILE语句的标注名称;如果循环条件结果为真,WHILE语句内的语句或语句群被执行,直 至循环条件为假,退出循环。
3.5 循环结构之REPEAT
REPEAT语句创建一个带条件判断的循环过程。与WHILE循环不同的是,REPEAT 循环首先会执行一次循 环,然后在 UNTIL 中进行表达式的判断,如果满足条件就退出,即 END REPEAT;如果条件不满足,则会 就继续执行循环,直到满足退出条件为止。
[repeat_label:] REPEAT
循环体的语句
UNTIL 结束循环的条件表达式
END REPEAT [repeat_label]
repeat_label为REPEAT语句的标注名称,该参数可以省略;REPEAT语句内的语句或语句群被重复,直至 expr_condition为真。
对比三种循环结构:
1、这三种循环都可以省略名称,但如果循环中添加了循环控制语句(LEAVE或ITERATE)则必须添加名 称。
2、 LOOP:一般用于实现简单的"死"循环
WHILE:先判断后执行
REPEAT:先执行后判断,无条件 至少执行一次
3.6 跳转语句之LEAVE语句
LEAVE语句:可以用在循环语句内,或者以 BEGIN 和 END 包裹起来的程序体内,表示跳出循环或者跳出 程序体的操作。如果你有面向过程的编程语言的使用经验,你可以把 LEAVE 理解为 break。
LEAVE 标记名3.7 跳转语句之ITERATE语句
ITERATE语句:只能用在循环语句(LOOP、REPEAT和WHILE语句)内,表示重新开始循环,将执行顺序 转到语句段开头处。如果你有面向过程的编程语言的使用经验,你可以把 ITERATE 理解为 continue,意 思为“再次循环”。 语句基本格式如下:
ITERATE labellabel参数表示循环的标志。ITERATE语句必须跟在循环标志前面。
举例: 定义局部变量num,初始值为0。循环结构中执行num + 1操作。 如果num < 10,则继续执行循环; 如果num > 15,则退出循环结构;
DELIMITER //
CREATE PROCEDURE test_iterate()
BEGIN
DECLARE num INT DEFAULT 0;
my_loop:LOOP
SET num = num + 1;
IF num < 10
THEN ITERATE my_loop;
ELSEIF num > 15
THEN LEAVE my_loop;
END IF;
SELECT '尚硅谷:让天下没有难学的技术';
END LOOP my_loop;
END //
DELIMITER ;4. 游标
4.1 什么是游标(或光标)
虽然我们也可以通过筛选条件 WHERE 和 HAVING,或者是限定返回记录的关键字 LIMIT 返回一条记录, 但是,却无法在结果集中像指针一样,向前定位一条记录、向后定位一条记录,或者是随意定位到某一 条记录 ,并对记录的数据进行处理。
这个时候,就可以用到游标。游标,提供了一种灵活的操作方式,让我们能够对结果集中的每一条记录 进行定位,并对指向的记录中的数据进行操作的数据结构。游标让 SQL 这种面向集合的语言有了面向过程开发的能力。
在 SQL 中,游标是一种临时的数据库对象,可以指向存储在数据库表中的数据行指针。这里游标 充当了 指针的作用 ,我们可以通过操作游标来对数据行进行操作。
MySQL中游标可以在存储过程和函数中使用。
4.2 使用游标步骤
游标必须在声明处理程序之前被声明,并且变量和条件还必须在声明游标或处理程序之前被声明。 如果我们想要使用游标,一般需要经历四个步骤。不同的 DBMS 中,使用游标的语法可能略有不同。
#第一步,声明游标
#在MySQL中,使用DECLARE关键字来声明游标,其语法的基本形式如下:
DECLARE cursor_name CURSOR FOR select_statement;
#这个语法适用于 MySQL,SQL Server,DB2 和 MariaDB。如果是用 Oracle 或者 #PostgreSQL,需要写成:
DECLARE cursor_name CURSOR IS select_statement;
/*要使用 SELECT 语句来获取数据结果集,而此时还没有开始遍历数据,这里 select_statement 代表的是SELECT 语句,返回一个用于创建游标的结果集。*/
#比如:
DECLARE cur_emp CURSOR FOR
SELECT employee_id,salary FROM employees;
#第二步,打开游标
#打开游标的语法如下:
OPEN cursor_name;
#第三步,使用游标(从游标中取得数据)
FETCH cursor_name INTO var_name [, var_name] ...
/*这句的作用是使用 cursor_name 这个游标来读取当前行,并且将数据保存到 var_name 这个变量中,游
标指针指到下一行。如果游标读取的数据行有多个列名,则在 INTO 关键字后面赋值给多个变量名即可。
注意:var_name必须在声明游标之前就定义好。*/
#注意:游标的查询结果集中的字段数,必须跟 INTO 后面的变量数一致,否则,在存储过程执行的时
#候,MySQL 会提示错误。
#第四步,关闭游标
CLOSE cursor_nam
/*有 OPEN 就会有 CLOSE,也就是打开和关闭游标。当我们使用完游标后需要关闭掉该游标。因为游标会
占用系统资源 ,如果不及时关闭,游标会一直保持到存储过程结束,影响系统运行的效率。而关闭游标
的操作,会释放游标占用的系统资源。
*/4.3 举例
创建存储过程“get_count_by_limit_total_salary()”,声明IN参数 limit_total_salary,DOUBLE类型;声明 OUT参数total_count,INT类型。函数的功能可以实现累加薪资最高的几个员工的薪资值,直到薪资总和 达到limit_total_salary参数的值,返回累加的人数给total_count。
DELIMITER //
CREATE PROCEDURE get_count_by_limit_total_salary(IN limit_total_salary DOUBLE,OUT
total_count INT)
BEGIN
DECLARE sum_salary DOUBLE DEFAULT 0; #记录累加的总工资
DECLARE cursor_salary DOUBLE DEFAULT 0; #记录某一个工资值
DECLARE emp_count INT DEFAULT 0; #记录循环个数
#定义游标
DECLARE emp_cursor CURSOR FOR SELECT salary FROM employees ORDER BY salary DESC;
#打开游标
OPEN emp_cursor;
REPEAT
#使用游标(从游标中获取数据)
FETCH emp_cursor INTO cursor_salary;
SET sum_salary = sum_salary + cursor_salary;
SET emp_count = emp_count + 1;
UNTIL sum_salary >= limit_total_salary
END REPEAT;
SET total_count = emp_count;
#关闭游标
CLOSE emp_cursor;
END //
DELIMITER ;
4.5 小结
游标是 MySQL 的一个重要的功能,为 逐条读取 结果集中的数据,提供了完美的解决方案。跟在应用层面实现相同的功能相比,游标可以在存储程序中使用,效率高,程序也更加简洁。 但同时也会带来一些性能问题,比如在使用游标的过程中,会对数据行进行 加锁 ,这样在业务并发量大 的时候,不仅会影响业务之间的效率,还会 消耗系统资源 ,造成内存不足,这是因为游标是在内存中进行的处理。 建议:养成用完之后就关闭的习惯,这样才能提高系统的整体效率。
补充:MySQL 8.0的新特性—全局变量的持久化
在MySQL数据库中,全局变量可以通过SET GLOBAL语句来设置。例如,设置服务器语句超时的限制,可 以通过设置系统变量max_execution_time来实现:
SET GLOBAL MAX_EXECUTION_TIME=2000;使用SET GLOBAL语句设置的变量值只会 临时生效 。 数据库重启 后,服务器又会从MySQL配置文件中读取 变量的默认值。 MySQL 8.0版本新增了 SET PERSIST 命令。例如,设置服务器的最大连接数为1000:
SET PERSIST global max_connections = 1000;MySQL会将该命令的配置保存到数据目录下的 mysqld-auto.cnf 文件中,下次启动时会读取该文件,用 其中的配置来覆盖默认的配置文件。
触发器
1. 触发器概述
MySQL从 5.0.2 版本开始支持触发器。MySQL的触发器和存储过程一样,都是嵌入到MySQL服务器的一 段程序。 触发器是由 事件来触发 某个操作,这些事件包括 INSERT 、 UPDATE 、 DELETE 事件。所谓事件就是指 用户的动作或者触发某项行为。如果定义了触发程序,当数据库执行这些语句时候,就相当于事件发生 了,就会 自动 激发触发器执行相应的操作。 当对数据表中的数据执行插入、更新和删除操作,需要自动执行一些数据库逻辑时,可以使用触发器来 实现。
2. 触发器的创建
2.1 创建触发器语法
CREATE TRIGGER 触发器名称
{BEFORE|AFTER} {INSERT|UPDATE|DELETE} ON 表名
FOR EACH ROW
触发器执行的语句块;
说明:
表名 :表示触发器监控的对象。
BEFORE|AFTER :表示触发的时间。BEFORE 表示在事件之前触发;AFTER 表示在事件之后触发。 INSERT|UPDATE|DELETE :表示触发的事件。
INSERT 表示插入记录时触发; UPDATE 表示更新记录时触发; DELETE 表示删除记录时触发。
触发器执行的语句块 :可以是单条SQL语句,也可以是由BEGIN…END结构组成的复合语句块。
2.2 代码举例
1、创建数据表:
CREATE TABLE test_trigger (
id INT PRIMARY KEY AUTO_INCREMENT,
t_note VARCHAR(30)
);
CREATE TABLE test_trigger_log (
id INT PRIMARY KEY AUTO_INCREMENT,
t_log VARCHAR(30)
);2、创建触发器:创建名称为before_insert的触发器,向test_trigger数据表插入数据之前,向 test_trigger_log数据表中插入before_insert的日志信息。
delimiter //
create trigger before_insert
before insert on test_trigger
for each row
begin
insert into test_trigger(t_log)
values('before_insert');
end //
delimiter ;3、向test_trigger数据表中插入数据
insert into test_trigger (t_note )values ('测试 BEFORE INSERT 触发器')4、查看test_trigger_log数据表中的数据
mysql> SELECT * FROM test_trigger_log;
+----+---------------+
| id | t_log |
+----+---------------+
| 1 | before_insert |
+----+---------------+
1 row in set (0.00 sec)举例3:定义触发器“salary_check_trigger”,基于员工表“employees”的INSERT事件,在INSERT之前检查 将要添加的新员工薪资是否大于他领导的薪资,如果大于领导薪资,则报sqlstate_value为'HY000'的错 误,从而使得添加失败。
DELIMITER //
CREATE TRIGGER salary_check_trigger
BEFORE INSERT ON employees FOR EACH ROW
BEGIN
DECLARE mgrsalary DOUBLE;
SELECT salary INTO mgrsalary FROM employees WHERE employee_id = NEW.manager_id;
IF NEW.salary > mgrsalary THEN
SIGNAL SQLSTATE 'HY000' SET MESSAGE_TEXT = '薪资高于领导薪资错误';
END IF;
END //
DELIMITER ;
#上面触发器声明过程中的NEW关键字代表INSERT添加语句的新记录。3. 查看、删除触发器
3.1 查看触发器
查看触发器是查看数据库中已经存在的触发器的定义、状态和语法信息等。
#方式1:查看当前数据库的所有触发器的定义
show trigger\G
#方式2:查看当前数据库中某个触发器的定义
show create trigger 触发器名
/*方式3:从系统库information_schema的TRIGGERS表中查询“salary_check_trigger”触发器的信息。*/
select * from information_schema.triggers;3.2 删除触发器
触发器也是数据库对象,删除触发器也用DROP语句,语法格式如下:
drop trigger if exists 触发器名称;4. 触发器的优缺点
4.1 优点
1、触发器可以确保数据的完整性。
2、触发器可以帮助我们记录操作日志。
3、触发器还可以用在操作数据前,对数据进行合法性检查。
4.2 缺点
1、触发器最大的一个问题就是可读性差。
因为触发器存储在数据库中,并且由事件驱动,这就意味着触发器有可能 不受应用层的控制 。这对系统 维护是非常有挑战的。
2、相关数据的变更,可能会导致触发器出错。
4.3 注意点
注意,如果在子表中定义了外键约束,并且外键指定了ON UPDATE/DELETE CASCADE/SET NULL子句,此 时修改父表被引用的键值或删除父表被引用的记录行时,也会引起子表的修改和删除操作,此时基于子 表的UPDATE和DELETE语句定义的触发器并不会被激活。
MySQL8其它新特性
1. MySQL8新特性概述
1.1 MySQL8.0 新增特性
1.2 MySQL8.0移除的旧特性
2. 新特性1:窗口函数
2.1 使用窗口函数前后对比
2.2 窗口函数分类
2.3 语法结构
2.4 分类讲解
1. 序号函数
2. 分布函数
3. 前后函数
4. 首尾函数
5. 其他函数
2.5 小 结
3. 新特性2:公用表表达式
3.1 普通公用表表达式
3.2 递归公用表表达式
3.3 小 结
补充
in的用法
一、基础用法
mysql中in常用于where表达式中,其作用是查询某个范围内的数据。
select * from where field in (value1,value2,value3,…)
当 IN 前面加上 NOT 运算符时,表示与 IN 相反的意思,即不在这些列表项内选择
select * from where field not in (value1,value2,value3,…)
二、IN 子查询
更多情况下,IN 列表项的值是不明确的,而可能是通过一个子查询得到的:
SELECT * FROM article WHERE uid IN(SELECT uid FROM user WHERE status=0)
在in的子查询中常常会遇到查询效率太低问题,解决方法如下:
1、仍使用in子查询,多查询一次
SELECT * FROM basic_zdjbxx WHERE suiji IN ( SELECT zdcode FROM ( SELECT zdcode FROM basic_h WHERE zdcode != "" ) AS h )
2、使用LEFT JOIN
SELECT zd.* FROM ( SELECT DISTINCT zdcode FROM basic_h WHERE zdcode != "" ) AS h LEFT JOIN basic_zdjbxx zd ON zd.suiji = h.zdcode
三、IN 运算符补充说明
IN 列表项不仅支持数字,也支持字符甚至时间日期类型等,并且可以将这些不同类型的数据项混合排列而无须跟 column 的类型保持一致:
SELECT * FROM user WHERE uid IN(1,2,'3','c')一个 IN 只能对一个字段进行范围比对,如果要指定更多字段,可以使用 AND 或 OR 逻辑运算符:
SELECT * FROM user WHERE uid IN(1,2) OR username IN('admin','manong')使用 AND 或 OR 逻辑运算符后,IN 还可以和其他如 LIKE、>=、= 等运算符一起使用。
四、关于 IN 运算符的效率问题
如果 IN 的列表项是确定的,那么可以用多个 OR 来代替:
SELECT * FROM user WHERE uid IN (2,3,5)等效为:
SELECT * FROM user WHERE (uid=2 OR aid=3 OR aid=5)一般认为: 1、如果是对索引字段进行操作,使用 OR 效率高于 IN,但对于列表项不确定的时候(如需要子查询得到结果),就必须使用 IN 运算符。另外,对于子查询表数据小于主查询的时候,也是适用 IN 运算符的。
2、in或or在字段没有添加索引的情况下,所连接的字段越多(1 or 2 or 3 or 4 or…),or比in的查询效率低很多。