
基本知识
01、java 语言的特点:
1、面向对象:封装、继承、多态。
2、跨平台(JVM):编译+解释&JIT
3、多线程:(JUC 机制)。
4、可靠性、安全性、高效性、支持 I/O 编程(生态强)
java 现在是生态强,才比别人强,很多功能 java 有,别人也有。
02、JavaSE 和 JavaEE:
Java SE(Java Platform,Standard Edition): Java 平台标准版
Java EE(Java Platform, Enterprise Edition ):Java 平台企业版
Java SE 是 Java 的基础版本,Java EE 是 Java 的高级版本。Java SE 更适合开发桌面应用程序或简单的服务器应用程序,Java EE 更适合开发复杂的企业级应用程序或 Web 应用程序。
03、JIT、JVM、JRE、JDK
JIT 是 JVM 中的字节码编译器,JVM 是 字节码转换成机器码,JRE(Java Runtime Environment ) 是运行已编译 Java 程序所需的环境,JDK 是 JRE+开发和调试 Java 程序的工具。
JIT>JVM>JDK>JRE
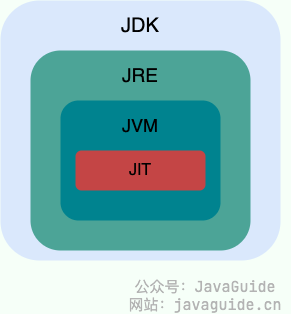
在 JDK9 中无 JDK 和 JRE,取代的是模块系统+ jlink 工具(生成自定义 Java 运行时映像模块)
04、AOT 和 JIT 的区别?有哪些应用?为什么不使用 AOT?
AOT 是在执行前预先编译(C++,GO 等语言)减少内存占用,避免 JIT 预热等;JIT 是先用解释器一句一句解释,执行时将热点代码保存,下次直接加载。
AOT 经典的是GraalVM(完整的 JDK 发行版本),但是 AOT 适合云原生场景和微服务场景,无法支持直接支持 java 的反射,动态代理等。
05、Oracle JDK vs OpenJDK
历史:sun 公司做的 OpenJDK,全开源;后面 sun 被 Oracle 公司收购,搞了个OracleJDK 不开源,收费。所以每 3 个月在OpenJDK 更新功能,每 6 个月在OracleJDK 更新 OpenJDK 的好功能(搞了个部分开源)。一般都是选择OpenJDK 的发行版,比如 AWS 的 Amazon Corretto,阿里巴巴的 Alibaba Dragonwell。
06、Java 和 C++ 的区别?
- Java 不提供指针来直接访问内存,程序内存更加安全
- Java 的类是单继承的,C++ 支持多重继承;虽然 Java 的类不可以多继承,但是接口可以多继承。
- Java 有自动内存管理垃圾回收机制(GC),不需要程序员手动释放无用内存。
- C ++同时支持方法重载和操作符重载,但是 Java 只支持方法重载(操作符重载增加了复杂性,这与 Java 最初的设计思想不符)。
基本语法:
Java 语言关键字有哪些?
| 分类 | 关键字 | ||||||
|---|---|---|---|---|---|---|---|
| 访问控制 | private | protected | public | ||||
| 类,方法和变量修饰符 | abstract | class | extends | final | implements | interface | native |
| new | static | strictfp | synchronized | transient | volatile | enum | |
| 程序控制 | break | continue | return | do | while | if | else |
| for | instanceof | switch | case | default | assert | ||
| 错误处理 | try | catch | throw | throws | finally | ||
| 包相关 | import | package | |||||
| 基本类型 | boolean | byte | char | double | float | int | long |
| short | |||||||
| 变量引用 | super | this | void | ||||
| 保留字 | goto | const |
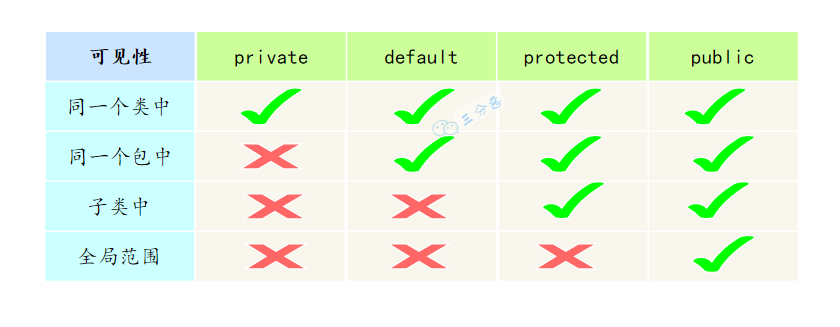
- default (即默认,什么也不写): 在同一包内可见,不使用任何修饰符。可以修饰在类、接口、变量、方法。
- private : 在同一类内可见。可以修饰变量、方法。注意:不能修饰类(外部类)
- public : 对所有类可见。可以修饰类、接口、变量、方法
- protected : 对同一包内的类和所有子类可见。可以修饰变量、方法。注意:不能修饰类(外部类)。
基本数据类型:
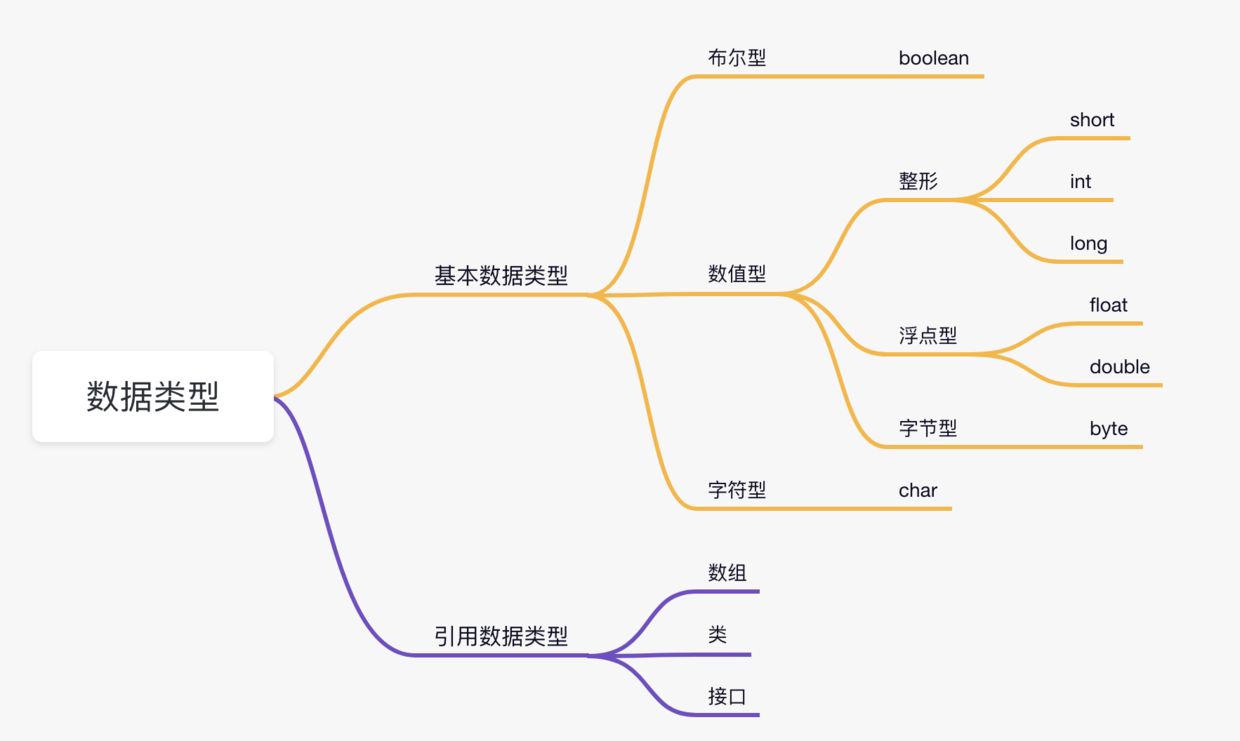
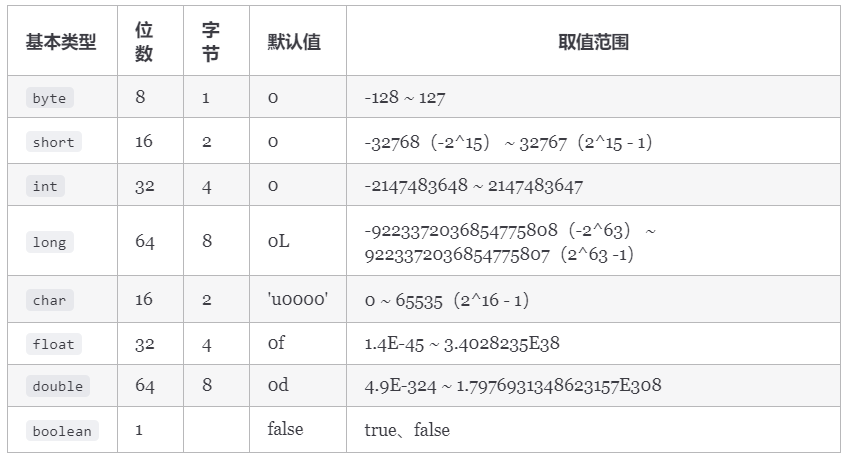
基本数据类型有8 种:
boolean 、short 、int 、long、 float、double、byte、char 类型。特点是直接存储对象,在栈中或局部变量表中,
成员变量会自动初始化,局部变量必须手动赋值。
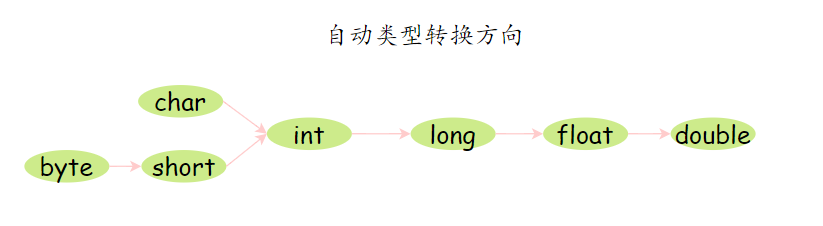
注意:
- Java 里使用
long类型的数据一定要在数值后面加上 L,否则将作为整型解析。 - Java 里使用
float类型的数据一定要在数值后面加上 f 或 F,否则将无法通过编译。 char a = 'h'char :单引号,String a = "hello":双引号。
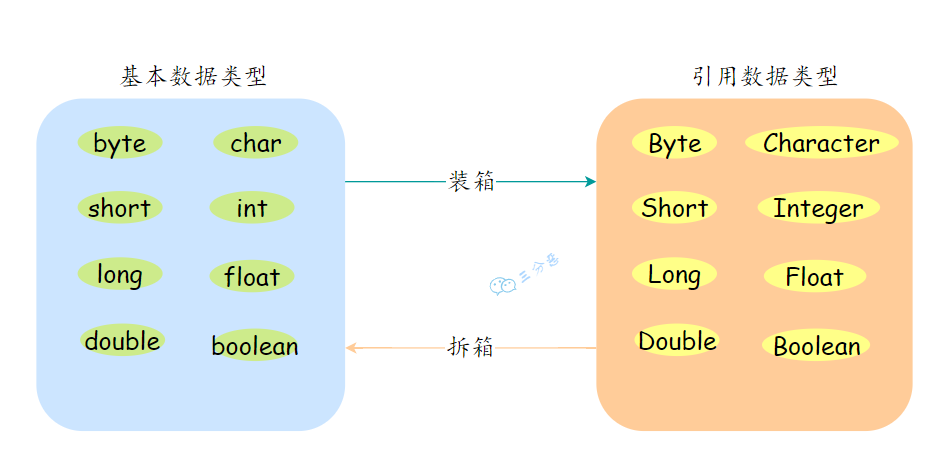
这八种基本类型都有对应的包装类分别为:Byte、Short、Integer、Long、Float、Double、Character、Boolean 。
基本类型和包装类型的区别?
基本数据类型不是对象,而 java 中很多功能是为对象设计的,所以使用包装类型。但是基本数据类型存在 java 栈中,
概念:
一般使用包装类型(用于泛型,集合类,反射),很多核心特性和高级功能是专门为“对象”设计的,但性能至关重要的基本数据类型却不是对象。它的首要作用就是将基本类型**“包装”成对象**,从而让它们能够参与到面向对象的活动中,这样功能丰富。
区别:
基本数据类的局部变量存在 java 栈中,成员变量(非 static 静态变量)放在堆中;占用空间小,默认值非 null,比较的是值。
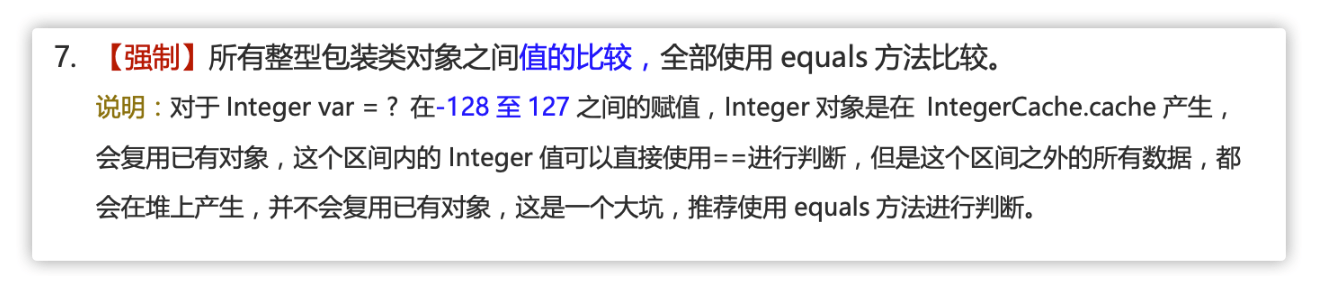
包装类型属于对象类型,放在堆中(若未发生代码逃逸,就放在栈中,优化代码);占用空间相对大,默认值为 null,比较的是地址,所以一定要用 equals 方法比较。
但是包装类占用内存大,频繁的拆箱和装箱创建很多不必要的对象,GC 压力大
包装类型缓存机制:
基本数据类型的包装类型的大部分都用到了缓存机制来提升性能。
Byte,Short,Integer,Long 这 4 种包装类默认创建了数值 [-128,127] 的相应类型的缓存数据,
Character 创建了数值在 [0,127] 范围的缓存数据,
Boolean 直接返回 TRUE or FALSE.
(其中Integer可以通过 JVM 参数-XX:AutoBoxCacheMax=<size>修改缓存上限,下限无法修改。 其他 3 种参数修改,)
Float,Double 无缓存机制在·
自动拆箱和装箱:
- 装箱:将基本数据类型转换为包装类型,例如 int 转换为 Integer。本质是调用
valueOf()方法, - 拆箱:将包装类型转换为基本数据类型。调用了
xxxValue()方法。 Integer i = 10等价于Integer i = Integer.valueOf(10)int n = i等价于int n = i.intValue();
Integer
integer 中的缓存池+设置+大小:
Byte,Short,Integer,Long 这 4 种包装类默认创建了数值 [-128,127] 的相应类型的缓存数据,
Character 创建了数值在 [0,127] 范围的缓存数据,
所以如果使用==来判断 integer 的大小会可能会发生超出缓存池大小,导致返回 false 的情况。如 Integer a =128、Integer b =128。a==b,返回 false。
因为该值在缓存大小外,在堆中创建了两个新对象,所以引用的地址比较为 false。故比较值一定要用 equals()方法
String 转换成 integer
String 转成 Integer,主要有两个方法:
- Integer.parseInt(String s):
- Integer.valueOf(String s)
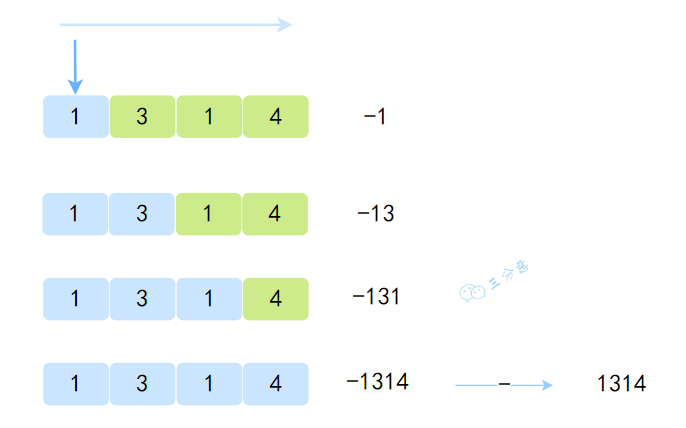
本质都是调用parseInt(String s, int radix)方法。即 字符串遍历计算,不过计算方式有点反常规,是用负的值累减。
public static int parseInt(String s, int radix)
throws NumberFormatException
{
int result = 0;
//是否是负数
boolean negative = false;
//char字符数组下标和长度
int i = 0, len = s.length();
……
int digit;
//判断字符长度是否大于0,否则抛出异常
if (len > 0) {
……
while (i < len) {
// Accumulating negatively avoids surprises near MAX_VALUE
//返回指定基数中字符表示的数值。(此处是十进制数值)
digit = Character.digit(s.charAt(i++),radix);
//进制位乘以数值
result *= radix;
result -= digit;
}
}
//根据上面得到的是否负数,返回相应的值
return negative ? result : -result;
}
浮点运算精度丢失问题?
本质是用二进制保存,底层是用 OS 中的科学计数法表示(如下图),但是计算机宽度有限,可能会导致截断导致精度损失。
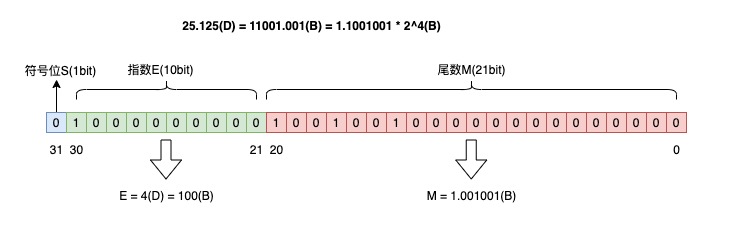
- 符号位 S 占 1 bit
- 指数 E 占 10 bit
- 尾数 M 占 21 bit
使用专门的BigDecimal 数据类型
BigDecimal 能够保证精度,是因为它使用了任意精度的整数表示法,而不是浮动的二进制表示。
BigDecimal 内部使用两个字段存储数字,一个是整数部分 **intval**,另一个是用来表示小数点的位置 scale,避免了浮点数转化过程中可能的精度丢失。
计算时通过整数计算,再结合小数点位置和设置的精度与舍入行为,控制结果精度,避免了由默认浮点数舍入导致的误差。
public class BigDecimal extends Number implements Comparable<BigDecimal> {
private final BigInteger intVal; // 存储整数部分
private final int scale; // 存储小数点的位置
public BigDecimal(String val) {
// 使用 BigInteger 来表示数值
intVal = new BigInteger(val.replace(".", ""));
scale = val.contains(".") ? val.length() - val.indexOf(".") - 1 : 0;
}
}
创建BigDecimal对象使用字符串形式或valueOf方法
BigDecimal bd1 = new BigDecimal("123.45");
BigDecimal bd3 = BigDecimal.valueOf(123.45);其中BigDecimal 的等值比较使用 compareTo()方法,而不是 equals()方法
String 类型
java 基本数据类型有四种整型(byte、short、int、long)、两种浮点型(float、double)、一种字符型(char)和一种布尔型(boolean)。
String 类型是一个引用类型类,被 final 修饰,不可继承和不可变(本质 String 用 private+final+不提供修改字符的方法)。
常见 String 使用方法:
length()- 返回字符串的长度。charAt(int index)- 返回指定位置的字符。substring(int beginIndex, int endIndex)- 返回字符串的一个子串,从beginIndex到endIndex-1。contains(CharSequence s)- 检查字符串是否包含指定的字符序列。equals(Object anotherObject)- 比较两个字符串的内容是否相等。indexOf(int ch)和indexOf(String str)- 返回指定字符或字符串首次出现的位置。replace(char oldChar, char newChar)和replace(CharSequence target, CharSequence replacement)- 替换字符串中的字符或字符序列。trim()- 去除字符串两端的空白字符。split(String regex)- 根据给定正则表达式的匹配拆分此字符串。
聊聊创建 String 的方式?会创建几个对象?
有两种方式:
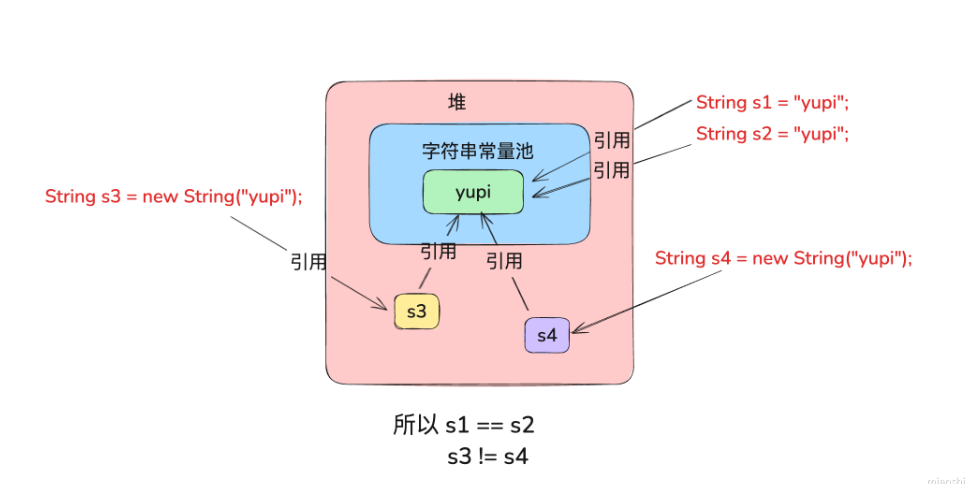
- 字面量直接定义:String s1 = "abc";
- 对象引用:String s2 = new String("abc");
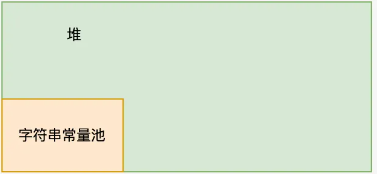
第一种方式是直接在堆中字符串常量池中创建 String 对象,将引用保存在该池中。
第二种 new 方式是先在堆中创建一个 String 对象 ,然后在用该对象的指针去查字符串常量池中该"abc"字面值的引用,如果存在则直接引用,反之重复第一种方式在字符串常量池中创建一个引用。(即堆中有 String 对象,字符串常量池也要有 String 对象)
使用 new 方法创建会导致对象冗余,可以使用 **String.intern()**方法,如果存在重复字符会返回引用,反之才会创建,不会重复创建.
其中 **String.intern()****方法就是直接到字符串常量池中查字符(**equals()方法 ),如果存在,则不会在堆中再创建,而是直接引用.
在 JDK9 中,String 类型类和BigDecimal 类型都是由 char 类型变成了 byte+coder 标识符,好处就是有原来 2 个字节大小变成了 1 个字节大小,利用 coder 标识编码方式即可(UTF-16 或 Latin-1)
String 和 StringBuilder、StringBuffer 的区别?
String 的特点
String类的对象是不可变的。也就是说,一旦一个String对象被创建,它所包含的字符串内容是不可改变的。
每次对String对象进行修改操作(如拼接、替换等)实际上都会生成一个新的**String****对象,而不是修改原有对象。**这可能会导致内存和性能开销,尤其是在大量字符串操作的情况下。
StringBuilder 的特点
StringBuilder提供了一系列的方法来进行字符串的增删改查操作,这些操作都是直接在原有字符串对象的底层数组上进行的,而不是生成新的 String 对象。
StringBuilder不是线程安全的。这意味着在没有外部同步的情况下,它不适用于多线程环境。
相比于String,在进行频繁的字符串修改操作时,StringBuilder能提供更好的性能。 Java 中的字符串连+操作其实就是通过StringBuilder实现的。
StringBuilder 解决 String 对象的不可变问题,提高对字符串的拼接和修改(JDK9)
- 底层使用字符数组(char[] value)存储字符序列
- 使用 append()、insert()等操作,直接修改内部字符数组,不会创建新对象
- 会以两倍的容量形式扩容,无缩容机制。
在 JDK9 版本后,底层 char 数组变成了 byte 数组 +标记位(区分不同编码),目的是节约内存
StringBuffer 的特点
StringBuffer和StringBuilder类似,但StringBuffer是线程安全的,方法前面都加了synchronized关键字。
请总结一下使用场景
- String:字符串内容不可变,比如说作为 HashMap 的 key。
- StringBuilder(可变+非线程安全):适用于单线程环境下需要频繁修改字符串内容的场景,比如在循环中拼接或修改字符串,是 String 的完美替代品。
- StringBuffer(可变+线程安全):现在已经不怎么用了,因为一般不会在多线程场景下去频繁的修改字符串内容。
讲一下 String 的拼接:
因为 String 是不可变的,因此通过“+”操作符进行的字符串拼接,会生成新的字符串对象。
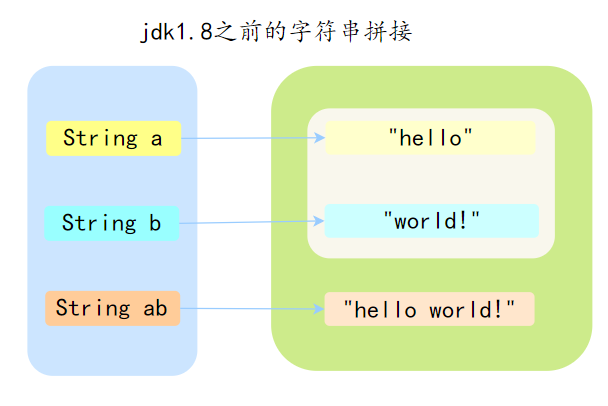
StringBuilder 中用 append 方法进行拼接。
面向对象章:
1、 封装继承多态、重载和重写的区别?
**封装:**将对象的属性和方法封装到一个类的内部,对外可以提供修改和访问的方法,隐藏实现细节
继承:java 单继承,无多继承(利用接口来实现多继承)。C++有多继承,但是有菱形继承等问题,C++通过显性指示或虚继承解决(通过指针解决)
多态:指同一个接口或方法在不同的类中有不同的实现。通过虚方法表存储方法指针,方法调用时根据对象实际类型从虚方法表查找具体实现。(重载和重写)
重载:一个类有多个名字相同但参数个数不同的方法。
重写:子类具有和父类一样的方法(参数相同、返回类型相同、方法名相同,但方法体可能不同),不能重写静态方法(属于类,不依赖对象的多态性)
2、this 关键字有什么作用?
指向对象本身的一个指针。
使用:
- 普通的直接引用,this 相当于是指向当前对象本身
- 形参与成员变量名字重名,用 this 来区分:
public Person(String name,int age){
this.name=name;
this.age=age;
}- 引用本类的构造方法
3、局部变量和成员变量的区别?实例变量(方法)和静态变量(方法)的区别
成员变量其实就是类内,方法外定义的变量。整个类可以访问,和对象一个生命周期,放在堆中(无代码逃逸除外),有默认值,可以用修饰符(public、protected、private、static、final等)
局部变量就是方法内定义的变量。只有方法内可以访问,和方法一个生命周期,放在栈中,无默认值,不可以用修饰符
静态变量(类变量)和实例变量是Java中两种不同类型的成员变量,它们在多个方面有显著差异:
| 特性 | 静态变量 (static变量) | 实例变量 (非static变量) |
|---|---|---|
| 声明方式 | 使用static关键字修饰 |
不使用static关键字 |
| 所属级别 | 类级别 - 属于类本身 | 实例级别 - 属于类的各个对象实例 |
| 内存分配 | 类加载时分配内存,存储在方法区(元空间) | 对象创建时分配内存,存储在堆内存 |
| 内存份数 | 只有一份,被所有实例共享 | 每个对象实例都有自己的一份拷贝 |
| 生命周期 | 从类加载开始,到程序结束 | 从对象创建开始,到对象被垃圾回收结束 |
| 初始化时机 | 类加载时初始化 | 对象创建时初始化 |
| 访问方式 | 可通过类名.变量名直接访问 |
必须通过对象实例访问 |
| 默认值 | 有默认值(与实例变量相同) | 有默认值(如int为0,引用类型为null等) |
| 线程安全 | 多线程共享需考虑同步问题 | 每个线程访问自己的实例,通常更安全 |
| 使用场景 | 用于类级别的共享数据 | 用于对象特有的数据 |
静态方法:static 修饰的方法,也被称为类方法。在外部调⽤静态⽅法时,可以使⽤"类名.⽅法名"的⽅式,也可以使⽤"对象名.⽅法名"的⽅式。静态方法里不能访问类的非静态成员变量和方法。
实例⽅法:依存于类的实例,需要使用"对象名.⽅法名"的⽅式调用;可以访问类的所有成员变量和方法。
4、static 关键字
修饰类的成员(变量、方法、代码块和嵌套类),使其成为类级别的成员,而不是实例级别的成员。
static 是在类加载时初始化的,只有一份拷贝**。而实例级别(非 static)的是****每个对象实例都有自己的一份拷贝。**
static 修饰变量:
- 所有实例共享同一个静态变量
static 修饰方法(静态方法):
- 可以直接通过类名调用,无需创建对象
- 静态方法中只能直接访问静态成员,不能直接访问实例成员(因为实例成员需要对象存在)
- 不能使用
this和super关键字
static 代码块(静态初始化块):
- 用于初始化静态变量或执行只需执行一次的初始化操作
- 可以有多个静态块,按它们在类中出现的顺序执行
static 修饰内部类(静态嵌套类):
- 静态内部类不持有外部类的引用
- 可以独立于外部类实例存在
- 只能访问外部类的静态成员
class Outer {
static int outerStaticVar = 10;
int outerInstanceVar = 20;
static class StaticNested {
void display() {
System.out.println(outerStaticVar); // 可以访问
// System.out.println(outerInstanceVar); // 错误,不能访问实例变量
}
}
}
// 使用
Outer.StaticNested nested = new Outer.StaticNested();
nested.display();静态导入(static import)
允许直接使用静态成员而不必用类名限定:
import static java.lang.Math.PI;
import static java.lang.Math.sqrt;
public class Test {
public static void main(String[] args) {
double radius = 5.0;
double area = PI * radius * radius; // 直接使用PI
double root = sqrt(25); // 直接使用sqrt
}
}java变量的作用域----------四个级别:类级、对象实例级、方法级、块级(类是对象的抽象,对象是类的实例)
类是一个东西的定义,对象是一类事物的抽象,实例就是具体的对象。如"人"是一个类,"名字"是对象,"王明松"是实例。
- 类级变量又称全局级变量或静态变量,需要使用static关键字修饰,在类加载后就已经存在,占内存,通过类名来访问
- 对象实例化就是成员变量,实例化后才会分配内存空间,才能访问。
- 方法级变量就是在方法内部定义的变量,就是局部变量。
- 块级变量就是定义在一个块内部的变量,变量的生存周期就是这个块,出了这个块就消失了
5、final、finally 和 finalize 的区别与作用
final 的作用:修饰类,该类不能被继承(如 Integer 包装类)。修饰方法,该方法不能被重写。修饰变量,基本类型数值初始化被赋值,无法修改值,引用类型,初始化之后地址不能变,值可修改。
finally 是异常中的关键字,是必须执行的代码。
finalize()是 GC 回收清理工作,JDK9 之后直接标为过时。
| 特性 | final | finally | finalize() |
|---|---|---|---|
| 类型 | 关键字(修饰符) | 关键字(异常处理) | Object类的方法 |
| 作用对象 | 类、方法、变量 | try-catch 代码块 | 即将被GC回收的对象 |
| 执行时机 | 编译时约束 | 异常处理后必定执行 | 不确定的GC时执行 |
| 用途 | 定义不可变的约束 | 确保资源清理 | 对象回收前的最后清理(已过时) |
| 是否可重写 | 用于防止重写/继承 | 不适用 | 可以重写(但不推荐) |
6、=、==、equals()、hashCode()
=是赋值,==是比较对象的引用(非逻辑相等),对基本类型是比较实际值。equals() 方法是比较两个对象内容是否相等。hashCode()是计算 hash 值。
hashCode()可能出现相同值,不同引用对象的问题,所以用equals() 比较是否是相同内容。
7、java 是值传递还是引用传递?
- 值传递(pass by value)是将参数复制一份,修改形参不会对实参造成影响
- 引用传递(pass by reference)是将实参的地址传递给形参,修改形参也就是在修改实参
java 是值传递,即传递给函数的是实参的地址的拷贝(如果实参在栈中,则直接拷贝该值)。
这里我们正常理解就是传递地址,所以想到是引用传递,但是概念和理解不一样。
简单点说,Java 中的传递,是值传递,而这个值,实际上是对象的引用地址值。
- 传递的值在栈中,直接拷贝一份值传递,改变的形参不会对实参造成影响。
- 传递的值在栈中存放的是地址(引用),先根据栈中的地址找到在堆上的值,然后把地址拷贝一份(拷贝的地址是一个值),此时形参和实参指向堆上同一个地址,形参的修改导致了实参的改变。
8、接口和抽象类的区别
接口和抽象类在设计动机上有所不同。
- 接口的设计是自上而下的。(先约定再实现)知道行为,实现对应接口
- 抽象类的设计是自下 而上的。对于需要重构的类,知道类,再抽象共同父类
方法实现上:
- 接口中的方法默认是 public 和 abstract(但在 Java8 之后可以设置 default 方法或者静态方法)
- 抽象类可以包含 abstract 方法(没有实现)和具体方法(有实现)。它允许子类继承并重用抽象类中的方法实现。
构造函数和成员变量:
- 接口无构造函数,成员变量默认为 public static final,即常量。
- 抽象类可有构造函数,**成员变量与正常类一致,**可以有不同的访问修饰符(如 private、protected、public),并且可以不是常量。
**多继承:**抽象类只能单继承,接口可以有多个实现:
PS:为什么Java只有单继承,多继承通过接口间接实现。
C++是可以有多继承的,但是会出现菱形继承等类似问题:
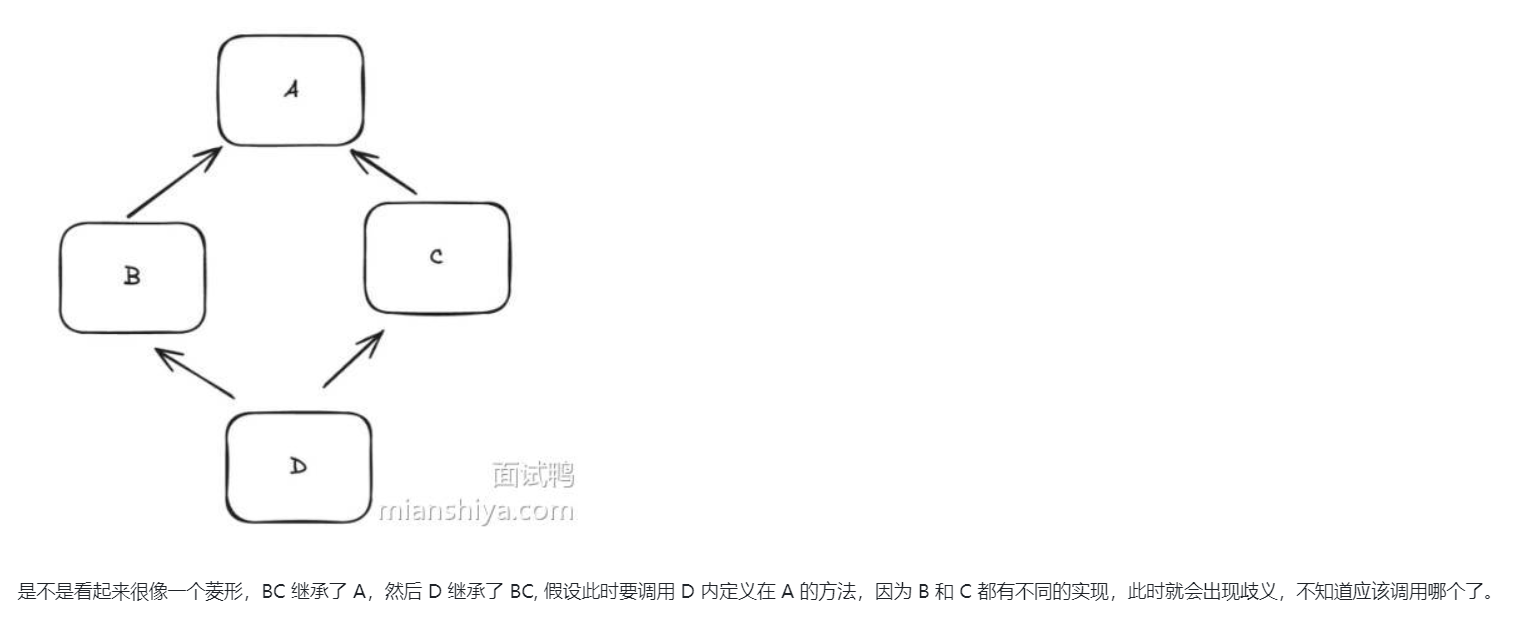
在C++中通过虚继承,类似共享,不会出现多份拷贝,解决了上述问题。
反问:为什么Java就不使用多继承了呢?而使用接口间接实现。
多个接口有相同的方法,子类必须重写,这样保证唯一性
9、Java中的反射机制,应用场景有哪些?
A:Java中的反射机制是指在运行时获取类的结构信息,并操作对象的机制。这样无须在编译时期知道具体信息,动态获取类的信息,创建对象和调用对象属性和方法。
java程序执行过程:HelloWorld.java -(javac编译)-> HelloWorld.class -(java命令)-> JVM加载执行(运行)
这种机制在框架中使用偏多,如spring的DI和AOP。同时反射比直接调用代码消耗大,为避免这种情况,需要避免高频循环中使用反射,可以通过缓存反射结果,即将第一次反射得到method缓存起来,后续直接使用。
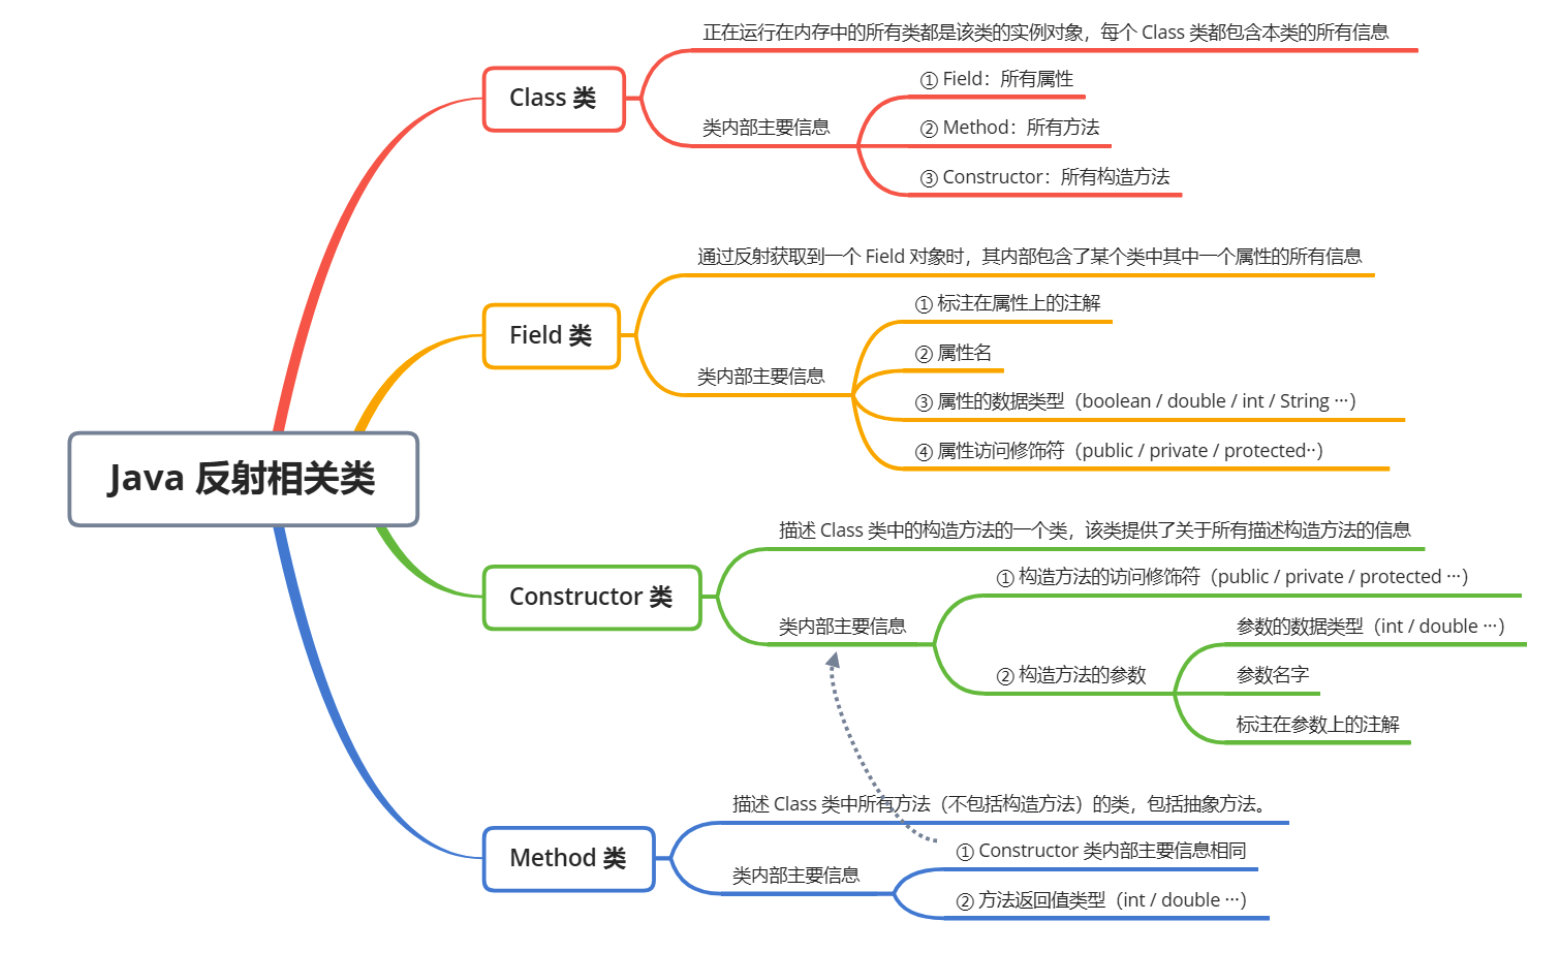
10、 反射的使用:(Class类):
获取class对象:
Class<?> clazz = Class.forName("com.mianshiya.MyClass");
// 或者
Class<?> clazz = MyClass.class;
// 或者
Class<?> clazz = obj.getClass();创建对象:
Object obj = clazz.newInstance(); // 已过时
Constructor<?> constructor = clazz.getConstructor();
Object obj = constructor.newInstance();访问字段:
Field field = clazz.getField("myField");
field.setAccessible(true); // 允许访问 private 字段
Object value = field.get(obj);
field.set(obj, newValue);调用方法:
Method method = clazz.getMethod("myMethod", String.class);
Object result = method.invoke(obj, "param");获取类的相关信息(类,方法等信息):.....
11、什么是代理模式? JDK动态代理和CGLB动态代理的区别?
代理模式定义:由于某些原因需要给某对象提供一个代理以控制对该对象的访问。这时,访问对象不适合或者不能直接引用目标对象,代理对象作为访问对象和目标对象之间的中介。
代理(Proxy)模式分为三种角色:
- 抽象主题(Subject)类: 通过接口或抽象类声明真实主题和代理对象实现的业务方法。
- 真实主题(Real Subject)类: 实现了抽象主题中的具体业务,是代理对象所代表的真实对象,是最终要引用的对象。
- 代理(Proxy)类 : 提供了与真实主题相同的接口,其内部含有对真实主题的引用,它可以访问、控制或扩展真实主题的功能。
静态代理是在编译时进行代理动作,动态代理是在运行时进行代理动作
动态代理应用在 spring 的 AOP,RPC 框架的远程封装调用
静态代理:直接在需要代理的对象上添加需要的方法,到后期方法越多越难维护
例子:
//接口
public interface SellTickets {
void sell(); // 卖票方法
}
//直接实现类
public class TrainStation implements SellTickets{
@Override
public void sell() {
System.out.println("Sell方法执行");
}
}
//代理实现类,把直接实现类作为成员变量
public class ProxyPoint implements SellTickets{
private TrainStation trainStation = new TrainStation();
@Override
public void sell() {
System.out.println("静态代理");
trainStation.sell();
}
}
//测试
public class Client {
public static void main(String[] args) {
//先创建代理类对象,在使用对应方法
ProxyPoint proxyPoint = new ProxyPoint();
proxyPoint.sell();
}
}JDK动态代理是基于接口的,要求被代理类有定义接口
CGLB动态代理是基于ASM字节码生成工具,通过继承的方式实现目标子类来实现代理类,所以无继承方法的final方法无法实现。
在java6,运行次数少时(百万级别),jdk代理和cglb代理差距不大,运行次数多时,cglb代理快
在java7,发生逆转。运行次数少时(百万级别),jdk代理和快30%,运行次数多时(5百万),jdk代理快1倍
在java8,两者差距不大
JDK动态代理机制:
通过反射机制,通过java.lang.reflect.Proxy类和 InvocationHandler 接口来实现代理。代理对象仅代理接口中的方法。
当调用代理对象的方法时,代理类会拦截方法调用,并通过InvocationHandler.invoke()方法执行额外的逻辑因此,JDK动态代理实现原理:
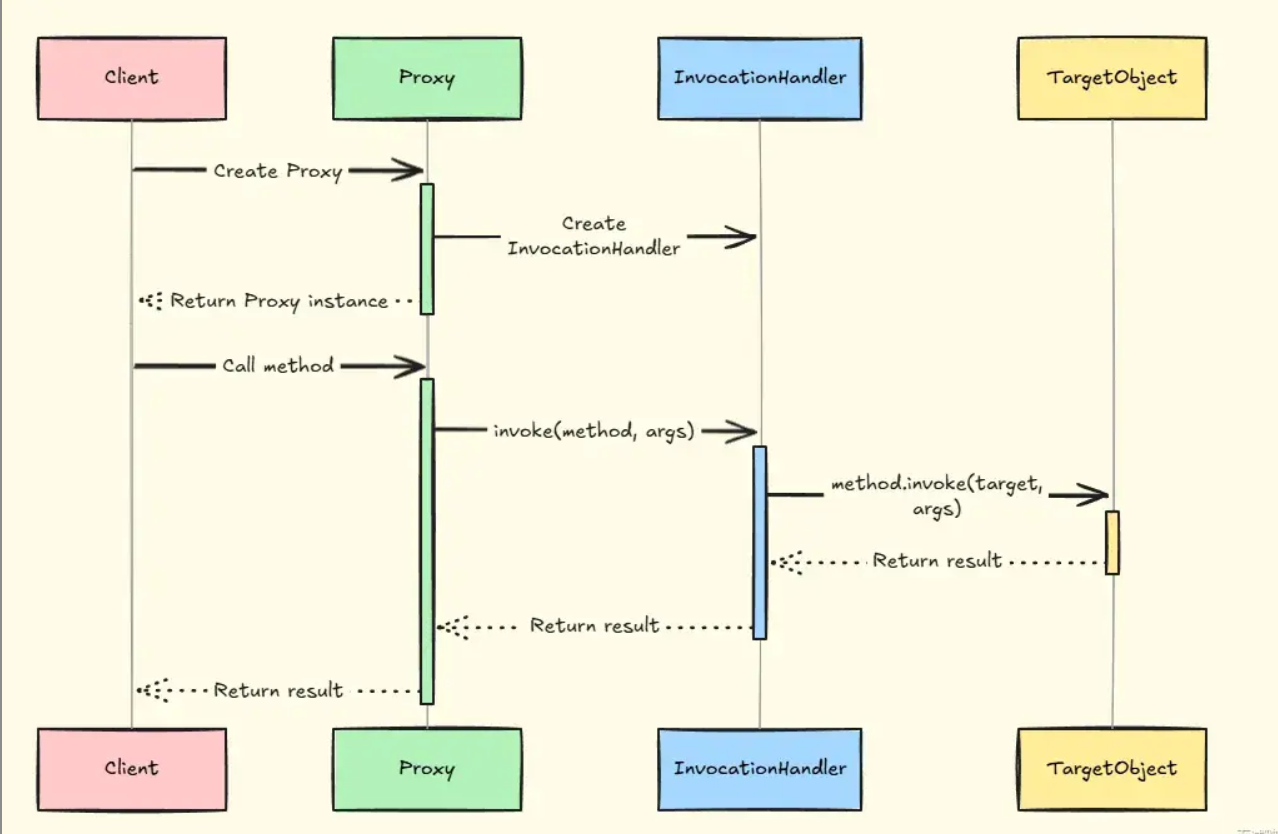
举例:(利用动态代理实现:缓存命中)
1、定义接口DataQuery(),实现query()和queryAll()方法,
2、实现接口实现类DatabaseQuery(),具体实现上述两个方法
3、自定义**InvocationHandler()**方法实现AOP,在调用实现类时,会提前调用切面方法
4、具体的调用方法(业务层,这个是重要的)
public interface DataQuery {
String query(String queryKey);
String queryAll(String queryKey);
}
public class DatabaseDataQuery implements com.muzi.Structural.proxy.dynamicProxy.jdk.DataQuery {
@Override
public String query(String queryKey) {
// 他会使用数据源从数据库查询数据很慢
System.out.println("正在从数据库查询数据");
return "result";
}
@Override
public String queryAll(String queryKey) {
// 他会使用数据源从数据库查询数据很慢
System.out.println("正在从数据库查询数据");
return "all result";
}
}
import java.lang.reflect.InvocationHandler;
import java.lang.reflect.Method;
import java.util.HashMap;
import java.util.LinkedHashMap;
public class CacheInvocationHandler implements InvocationHandler {
private HashMap<String,String> cache = new LinkedHashMap<>(256);
// 创建接口实现类的对象和构造方法
private DataQuery databaseDataQuery;
public CacheInvocationHandler(DatabaseDataQuery databaseDataQuery) {
this.databaseDataQuery = databaseDataQuery;
}
public CacheInvocationHandler() {
this.databaseDataQuery = new DatabaseDataQuery();
}
// 重写invoke()
@Override
public Object invoke(Object proxy, Method method, Object[] args) throws Throwable {
// 1、判断是哪一个方法
String result = null;
if("query".equals(method.getName())){
// 2、查询缓存,命中直接返回
result = cache.get(args[0].toString());
if(result != null){
System.out.println("数据从缓存重获取。");
return result;
}
// 3、未命中,查数据库(需要代理实例)
result = (String) method.invoke(databaseDataQuery, args);
// 4、如果查询到了,进行呢缓存
cache.put(args[0].toString(),result);
return result;
}
// 当其他的方法被调用,不希望被干预,直接调用原生的方法
return method.invoke(databaseDataQuery,args);
}
}
package com.muzi.Structural.proxy.dynamicProxy.jdk;
import java.lang.reflect.InvocationHandler;
import java.lang.reflect.Proxy;
public class Main {
public static void main(String[] args) {
// jdk提供的代理实现,主要是使用Proxy类来完成(重点)
// 1、classLoader:被代理类的类加载器
ClassLoader contextClassLoader = Thread.currentThread().getContextClassLoader();
// 2、代理类需要实现的接口数组
Class[] classes = new Class[]{DataQuery.class};
// 3、InvocationHandler
CacheInvocationHandler cacheInvocationHandler = new CacheInvocationHandler();
DataQuery dataQuery = (DataQuery) Proxy.newProxyInstance(contextClassLoader, classes, cacheInvocationHandler);
// 事实上调用query方法的使用,他是调用了invoke
String result = dataQuery.query("key1");
System.out.println(result);
System.out.println("--------------------");
result = dataQuery.query("key1");
System.out.println(result);
System.out.println("--------------------");
result = dataQuery.query("key2");
System.out.println(result);
System.out.println("++++++++++++++++++++++++++++++++++++");
// 事实上调用queryAll方法的使用,他是调用了invoke
result = dataQuery.queryAll("key1");
System.out.println(result);
System.out.println("--------------------");
result = dataQuery.queryAll("key1");
System.out.println(result);
System.out.println("--------------------");
result = dataQuery.queryAll("key2");
System.out.println(result);
System.out.println("--------------------");
}
}例子中 DataQuery是接口,DatabaseDataQuery 实现该接囗。
JDK 动态代理要求被代理对象至少实现一个接口,以便代理类通过接口暴露代理行为。
通过 Proxy.newProxyInstance()创建代理对象,需三个参数:
- 类加载器,如
Thread.currentThread().getContextclassLoader(),用于加载代理类 - 接口列表,如
new class[]{DataQuery.class},指定代理类应实现的接口。 InvocationHandler代理对象实际逻辑由实现该接口的类完成,如cacheInvocationHandler 会拦截代理方法调用并添加额外逻辑。
CacheInvocationHandler 的 invoke()方法拦截方法调用,添加一些特殊的业务逻辑,通过 method.invoke(target,args)执行目标对象原始方法。
CGLB动态代理:
使用的是org.springframework.cglib.proxy.Enhancer类进行实现的
基于字节码操作,使用CGLB(Code Generation Library )生成目标类的子类并重写目标方法来实现代理。
注意:是通过继承的方法拦截所有非final方法的调用(Spring的AOP和SpringMVC中的拦截器还是很像的)
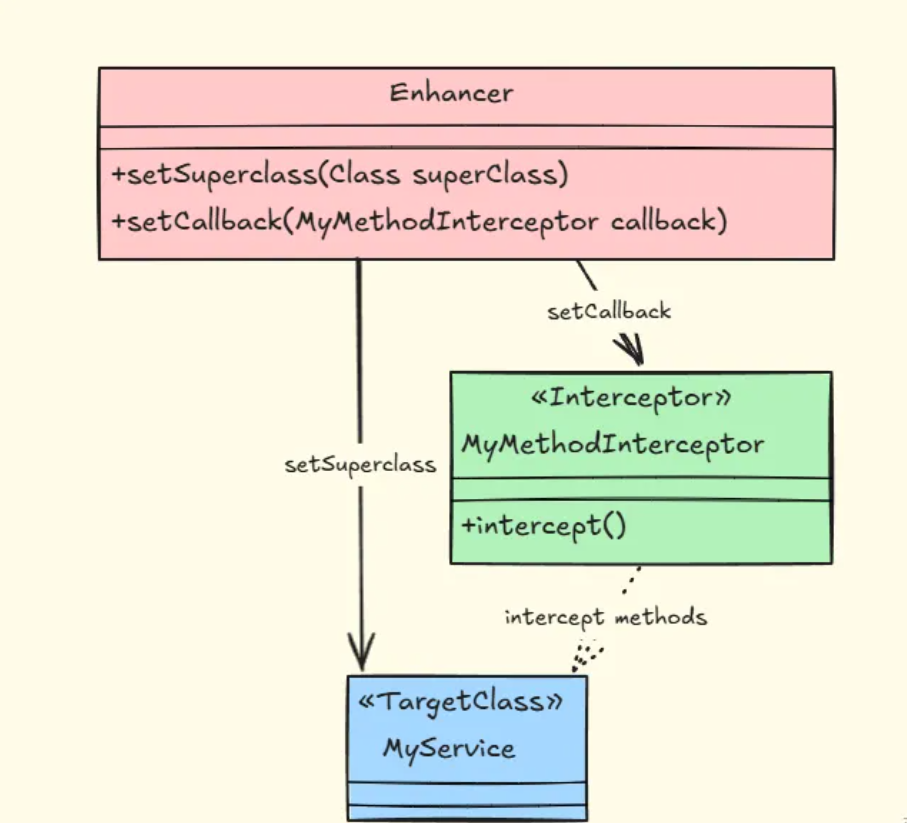
如上图所示:通过Enhancer类中的setSuperclass(Class superClass )设置父类,setCallback(xxx)设置拦截器,拦截方法,然后通过enhancer.create()方法创建代理类即可
例子:(通过CGLB方法实现缓存命中,其中接口和接口实现类及自定义的拦截器方法与上述一致,区别仅仅是反射的实现类不同以及在invoke()中创建接口需要实现的点不同)
1、定义接口DataQuery(),实现query()和queryAll()方法,.....省略不写
2、实现接口实现类DatabaseQuery(),具体实现上述两个方法,.....省略不写
3、自定义**InvocationHandler()**方法实现AOP,在调用实现类时,会提前调用切面方法 (只有创建接口对象与JDK动态代理有些不同)
4、具体的调用方法(业务层,这个是重要的)
package com.muzi.Structural.proxy.dynamicProxy.cglib;
import org.springframework.cglib.proxy.MethodInterceptor;
import org.springframework.cglib.proxy.MethodProxy;
import java.lang.reflect.Method;
import java.util.HashMap;
public class CacheMethodInterceptor implements MethodInterceptor {
private HashMap<String,String> cache = new HashMap<>();
// 在这里创建了接口和构造方法,无空参构造
private DatabaseDataQuery databaseDataQuery;
public CacheMethodInterceptor( ) {
this.databaseDataQuery = new DatabaseDataQuery();
};
@Override
public Object intercept(Object obj, Method method, Object[] args, MethodProxy proxy) throws Throwable {
// 1、判断是哪一个方法
String result = null;
if("query".equals(method.getName())){
// 2、查询缓存,命中直接返回
result = cache.get(args[0].toString());
if(result != null){
System.out.println("数据从缓存重获取。");
return result;
}
// 3、未命中,查数据库(需要代理实例)
result = (String) method.invoke(databaseDataQuery, args);
// 4、如果查询到了,进行呢缓存
cache.put(args[0].toString(),result);
return result;
}
return method.invoke(databaseDataQuery,args);
}
}
import org.springframework.cglib.proxy.Enhancer;
public class Main {
public static void main(String[] args) {
//cglib通过Enhancer
Enhancer enhancer = new Enhancer();
//设置父类
enhancer.setSuperclass(DatabaseDataQuery.class);
//设置一个拦截器,用来拦截方法
enhancer.setCallback(new CacheMethodInterceptor());
//创建代理类
DatabaseDataQuery databaseDataQuery = (DatabaseDataQuery) enhancer.create();
databaseDataQuery.query("Key1");
databaseDataQuery.query("Key1");
databaseDataQuery.query("Key2");
}
}MyService类并没有实现任何接口,这就是CGLIB动态代理的优势之一,它不要求目标类实现接口。CGLIB通过生成目标类的子类来实现代理。
CGLIB通过 Enhancer 类来创建代理对象,主要配置了两个部分目标类的超类:通过 enhancer.setsuperclass(DatabaseDataQuery.class)指定目标类(DatabaseDataQuery)
回调逻辑:通过 enhancer.setcallback()设置方法拦截器 cacheMethodInterceptor,它会拦截所有方法调用,并可以插入额外的逻辑。
cacheMethodInterceptor 实现了 MethodInterceptor 接口,代理的核心逻辑在 intercept()方法中。与JDK动态代理不同,CGLIB使用 proxy.invokesuper(obj,args)调用父类的原始方法,而不是通过反射调用。
总结:
两者的对比
| 特性 | JDK 动态代理 | CGLIB 动态代理 |
|---|---|---|
| 代理的对象 | 必须实现接口的类 | 没有实现接口的类或接口 |
| 代理创建 | 使用 Proxy.newProxyInstance() | 使用 Enhancer.create() |
| 方法调用机制 | 通过反射调用目标对象的接口方法 | 直接通过子类调用父类方法,性能较高 |
| 模拟逻辑插入位置 | InvocationHandler.invoke() | MethodInterceptor.intercept() |
| 性能 | 方法调用的性能较低,因为依赖于反射机制 | 性能较高,因为是直接的字节码生成 |
| 限制 | 目标类必须实现接口 | 不能代理 final 类和 final 方法 |
优缺点对比(对比一栏就可以看出优缺点了)
| 特性 | JDK 动态代理 | CGLIB 动态代理 |
|---|---|---|
| 代理对象 | 必须实现接口 | 不需要实现接口 |
| 代理方式 | 基于接口和反射 | 基于字节码生成子类 |
| 性能 | 创建代理开销小,方法调用开销高 | 创建代理开销大,方法调用性能好 |
| 限制 | 不能代理没有接口的类 | 不能代理 final 类和 final 方法 |
| 使用场景 | 适用于接口驱动的开发 | 适用于没有接口的类 |
| Spring AOP默认情况 | 接口时使用 | 没有接口时使用,可以强制使用CGLIB代理(通过设置 proxyTargetClass=true) |
12、强拷贝、浅拷贝,强引用、软引用、弱引用、虚引用
https://www.cnblogs.com/Scott007/archive/2013/05/15/3080739.html
强引用、弱引用、软引用、虚引用
1、强引用是最普遍的引用赋值,一般把一个对象赋给一个引用变量,这个引用变量就是强引用。
如果一个对象具有强引用,垃圾回收器不会回收该对象,当内存空间不足时,JVM 宁愿抛出 OutOfMemoryError异常。用完最好记得解除这种引用关系(置为null)。
2、软引用是一种相对强引用弱化了一些的引用,需要用java.lang.ref.SoftReference 类来实现。
软引用可以和一个引用队列(ReferenceQueue)联合使用,如果软引用所引用对象被垃圾回收,Java虚拟机就会把这个软引用加入到与之关联的引用队列中。软引用可用来实现内存敏感的高速缓存。
3、弱引用的使用和软引用类似,只是关键字变成了 WeakReference:
弱引用的特点是不管内存是否足够,只要发生 GC,都会被回收。
4、虚引用”顾名思义,就是形同虚设,与其他几种引用都不同,虚引用并不会决定对象的生命周期。如果一个对象仅持有虚引用,那么它就和没有任何引用一样,在任何时候都可能被垃圾回收器回收。
- 虚引用需要java.lang.ref.PhantomReference 来实现:
- 虚引用与软引用和弱引用的一个区别在于:虚引用必须和引用队列 (ReferenceQueue)联合使用,当垃圾回收器准备回收一个对象时,如果发现它还有虚引用,就会在回收对象的内存之前,把这个虚引用加入到与之 关联的引用队列中。
浅拷贝和强拷贝概念
1)浅拷贝 被复制对象的所有变量都含有与原来的对象相同的值,而所有的对其他对象的引用仍然指向原来的对象。
只会复制过去引用地址,如果修改了对象中属性值,另一方也会被修改(共享)
2)强拷贝 被复制对象的所有变量都含有与原来的对象相同的值,那些引用其他对象的变量将指向被复制过的新对象,而不再是原有的那些被引用的对象。
复制的是属性,内存空间是独立的两份。
基本数据类型没有浅拷贝和深拷贝的区别,赋值操作或clone()方法默认都是强拷贝,即传的是值(方法内修改不影响原始值)。引用类型****存在深拷贝和浅拷贝的区别,浅拷贝是传引用(方法内修改会影响原始对象),深拷贝需要递归复制整个对象图。
怎么实现强拷贝?
1.实现cloneable接口,重写clone方法,调用super.clone()
class Person implements Cloneable { //1.实现接口
String name;
Address address;
@Override
public Person clone() { // 2.重写方法
try {
Person cloned = (Person) super.clone(); // 3.调用clone方法
// address是可变引用类型,要额外复制该字段
cloned.address = this.address.clone(); // 深复制引用对象
return cloned;
} catch (CloneNotSupportedException e) {
throw new AssertionError(); // 不会发生
}
}
}
// 使用
Person original = new Person("John", new Address("Main St"));
Person deepCopy = original.clone();谨慎使用Cloneable,Joshua Bloch在《Effective Java》中明确指出:
设计缺陷
- 标记接口(Marker Interface)反模式:
Cloneable只是一个空接口,不包含任何方法 - 方法定义在Object类:实际的
clone()方法定义在Object类中,违反了接口设计原则 - 不调用构造函数:
clone()通过直接复制内存创建对象,绕过了构造函数 - 必须实现
Cloneable接口,否则会抛出CloneNotSupportedException - 必须重写
clone()方法并提升为public访问级别 - 必须调用
super.clone()来维持复制链,手动处理所有引用字段的复制
尽管存在诸多问题,但在以下情况下仍可考虑使用:
- 数组复制:数组的
clone()方法是高效且安全的 - 性能关键路径:当确实需要避开构造函数调用的开销时
- 维护遗留代码:当需要与现有使用clone()的代码保持兼容时(向前兼容)
推荐的替代方案
复制构造函数(Copy Constructor)
优势:
- 类型安全,无需强制转换
- 可以自由控制复制过程
- 会调用正常的构造流程
public class Person {
private String name;
private Address address;
// 复制构造函数
public Person(Person original) {
this.name = original.name;
this.address = new Address(original.address); // 深复制
}
}
// 使用
Person original = new Person(...);
Person copy = new Person(original); // 清晰明确静态工厂方法
优势:
- 方法名称可以更清楚地表达意图
- 可以返回不同的实现类
- 更好的封装控制
public class Person {
// ...字段...
public static Person newInstance(Person original) {
Person copy = new Person();
copy.name = original.name;
copy.address = Address.newInstance(original.address);
return copy;
}
}
// 使用
Person copy = Person.newInstance(original);构建器模式(Builder)
优势:
- 特别适合复杂对象的复制
- 可以灵活选择复制的部分属性
Person copy = Person.builder(original)
.withAddress(newAddress) // 可选修改某些字段
.build();各方案对比
| 特性 | Cloneable/clone() | 复制构造函数 | 静态工厂方法 | 构建器模式 |
|---|---|---|---|---|
| 类型安全 | ❌ 需要强制转换 | ✅ | ✅ | ✅ |
| 调用构造函数 | ❌ | ✅ | ✅ | ✅ |
| 处理final字段 | ❌ 困难 | ✅ | ✅ | ✅ |
| 方法名称表达意图 | ❌ clone() | ⭕ 一般 | ✅ 可自定义 | ✅ 可自定义 |
| 支持多态 | ⭕ 有限支持 | ⭕ 有限支持 | ✅ | ✅ |
| 实现复杂度 | ⭕ 中等 | ✅ 简单 | ⭕ 中等 | ❌ 较高 |
| 深复制控制 | ⭕ 需要手动实现 | ✅ | ✅ | ✅ |
13、Java 创建对象有哪几种方式?
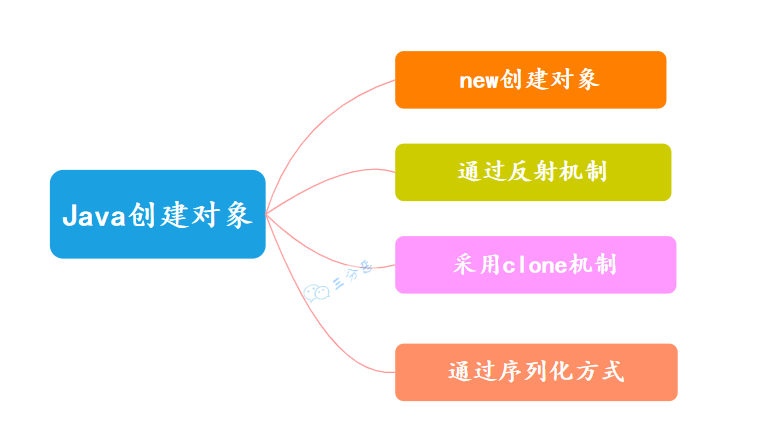
①、new 关键字创建
Person person = new Person();
②、反射机制创建,反射机制允许在运行时创建对象,并且可以访问类的私有成员,在框架和工具类中比较常见。
Class clazz = Class.forName("Person");
Person person = (Person) clazz.newInstance();
③、clone 拷贝创建,通过 clone 方法创建对象,需要实现 Cloneable 接口并重写 clone 方法。
Person person = new Person();
Person person2 = (Person) person.clone();
④、序列化机制创建,通过序列化将对象转换为字节流,再通过反序列化从字节流中恢复对象。需要实现 Serializable 接口。
Person person = new Person();
ObjectOutputStream oos = new ObjectOutputStream(new FileOutputStream("person.txt"));
oos.writeObject(person);
ObjectInputStream ois = new ObjectInputStream(new FileInputStream("person.txt"));
Person person2 = (Person) ois.readObject();在 new 对象时,静态代码、父类、子类方法有执行顺序区别吗?
静态代码本质是 static 创建的,在类加载时分配了内存;非 static 创建的,是局部变量就在栈中,是对象(成员变量)在堆中。
所以根据 JVM 过程中,顺序:类加载>栈和内存分配。所以静态代码先执行,后执行其他非静态代码。然后双亲委派机制顺序:父类>子类
Object 类的常见方法?
Object 主要提供了 11 个方法,大致可以分为六类: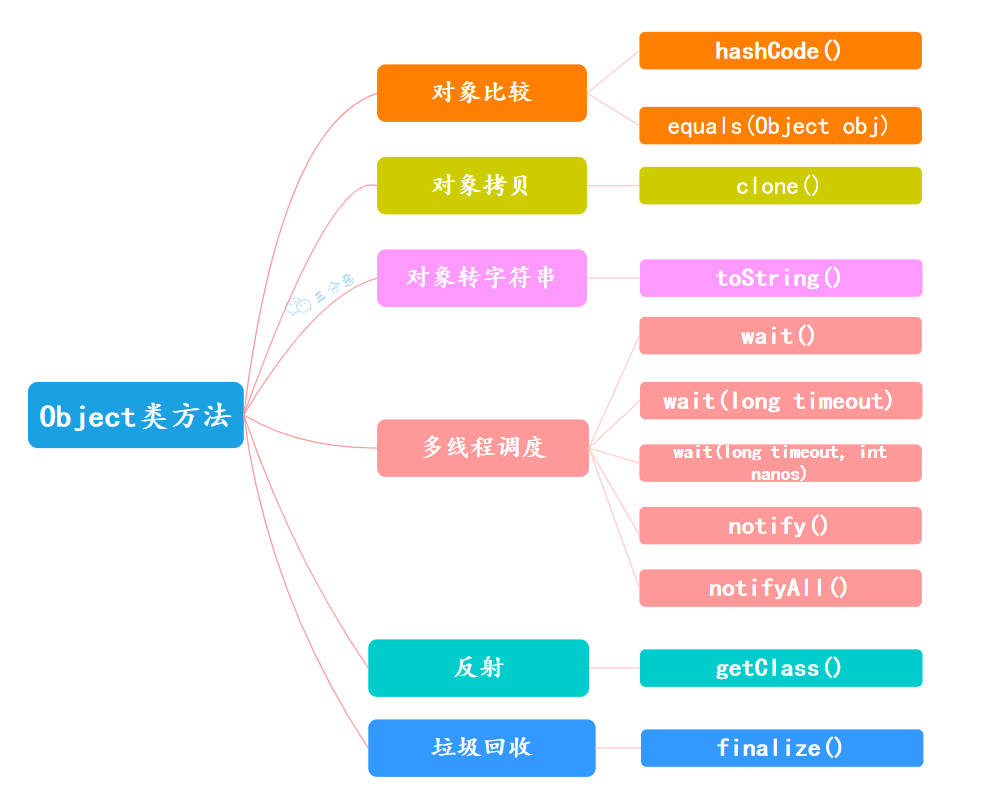
对象比较:
①、public native int hashCode() :native 方法,用于返回对象的哈希码。
public native int hashCode();
public int hashCode() {
return Objects.hash(name, age);
}
②、public boolean equals(Object obj):用于比较 2 个对象的内存地址是否相等。
public boolean equals(Object obj) {
return (this == obj);
}
对象拷贝:
protected native Object clone() throws CloneNotSupportedException:naitive 方法,返回此对象的一个副本。默认实现只做浅拷贝,且类必须实现 Cloneable 接口。
对象转字符串:
public String toString():返回对象的字符串表示。默认实现返回类名@哈希码的十六进制表示,但通常会被重写以返回更有意义的信息。
public String toString() {
return getClass().getName() + "@" + Integer.toHexString(hashCode());
}
多线程调度:
省略
①、public final void wait() throws InterruptedException:调用该方法会导致当前线程等待,直到另一个线程调用此对象的notify()方法或notifyAll()方法。
②、public final native void notify():唤醒在此对象监视器上等待的单个线程。如果有多个线程等待,选择一个线程被唤醒。
③、public final native void notifyAll():唤醒在此对象监视器上等待的所有线程。
④、public final native void wait(long timeout) throws InterruptedException:等待 timeout 毫秒,如果在 timeout 毫秒内没有被唤醒,会自动唤醒。
⑥、public final void wait(long timeout, int nanos) throws InterruptedException:更加精确了,等待 timeout 毫秒和 nanos 纳秒,如果在 timeout 毫秒和 nanos 纳秒内没有被唤醒,会自动唤醒。
反射:
public final native Class<?> getClass():用于获取对象的类信息,如类名。比如说:
public class GetClassDemo {
public static void main(String[] args) {
Person p = new Person();
Class<? extends Person> aClass = p.getClass();
System.out.println(aClass.getName());
}
}
垃圾回收:(JDK9已经放弃)
protected void finalize() throws Throwable异常处理
通过 try-catch-finally 语句和 throw 关键字来实现。
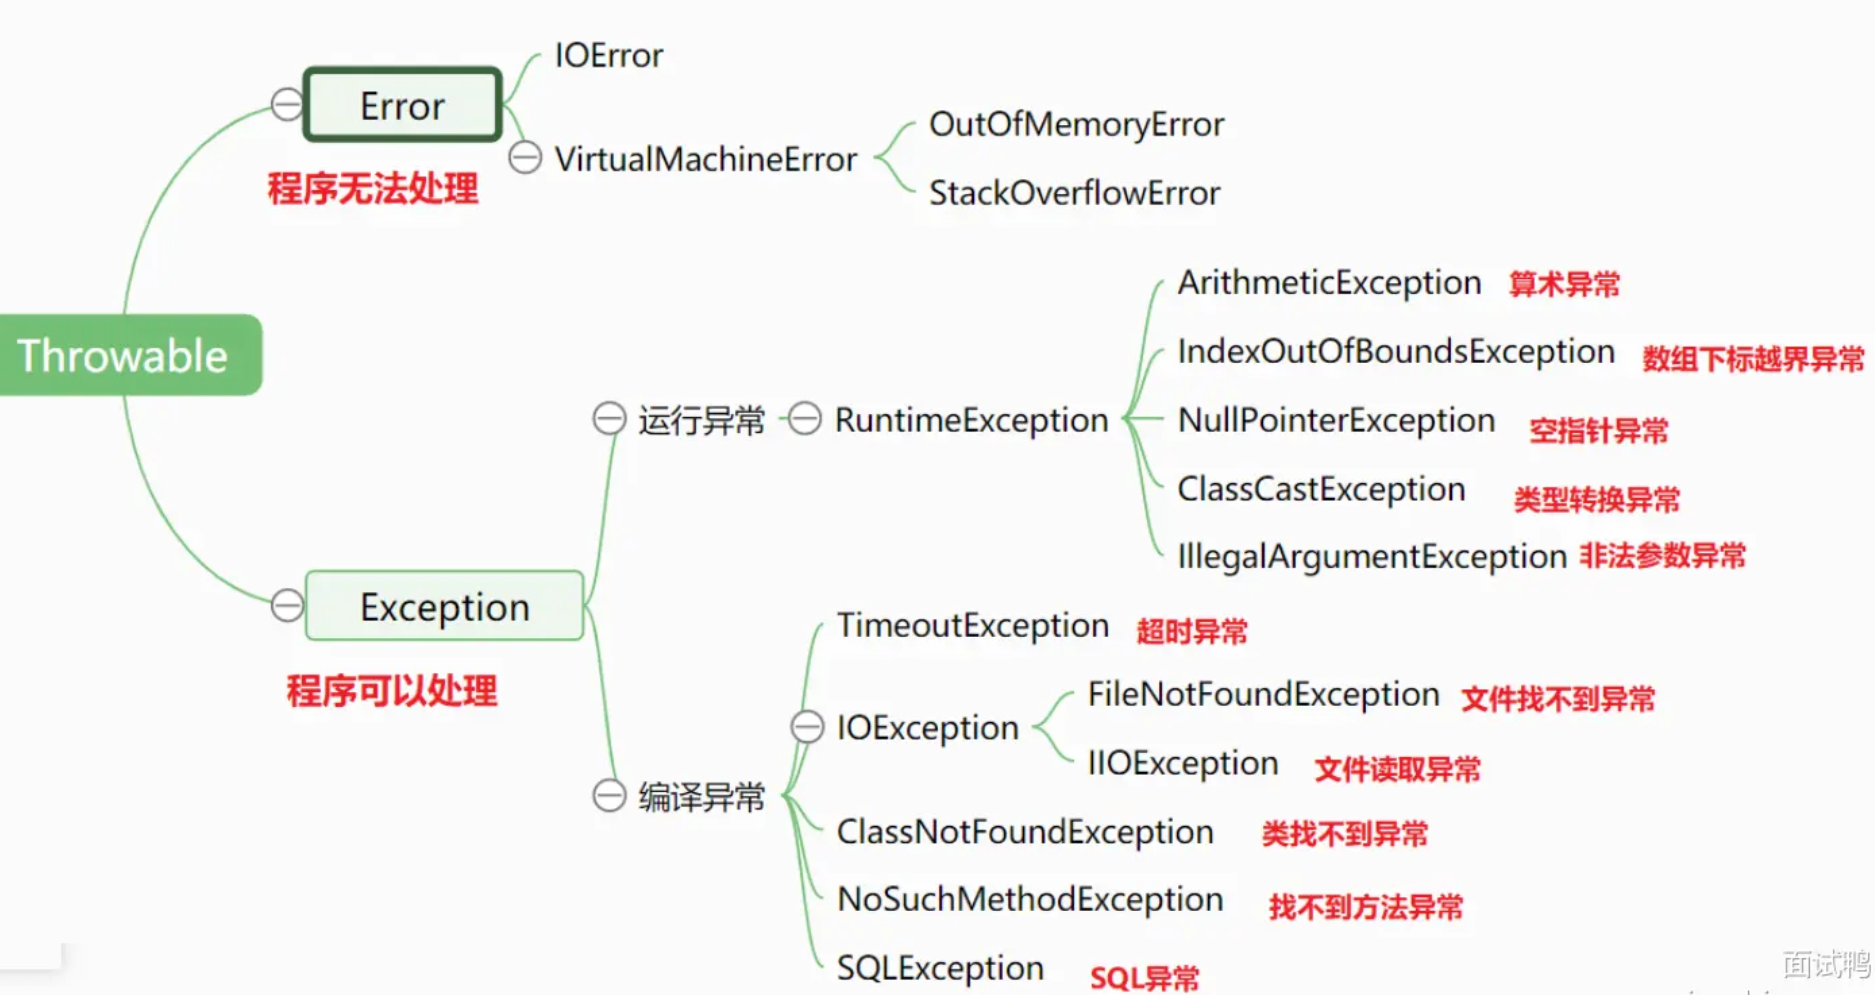
Throwable 是所有错误和异常的基类。
Error:严重的错误,这类错误通常是程序无法处理的。比如,OutOfMemoryError 表示内存不足,StackOverflowError 表示栈溢出。这些错误通常与 JVM 的运行状态有关,一旦发生,应用程序通常无法恢复。
Exception:程序可以处理的异常。又分为:
编译时异常(Checked Exception):在编译时必须被显式处理(捕获或声明抛出)。否则会编译不会通过。
运行时异常(Runtime Exception):程序运行错误导致的。如 NullPointerException、IndexOutOfBoundsException 等。
Throwable 类常用方法有哪些?
String getMessage(): 返回异常发生时的详细信息String toString(): 返回异常发生时的简要描述String getLocalizedMessage(): 返回异常对象的本地化信息。使用Throwable的子类覆盖这个方法,可以生成本地化信息。如果子类没有覆盖该方法,则该方法返回的信息与getMessage()返回的结果相同void printStackTrace(): 在控制台上打印Throwable对象封装的异常信息
异常的处理方式?
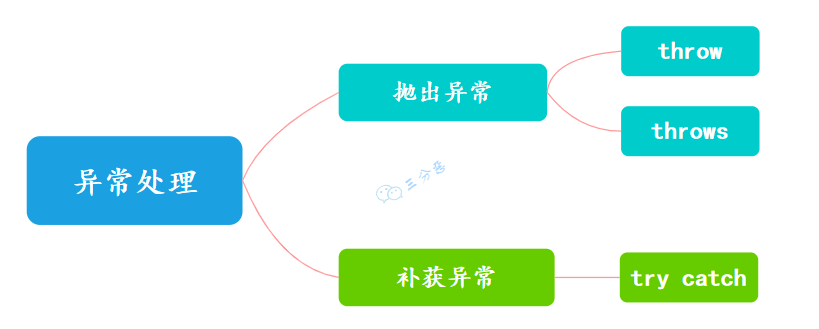
1、抛出异常,可以直接通过 throw 和 throws.
throws 关键字用于声明可能会抛出的异常,而 throw 关键字用于抛出异常。
public void test() throws Exception {
throw new Exception("抛出异常");
}2、使用 try-catch-finally捕获异常,处理异常。
try块:用于捕获异常。其后可接零个或多个catch块,如果没有catch块,则必须跟一个finally块。catch块:用于处理 try 捕获到的异常。finally块:无论是否捕获或处理异常,finally块里的语句都会被执行。当在try块或catch块中遇到return语句时,finally语句块将在方法返回之前被执行。
注意:不要在 finally 语句块中使用 return!
try {
//包含可能会出现异常的代码以及声明异常的方法
}catch(Exception e) {
//捕获异常并进行处理
}finally {
//可选,必执行的代码
}关于****try-catch-finally 执行顺序问题:
执行 try —>catch——>finally
- finally 总是执行:除非 JVM 退出(System.exit())
- return 的执行时机:
- 先计算 return 表达式的值并暂存
- 执行 finally 块
- 最后返回暂存的值(除非 finally 中有 return)
- 异常覆盖规则:
- 如果 finally 抛出异常,会覆盖 try/catch 的异常
- 可以使用
addSuppressed()保存被覆盖的异常
如果在 try 或 catch 中调用 System.exit(),finally 不会执行,即finally 可能发生系统调用等问题,而不会调用
- try 若捕获到异常,则 catch 内容会执行;反之 catch 不会执行。
- finally 若有 return,在整个过程中,先执行 try-catch 的内容,然后在返回 try 内容之前会执行 finally 的内容,会导致 finally 中的 return 直接返回,而未返回 try 的方法。
finally 中有 return
public static int test() {
try {
System.out.println("try 块");
return 1;
} finally {
System.out.println("finally 块");
return 2; // 这会覆盖 try 中的 return
}
}
// 输出顺序:
// try 块
// finally 块
// 方法返回 2finally 中抛出异常
try {
System.out.println("try 块");
} finally {
System.out.println("finally 块");
throw new RuntimeException("finally 异常");
}
// 输出顺序:
// try 块
// finally 块
// 然后抛出 RuntimeException
// 如果 try 块也有异常,finally 的异常会覆盖它catch和finally的异常可以同时抛出吗?
**不能,会覆盖 try/catch 的异常。**解决方法,在 try 或 catch 中设置一个临时变量保存,
public class Example {
public static void main(String[] args) {
Exception catchException = null; // 临时变量
try {
throw new Exception("Exception in try");
} catch (Exception e) {
catchException = e;
throw new RuntimeException("Exception in catch");
} finally {
try {
throw new IllegalArgumentException("Exception in finally");
} catch (IllegalArgumentException e) {
if (catchException != null) {
System.out.println("Catch exception: " + catchException.getMessage());
}
System.out.println("Finally exception: " + e.getMessage());
}
}
}
}- finally 非 return 方法,虽然还是try 返回前先执行 finally,但是非 return 方法不会提前跳出,所以还是会执行到 try 中。
IO 流
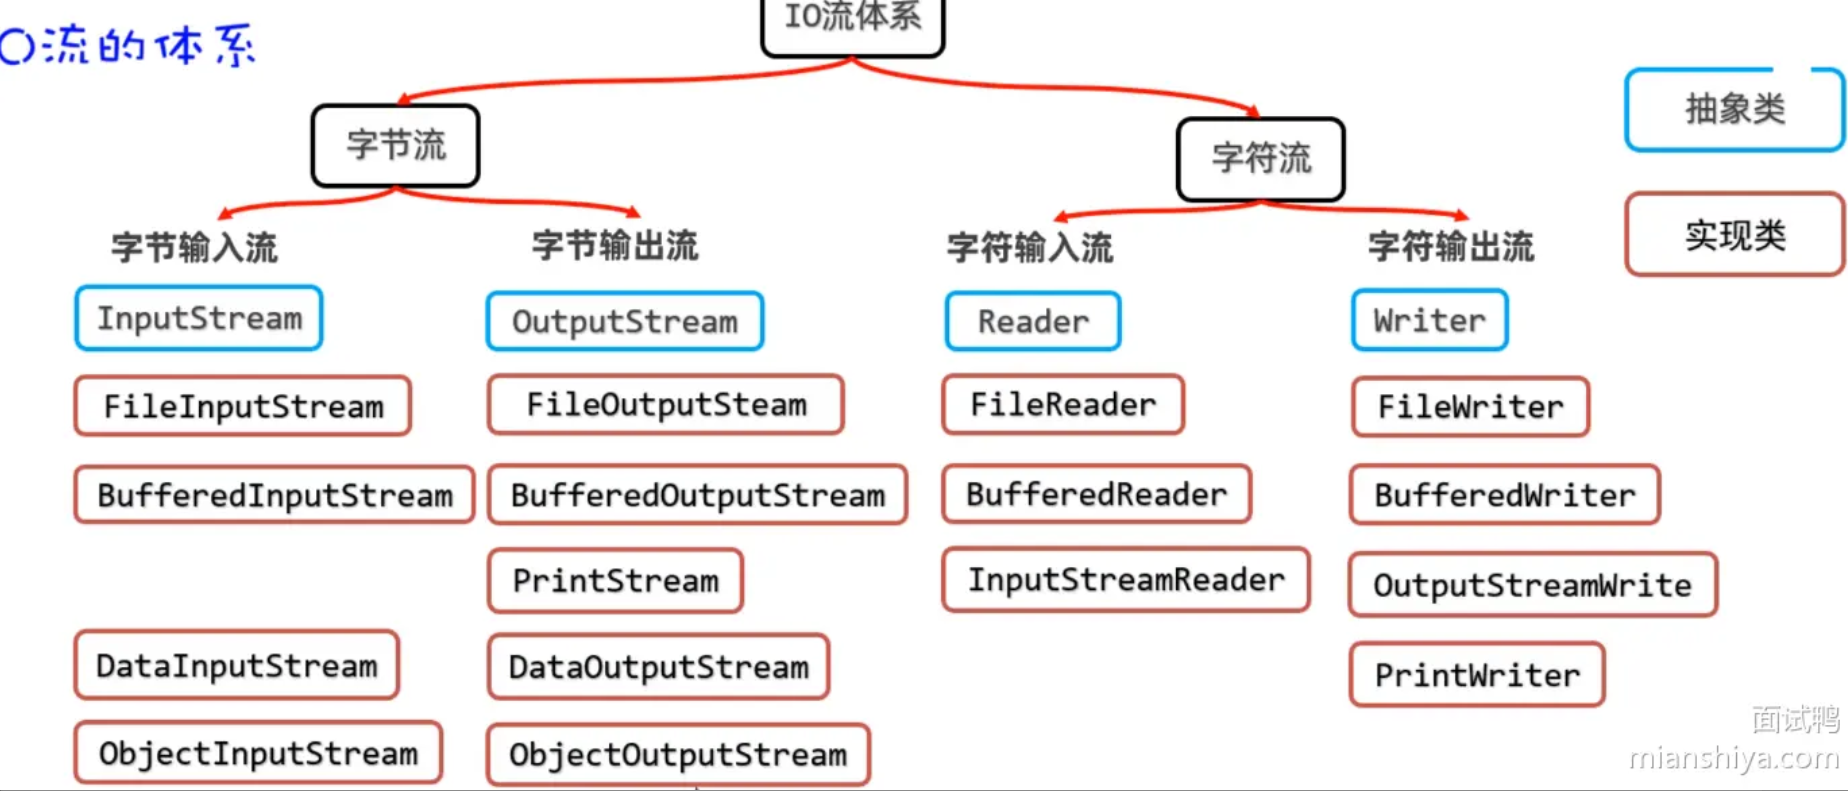
分类
按照数据流方向如何划分?
输入流(Input Stream):从源(如文件、网络等)读取数据到程序。
输出流(Output Stream):将数据从程序写出到目的地(如文件、网络、控制台等)。
按处理数据单位如何划分?
字节流(Byte Streams):以字节为单位读写数据,主要用于处理二进制数据,如音频、图像文件等。
字符流(Character Streams):以字符为单位读写数据,主要用于处理文本数据。(直接传输文本,防止乱码)
按功能如何划分?
节点流(Node Streams):直接与数据源或目的地相连,如 FileInputStream、FileOutputStream。
处理流(Processing Streams):对一个已存在的流进行包装,如缓冲流 BufferedInputStream、BufferedOutputStream。
管道流(Piped Streams):用于线程之间的数据传输,如 PipedInputStream、PipedOutputStream。
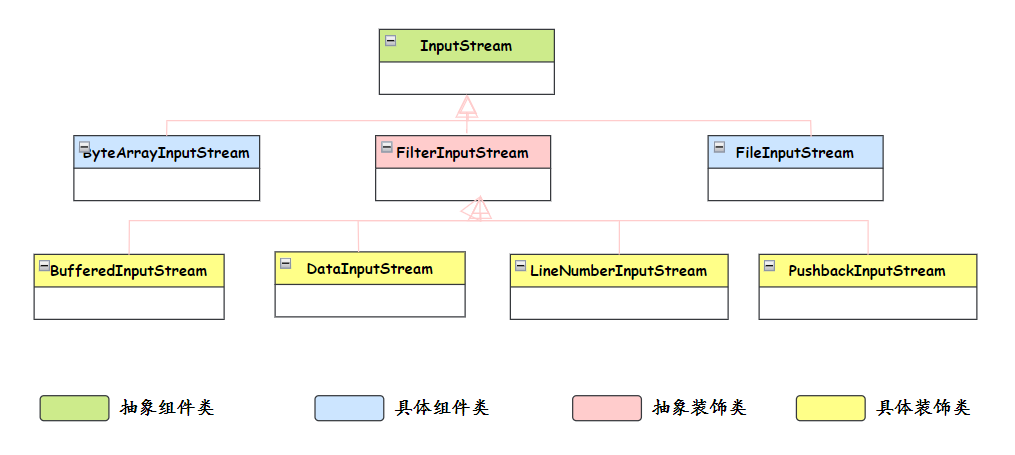
IO 流用到了什么设计模式?
装饰器模式。
Java 缓冲区溢出,如何预防
Java 缓冲区溢出主要是由于向缓冲区写入的数据超过其能够存储的数据量。可以采用这些措施来避免:
①、合理设置缓冲区大小:在创建缓冲区时,应根据实际需求合理设置缓冲区的大小,避免创建过大或过小的缓冲区。
②、控制写入数据量:在向缓冲区写入数据时,应该控制写入的数据量,确保不会超过缓冲区的容量。Java 的 ByteBuffer 类提供了remaining()方法,可以获取缓冲区中剩余的可写入数据量。
BIO、NIO、AIO 之间的区别?(重点)
Java 常见的 IO 模型有三种:BIO、NIO 和 AIO。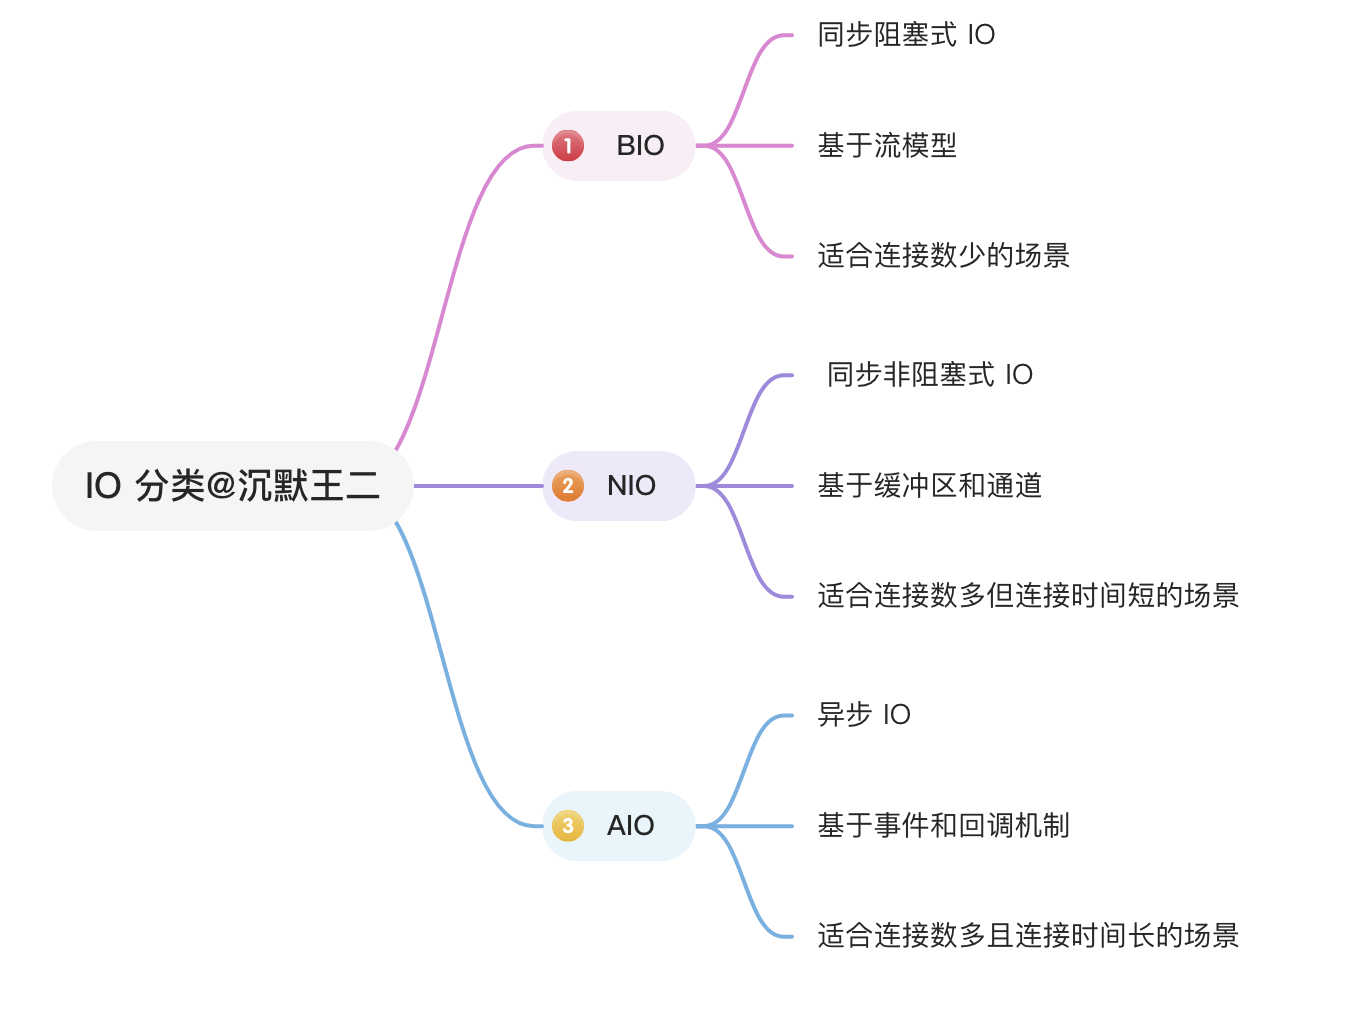
序列化:
什么是序列化?什么是反序列化?
**序列化(Serialization)**是指将对象转换为字节流的过程,以便能够将该对象保存到文件、数据库,或者进行网络传输。
**反序列化(Deserialization)**就是将字节流转换回对象的过程,以便构建原始对象。
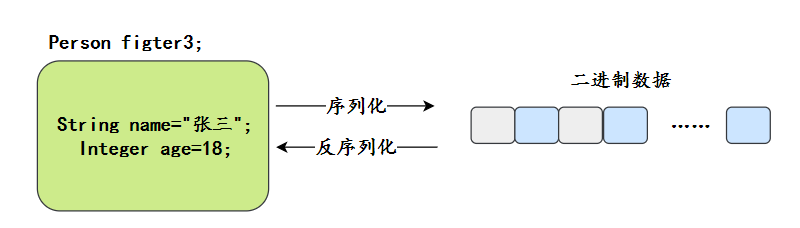
使用Serializable接口标记一个类可以被序列化。
public class Person implements Serializable {
private String name;
private int age;
// 省略 getter 和 setter 方法
}但是由于版本兼容问题,在这个过程中需要生成序列号serialVersionUID ,作为标识类版本的唯一标识符。
- 隐式生成
serialVersionUID会在类变化时,自动更新,导致反序列化失败。 - 显示生成
private static final long serialVersionUID = 1L;省事,或使用 IDEA 自动生成
注意:序列化是在对象和字节流之间的转换,所以 static 是静态对象,属于类,无法被序列化。
同时在对象中,可以使用transient关键字修饰不想序列化的变量。private transient int age;
序列化的过程 :
1、实现Serializable 接口。(标注可序列化)
public class Person implements Serializable {
private String name;
private int age;
// 省略构造方法、getters和setters
}2、将对象写入输出流中,使用 ObjectOutputStream
ObjectOutputStream out = new ObjectOutputStream(new FileOutputStream("person.ser"));3、调用 ObjectOutputStream 的 writeObject 方法,将对象序列化并写入到输出流中
Person person = new Person("沉默王二", 18);
out.writeObject(person);说说有几种序列化方式?
Java 序列化方式有很多,常见的有三种:
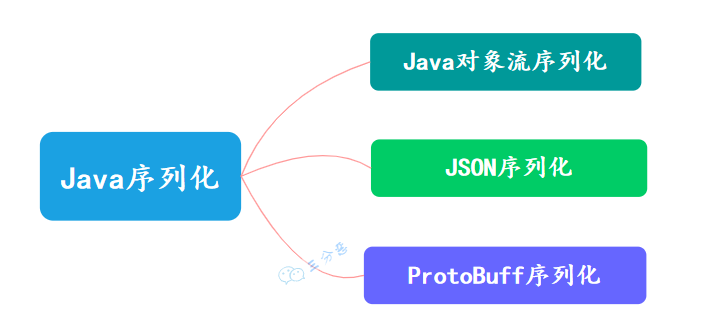
- Java 对象序列化 :Java 原生序列化方法即通过 Java 原生流(InputStream 和 OutputStream 之间的转化)的方式进行转化,一般是对象输出流
ObjectOutputStream和对象输入流ObjectInputStream。 - Json 序列化:这个可能是我们最常用的序列化方式,Json 序列化的选择很多,一般会使用 jackson 包,通过 ObjectMapper 类来进行一些操作,比如将对象转化为 byte 数组或者将 json 串转化为对象。
- ProtoBuff 序列化:ProtocolBuffer 是一种轻便高效的结构化数据存储格式,ProtoBuff 序列化对象可以很大程度上将其压缩,可以大大减少数据传输大小,提高系统性能。
序列化在网络模型的第几层?
- 应用层
- 传输层
- 网络层
- 网络接口层
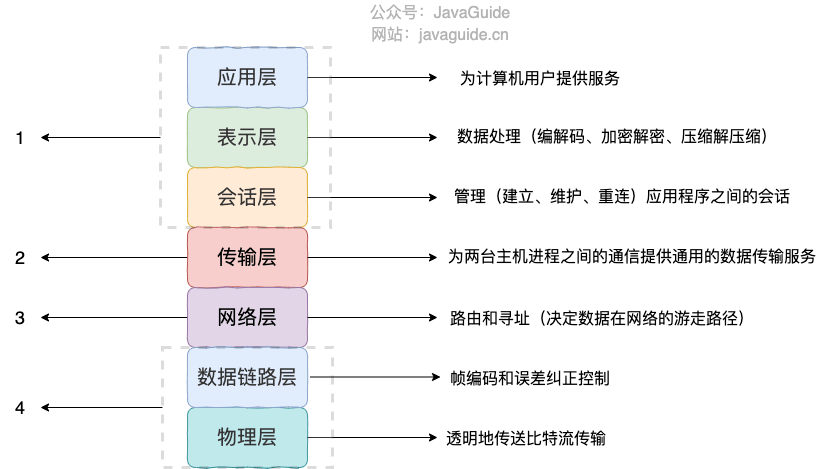
OSI 七层协议模型中,表示层做的事情主要就是对应用层的用户数据进行处理转换为二进制流。反过来的话,就是将二进制流转换成应用层的用户数据。这不就对应的是序列化和反序列化么?
因为,OSI 七层协议模型中的应用层、表示层和会话层对应的都是 TCP/IP 四层模型中的应用层,所以序列化协议属于 TCP/IP 协议应用层的一部分。
杂题:
Java8 新特性
1.Lambda表达式:以简洁的方式来表示 函数式接口的实例
2.StreamAPl:更方便处理集合操作,过滤、排序、分组、映射 操作等。
3.接口的默认方法:在接口中使用 default 定义的方法
4.新日期时间APl:LocalDateTime、LocalDate、LocalTime等。不可变类、线程安全
5.元空间代替永久代:元空间是分配在直接内存中,解决永久代存在的内存不足、GC效率低的问题
RPC框架了解吗?
RPC(Remote Procedure Call,远程过程调用)是一种协议,允许程序调用位于远程服务器上的方法,就像调用本地方法一样。RPC 通常基于 Socket 通信实现。
RPC 框架支持高效的序列化(如 Protocol Buffers)和通信协议(如 HTTP/2),屏蔽了底层网络通信的细节,开发者只需关注业务逻辑即可。
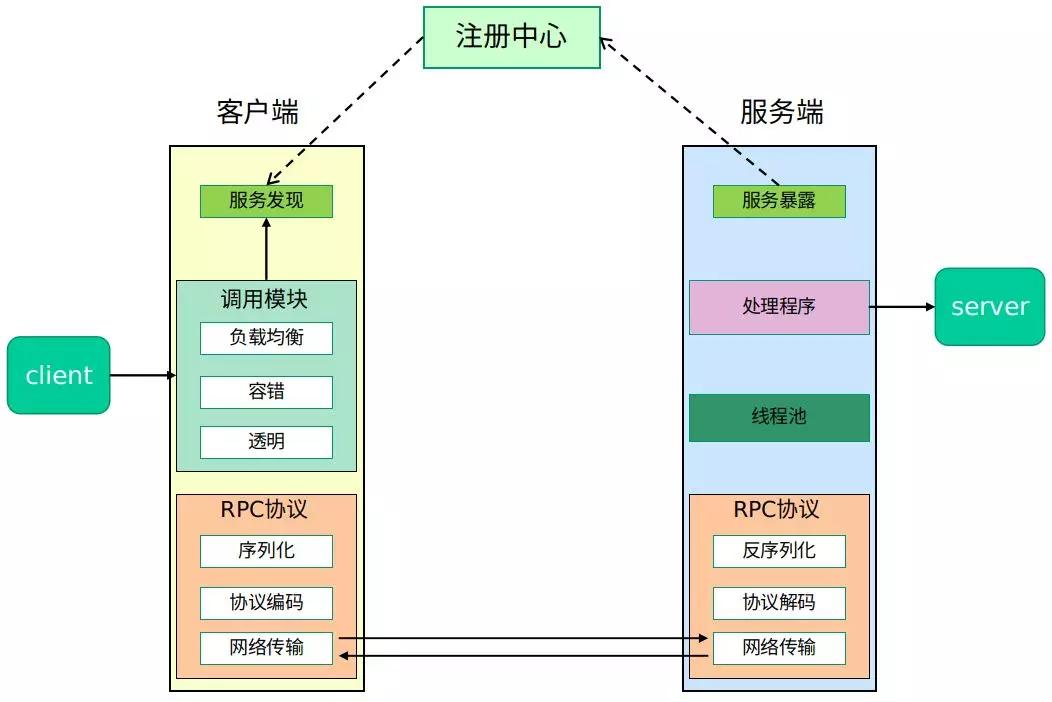
常见的 RPC 框架包括:
- gRPC:基于 HTTP/2 和 Protocol Buffers。
- Dubbo:阿里开源的分布式 RPC 框架,适合微服务场景。
- Spring Cloud OpenFeign:基于 REST 的轻量级 RPC 框架。
- Thrift:Apache 的跨语言 RPC 框架,支持多语言代码生成。
API 和 SPI 的区别:
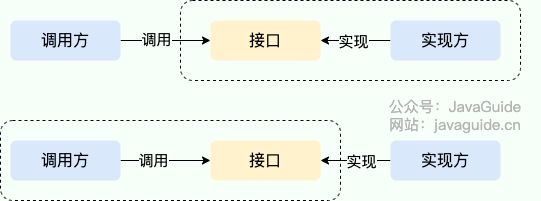
API 就是提供了接口和实现,需要什么方法调用即可。
SPI 提供了调用和接口,直接提供服务即可。
比如:API 就是提供的方法。SPI 就是提供了不同方案的相同实现,比如 tomcat 不同版本,但是效果一致。
泛型:
泛型主要用于提高代码的类型安全(将运行时异常转为编译时异常),它允许在定义类、接口和方法时使用类型参数,这样可以在编译时检查类型一致性,避免不必要的类型转换和类型错误。
没有泛型的时候,像 List 这样的集合类存储的是 Object 类型,导致从集合中读取数据时,必须进行强制类型转换,否则会引发 ClassCastException。
类型参数的定义:以方法的定义为例,在方法定义时,将方法签名中的形参的数据类型也设置为参数(也可称之为类型参数),在调用该方法时再从外部传入一个具体的数据类型和变量。
List list = new ArrayList();
list.add("hello");
String str = (String) list.get(0); // 必须强制类型转换泛型一般有三种使用方式:泛型类、泛型接口、泛型方法。
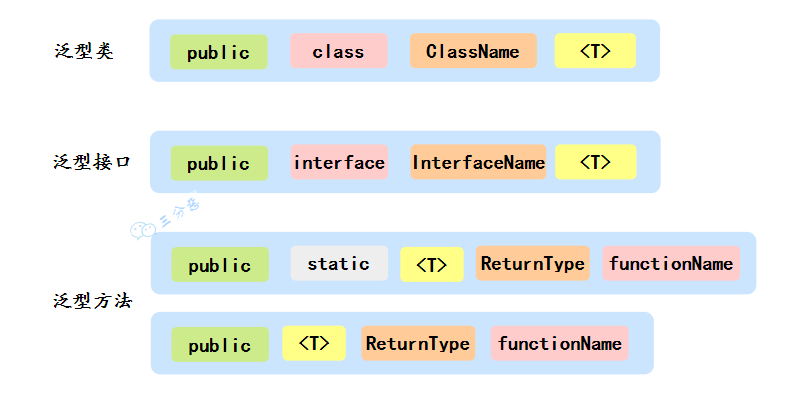
泛型变量:private T key;
T :代表一般的任何类。
E :代表 Element 元素的意思,或者 Exception 异常的意思。
K :代表 Key 的意思。
V :代表 Value 的意思,通常与 K 一起配合使用。
S :代表 Subtype 的意思,文章后面部分会讲解示意。
泛型擦除:
泛型的本质是将数据类型参数化,它通过擦除的方式来实现,即编译器会在编译期间擦除代码中的所有泛型语法并相应的做出一些类型转换动作。
换而言之,泛型信息只存在于代码编译阶段,在代码编译结束后,与泛型相关的信息会被擦除掉,用对象的上限(Object)替代这些类型参数,专业术语叫做泛型擦除。也就是说,成功编译过后的 class 文件中不包含任何泛型信息,泛型信息不会进入到运行时阶段。
**为什么这么做呢?**向后兼容。但是会引发泛型类型信息的丢失,进而导致运行时的类型错误问题
泛型的上下界:
PECS 原则(Producer Extends,Consumersuper)是Java 泛型中使用通配符时的一个重要原则。它帮助我们在使用泛型类和方法时,正确地选择通配符的上界(extends )或下界(super ),以确保类型安全性和灵活性。
PECS 原则的解释:
Producer Extends:如果一个对象提供(生产)某种类型的数据(即你从中读取数据),那么使用泛型的上界通配符<? extends T>。这样可以确保你从中读取的数据是T类型或其子类型。
Consumersuper: 如果一个对象接收(消费)某种类型的数据(即你往里写数据),那么使用泛型的下界通配符<? super T>。这样可以确保你可以向其中写入 T 类型或其子类型的数据。
上界通配符 **<? extends T>**:T 代表了类型参数的上界,**<? extends T>**表示类型参数的范围是 T 和 T 的子类。需要注意的是: **<? extends T>** 也是一个数据类型实参,它和 Number、String、Integer 一样都是一种实际的数据类型。
下界通配符 <? super T>:T 代表了类型参数的下界,<? super T>表示类型参数的范围是 T 和 T 的超类,直至 Object。需要注意的是: <? super T> 也是一个数据类型实参,它和 Number、String、Integer 一样都是一种实际的数据类型。而且这里的下界,指的是 T 类及其超类直至 Object 类型都可以加入该集合
java 乱码的原因:
1、默认编码在不同 OS 中不同,导致字符处理时,导致不一致。
2、流处理时,未指定编码
3、数据库乱码
java 不可变类
就是不可修改的类,其中类用 final,变量用 private finall 修饰(不写 setter 方法)
本质是在类加载时创建好内存并赋值,这样线程安全,但是频繁修改会浪费资源,
java 中的 for 循环、foreach 循环(增强 for 循环)、Iterator 迭代器循环、ListIterator接口
for 循环:常见的循环
foreach:是基于Iterator 迭代器中遍历功能实现的,好处就是不用索引遍历元素, for(type element 自定义的 i,遍历的集合)
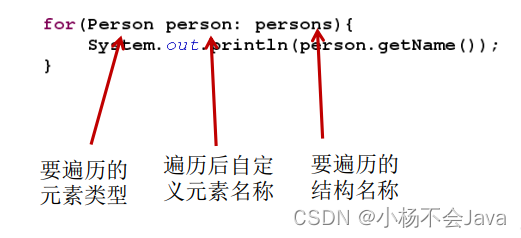
Iterator 迭代器循环:对 java 所有Collection集合进行遍历等操作。
| 修饰与类型 | 方法与描述 |
|---|---|
boolean |
hasNext() 如果仍有元素可以迭代,则返回true。(很像IsEmpty()) |
E |
next()获取当前元素的值,并返回迭代的下一个元素的地址。 |
void |
remove()从迭代器指向的 collection 中移除迭代器返回的最后一个元素(可选操作)。 |
//第一步:获取集合对象的迭代器对象Iterator
Iterator it = c.iterator();
//第二步:通过以上获取的迭代器对象开始迭代/遍历集合。
while(it.hasNext()){
Object obj = it.next();//不管你当初存进去什么,取出来统一都是Object。
System.out.println(obj);
}ListIterator接口:继承于Iterator接口,只能用于各种List类型的访问。功能更强大。
特点:
双向遍历,可以获取下标,可以修改元素
list 接口:
- ArrayList:动态数组
- LikedList:双向链表
- Vector:动态数组+线程安全
| 方法 | 说明 |
|---|---|
boolean hasNext() |
是否还有下一个元素(继承自 Iterator)。 |
E next() |
返回下一个元素(继承自 Iterator)。 |
boolean hasPrevious() |
是否还有前一个元素(ListIterator 特有)。 |
E previous() |
返回前一个元素(ListIterator 特有)。 |
int nextIndex() |
返回下一个元素的索引(ListIterator 特有)。 |
int previousIndex() |
返回前一个元素的索引(ListIterator 特有)。 |
void remove() |
删除当前元素(继承自 Iterator)。 |
void set(E e) |
修改当前元素(ListIterator 特有)。 |
void add(E e) |
插入新元素(ListIterator 特有)。 |
List<String> list = new ArrayList<>(Arrays.asList("A", "B", "C"));
ListIterator<String> iterator = list.listIterator();
// 正向遍历
while (iterator.hasNext()) {
System.out.print(iterator.next() + " "); // A B C
}
// 反向遍历
while (iterator.hasPrevious()) {
System.out.print(iterator.previous() + " "); // C B A
}
//修改和插入元素
while (iterator.hasNext()) {
String element = iterator.next();
if ("B".equals(element)) {
iterator.set("BB"); // 修改当前元素
iterator.add("X"); // 插入新元素
}
}
//获取索引
while (iterator.hasNext()) {
int nextIndex = iterator.nextIndex();
String element = iterator.next();
System.out.println("Index: " + nextIndex + ", Value: " + element);
}java 函数式编程
函数式编程的目的就是,关注输入的参数和输出的结果。不用关注其他代码。
Lambda表达式是函数式编程思想的体现
关注的也是输入的参数和输出的结果
代码语法:(参数列表)->{代码}
Stream 流
是将 java 集合类和数组转换成流的形式,快速进行操作,然后再转换回去。
常见操作:
创建流
- 单列集合:
集合对象.stream() - 数组:
Arrays.stream(数组)或者使用Stream.of来创建 - 双列集合:转换成单列集合后再创建
操作流
- filter():可以对流中的元素进行条件过滤,符合过滤条件的才能继续留在流中。、
- map():可以把对流中的元素进行计算或转换。
- distinct():可以去除流中的重复元素。 注意:distinct方法是依赖Object的equals方法来判断是否是相同对象的。所以需要注意重写equals方法。
- sorted():可以对流中的元素进行排序。
- 注意:如果调用空参的sorted()方法,需要流中的元素是实现了Comparable。
- limit():可以设置流的最大长度,超出的部分将被抛弃。
- skip():跳过流中的前n个元素,返回剩下的元素
- flatMap():map只能把一个对象转换成另一个对象来作为流中的元素。而flatMap可以把一个对象转换成多个对象作为流中的元素。
结束操作:
- forEach:对流中的元素进行遍历操作,我们通过传入的参数去指定对遍历到的元素进行什么具体操作。
- count:可以用来获取当前流中元素的个数。
- max&min:可以用来或者流中的最值。
- collect:把当前流转换成一个集合。
查找与匹配(结束操作)
- anyMatch:可以用来判断是否有任意符合匹配条件的元素,结果为boolean类型。
- allMatch:可以用来判断是否都符合匹配条件,结果为boolean类型。如果都符合结果为true,否则结果为false。
- noneMatch:可以判断流中的元素是否都不符合匹配条件。如果都不符合结果为true,否则结果为false
- findAny:获取流中的任意一个元素。该方法没有办法保证获取的一定是流中的第一个元素。
- findFirst:获取流中的第一个元素。
- reduce归并
Optional
java8 提供的容器类,用来包装空指针异常,简化空指针异常的代码(更优雅的代码来避免空指针异常。)
作用:
- 减少 NulPointerException:通过 optiona1 提供的操作方法,避免直接使用 nu11 进行空值检查,从而降低空指针异常的风险。
- 提高代码可读性: 0ptiona1提供了一套简洁的 AP!,例如 ispresent()、ifpresent()和 orE1se(),可以让代码更具表达性,清晰地展示处理空值的逻辑。
创建对象:
- **ofNullable(T value)****:**创建一个包含非空值的 optional 。推荐使用
- **of(T value):**创建一个包含非空值的 optional 。
- **empty():**创建一个空的 optional。
获取值:
- **get():**获取 optional 中的值(不推荐直接使用,可能抛出异常)。
- **orElse(T other):**如果 optional 为空,返回默认值。
- **orElseGet(Supplier<?extends T>):**如果 optional为空,执行 supplier 提供的操作,返回值。推荐使用
- **orElseThrow((Supplier<Throwable>):**获取数据,如果数据不为空就能获取到该数据。如果为空则根据你传入的参数来创建异常抛出。
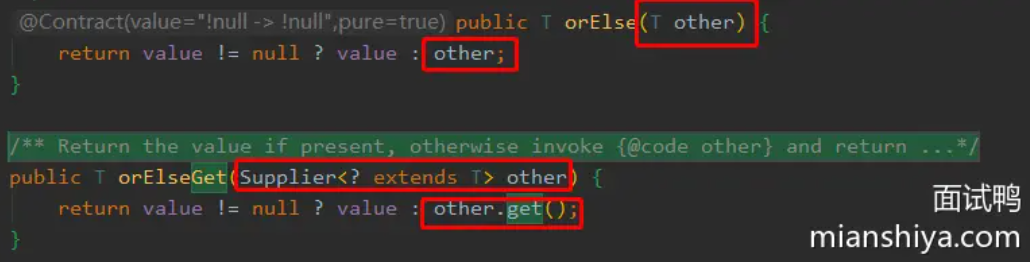
上述两个函数orElse(),orElseGet()由于传入参数的不同和optional 类型会导致无论是否为 NULL 值,下面的逻辑都会执行,导致最后返回的值一个是默认值,和执行 supplier 提供的操作,返回的值。
结果上看orElse()速度慢。
对值的判断:
- **isPresent():**判断optional 中是否包含值。
- **ifPresent(Consumer<?super T>):**如果 optional 中包含值,则执行指定的操作。
过滤**:**
- filter():数据进行过滤。如果原本是有数据的,但是不符合判断,也会变成一个无数据的Optional对象。
数据转换**:**
- map():对数据进行转换,并且转换得到的数据也还是被Optional包装好的,保证了我们的使用安全。
并行流:
把任务分配给多个线程去完成,和单线程的 Stream()不一样的是创建的函数不同,其他方法一致。
创建并行流:parallelStream(),
函数式接口
常见函数式接口
Consumer 消费接口
Function 计算转换接口
Predicate 判断接口
Supplier 生产型接口
常用的默认方法
and 并且
or 或者
negate 取反
方法引用:
方法引用:
方法体中只有一个方法的调用的话(包括构造方法),简化显示。(和匿名方法一样,只关注类名/对象名,方法名)格式: 类名或者对象名::方法名
在 lambda 中,只需要关注形参和方法体代码。但是出现静态和成员方法时,还可以再简化
1、调用了某个类的静态方法,重写的抽象方法中所有的参数都按照顺序传入了这个静态方法中
2、调用了某个对象的成员方法,重写的抽象方法中所有的参数都按照顺序传入了这个成员方法中
3、调用了第一个参数的成员方法,重写的抽象方法中剩余的所有的参数都按照顺序传入了这个成员方法中
构造器引用: 如果方法体中的一行代码是构造器的话就可以使用构造器引用。格式:类名::new