
- PyTorch是一个Python包,提供两个高级功能:
- 具有强大的GPU加速的张量计算(如NumPy)
- 包含自动求导系统的的深度神经网络
一、环境的安装
1.安装Anaconda
2.显卡GPU的准备(个人未选择安装,安装巨麻烦,而且24年很多博主说不需要安装,在虚拟环境下可以下载cudatoolkit和cudnn包)
本人NVIDIA显卡驱动cuda driver为12.7
查看命令:nvidia-smi
区分一下显卡CUDA driver驱动版本和运行版本
驱动是电脑显卡的驱动器版本,运行版本是小于等于运行版本的
本人安装的是CUDA11.6(运行版本)对应CUDNN为11.x(8.60)版本
为什么安装CUDA运行版本和CUDNN?
简单点说,安装pytorch,就是安装CUDA的阉割版;安装CUDA就是安装完整版,安装CUDNN就是下载对应深度学习加速库,有对应API
但是但是要依赖VScode,就是那个紫色的代码软件
3.管理环境的准备:由于环境版本多,所以要创建几个环境变量
查看环境:conda env list
在Anconda prompt管理器中打开输入
conda create -n pytorch_py39 python=3.9
#-n 后面输入的环境名称
#安排python3.9
conda activate pytorch_py39 #为选择环境名
pip list #为查找当前环境下的包4.pytorch的安装
事先准备:
切换国内镜像源: 修改 .condarc 文件(最强硬)
Windows 中,该文件的位置在:C:\Users(你的用户名).condarc
修改如下
show_channel_urls: true
ssl_verify: true
channels:
- https://mirrors.tuna.tsinghua.edu.cn/anaconda/cloud/msys2/
- https://mirrors.tuna.tsinghua.edu.cn/anaconda/cloud/conda-forge
- https://mirrors.tuna.tsinghua.edu.cn/anaconda/pkgs/free/
- defaults
//修改虚拟环境中安装包中的env和pkgs的位置
envs_dirs:
- D://CodeInstall//Anaconda//envs
pkgs_dirs:
- D://CodeInstall//Anaconda//pkgs 安装pytorch
#查看显卡版本,无空格
nvidia-smi原笔记图片缺失:image-20240918170106447
进入pytorch的环境,注意安装的CUDA版本要小于等于自己安装的CUDA版本并且要对应python版本
复制上面的命令行
conda install pytorch torchvision torchaudio pytorch-cuda=11.8 -c pytorch -c nvidia检验安装
#cmd进入python环境
python
#导入torch,如果不报错就没问题了
import torch
#查看是否能够使用当前机器的GPU
torch.cuda.is_available()5.切换虚拟环境
先查看环境下的list
conda env list
在激活对应环境
conda activate 虚拟环境名
查看安装的包
conda list
6.虚拟环境的卸载
conda remove -n 虚拟环境名称 --all
7.虚拟环境相关命令:
查看当前存在哪些虚拟环境:conda env list 或 conda info -e; 查看安装了哪些包: conda list; 退出虚拟环境: conda deactivate; 卸载虚拟环境 :conda remove -n your_env_name(虚拟环境名称) --all; 创建虚拟环境:conda create -n your_env_name(虚拟环境名称); 激活虚拟环境:conda activate your_env_name(虚拟环境名称);
二、编译器的选择
Pycharm或jupyter-notebook
1.Pycharm中创建pytorch项目(换环境)
1.进入设置中,项目中python解释器,添加本地的解释器,换到Conda环境,使用现有的“pytorch”环境
名称pytorch是自己取的,实际要先创建环境,再到环境中安装pytorch
2.检查pytorch环境
python
import torch
torch.cuda.is_available(s)#Ture2.在jupyter中安装pytorch
本人电脑python版本为3.11,出现与pytorch版本冲突,
问题来源1:
在Anaconda环境下使用pytorch环境,然后使用了这个命令
conda install nb_canda 下个pthon版本不冲突的,再进行安装即可
原笔记图片缺失:image-20240920204017844
解决方法:
==jupyter相关配置==
在jupyter中查看输入参数shift+tab+tab
三、基础语句
dir()函数,能让我们知道 工具箱以及工具箱中的分隔区有什么东西。
help()函数,能让我们知道每个工具是如何使用的,工具的使用方法。
四、基本数据类型Tensor
参考文章:
4.1Tensor
Tensor张量是Pytorch里最基本的数据结构。直观上来讲,它是一个多维矩阵,支持GPU加速,其基本数据类型如下,分两种数据类型:一种是用CPU加速的,另一种是GPU加速的。
torch.xxxTensor(列表或维度值)
列表就是行列式
维度就是(行数,列数)
| 数据类型 | CPU tensor | GPU tensor |
|---|---|---|
| 8位无符号整型 | torch.ByteTensor | torch.cuda.ByteTensor |
| 8位有符号整型 | torch.CharTensor | torch.cuda.CharTensor |
| 16位有符号整型 | torch.ShortTensor | torch.cuda.ShortTensor |
| 32位有符号整型 | torch.IntTensor | torch.cuda.IntTensor |
| 64位有符号整型 | torch.LongTensor | torch.cuda.LonfTensor |
| 32位浮点型 | torch.FloatTensor | torch.cuda.FloatTensor |
| 64位浮点型 | torch.DoubleTensor | torch.cuda.DoubleTensor |
| 布尔类型 | torch.BoolTensor | torch.cuda.BoolTensor |
指定数据类型:dtype=数据类型
| 函数名称 | 函数解释 |
|---|---|
| torch.FloatTensor | 生成为浮点型的Tensor,传递给torch.FloatTensor的参数是列表或维度值。 |
| torch.IntTensor | 生成为整型的Tensor,传递给传递给torch.IntTensor的参数是列表或维度值 |
| torh.xxxTensor | 基本方法一样 |
| torch.randn() | 生成浮点数且维度指定的随机Tensor,和在numpy中使用的numpy.randn生成的随机数的方法类似,随机生成的浮点数的取值满足均值为0,方差为1的正态分布 |
| torch.rand(*sizes, out=None) → [Tensor] | 返回一个张量,包含了从区间[0, 1)的均匀分布中抽取的一组随机数。张量的形状由参数sizes定义。 |
| torch.arange() | 生成浮点型且起始范围和结束范围的Tensor,所以传递给torch.range的参数有三个,分别为起始值,结束值,步长,其中步长用于指定从起始值到结束值得每步的数据间隔。[step,end],左闭右闭 |
| torch.zeros() | 生成浮点型且维度指定的Tensor,不过这个浮点型的Tensor中的元素值全部为0。 |
| torch.ones | 生成全1的数组。 |
| torch.empty | 创建一个未被初始化数值的tensor,tensor的大小是由size确定,size: 定义tensor的shape ,这里可以是一个list 也可以是一个tuple |
| x = torch.tensor([5,5],[2,3]) | 使用list序列直接创建 |
4.2 Tensor的运算
| 函数名称 | 函数解释 |
|---|---|
| torch.abs | 将参数传递到torch.abs后返回输入参数的绝对值作为输出,输入参数必须是一个Tensor数据类型的变量。 |
| torch.add(input, other, *, alpha=1, out=None) -> Tensor | 将参数传递到torch.add后返回输入参数的求和结果作为输出,输入参数:既可以全部是Tensor数据类型的变量,也可以一个是Tensor数据类型的变量,另一个是标量。 |
| torch.clamp(input, min=None, max=None, *, out=None) -> Tensor | 对输入参数按照自定义的范围进行裁剪,最后将参数裁剪的结果作为输出,所以输入参数一共有三个,(变量名,上界,下界);其中上下界的含义就是输入的数据在范围内就不变,在范围外就变成上下界的大小。 |
| torch.div(input, other, *, rounding_mode=None, out=None) -> Tensor | 将参数传递到torch.div后返回输入参数的求商结果作为输出,同样,参与运算的参数可以全部是Tensor数据类型的变量,也可以是Tensor数据类型的变量和标量的组合 |
| torch.pow(input, exponent, *, out=None) -> Tensor | 将参数传递到torch.pow后返回输入参数的求幂结果作为输出,参与运算的参数可以全部是Tensor数据类型的变量,也可以是Tensor数据类型的变量和标量的组合。 |
| torch.mm | 将参数传递到torch.mm后返回输入参数的矩阵求积结果作为输出,不过这个求积的方式和之前的torch.mul运算方式不太一样,torch.mm运用矩阵之间的乘法规则进行计算,所以被传入的参数会被当作矩阵进行处理,参数的维度自然也要满足矩阵乘法的前提条件,即前一个矩阵的行数必须和后一个矩阵列数相等 |
| torch.mv | 将参数传递到torch.mv后返回输入参数的求积结果作为输出,torch.mv运用矩阵与向量之间的乘法规则进行计算,被传入的第1个参数代表矩阵,第2个参数代表向量,循序不能颠倒。 |
| torch.as_tensor(data, dtype=None, device=None)->Tensor | 传入参数(list、tuple、ndarray等)转换为tensor |
| torch.from_numpy(ndarray) → Tensor | 传入ndarray数据转换为tensor |
| torch.mean(tensor) | 求平均值。median平均数,sqrt开方 |
一、运算符中最后加_和不加的区别:
例如:torch.add()和torch.add_()
所有的带<font color='red'>_</font>符号的函数都会对原数据进行修改,即x.add_(y),相对于x+y 的结果会存储到原来的x中(即x = x+y)
二、torch.stack()函数
stack为拼接函数,函数的第一个参数为需要拼接的Tensor参数,第二个参数为细分到哪个维度
Pythonimport torch A=torch.IntTensor([[1,2,3],[4,5,6]]) B=torch.IntTensor([[7,8,9],[10,11,12]]) C1=torch.stack((A,B),dim=0) # or C1=torch.stack((A,B)) C2=torch.stack((A,B),dim=1) C3=torch.stack((A,B),dim=2) C4=torch.stack((A,B),dim=-1) print(C1,C2,C3,C4) ''' dim=0,C1 = [ A,B ] dim=1,C2 = [ [ A[0],B[0] ] , [ A[1],B[1] ] ] dim=2,C3 = [ [ [ A[0][0],B[0][0] ] , [ A[0][1],B[0][1] ] , [ A[0][2],B[0][2] ] ], [ [ A[1][0],B[1][0] ] , [ A[1][1],B[1][1] ] , [ A[1][2],B[1][2] ] ] ] dim=-1,C4 = C3 '''dim的不同值表示不同维度。特别的在dim=0表示二维中的行,dim=1在二维矩阵中表示列。广泛的来说,我们不管一个矩阵是几维的,比如一个矩阵维度如下:(do,d.,…, dn-1),那么dim=0就表示对应到dg也就是第一个维度,dim=1表示对应到di也就是第二个维度,依次类推。
即:A,B矩阵中使用的是三维矩阵,其中: C1中,dim=0,即高度进行拼接
C2中,dim=1,即行进行拼接
C3中,dim=2,即列进行拼接
C4中,dim=-1,即列进行拼接,为什么-1代表列呢?可以理解为逆向的表示
(-2,-1,0,1,2),其中dim=-2=1,行;dim=-1=2,代表列。
那么在torch.stack()中对tensor拼接使用dim函数代表什么呢?
在二维矩阵下:
- dim = 0,列不变(按列-将当前列所有行数据-计算),指定的是行,那就是行变,理解成:针对每一列中,所有行之间的数据比较或者求和等操作,是每一行的比较,因为行是可变的。
- dim = 1,行不变(按行-将当前行所有列数据-计算),指定的是列,那就是列变,理解成:针对每一行中,所有列之间的数据比较或者求和等操作,是每一行的比较,因为行是可变的。
三、tensor数据的切分
和numpy是一样的
4.3 一些参数的对比
4.3.1 torch.tensor()&&torch.tensor([])
区别:就是圆括号里面是否有[],有[]是列表
import torch
print(torch.Tensor(2,3))
'''
tensor([[0., 0., 0.],
[0., 0., 0.]])
'''
print(torch.Tensor([2,3]))
'''
tensor([2., 3.])
'''4.3.2 torch.randn && torch.randperm&&torch.rand()
区别:
torch.randn是生成的数据类型为浮点型,与numpy.randn生成随机数的方法类似,生成的浮点数的取值满足均值为0,方差为1的正态分布
torch.randperm(n)是创建一个n个整数,随机排列的Tensor
torch.rand(size)是创建一个n个整数,随机均匀分布的Tensor
import torch
print(torch.rand(2,3))
'''
tensor([[0.4199, 0.7724, 0.7531],
[0.3629, 0.2401, 0.5478]])
'''
print(torch.randperm(10))
'''
tensor([7, 4, 5, 1, 6, 0, 2, 9, 8, 3])
'''4.3.3 torch.range(begin,end,step)
torch.range(begin,end,step)生成一个一维的Tensor,三个参数分别的起始位置,终止位置和步长
import torch
print(torch.range(1,41,2))
'''
tensor([ 2., 4., 6., 8., 10., 12., 14., 16., 18., 20., 22., 24., 26., 28.,
30., 32., 34., 36., 38., 40.])
'''如今版本已经不在使用torch.range(),改用torch.arange(),在[begin,end]
4.3.4 利用numpy 创建指定Tensor
很多时候我们需要创建指定的Tensor,而numpy就是一个很好的方式
import torch
import numpy as np
print(torch.tensor(np.arange(15).reshape(3,4)))
'''
tensor([[ 0, 1, 2, 3, 4],
[ 5, 6, 7, 8, 9],
[10, 11, 12, 13, 14]])
'''4.3.5 torch.tensor() 、torch.Tensor()、torch.as_tensor()、transforms.ToTensor()
torch.tensor()
是一个通过深拷贝数据,构造一个新张量的函数:
torch.tensor(data, *, dtype=None, device=None, requires_grad=False, pin_memory=False) →Tensor
即data为 list, tuple, NumPy ndarray, scalar, and other types,就没waring。
如果data为tensor,会报警告;建议使用clone().detach()等函数
import torch
import numpy as np
#使用非tensor类型,不会waring
a = np.array([1,3,4])
t0 = torch.tensor(a)
b = [1,34,5]
t1 = torch.tensor(b)
c = (1,223,423)
t2 = torch.tensor(c)
#使用tensor会导致Userwarning
d = torch.tensor([1,2,3],[1,2,3])
t3 = torch.tensor(d)
print(t0.dtype, t1.dtype, t2.dtype,t3.dtype)
'''
UserWarning: To copy construct from a tensor, it is recommended to use sourceTensor.clone().detach() or sourceTensor.clone().detach().requires_grad_(True), rather than torch.tensor(sourceTensor). t3 = torch.tensor(d)
torch.int64 torch.int64 torch.int64 torch.int64
'''**torch.Tensor() **
是默认张量类型 (torch.FloatTensor()) 的别名。也就是说,torch.Tensor() 的作用实际上跟 torch.FloatTensor() 一样,都是生成一个数据类型为 32 位浮点数的张量,如果没传入数据就返回空张量,如果有列表或者 narray 的返回其对应张量。但无论传入数据本身的数据类型是什么,返回的都是 32 位浮点数的张量。
>>> torch.Tensor()
tensor([])
>>> torch.Tensor().dtype
torch.float32
>>> torch.FloatTensor()
tensor([])
>>> torch.FloatTensor().dtype
torch.float32torch.as_tensor
(data, dtype=None,device=None)->Tensor : 为data生成tensor,保留 autograd 历史记录并尽量避免复制(dtype和devices相同,尽量浅拷贝)。
如果data已经是tensor,且dtype和device与参数相同,则生成的tensor会和data共享内存(浅拷贝)。如果data是ndarray,且dtype对应,devices为cpu,则同样共享内存。其他情况则不共享内存。
#1)数据类型和device相同,浅拷贝,共享内存
import numpy
a = numpy.array([1, 2, 3])
t = torch.as_tensor(a)
t[0] = -1
a,t
#Out[77]: (array([-1, 2, 3]), tensor([-1, 2, 3], dtype=torch.int32))
#2)数据类型相同,但是device不同,深拷贝,不再共享内存
import numpy
a = numpy.array([1, 2, 3])
t = torch.as_tensor(a, device=torch.device('cuda'))
t[0] = -1
a,t
#Out[78]: (array([1, 2, 3]), tensor([-1, 2, 3], device='cuda:0', dtype=torch.int32))
#3)device相同,但数据类型不同,深拷贝,不再共享内存
import numpy
a = numpy.array([1, 2, 3])
t = torch.as_tensor(a, dtype=torch.float32)
t[0] = -1
a,t
Out[80]: (array([1, 2, 3]), tensor([-1., 2., 3.]))transforms.ToTensor()
ToTensor()将shape为(H, W, C)的nump.ndarray或img转为shape为(C, H, W)的tensor,其将每一个数值归一化到[0,1],其归一化方法比较简单。
# 归一化到(0,1)之后,再数据标准化处理 (x-mean)/std,归一化到(-1,1),数据中存在大于mean和小于mean
transform2 = transforms.Compose([
transforms.ToTensor(),
transforms.Normalize(std=(0.5,0.5,0.5),
mean=(0.5,0.5,0.5))])4.3.6 torch.as_strided
torch.as_strided(input, size, stride, storage_offset=0) → Tensor
创建具有指定size,stride和storage_offset的现有torches,input的视图
参数分析:
- input (Tensor) – the input tensor.
- 大小(元组 或 python:ints )–输出张量的形状
- 跨度(元组 或 python:ints )–输出张量的跨度,
- storage_offset (python:int , 可选)–输出张量的基础存储中的偏移量
import torch
>>> x = torch.randn(3, 3)
>>> x
tensor([[ 0.9039, 0.6291, 1.0795],
[ 0.1586, 2.1939, -0.4900],
[-0.1909, -0.7503, 1.9355]])
>>> t = torch.as_strided(x, (2, 2), (1, 2))
>>> t
tensor([[0.9039, 1.0795],
[0.6291, 0.1586]])
>>> t = torch.as_strided(x, (2, 2), (1, 2), 1)
tensor([[0.6291, 0.1586],
[1.0795, 2.1939]])4.3.7 torch.xxx和torch.xxx_like的区别
总结来说,torch.xxx 需要你明确指定新张量的形状,而 torch.xxx_like 则是根据一个已有张量的形状来创建新张量。
torch.ones:
torch.ones函数用于创建一个指定大小的张量,并将所有元素初始化为1。- 它的用法是
torch.ones(*size, *, out=None, dtype=None, layout=torch.strided, device=None, requires_grad=False)。- 你可以指定张量的形状(
size),数据类型(dtype),内存布局(layout),设备(device)等参数。- 例如,
torch.ones(2, 3)会创建一个2行3列的张量,所有元素都是1。torch.ones_like:
torch.ones_like函数用于创建一个与给定张量形状相同、所有元素为1的新张量。- 它的用法是
torch.ones_like(input, *, dtype=None, layout=None, device=None, requires_grad=False, memory_format=torch.preserve_format)。- 你只需要提供一个已有的张量(
input),函数会根据这个张量的形状创建一个新的张量,并且所有元素都是1。- 例如,如果有一个张量
x = torch.empty(2, 3),那么torch.ones_like(x)会创建一个同样形状的张量,所有元素都是1。
4.4 一些常见属性的解释
在函数里面有许多变量参数如size、data、dtype、layout、device、requires_grad等,使用的时候总是迷糊
-
size:大小 (python:int ... )–定义输出张量形状的整数序列。 可以是可变数量的参数,也可以是列表或元组之类的集合。
-
data:数据 (array_like )–张量的初始数据。 可以是列表,元组,NumPy
ndarray,标量和其他类型。
如torch.tensor(data,...)
torch.IntTensor(size,...)
这两个函数输入的参数不同,tensor只接收初始数据,即值确定了的,无法定义张量初始尺寸。而xxxTensor可以直接定义张量尺寸
-
dtype (
torch.dtype,可选)–返回张量的所需数据类型。 默认值:如果None,则从data推断数据类型。 -
设备 (
device,可选)–返回张量的所需设备。 默认值:如果None,则使用当前设备作为默认张量类型
这个参数默认为none,选择当前设备的Cpu或Gpu进行计算。反之可以选择cup和gpu来计算
对应torch.device函数
import torch
#创建一个CPU设备
device_cpu = torch.device("cpu")
#创建一个GPU设备,如果有多个GPU,可以指定编号
device_gpu = torch.device("cuda:0") # 编号0的GPU
-
require_grad (bool , 可选)–如果 autograd 应该在返回的张量上记录操作。 默认值:
False。
在 PyTorch 中,
require_grad是一个张量(Tensor)的属性,用来指示该张量是否需要梯度。当一个张量设置了requires_grad=True时,PyTorch 会自动跟踪对这个张量的所有操作,并计算梯度。这对于训练神经网络时进行反向传播是必要的。以下是一些关于
requires_grad的关键点:
默认值:当你创建一个新的张量时,
requires_grad默认是False。设置
requires_grad:Pythonimport torch # 创建一个张量,并设置requires_grad=True tensor = torch.randn(2, 2, requires_grad=True)查看
requires_grad状态:Pythonprint(tensor.requires_grad) # 输出: True自动梯度计算:当你对设置了
requires_grad=True的张量进行操作时,PyTorch 会记录这些操作,以便在反向传播时计算梯度。停止梯度计算:如果你不想对某个操作的输出计算梯度,可以使用
.detach()方法,这会创建一个新的张量,与原始张量共享数据,但是不会跟踪梯度。Pythondetached_tensor = tensor.detach() print(detached_tensor.requires_grad) # 输出: False梯度清零:在每次反向传播之前,需要将梯度清零,否则梯度会累积。可以使用
.zero_grad()方法。Pythontensor.grad = None # 清空梯度梯度裁剪:为了防止梯度爆炸,可以使用
torch.nn.utils.clip_grad_norm_或torch.nn.utils.clip_grad_value_来裁剪梯度。反向传播:在训练过程中,你需要调用
.backward()方法来计算梯度。Pythonloss = criterion(output, target) loss.backward() # 计算梯度
requires_grad是 PyTorch 中实现自动微分的核心属性之一,对于深度学习模型的训练至关重要。通过正确设置和管理requires_grad,你可以有效地控制梯度的计算和反向传播过程。
-
布局 (
torch.layout,可选)–返回的 Tensor 所需的布局。 默认值:torch.strided。
在 PyTorch 中,
layout是一个与张量(Tensor)相关的概念,它定义了张量数据在内存中的存储方式。不同的layout会影响张量的操作和性能,尤其是在不同的设备(如 CPU 和 GPU)上。PyTorch 支持多种layout,但最常用的是以下几种:
Strided Layout(默认):
- 这是 PyTorch 的默认布局,也是大多数操作所期望的布局。
- 在这种布局中,数据是连续存储的,每个维度的步长(stride)是固定的。
- 对于多维张量,后一个维度的步长是该维度大小乘以前一个维度的步长。
Sparse Layout:
- 稀疏布局用于存储大部分元素为零的张量,以节省内存。
- PyTorch 通过
torch.sparse和torch.sparse_coo_tensor等函数支持稀疏张量。MKLDNN Layout:
- 这是一种针对英特尔 CPU 优化的布局,可以提高某些操作的性能。
- 通常用于与 MKL-DNN 库集成,以加速深度学习模型。
Channels Last Layout:
- 在图像处理中,这种布局将通道维度放在最后,例如,对于一个形状为
(N, C, H, W)的张量,C是通道数,H和W分别是高度和宽度。- 这种布局在某些情况下可以提高性能,尤其是在使用 CUDA 时。
Channels First Layout:
- 与 Channels Last 相反,这种布局将通道维度放在第一个维度,例如
(N, C, H, W)。- 这种布局在某些框架和操作中更常见。
Packed Layout:
- 这是一种特殊的布局,用于存储打包的序列数据,例如在 RNN 操作中。
在 PyTorch 中,你可以通过
torch.Tensor.layout属性查看张量的布局,但这个属性是只读的。如果你需要改变张量的布局,可以使用torch.Tensor.contiguous()方法将张量转换为连续的 Strided Layout,或者使用torch.Tensor.view()方法在不改变数据的情况下重新排列张量的形状。请注意,改变张量的布局可能会影响性能,因此在设计深度学习模型时,了解和选择合适的布局是很重要的。
4.5 索引,切片,联接,操作变更
torch.cat(tensors, dim=0, out=None) → Tensor
用于将多个张量(tensors)沿着指定的维度连接起来
import torch
# 创建两个形状为2x3的张量
tensor1 = torch.randn(2, 3)
tensor2 = torch.randn(2, 3)
# 沿着第一个维度(dim=0)连接它们,结果形状为4x3
result = torch.cat((tensor1, tensor2), dim=0)多维连接
torch.cat 也可以用于多维张量的连接,只要除了连接的维度外,其他维度的形状必须相同。
# 创建两个形状为2x3x4的张量
tensor3 = torch.randn(2, 3, 4)
tensor4 = torch.randn(2, 3, 4)
# 沿着第二个维度(dim=1)连接它们,结果形状为2x6x4
result = torch.cat((tensor3, tensor4), dim=1)注意事项:
- 所有输入张量的数据类型必须相同。
- 如果输入张量中有任何张量需要梯度,那么输出张量也会需要梯度。
torch.cat返回的张量是连续的(contiguous),这意味着它在内存中是连续存储的。
与 torch.stack 的区别:
torch.cat是在指定维度上进行连接,而torch.stack是在新的维度上堆叠张量,这会增加结果张量的维度
torch.chunk(input, chunks, dim=0) → List of Tensors
用于将一个张量(tensor)分割成指定数量的块(chunks)
- 参数:
input:要分割的张量。chunks:一个整数,表示要将张量分割成多少块。dim:指定沿着哪个维度进行分割,默认为0。
- 使用示例:
import torch
# 创建一个形状为6的一维张量
tensor = torch.arange(6)
# 沿着维度0(默认维度)将张量分割成3块,每块包含2个元素
chunks = torch.chunk(tensor, chunks=3, dim=0)
for i, chunk in enumerate(chunks):
print(f"Chunk {i}: {chunk}")3.多维张量分割: torch.chunk 也可以用于多维张量的分割,只要指定的维度可以被块的数量整除。
# 创建一个形状为2x6的二维张量
tensor2d = torch.arange(12).reshape(2, 6)
# 沿着维度1将张量分割成3块,每块包含2列
chunks = torch.chunk(tensor2d, chunks=3, dim=1)
for i, chunk in enumerate(chunks):
print(f"Chunk {i}: {chunk}")4.注意事项:
- 张量在指定维度的大小必须能够被
chunks参数整除,否则会抛出错误。 - 返回的块是原始张量的视图,如果原始张量是可变的,那么对块的修改也会影响原始张量。
- 如果你只需要分割张量的一小部分,可以使用列表推导式或循环来选择特定的块。
5.返回值: torch.chunk 返回一个元组,其中包含了分割后的张量块。每个块都是原始张量的子集。
五、TensorBoard可视化的使用
5.1TensorBoard的安装
在自己的pytorch环境下安装
Pythonpip install tensorboardSuccessfully installed absl-py-2.1.0 grpcio-1.66.1 markdown-3.7 protobuf-5.28.2 tensorboard-2.17.1 tensorboard-data-server-0.7.2 werkzeug-3.0.4
TensorBoard 是一组用于数据可视化的工具。它包含在流行的开源机器学习库 Tensorflow 中。TensorBoard 的主要功能包括:
- 可视化模型的网络架构
- 跟踪模型指标,如损失和准确性等
- 检查机器学习工作流程中权重、偏差和其他组件的直方图
- 显示非表格数据,包括图像、文本和音频
- 将高维嵌入投影到低维空间
TensorBoard算是包含在 TensorFlow中的一个子服务。TensorFlow 库是一个专门为机器学习应用程序设计的开源库。Google Brain 于 2011 年构建了较早的 DistBelief 系统。随着其用户群的快速增长,它被简化并重构为我们现在称为 Tensorflow 的库。TensorFlow 随后于 2015 年向公众发布。TensorBoard刚出现时只能用于检查TensorFlow的指标和TensorFlow模型的可视化,但是后来经过多方的努力其他深度学习框架也可以使用TensorBoard的功能,例如Pytorch已经抛弃了自家的visdom(听到过这个名字的人应该都不多了吧)而全面支持TensorBoard。
5.2 opencv的安装
在自己的pytorch环境下安装
Pythonpip install opencv-pythonSuccessfully installed opencv-python-4.10.0.84
5.3基本使用
SummaryWriter:
这个用来创建一个log文件,TensorBoard面板查看时,也是需要选择查看那个log文件。
| args | 解释 |
|---|---|
| log_dir (str) | 日志保存地址,默认保存在runs/‘当前时间_主机名’;建议用'runs/exp1', 'runs/exp2', etc.来保存 |
| comment (str) | 注释;默认跟在log_dir参数后面,不选;只在log_dir报错时,提供信息 |
| max_queue (int) | 等待事件队列的大小其中一个“add”调用强制刷新磁盘之前的摘要。<br/>默认是10项。 |
| flush_secs (int) | 以秒为单位多久刷新,挂起事件和摘要到磁盘。默认是每两分钟一次。 |
| filename_suffix (str) | 所有事件文件名添加后缀log_dir目录。. 有关文件名构造的更多细节,请参见tensorboard.summary.writer.event_file_writer.EventFileWriter。 |
#例子:
from torch.utils.tensorboard import SummaryWriter
writer = SummaryWriter("run/exp1")
# 会创建文件名称:run/exp1add_something:
向log文件里面增添数据。例如可以通过add_scalar增添折线图数据,add_image可以增添图片。
add_something指的是添加__xxx
#1.
def add_scalar(
self,
tag,
scalar_value,
global_step=None,
walltime=None,(可选)
new_style=False,(可选)
double_precision=False,(可选)
):
Args:
tag (str): 图像名称
scalar_value (float or string/blobname): y轴
global_step (int):x轴
walltime (float):可选覆盖默认的walltime (time.time()),事件发生后的几秒钟
new_style (boolean): 是使用新样式(张量字段)还是旧样式
style (simple_value field). 是使用新样式(张量字段)还是旧样式
Examples::
#创建100个数。循环遍历,图像名称为y=2x,x轴位2*i,y轴位i
from torch.utils.tensorboard import SummaryWriter
writer = SummaryWriter()
x = range(100)
for i in x:
writer.add_scalar('y=2x', i * 2, i)
writer.close()
Expected result:
#结果:
.. image:: _static/img/tensorboard/add_scalar.png
:scale: 50 %
"""#2.
def add_image(
# 注意默认图片的格式为CHW,而输入图片格式
self, tag, img_tensor, global_step=None, walltime=None, dataformats="CHW"
):
#注意,这需要``pillow``包。
Args:
tag (str): 图像名称
img_tensor (torch.Tensor, numpy.ndarray, or string/blobname): 图片数据类型
global_step (int): 结果步长,也是y轴
walltime (float):
dataformats (str): 图片格式的排布形状,C代表维度,H代表高度,W代表宽度。有 CHW, HWC, HW, WH, etc.
Examples::
from torch.utils.tensorboard import SummaryWriter
import numpy as np
img = np.zeros((3, 100, 100))
img[0] = np.arange(0, 10000).reshape(100, 100) / 10000
img[1] = 1 - np.arange(0, 10000).reshape(100, 100) / 10000
img_HWC = np.zeros((100, 100, 3))
img_HWC[:, :, 0] = np.arange(0, 10000).reshape(100, 100) / 10000
img_HWC[:, :, 1] = 1 - np.arange(0, 10000).reshape(100, 100) / 10000
writer = SummaryWriter()
writer.add_image('my_image', img, 0)
# If you have non-default dimension setting, set the dataformats argument.
writer.add_image('my_image_HWC', img_HWC, 0, dataformats='HWC')
writer.close()
Expected result:
.. image:: _static/img/tensorboard/add_image.png
:scale: 50 %
"""close
当训练结束后,我们可以通过close方法结束log写入。
在train结束之后要记得write.close()
标准使用例子:
#1.
#导入tensorboard 中SummaryWrite包
from torch.utils.tensorboard import SummaryWriter
#等价于 import torch.utils.tensorboard.SummaryWriter
#2.创建SummaryWrite实体,设置日志文件夹为run/exp1
writer = SummaryWriter("runs/exp1")
#3.导入数据例子
for i in range(100):
writer.add_scalar("y=2x",2*i,i)
#关闭文件流
writer.close()PS:程序运行完成后,不会自动跳入tensorboard运行网站,需要输入命令
在对应文件终端输入:tensorboard --logdir=runs/exp1
默认端口为6006
修改端口:tensorboard --logdir=runs/exp1 --port=xxx
#2.
#导入tensorboard 中SummaryWrite包
from torch.utils.tensorboard import SummaryWriter
#由于add_image函数中图片格式只能为tensor,array类型etc.所以要转换类型
import numpy as np
from PIL import Image
#创建SummaryWrite实体,日志文件夹为run/exp1
writer = SummaryWriter("runs/exp1")
#导入图片路径(一般复制根路径),并转换图片格式为array类型
image_path = "data/train/ants/0013035.jpg"
img_PIL = Image.open(image_path)
img_array = np.array(img_PIL)
# Create a SummaryWriter instance
writer = SummaryWriter("runs/exp1")
# 注意add_image参数中默认图片shape格式为(维度C,高度H,宽度W)
writer.add_image("Ant Image", img_array, 1 , dataformats="HWC")
writer.close()
5.4 补充知识
5.4.1 安装opencv
注意:在自己的pytorch环境安装
pip install opencv-python5.4.1 Python的_call_ 方法
在 Python 中,_call_ 是一个特殊方法(也称为魔术方法或双下划线方法),用于使对象可以像函数一样被调用。当你在一个对象上调用 obj() 时,Python 解释器会查找该对象的_call_ 方法并调用它.
其实就是不需要用”.函数名“这样的方式去调用的,可以直接使用”对象名(参数)“这样的方法去调用
而非双划线的方法,是需要对象名.函数名(参数)的形式调用的
六、transforms的使用
前言:
首先要知道transforms这个类是干什么的?
transforms是torchvision中一个模块,这个模块定义了很多图像处理的类,比如:
TEXT数据中心化 数据标准化 缩放 裁剪 旋转 翻转 填充 噪声添加 灰度变换 线性变换 仿射变换 亮度、饱和度以及对比度变换等。变换是常见的图像变换,其可以适应连接在一起的Compose, 此外,还有torchvision.transforms.functionaltorchvision.transforms.functional模块,功能转换可以对转换进行细粒度控制,如果您必须构建更复杂的转换管道(例如,在分段任务情况下),这将非常有用类。
Pythontorchvision.transforms.Compose(transforms)
- transforms: (Transformes对象列表)要组成的变换列表。
Pythontransforms.Compose([ transforms.CenterCrop(10), transforms.ToTensor(), ])其次:是如何使用transforms这个模块
Python#导入的包名 from torchvision import transforms1.实例化transforms
Pythontool = transforms.tool()#tool指的是模块中具体的方法类2.转换方法;在创建好具体的方法类之后,就要把预处理的数据进行转换
Pythonresult = tool(InputData)
常见的图像变换
官方文档只将该方法陈列,没有归纳总结,顺序很乱,这里总结一共有四大类,方便大家索引。
- 裁剪(Crop):—中心裁剪:
- transforms.CenterCrop:中心裁剪
- transforms.RandomCrop:随机裁剪
- transforms.RandomResizedCrop:随机长宽比裁剪
- transforms.FiveCrop:上下左右中心裁剪
- transforms.TenCrop:上下左右中心裁剪后翻转
- 翻转和旋转——
- transforms.RandomHorizontalFlip(p=0.5):依概率p pp水平翻转
- transforms.RandomVerticalFlip(p=0.5):依概率p垂直翻转
- transforms.RandomRotation:随机旋转。
- 图像变换(resize)
- transforms.Resize : 图像变换(resize)
- transforms.Normalize:标准化
- transforms.ToTensor: 转为tensor,并归一化为[0-1]
- transforms.Pad :。填充
- transforms.ColorJitter:修改亮度、对比度和饱和度
- transforms.Grayscale:转灰度图
- transforms.LinearTransformation():线性变换
- transforms.RandomAffine:放射变换
- transforms.RandomGrayscale:依概率p pp转为灰度图
- transforms.ToPILImage:将数据转换为PILImage
- transforms.Lambda:Apply a user-defined lambda as a transform
- 对transforms操作,使数据增强更灵活,transforms.RandomChoice(transforms),从给定一系列的transform中选一个进行操作,transforms.RandomApply(transforms, p=0.5), 给一个transform加上概率,依概率进行操作:transforms.RandomOrder。将transform中的操作进行随机打乱。
6.1 图像变换(resize)
6.1.1 ToTensor
将PIL图像或NumPy ndarray 转换为PyTorch张量,并将像素值从[0, 255]缩放到[0.0, 1.0]。并且归一化至[ 0 − 1 ] , 注意事项:归一化至[0-1]是直接除以255,若自己的ndarray数据尺度有变化,则需要自行修改。
只支持输入以下两类的数据:
- PIL类型的图像数据
- numpy.ndarray类型的图像数据
而且会将shape由HWC转换成CHW
from PIL import Image
from torch.utils.tensorboard import SummaryWriter
from torchvision import transforms
#数据的导入
img_path="data/train/ants/0013035.jpg"
img = Image.open(img_path)
#tensorboard文件日志的写入
writer = SummaryWriter('runs/exp1')
print(type(img))
#totensor的使用,先创建实例
tersor = transforms.ToTensor()
#再进行转换
tensor_image =tersor(img)
print(type(tensor_image))
#tensorboard写入
writer.add_image("Ant Image", tensor_image, 1 , dataformats="CHW")
print(tensor_image.shape)
writer.close()
6.1.2 ToPILImage()
ToPILImage()作用: 将PyTorch张量转换回PIL图像
#ToPILImage的使用:首先还是先创建实例
Tensor_to_PIL = transforms.ToPILImage()
#在把数据导入进行转换
img_PIL = Tensor_to_PIL(tensor_image)
print(img_PIL)
img_PIL.show()总结:
1.PIL、narrays格式的数据通过ToTensor()来转换成张量(理解成特殊矩阵)
2.利用ToPILImage()函数把张量转换成PIL图像
3.PIL数据通过Image库中的open()函数来打开,即Image.open()
4.tensor数据,即张量,通过Tosensor()来打开
5.narrays数据,通过cv.imread()函数打开,需要import cv库函数
6.1.3 Normalize()
transforms.Normalize()函数接受两个参数:mean和std,分别表示数据集的均值和标准差。函数会对输入数据进行以下操作: $normalized_image=\frac{image-mean}{std}$ (1)
如公式1所示,通过减去均值并除以标准差,我们可以将图像数据的分布转换为标准正态分布(均值为0,标准差为1)。这样,模型在训练过程中就可以更容易地学习到数据的特征。
import cv2
from torch.utils.tensorboard import SummaryWriter
from torchvision import transforms
writer = SummaryWriter("runs/exp1")
img = cv2.imread("data/train/ants/0013035.jpg")
img = cv2.cvtColor(img, cv2.COLOR_BGR2RGB) # cv2读入图像为BGR,转换成RGB
# transforms使用
trans_tensor = transforms.ToTensor() # ToTensor类,实例化一个ToTensor工具
tensor_img = trans_tensor(img)
trans_norm = transforms.Normalize([0.5, 0.5, 0.5], [0.5, 0.5, 0.5]) # 归一化
norm_img = trans_norm(tensor_img)
writer.add_image("ants_img", norm_img, 2)
writer.close()
这里的mean和std参数是根据ImageNet数据集的统计信息设置的。
6.1.4 Resize()
transforms.Resize():将输入图像的大小调整为给定的大小(高宽),参数值可以是序列 如(512, 512)或 int(512),图像可以是PIL图像或torch张量,shape格式为[…, H, W]
import cv2
from torch.utils.tensorboard import SummaryWriter
from torchvision import transforms
writer = SummaryWriter("logs")
img = cv2.imread("./data/train/ants/0013035.jpg")
img = cv2.cvtColor(img, cv2.COLOR_BGR2RGB) # cv2读入图像为BGR,转换成RGB
# transforms使用
trans_tensor = transforms.ToTensor() # ToTensor类,实例化一个ToTensor工具
tensor_img = trans_tensor(img)
trans_norm = transforms.Normalize([0.5, 0.5, 0.5], [0.5, 0.5, 0.5]) # 归一化
norm_img = trans_norm(tensor_img)
print(norm_img.shape)
trans_resize = transforms.Resize((512, 512)) # 改变尺寸为(512, 512)
resize_img = trans_resize(norm_img)
print(resize_img.shape)
writer.add_image("ants_img", resize_img, 3)
writer.close()
6.1.5 Compose
Compose就是把多个变换对象组合在一起
参数:一个list数组,数组里是多个’Transform’对象,即[transforms, transforms…]。 所在环境路径:/opt/conda/lib/python3.6/site-packages/torchvision/transforms/transforms.py 操作:如下所示,遍历list数组,对img依次执行每个transforms操作,并返回transforms后的img。
#创建一个Compose对象,里面的包含许多transforms对象操作,最后会返回一个结果
transform1 = transforms.Compose(#注意用list数组把操作框起来
[
transforms.ToTensor(),
transforms.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5))])Compose中调用的transform函数先后顺序,一定要跟数据类型一一对应
6.1.6 RandomCrop()
随即裁剪:
def init(self, size, padding=None, pad_if_needed=False, fill=0, padding_mode="constant")
size : (h,w) 类型:依照 长、宽裁剪; int 类型:方形裁剪(int,int) padding: 边框填充,如果提供了单个int,则用于填充所有边框。如果提供了长度为2的序列,则这是填充分别位于左侧/右侧和顶部/底部。如果提供长度为4的序列,这是分别用于左、上、右和下边框的填充。
RandomCrop需要输入一个格式为PIL类型的图像
from PIL import Image
from torch.utils.tensorboard import SummaryWriter
from torchvision import transforms
#传入数据
img = Image.open("data/train/ants/0013035.jpg")
print(type(img))#是PIL类型
writer = SummaryWriter('runs/exp1')
# 裁剪成100*10的图像
tran_crop = transforms.RandomCrop(100,10)
# 创建转换成tensor张量的方法
transforms_totensor = transforms.ToTensor()
#使用Compose方法来组合使用transforms对象
trans_compose2 = transforms.Compose([tran_crop,transforms_totensor])
# 随机裁剪10次
for i in range(10):
#数据传入
img_crop =trans_compose2(img)
writer.add_image('images',img_crop,i)
writer.close()
七、DataLoader的使用
使用CIFAR10数据集来讲解Dataloader的使用方法,并写入tensorboard中,可以更好的去查看。这是官方提供的数据集。
为什么学习Dataloader?
在pytorch中如何读取数据主要有两个类,分别是Dataset和Dataloader。 dataset可以理解为:提供一种方式去获取数据及其label(标签)。可以实现
(1)如何获取每一个数据及其label;
(2)总共有多少数据。这两个功能。
dataloader可以理解为:为后面的网络提供不同的数据形式。相比较dataset,dataloader更难一点,DataLoader直接与后面的神经网络有关,所以要重点学习。
7.1 DataLoader类的官方解释
DataLoader(
dataset,
batch_size=1,
shuffle=False,
sampler=None,
batch_sampler=None,
num_workers=0,
collate_fn=None,
pin_memory=False,
drop_last=False,
timeout=0,
worker_init_fn=None,
multiprocessing_context=None,
generator=None,
*,
prefetch_factor=2,
persistent_workers=False
)torch.utils.data.DataLoader(dataset, batch_size=1, shuffle=False, sampler=None, batch_sampler=None, num_workers=0, collate_fn=None, pin_memory=False, drop_last=False, timeout=0, worker_init_fn=None, multiprocessing_context=None)详细注释:
dataset (Dataset) – 从中加载数据的数据集。 batch_size (int, optional) – 每批要加载多少个样本(默认值:1)。 shuffle (bool, optional) – 设置为 True 让数据在每个 epoch 重新洗牌(默认值:False)。 sampler(Sampler 或 Iterable,可选)——定义从数据集中抽取样本的策略。可以是任何实现了 len 的 Iterable。如果指定,则不得指定 shuffle。 batch_sampler(Sampler 或 Iterable,可选)- 类似于 sampler,但一次返回一批索引。与 batch_size、shuffle、sampler 和 drop_last 互斥。 num_workers (int, optional) – 用于数据加载的子进程数。 0 表示数据将在主进程中加载。 (默认值:0) collate_fn(可调用,可选)——合并样本列表以形成小批量张量。从地图样式数据集中使用批量加载时使用。 pin_memory (bool, optional) – 如果为 True,数据加载器将在返回之前将张量复制到 CUDA 固定内存中。如果您的数据元素是自定义类型,或者您的 collate_fn 返回一个自定义类型的批次,请参见下面的示例。 drop_last (bool, optional) – 如果数据集大小不能被批次大小整除,则设置为 True 以丢弃最后一个不完整的批次。如果 False 并且数据集的大小不能被批大小整除,则最后一批将更小。 (默认:假) timeout (numeric, optional) -- 如果为正,则从工人那里收集批次的超时值。应始终为非负数。 (默认值:0) worker_init_fn (callable, optional) – 如果不是None,这将在播种之后和数据加载之前以worker id([0,num_workers - 1]中的一个int)作为输入在每个worker子进程上调用。 (默认:无)
7.1.1如何导入并使用CIFAR10数据集
CIFR10参数
root: Union[str, Path],#即CIFR10存放的地址或下载的地址 train: bool = True,#是否为训练数据,反正为测试数据 transform: Optional[Callable] = None,#可选 target_transform: Optional[Callable] = None,#可选 download: bool = False,#是否要下载CIFR10数据,对应root参数
import torchvision
train_set=torchvision.dataset.CIFAR10(root="./dataTest",train=True,download=True)7.1.2 如何使用Dataset
import torchvision
from torchvision import transforms
from torch.utils.tensorboard import SummaryWriter
writer = SummaryWriter("logs") # 日志文件存储位置
dataset_transform = transforms.Compose([
transforms.ToTensor()
])
train_set = torchvision.datasets.CIFAR10(root="./dataset", train=True,transform=dataset_transform, download=True)
test_set = torchvision.datasets.CIFAR10(root="./dataset", train=False,transform=dataset_transform, download=True)
print(test_set[0])
img, target = test_set[0] # target对应类的编号 对应cat
print(img)
print(target)
print(test_set.classes[target])
for i in range(10):
img, target = test_set[i]
writer.add_image("torchvision",img,i)
writer.close()7.1.3 如何使用DataLoader
from torch.utils.data import DataLoader
test_loader = DataLoader(dataset=train_set,batch_size=128,shuffle=True,num_workers=0,drop_last=False)
'''
注释:
dataset=test_data, 从test_data中加载数据
batch_size=128, 一次加载128个样本
shuffle=True, true表示 在每一次循环中都变化,随机取样
num_workers=0, 在主程序进行
drop_last=False 保留最后一个不完整的批次,为True删除最后不完整的批次
'''7.1.4利用tensorboard查看其Dataloader结果(完整代码)
import torchvision.datasets
from torch.utils.data import DataLoader
from torch.utils.tensorboard import SummaryWriter
from torchvision import transforms
dataset_transform = transforms.Compose([
transforms.ToTensor() # 转化为Tensor
])
test_set = torchvision.datasets.CIFAR10("./dataset", train=False, transform=dataset_transform, download=True)
test_loader = DataLoader(dataset=test_set, batch_size=64, shuffle=True, num_workers=0, drop_last=False)
imgs, targets = test_set[0] # 获取CIFAR10中下标为0数据
print(imgs.shape)
print(targets)
writer = SummaryWriter("logs")
step = 0
for data in test_loader:
imgs, targets = data
writer.add_images("训练模型", imgs, step)
step = step + 1
writer.close()
7.1.5 Dataset和Dataloader的区别:
https://blog.csdn.net/hxhabcd123/article/details/132953769
Dataset定义了数据集的内容,它相当于一个类似列表的数据结构,具有确定的长度,能够用索引获取数据集中的元素。
DataLoader定义了按batch加载数据集的方法,它是一个实现了**iter方法的可迭代对象,**每次迭代输出一个batch的数据。 DataLoader能够控制batch的大小,batch中元素的采样方法,以及将batch结果整理成模型所需输入形式的方法(collate_fn),并且能够使用多进程读取数据。
在绝大部分情况下,用户只需实现Dataset的__len__方法和__getitem__方法,就可以轻松构建自己的数据集,并用默认数据管道进行加载。
分工上的不同
1. 获取一个batch数据的步骤
让我们考虑一下从一个数据集中获取一个batch的数据需要哪些步骤。 (假定数据集的特征和标签分别表示为张量X和Y,数据集可以表示为(X,Y), 假定batch大小为m) 1,首先我们要确定数据集的长度n。
结果类似:n = 1000。 2,然后我们从0到n-1的范围中抽样出m个数(batch大小)。
假定m=4, 拿到的结果是一个列表,类似:indices = [1,4,8,9]
3,接着我们从数据集中去取这m个数对应下标的元素。
拿到的结果是一个元组列表,类似:samples = [(X[1],Y[1]),(X[4],Y[4]),(X[8],Y[8]),(X[9],Y[9])]
4,最后我们将结果整理成两个张量作为输出。
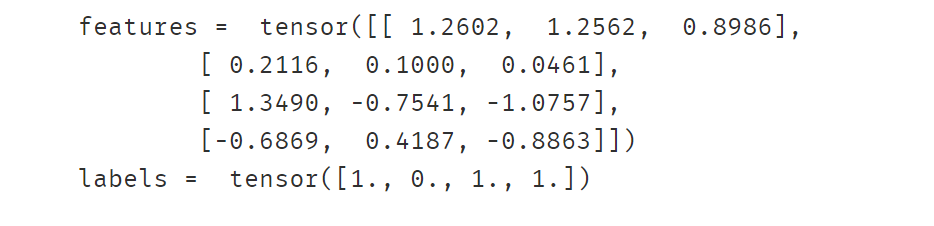
拿到的结果是两个张量,类似batch = (features,labels)
其中 features = torch.stack([X[1],X[4],X[8],X[9]])
labels = torch.stack([Y[1],Y[4],Y[8],Y[9]])
上述第1个步骤确定数据集的长度是由 Dataset_len_ 方法实现的。 第2个步骤从0到n-1的范围中抽样出m个数的方法是由DataLoader 的 sampler 和 batch_sampler参数指定的。 sampler参数指定单个元素抽样方法,一般无需用户设置,程序默认在DataLoader的参数shuffle=True时采用随机抽样,shuffle=False时采用顺序抽样。 batch_sampler参数将多个抽样的元素整理成一个列表,一般无需用户设置,默认方法在DataLoader的参数drop_last=True时会丢弃数据集最后一个长度不能被batch大小整除的批次,在drop_last=False时保留最后一个批次。 第3个步骤的核心逻辑根据下标取数据集中的元素 是由 Dataset的 getitem方法实现的。 第4个步骤的逻辑由DataLoader的参数collate_fn指定。一般情况下也无需用户设置。
import torch
from torch.utils.data import TensorDataset,Dataset,DataLoader
from torch.utils.data import RandomSampler,BatchSampler
ds = TensorDataset(torch.randn(1000,3),
torch.randint(low=0,high=2,size=(1000,)).float())
dl = DataLoader(ds,batch_size=4,drop_last = False)
features,labels = next(iter(dl))
print("features = ",features )
print("labels = ",labels )
Dataset类的使用