
一、JVM简史
JVM是什么?
JVM(Java Virtual Machine,Java虚拟机)是Java程序能够在不同平台上运行的关键,它将Java字节码转化为特定平台的机器码。转换的时候,可以做一些压缩或者优化,通过 JIT(just in time 即时编译) 来完成,这样的程序跑起来就快多了。JVM为Java提供了平台无关性,使得Java能够一次编译,处处运行。同时用于执行Java字节码并提供运行时环境。它不仅仅是一个运行Java程序的环境,还负责内存管理、垃圾回收、线程管理等任务。
总结JVM的功能:
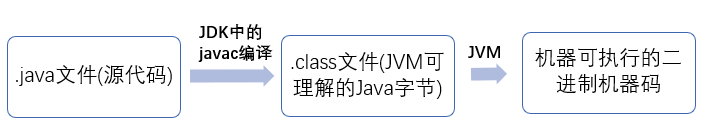
①java源代码被JDK编译成.class文件,再被JVM转换(运行)成任何机器上均可执行的机器码(直译器)(平台无关性)
即跨平台运行和字节码抽象(Write Once ,Run Anywhere )。
PS:JVM会根据不同的平台而不同.例如,提供java Native interface(JNI),允许Java代码调用其他语言(C++)
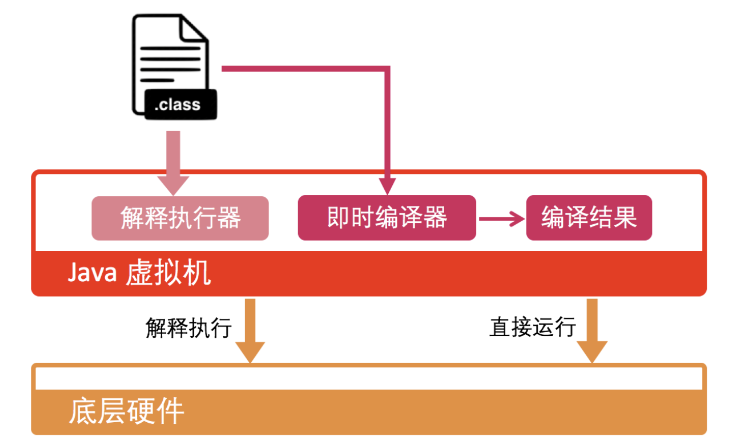
②直译器翻译的机器码肯定不如编译器的效果好,那就在转换的时候,做一些压缩和优化(加个编译器呗),通过JIT完成。这样程序也就快多了。(即时编译(JIT))
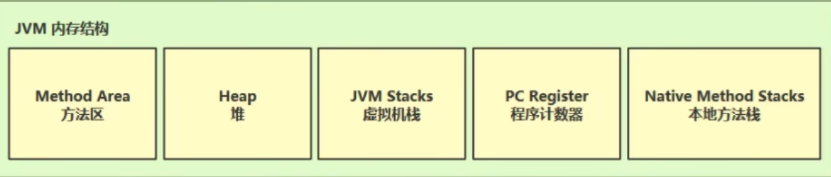
③在编译过程中,需要速度快,可能需要读取速度快等效果,那么就有内存,内存怎么管理呢?(内存管理),即
- 堆内存分配:管理对象实例的堆内存分配与回收。
- 垃圾回收(GC):自动回收不再使用的对象内存,避免内存泄漏。
- 内存隔离:划分方法区、堆、栈等不同内存区域,保障线程安全。
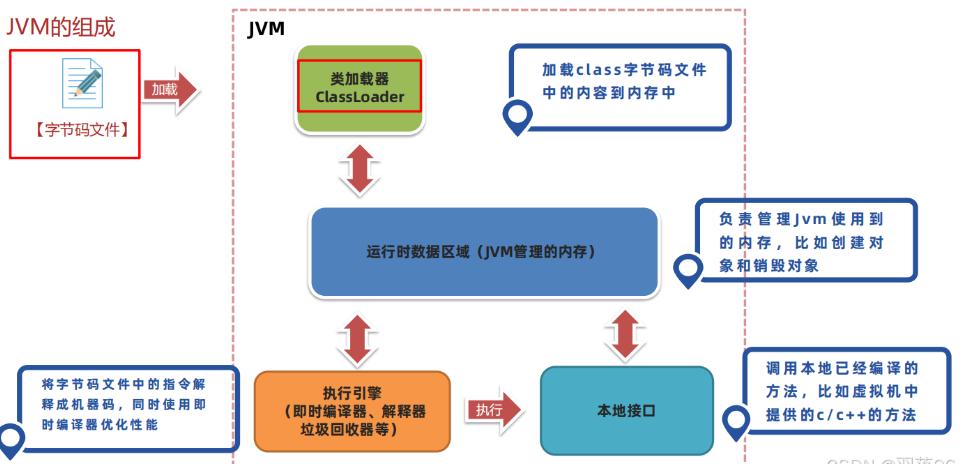
JVM的组成:
(这个相当于大纲,是整个JVM这本书的关键)
即黑盒:JVM的输入和输出是什么?
白盒:JVM内部大致分为类加载器,运行时内存,执行引擎,本地接口(JNI),这些的输入输出是什么,相互之间的关系是什么?
总结要学习的:
字节码文件,JVM中的类加载器,JVM的运行内存(内存结构,怎么管理内存),执行引擎(怎么优化和压缩的),本地接口(JNI)
常见JVM类型
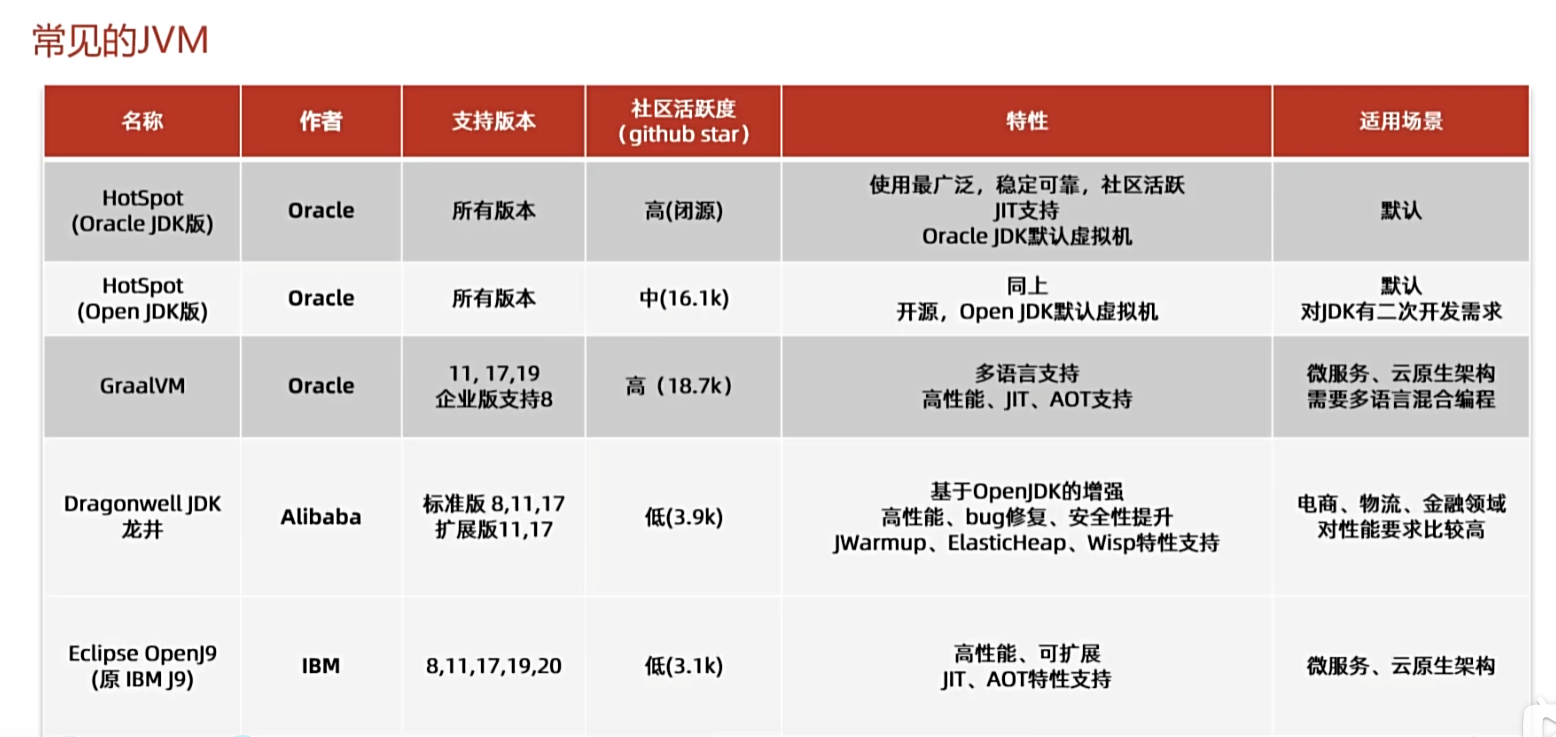
在jVM这个课程中的学习目录是什么呢?
看完这些,就知道了,java源码->class文件,这个过程中怎么做的?class文件有哪些特点?
class文件->JVM中,JVM干了什么?即JVM的结构是什么样的?
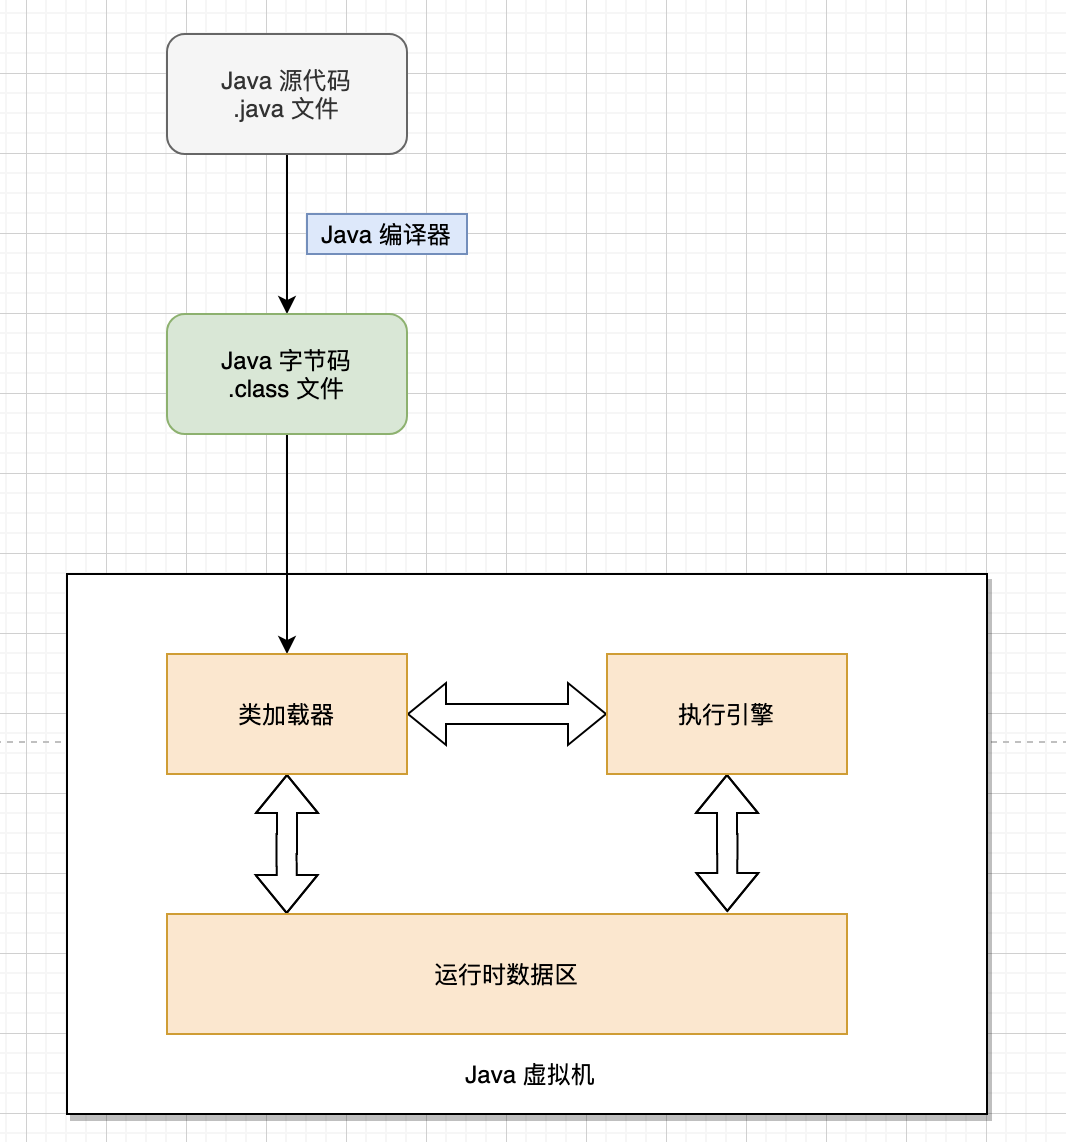
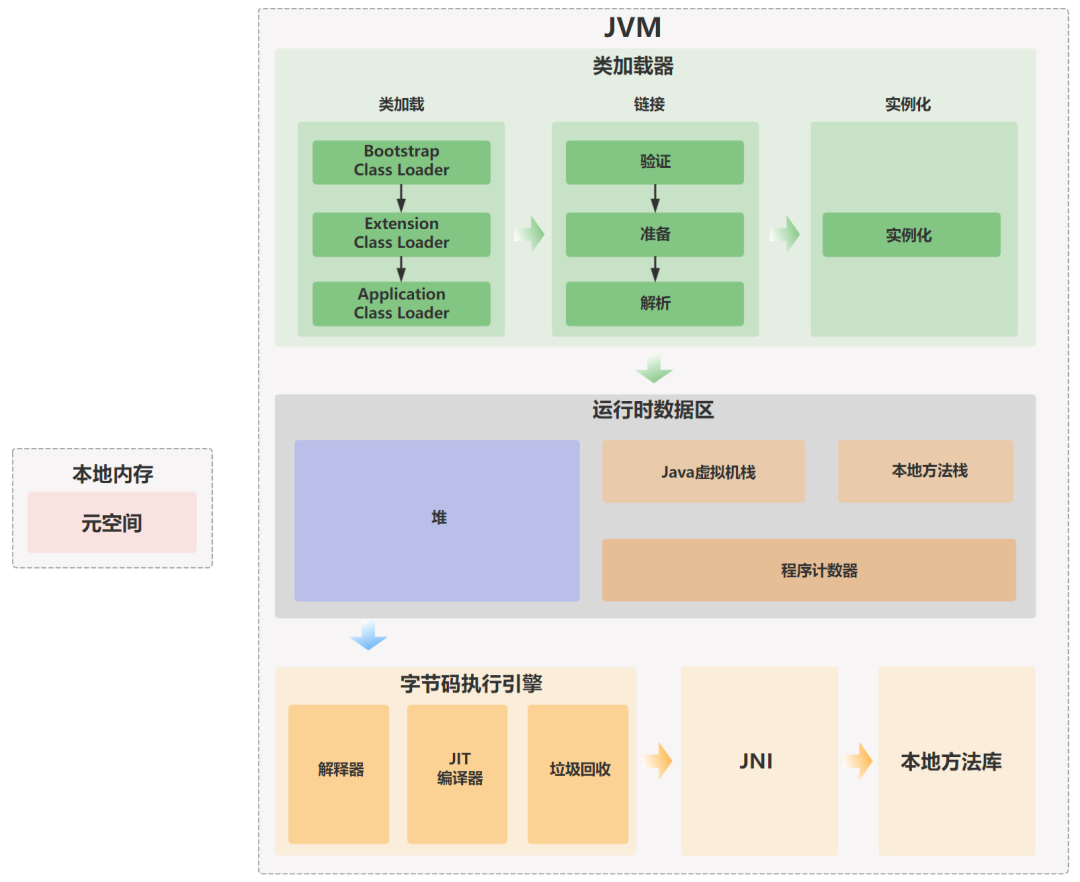
二、class文件:
(JVM的输入是class文件)
在.java->.calss这步后,得到.class字节码文件,其中该字节码文件的格式,规范是什么呢?(本质是16进制文件)
类文件的内容通常可以分为下面这几部分,见下图。
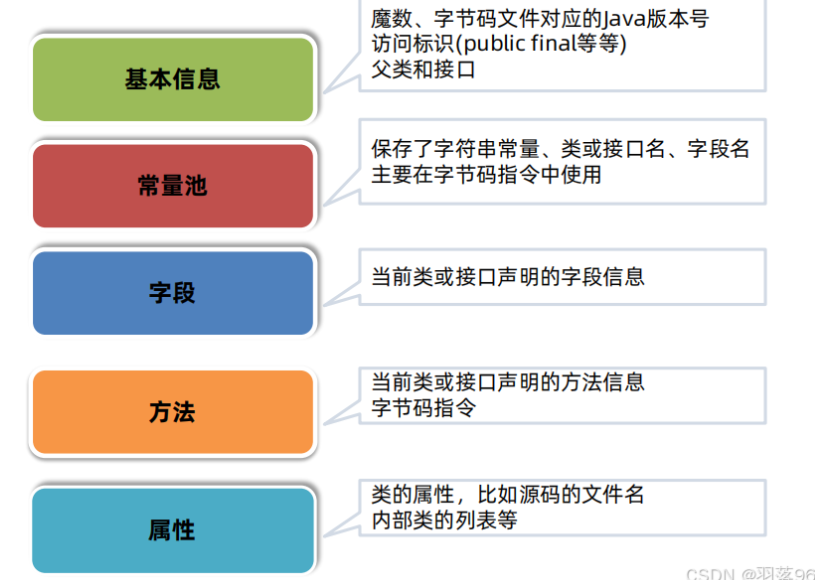
1、基本信息(包含魔数和对应版本号)
在字节码第一行会有一串特殊的字符 cafebabe(java图标就是coffee),它就是一个魔数,是 JVM 识别 class 文件的标志,JVM 会在验证阶段检查 class 文件是否以该魔数开头,如果不是则会抛出 ClassFormatError。
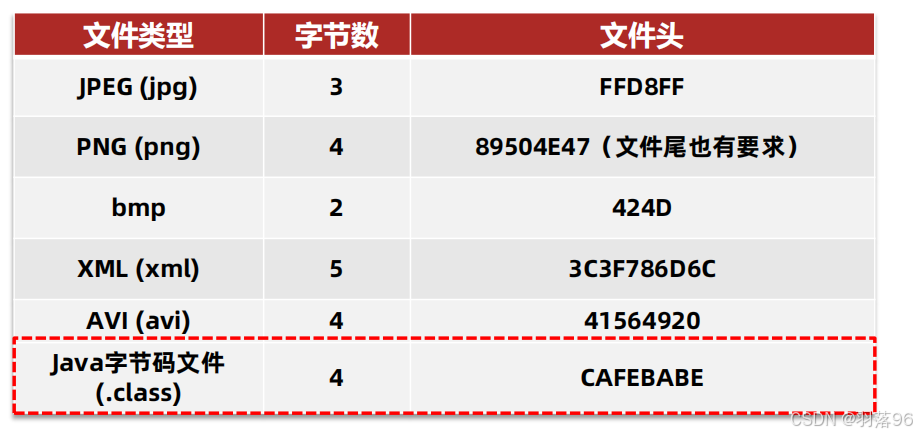
对应版本号接在magic后面,为四个字节,如 **0000 0037** 分别表示副版本号和主版本号,0000代表副版本为0,0037=55,代表java11。Java的主版本号从 **45**(JDK 1.0)开始,每个新的大版本递增1
2、常量池:
紧跟在版本号之后的是常量池,它包含了类、接口、字段和方法的符号引用,以及字符串字面量和数值常量。这些信息在编译时被创建,并在运行时被Java虚拟机(JVM)使用。相当于一个资源池
字面量(Literals):字面量是不变的数据,在源代码中直接赋值,编译后存储在常量池中。
符号引用(Symbolic References):符号引用是对类、接口、字段、方法等的引用,它们不是由字面量值。在类加载时被虚拟机解析为具体的内存地址。
3、字段:紧跟着常量池之后的区域就是字段(四个部分),包含
- 类或接口的访问信息。按照顺序有:访问标记(Access flags),这个标记用于识别类或接口的访问信息。
- 类索引、父类索引和接口索引。这三部分用来确定类的继承关系,this_class 为当前类的索引,super_class 为父类的索引,interfaces 为接口。
- 字段表用来存储字段的信息,包括字段名,字段的参数,字段的签名。
- 方法表用来存储方法的信息,包括方法名,方法的参数,方法的签名。
**4、属性表:**属性表是 class 文件中的最后一部分,通常出现在字段和方法中。用来存储属性的信息,包括字段的初始值,方法的字节码指令等。
三、类的加载过程
知道什么是 Java 字节码后,聊聊 Java 的类加载过程
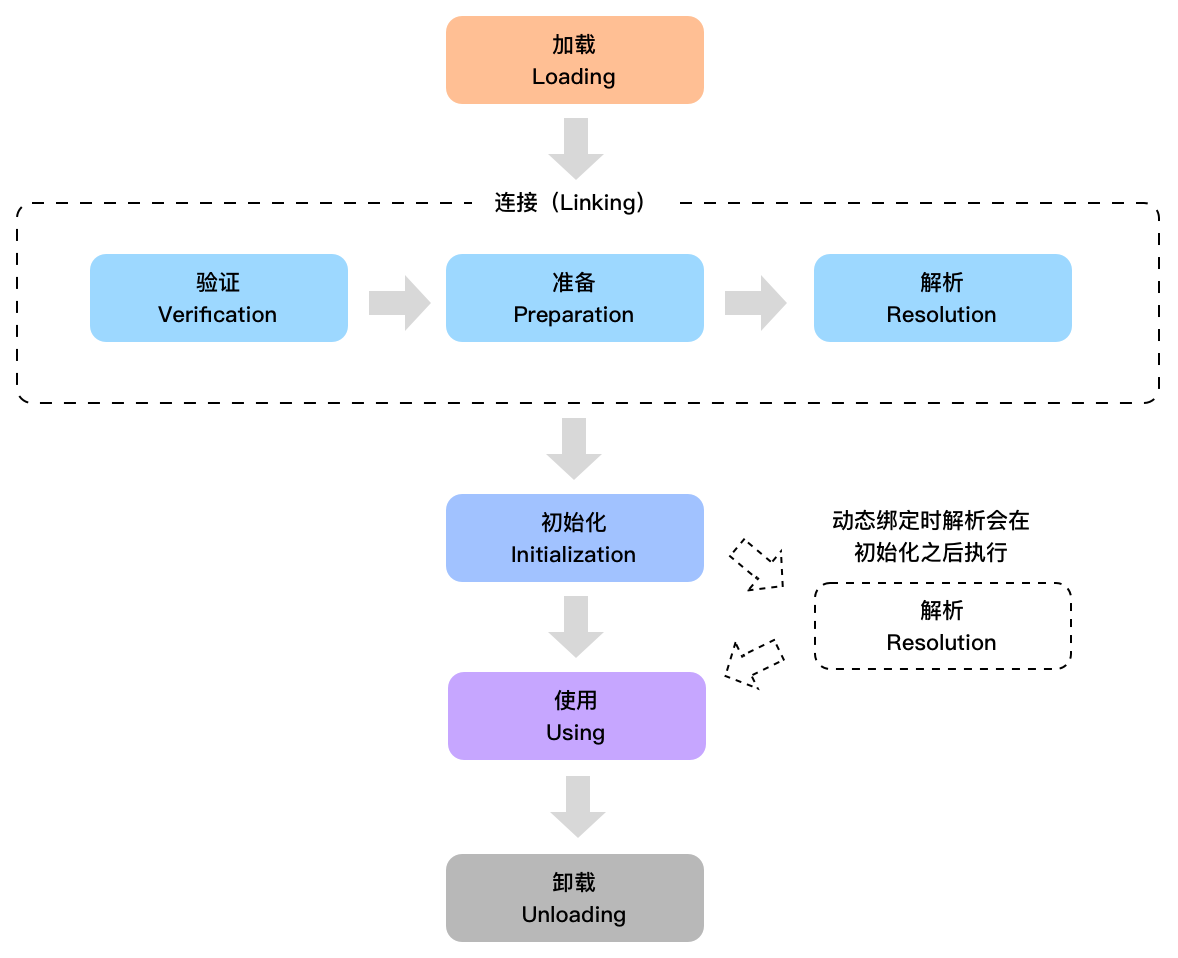
类从被加载到 JVM 开始,到卸载出内存,整个生命周期分为七个阶段,分别是加载、验证、准备、解析、初始化、使用和卸载。其中验证、准备和解析这三个阶段统称为连接。
除去使用和卸载,就是 Java 的类加载过程。这 5 个阶段一般是顺序发生的,但在动态绑定的情况下,解析阶段发生在初始化阶段之后(我们随后来解释)。
1)Loading(载入)
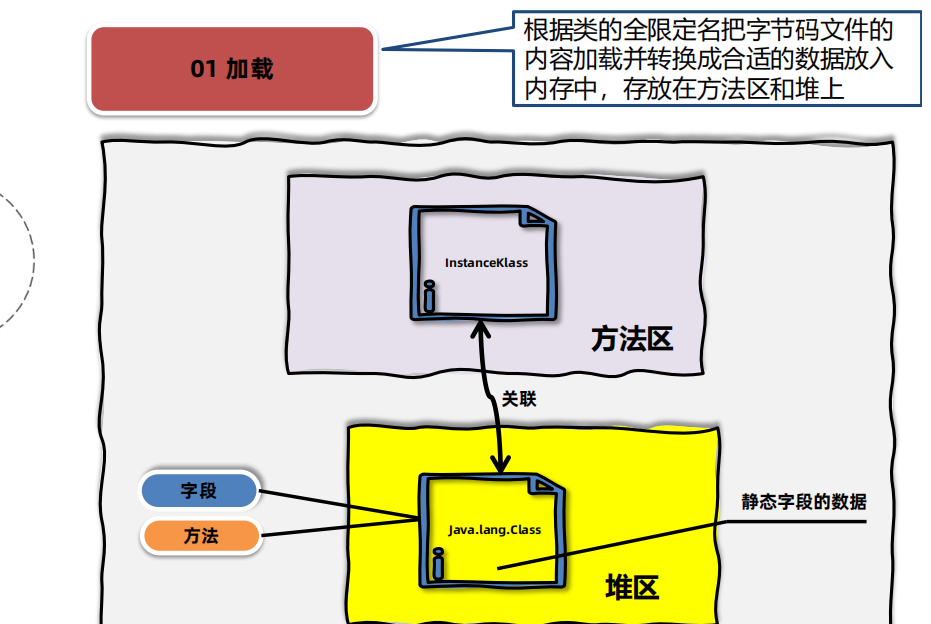
JVM 在该阶段的目的是将字节码从不同的数据源(可能是 class 文件、也可能是 jar 包,甚至网络)转化为二进制字节流加载到内存(方法区)中,并在堆生成一个代表该类的 **java.lang.Class** 对象(在学反射的时候有讲过)。
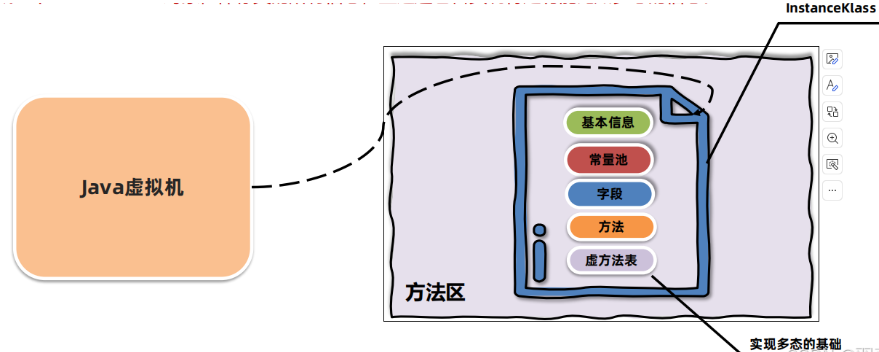
①加载到内存中,是生成一个instanceKlass对象,保存类的所有信息,里边还包含实现特定功能比如多态的信息。存在元空间(8 之前存在永久代)
②生成的java.lang.Class对象。作用是在Java代码中去获取类的信息以及存储静态字段的数据(JDK8及之后)。
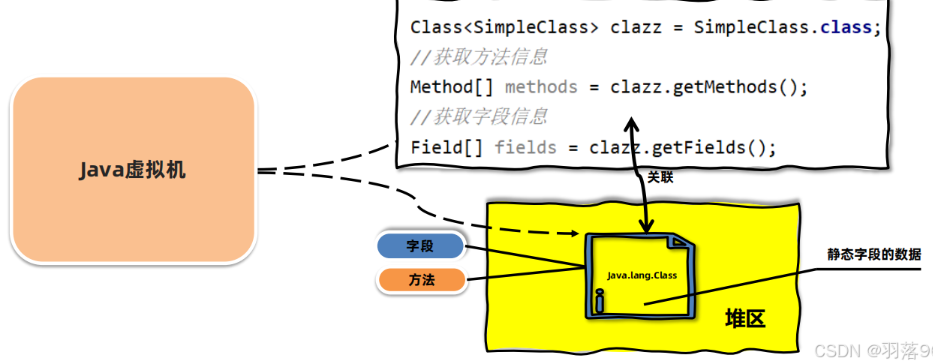
为什么分开存呢?主要是为了安全性,让开发者仅能访问堆中的Class对象,而不能访问方法区的全部信息,从而限制了数据访问范围。
2)Verification(验证)
JVM 会在该阶段对二进制字节流进行校验,只有符合 JVM 字节码规范的才能被 JVM 正确执行。该阶段是保证 JVM 安全的重要屏障,下面是一些主要的检查。
读者飞 2025 年 2 月 22 日 提供的修改建议。
- 确保二进制字节流格式符合预期(比如说是否以
cafe babe开头,前面提到过)。 - 是否所有方法都遵守访问控制关键字的限定,protected、private 那些。
- 方法调用的参数个数和类型是否正确。
- 确保变量在使用之前被正确初始化了。
- 检查变量是否被赋予恰当类型的值。
- 还有更多。
3)Preparation(准备)
JVM 会在该阶段对类变量(也称为静态变量,static 关键字修饰的)分配内存并初始化,对应数据类型的默认初始值,如 0、0L、null、false 等。
也就是说,假如有这样一段代码:
public String chenmo = "沉默"; \\无static,不分配内存
public static String wanger = "王二"; \\ 是static,分配内存,设置为初始值
public static final String cmower = "沉默王二";\\ static+final = 常量,直接赋值chenmo 不会被分配内存,而 wanger 会;但 wanger 的初始值不是“王二”而是 null。
需要注意的是,static final 修饰的变量被称作为常量,和类变量不同(这些在讲 static 关键字就讲过了)。常量一旦赋值就不会改变了,所以 cmower 在准备阶段的值为“沉默王二”而不是 null。
4)Resolution(解析)
该阶段将常量池中的符号引用转化为直接引用。
what?符号引用,直接引用?
符号引用以一组符号(任何形式的字面量,只要在使用时能够无歧义的定位到目标即可)来描述所引用的目标。
- 定义:包含了类、字段、方法、接口等多种符号的全限定名。
- 特点:在编译时生成,存储在编译后的字节码文件的常量池中。
- 独立性:不依赖于具体的内存地址,提供了更好的灵活性。
在编译时,Java 类并不知道所引用的类的实际地址,因此只能使用符号引用来代替。比如 com.Wanger 类引用了 com.Chenmo 类,编译时 Wanger 类并不知道 Chenmo 类的实际内存地址,因此只能使用符号 com.Chenmo。
直接引用通过对符号引用进行解析,找到引用的实际内存地址。我们再来对比说明一下。
- 定义:直接指向目标的指针、相对偏移量或者能间接定位到目标的句柄。
- 特点:在运行时生成,依赖于具体的内存布局。
- 效率:由于直接指向了内存地址或者偏移量,所以通过直接引用访问对象的效率较高。
通过这种方式,Java 程序能够在编译时和运行时具有更高的灵活性和解耦性,同时在运行时也能获得更好的性能。
Java 本身是一个静态语言(默认使用双亲委派),但后面又加入了动态加载特性(热部署等机制),因此我们理解解析阶段需要从这两方面来考虑。
传统静态加载(缓存机制):
- JVM 在首次加载类时,会将解析结果(如符号引用→直接引用)缓存到方法区(元空间)。
- 后续执行同一指令时(如
invokevirtual),直接使用缓存结果,无需重复解析。
避免了重复解析的开销,适合大多数静态场景(如传统单体应用)。
动态加载(如自定义类加载器、热部署):
会破坏系统的确定性,导致同一类被多次加载生成多个独立的Class对象。这使得解析结果无法跨加载器复用,并且每次执行时都需要重新解析方法签名和权限等。典型场景包括热部署中修改类后旧解析结果失效,以及插件系统中不同版本的同名类需要隔离解析。
这就是为什么前面讲的动态加载时解析会在初始化后执行。
整个解析阶段主要做了下面几个工作:
- 类或接口的解析
- 类方法解析
- 接口方法解析
- 字段解析
5)Initialization(初始化)
该阶段是类加载过程的最后一步。在准备阶段,类变量已经被赋过默认初始值,而在初始化阶段,类变量将被赋值为代码期望赋的值。换句话说,初始化阶段是执行类构造器方法(javap 中看到的 <clinit>() 方法)的过程。
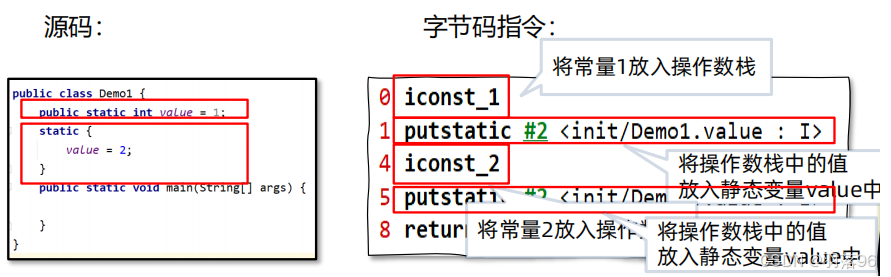
以下几种方式会导致类的初始化:
1.访问一个类的静态变量或者静态方法,(除了 final 常量,它们在编译期就已经放入常量池)。
2.使用 java.lang.reflect 包的方法对类进行反射调用时
3.new一个该类的对象时。
4.JVM 启动时,用户指定的主类(包含 main 方法的类)将被初始化
5.初始化一个类的子类(首先会初始化父类)
如下几种情况是不会进行初始化指令执行的:
1.无静态代码块且无静态变量赋值语句。
2.有静态变量的声明,但是没有赋值语句。
3.静态变量的定义使用final关键字,这类变量会在准备阶段直接进行初始化。
总结:
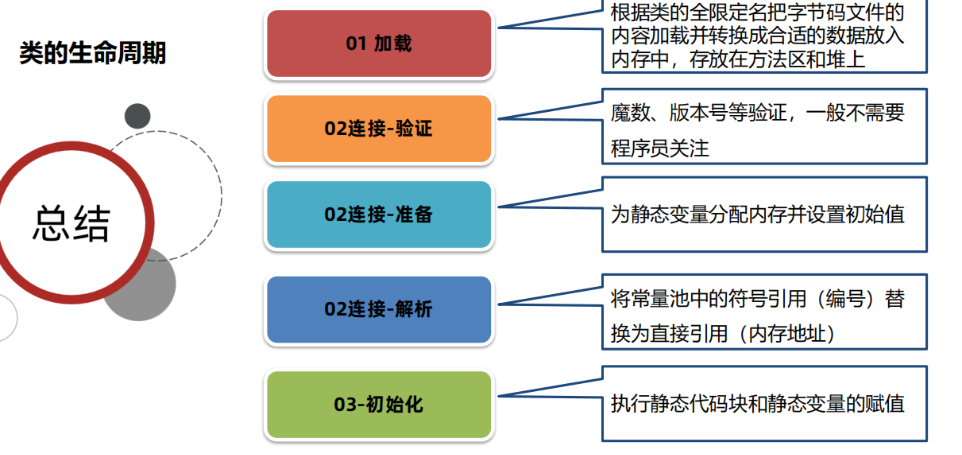
四、类加载器
定义:class->JVM的第一步就是进入类加载器,输入class字节码文件,classloader将字节码加载到内存中,并转换为运行时数据结构变成可执行的class对象。(官话:类加载器(ClassLoader)是Java虚拟机提供给应用程序去实现获取类和接口字节码数据的技术。)
那类加载器(ClassLoader)通过什么机制去实现呢?
loader,加载,将字节码里面定义的数据结构加载到内存中,然后使用即可
在此过程中解决了哪些问题?
加载是有规范的,java底层还是c++,加载的机制解决动态加载,隔离冲突(安全性),性能优化(缓存已加载的类,jdk9中并行加载,如Springboot加载机制)
又限制了哪些范围?
双亲委派机制的局限性,如无法热加载,实现服务发现机制(SPI),载入第三方模块。解决方法:自定义类加载器
实现类加载隔离
- 应用场景 :在 Java EE 容器如 Tomcat 中,需要部署多个不同的 Web 应用程序,而这些应用程序可能会依赖不同版本的第三方类库。
- 原因解释 :如果没有打破双亲委派机制,Tomcat 会使用系统类加载器统一加载所有Web 应用程序的类,这样会导致不同 Web 应用程序之间无法相互隔离,一个Web 应用程序中的类可能会干扰另一个Web 应用程序中的同名类。通过打破双亲委派机制,Tomcat 为每个Web 应用程序创建独立的类加载器,每个Web 应用程序的类加载器优先加载自己应用中的类,从而实现类的隔离,避免类的冲突。
满足热加载
- 热部署场景 :在一些 Java 服务器容器中,如 Tomcat,为了实现热部署功能,即在不重启整个容器的情况下更新应用程序的类。
- 原因解释 :按照双亲委派模型,类一旦被加载就无法卸载,新的类版本也无法被加载。通过打破双亲委派机制,自定义类加载器可以重新加载类,从而实现热部署。例如,Tomcat 的 WebAppClassLoader 会优先加载 Web 应用程序自己定义的类,当需要更新应用时,只需替换新的类文件,然后通过重新加载类即可实现热部署。
解决 SPI 机制问题
- 应用场景 :Java 的 SPI(服务提供发现机制)允许用户通过配置文件动态加载服务实现类,如 JDBC 驱动等。
- 原因解释 :SPI 的接口由 Java 核心库提供,由启动类加载器加载,而 SPI 的实现类通常由应用类加载器加载。由于启动类加载器无法识别应用类加载器加载的类,按照双亲委派模型,启动类加载器无法委派应用类加载器去加载 SPI 实现类。通过引入线程上下文类加载器来打破双亲委派机制,SPI 的接口可以使用线程上下文类加载器来加载 SPI 实现类,解决了类加载器之间的隔离问题。
适应模块化系统(使用第三方模块)
- 应用场景 :在 OSGi 等模块化系统中,每个模块都有自己的类加载器,需要实现模块之间的隔离和动态加载。
- 原因解释 :OSGi 通过自定义类加载器打破了传统的类加载器树状结构,实现了更加复杂的网状结构。在这种结构下,每个模块的类加载器可以独立地加载、卸载类,实现模块的动态安装、更新和卸载,满足了模块化系统对灵活性和动态性的要求。
自定义类加载逻辑(使用第三方模块)
- 应用场景 :开发人员可能需要根据特定的需求自定义类加载逻辑,如从网络加载类、对类进行加密解密等。
- 原因解释 :通过重写 ClassLoader 的 loadClass() 方法或 findClass() 方法,可以实现自定义的类加载逻辑,打破双亲委派机制。例如,开发一个从远程服务器加载类的应用,可以自定义类加载器,使其优先从远程服务器加载类,而不是按照双亲委派模型去委托父类加载器加载。
如图为类加载器:
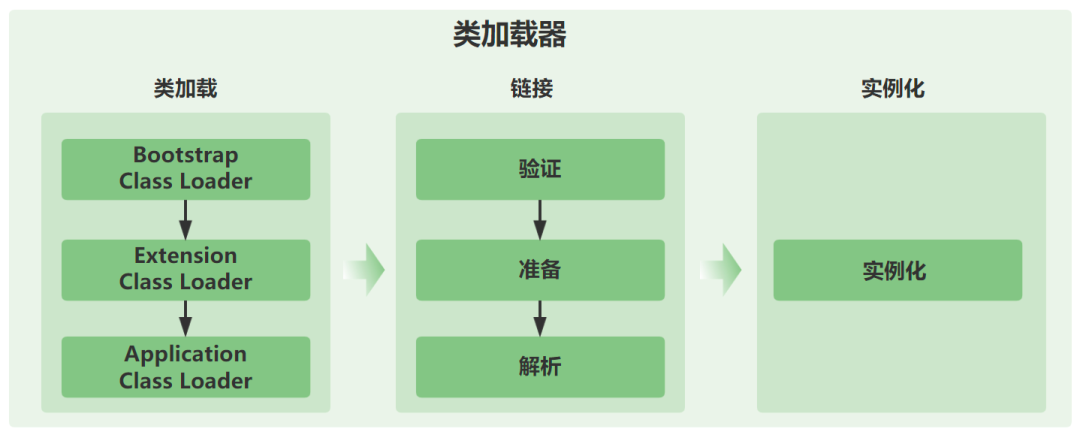
类加载器类型:
①引导类加载器(Bootstrap ClassLoader):负责加载 JVM 基础核心类库,如 rt.jar、sun.boot.class.path 路径下的类。
②扩展类加载器(Extension ClassLoader):负责加载 Java 扩展库中的类,例如 jre/lib/ext 目录下的类或由系统属性 java.ext.dirs 指定位置的类。
③系统(应用)类加载器(System/Application ClassLoader):负责加载系统类路径 java.class.path 上指定的类库,通常是你的应用类和第三方库。
- 讨论双亲委派模型时,通常使用 Application Class Loader(强调其层级位置)。
- 调用 Java API 时,使用 System Class Loader(如
getSystemClassLoader())
④用户自定义类加载器:Java 允许用户创建自己的类加载器,通过继承 java.lang.ClassLoader 类的方式实现。这在需要动态加载资源、实现模块化框架或者特殊的类加载策略时非常有用。
import java.io.*;
public class CustomClassLoader extends ClassLoader {
private String pathToBin;
public CustomClassLoader(String pathToBin) {
this.pathToBin = pathToBin;
}
@Override
protected Class<?> findClass(String name) throws ClassNotFoundException {
try {
byte[] classData = loadClassData(name);
return defineClass(name, classData, 0, classData.length);
} catch (IOException e) {
throw new ClassNotFoundException("Class " + name + " not found", e);
}
}
private byte[] loadClassData(String name) throws IOException {
String file = pathToBin + name.replace('.', File.separatorChar) + ".class";
InputStream is = new FileInputStream(file);
ByteArrayOutputStream byteSt = new ByteArrayOutputStream();
int len = 0;
while ((len = is.read()) != -1) {
byteSt.write(len);
}
return byteSt.toByteArray();
}
}这个自定义类加载器做了以下几件事情:
- 构造器:接受一个字符串参数,这个字符串指定了类文件的存放路径。
- 覆写 findClass 方法:当父类加载器无法加载类时,findClass 方法会被调用。在这个方法中,首先使用 loadClassData 方法读取类文件的字节码,然后调用 defineClass 方法来将这些字节码转换为 Class 对象。
- loadClassData 方法:读取指定路径下的类文件内容,并将内容作为字节数组返回
双亲委派机制:
双亲委派模型(Parent Delegation Model)是 Java 类加载器使用的一种机制,用于确保 Java 程序的稳定性和安全性。在这个模型中,类加载器在尝试加载一个类时,首先会委派给其父加载器去尝试加载这个类,只有在父加载器无法加载该类时,子加载器才会尝试自己去加载。
- 委派给父加载器:当一个类加载器接收到类加载的请求时,它首先不会尝试自己去加载这个类,而是将这个请求委派(不是继承哈)给它的父加载器。
- 递归委派:这个过程会递归向上进行,从启动类加载器(Bootstrap ClassLoader)开始,再到扩展类加载器(Extension ClassLoader),最后到系统类加载器(System ClassLoader)。
- 加载类:如果父加载器可以加载这个类,那么就使用父加载器的结果。如果父加载器无法加载这个类(它没有找到这个类),子加载器才会尝试自己去加载。
- 安全性和避免重复加载:这种机制可以确保不会重复加载类,并保护 Java 核心 API 的类不被恶意替换。
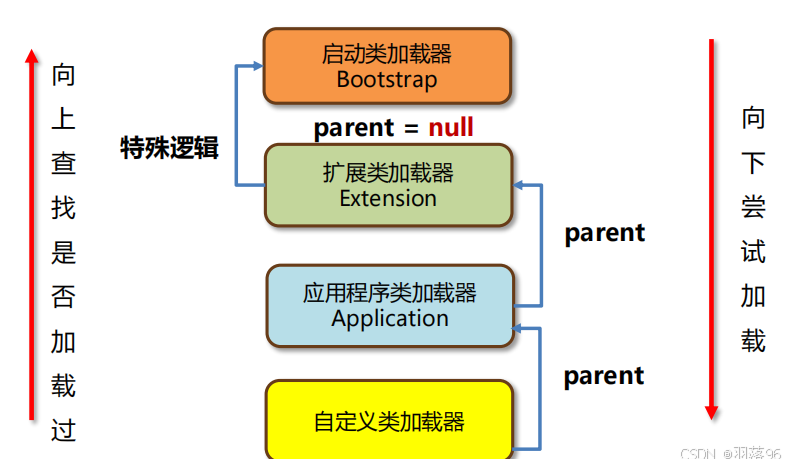
1、自底向上查找是否加载过,再由顶向下进行加载。这样可以保证加载JAVA类的安全性,避免重复加载同样的类(缓存过已经加载的类,提高性能)
2、如果类加载的parent为null,则会提交给启动类加载器处理。为什么会这样呢?因为bootstrap是用java底层机制(C++)实现的,即内置加载器,通常用null表示。
3、JDK9及之后扩展类加载器(Extension ClassLoader)变成了平台类加载器(PlatformClassLoader)
4、如果两个类的加载器不同,即使两个类来源于同一个字节码文件,那这两个类就必定不相等——双亲委派模型能够保证同一个类最终会被特定的类加载器加载。
五、运行时数据区
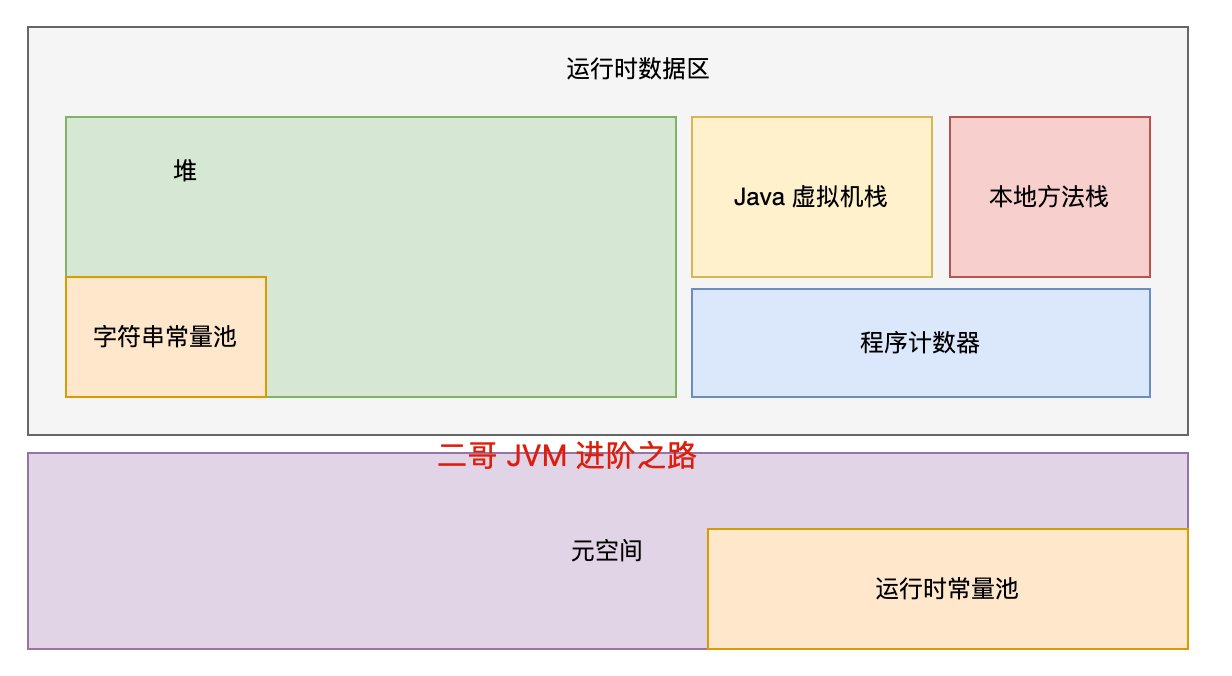
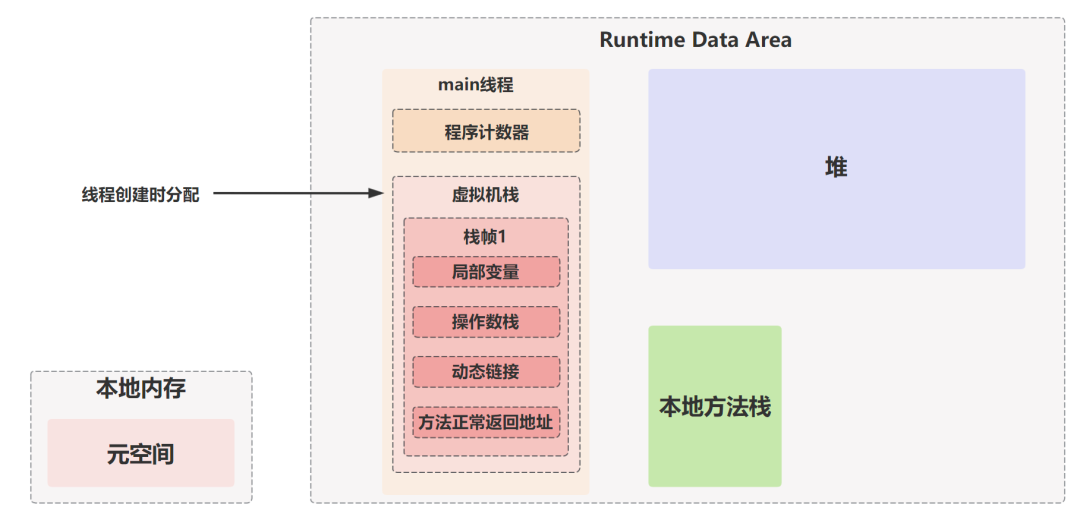
根据 Java 虚拟机规范的规定,运行时数据区可以分为以下几个部分:
- 程序计数器(Program Counter Register)
- Java 虚拟机栈(Java Virtual Machine Stacks)
- 本地方法栈(Native Method Stack)
- 堆(Heap)
- 方法区(Method Area)
下图是JDK1.7和1.8的运行时数据的版本:
注意看:
堆和方法区是共享的,堆是在 JVM 启动的时候创建,用来存储对象(数组也是一种对象)。 JVM 栈(主要存储局部变量、方法参数、对象引用等)
JVM栈、本地方法栈和PC计数器是私有的
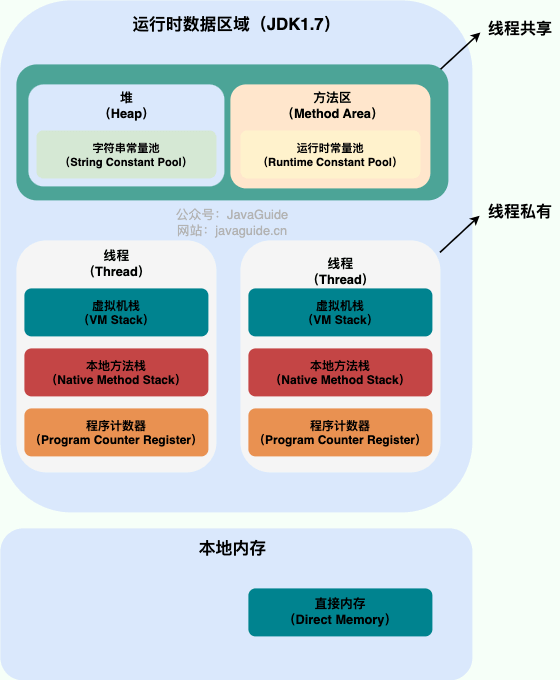
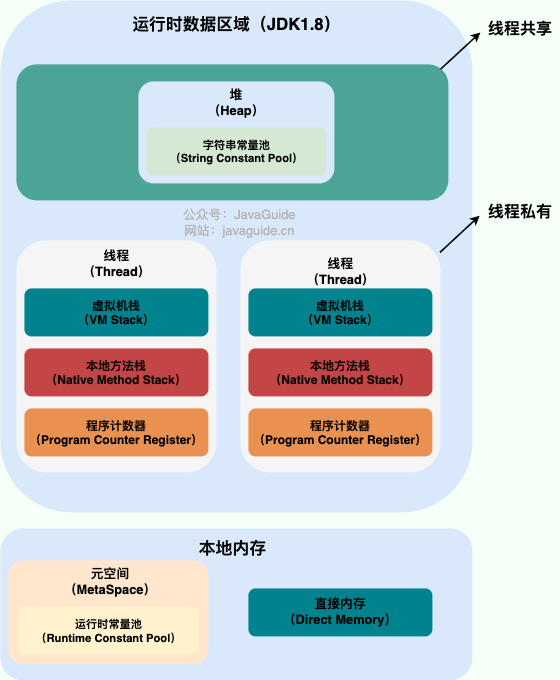
JDK 8 开始,永久代被彻底移除,取而代之的是元空间。元空间不再是 JVM 内存的一部分,而是通过本地内存(Native Memory)来实现的。也就是说,JDK 8 开始,方法区的实现就是元空间。
程序计数器
程序计数器(Program Counter Register)是一块较小的内存空间,可以看作是当前线程所执行的字节码的行号指示器。字节码解释器工作时通过改变这个计数器的值来选取下一条需要执行的字节码指令,分支、循环、跳转、异常处理、线程恢复等功能都需要依赖这个计数器来完成。
《Java 虚拟机规范》中规定,如果线程执行的是非本地方法,则程序计数器中保存的是当前需要执行的指令地址;如果线程执行的是本地方法,则程序计数器中的值是 undefined。
为什么本地方法在程序计数器中的值是 undefined 的?因为本地方法大多是通过 C/C++ 实现的,并未编译成需要执行的字节码指令
⚠️ 注意:程序计数器是唯一一个不会出现 OutOfMemoryError 的内存区域,它的生命周期随着线程的创建而创建,随着线程的结束而死亡。
Java 虚拟机栈
与程序计数器一样,Java 虚拟机栈(后文简称栈)也是线程私有的,它的生命周期和线程相同,随着线程的创建而创建,随着线程的死亡而死亡。
栈绝对算的上是 JVM 运行时数据区域的一个核心,除了一些 Native 方法调用是通过本地方法栈实现的(后面会提到),其他所有的 Java 方法调用都是通过栈来实现的(也需要和其他运行时数据区域比如程序计数器配合)。
方法调用的数据需要通过栈进行传递,每一次方法调用都会有一个对应的栈帧被压入栈中,每一个方法调用结束后,都会有一个栈帧被弹出。 栈帧随着方法调用而创建,随着方法结束而销毁。无论方法正常完成还是异常完成都算作方法结束。
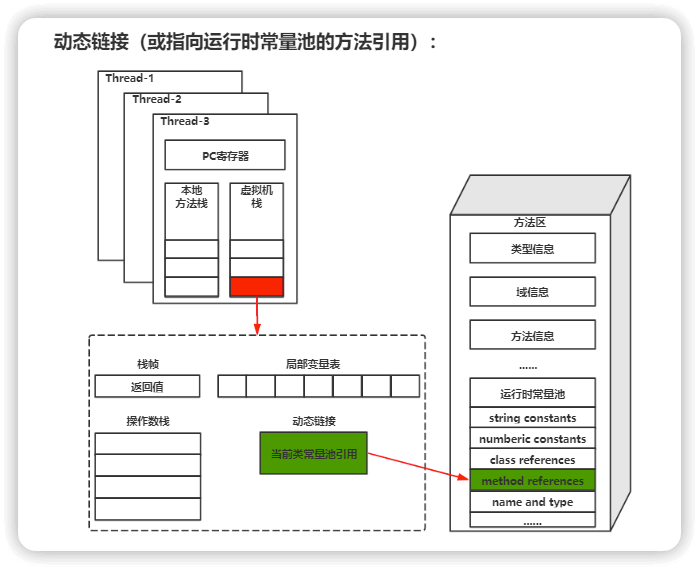
栈由一个个栈帧组成,而每个栈帧中都拥有:局部变量表、操作数栈、动态链接、方法返回地址。和数据结构上的栈类似,两者都是先进后出的数据结构,只支持出栈和入栈两种操作。默认的 JVM 栈大小是 1024 KB,可能因 OS 或 JVM 实现而异。、
线程数与栈内存的关系
总线程数 ≈ 可用内存 / 每个线程的栈大小
-
如果机器总内存为 512MB,且默认栈大小为 1024KB(1MB):
-
理论最大线程数 ≈
512MB / 1MB = 512个线程。 -
如果将栈大小改为 2048KB(2MB):
-
理论最大线程数 ≈
512MB / 2MB = 256个线程(减半)
栈帧过大:即深层递归调用或大方法的调用会导致栈帧变大。所以设置栈内存过小时,大栈帧会导致StackOverflowError;****栈内存设置过大,线程数变小了,会导致无法创建线程错误:OutOfMemoryError: unable to create new native thread。
总结:栈内存和线程数大致上呈现出反比的关系,本质上是可用内存的限制。
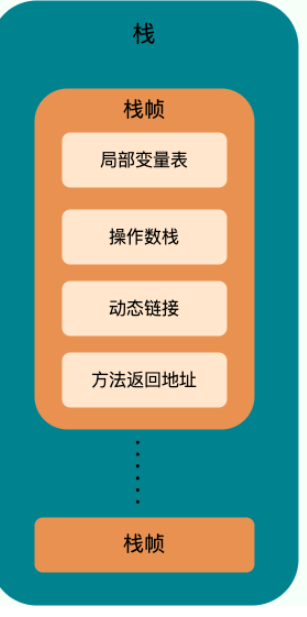
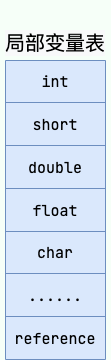
局部变量表 主要存放了编译期可知的各种数据类型(boolean、byte、char、short、int、float、long、double)、对象引用(reference 类型,它不同于对象本身,可能是一个指向对象起始地址的引用指针(直接引用),也可能是指向一个代表对象的句柄或其他与此对象相关的位置(符号引用)。
操作数栈 主要作为方法调用的中转站使用,用于存放方法执行过程中产生的中间计算结果。另外,计算过程中产生的临时变量也会放在操作数栈中。(这算是栈的基本应用,计算数)
动态链接 主要服务一个方法需要调用其他方法的场景。Class 文件的常量池里保存有大量的符号引用,比如方法引用的符号引用。当一个方法要调用其他方法,需要将常量池中指向方法的符号引用转化为其在内存地址中的直接引用。动态链接的作用就是为了将符号引用转换为调用方法的直接引用,这个过程也被称为 动态连接 。
PS:弹栈帧的条件是return或抛异常,其中有两种内存异常要注意:
**StackOverFlowError**: 如果栈的内存大小不允许动态扩展,那么当线程请求栈的深度超过当前 Java 虚拟机栈的最大深度的时候,就抛出StackOverFlowError错误。**OutOfMemoryError**: 如果栈的内存大小可以动态扩展, 那么当虚拟机在动态扩展栈时无法申请到足够的内存空间,则抛出OutOfMemoryError异常
本地方法栈
和虚拟机栈所发挥的作用非常相似,区别是:虚拟机栈为虚拟机执行 Java 方法 (也就是字节码)服务,而本地方法栈则为虚拟机使用到的 Native 方法服务。 在 HotSpot 虚拟机中和 Java 虚拟机栈合二为一。
本地方法被执行的时候,在本地方法栈也会创建一个栈帧,用于存放该本地方法的局部变量表、操作数栈、动态链接、出口信息。
方法执行完毕后相应的栈帧也会出栈并释放内存空间,也会出现 StackOverFlowError 和 OutOfMemoryError 两种错误。
堆和字符常量池
Java 虚拟机所管理的内存中最大的一块,Java 堆是所有线程共享的一块内存区域,在虚拟机启动时创建。此内存区域的唯一目的就是存放对象实例,几乎所有的对象实例以及数组都在这里分配内存。
Java 世界中“几乎”所有的对象都在堆中分配,但是,随着 JIT 编译器的发展与逃逸分析技术逐渐成熟,栈上分配、标量替换优化技术将会导致一些微妙的变化,所有的对象都分配到堆上也渐渐变得不那么“绝对”了。从 JDK 1.7 开始已经默认开启逃逸分析,如果某些方法中的对象引用没有被返回或者未被外面使用(也就是未逃逸出去),那么对象可以直接在栈上分配内存。
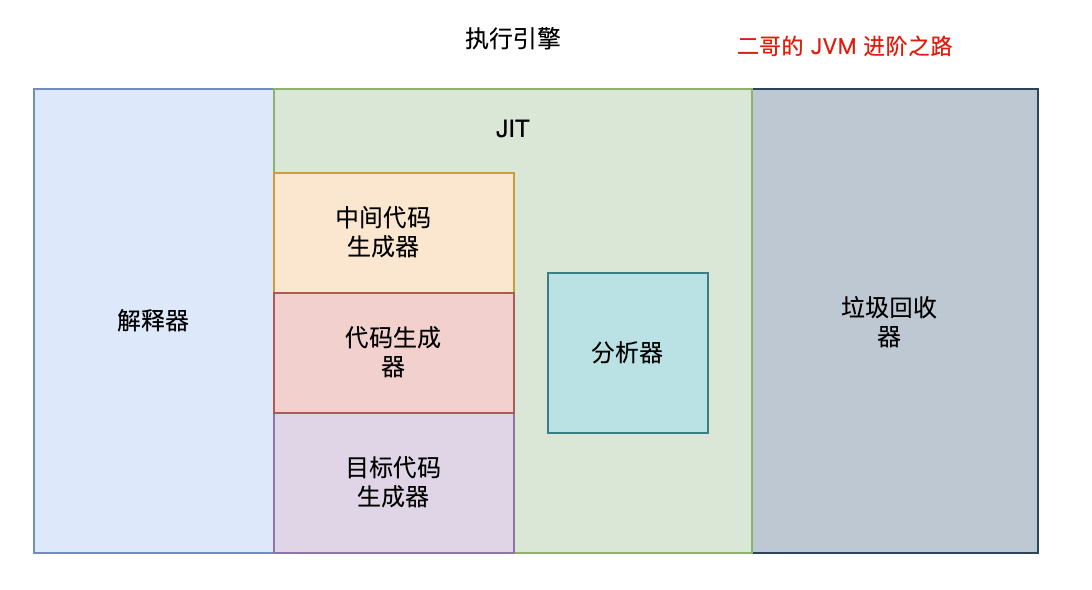
为了优化 Java 的性能 ,JVM 在解释器之外引入了 JIT 编译器:当程序运行时,解释器首先发挥作用,代码可以直接执行。随着时间推移,即时编译器逐渐发挥作用,把越来越多的代码编译优化成本地代码,来获取更高的执行效率。解释器这时可以作为编译运行的降级手段,在一些不可靠的编译优化出现问题时,再切换回解释执行,保证程序可以正常运行。
逃逸分析(Escape Analysis)是一种编译器优化技术,用于判断对象的作用域和生命周期。如果编译器确定一个对象不会逃逸出方法或线程的范围,它可以选择在栈上分配这个对象,而不是在堆上。这样做可以减少垃圾回收的压力,并提高性能。
Java 堆是垃圾收集器管理的主要区域,因此也被称作 GC 堆(Garbage Collected Heap)。从垃圾回收的角度,由于现在收集器基本都采用分代垃圾收集算法,所以 Java 堆还可以细分为:新生代和老年代;再细致一点有:Eden、Survivor、Old 等空间。进一步划分的目的是更好地回收内存,或者更快地分配内存。
在 JDK 7 版本及 JDK 7 版本之前,堆内存被通常分为下面三部分:
- 新生代内存(Young Generation)
- 老生代(Old Generation)
- 永久代(Permanent Generation)
HotSpot还会进一步将新生代划分为Eden区和Survivor区(From Survivor、To Survivor)。对象的晋升(Promotion)过程遵循分代垃圾回收(Generational GC)策略,核心目标是减少Full GC的频率。以下是对象在堆内存中的转换流程:
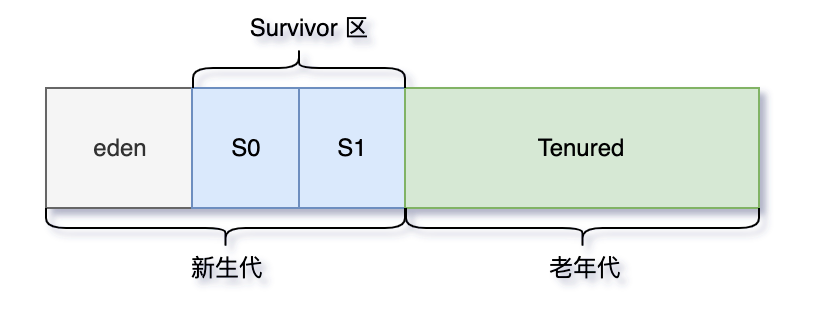
下图所示的 Eden 区、两个 Survivor 区 S0 和 S1 都属于新生代,中间一层属于老年代,最下面一层属于永久代。
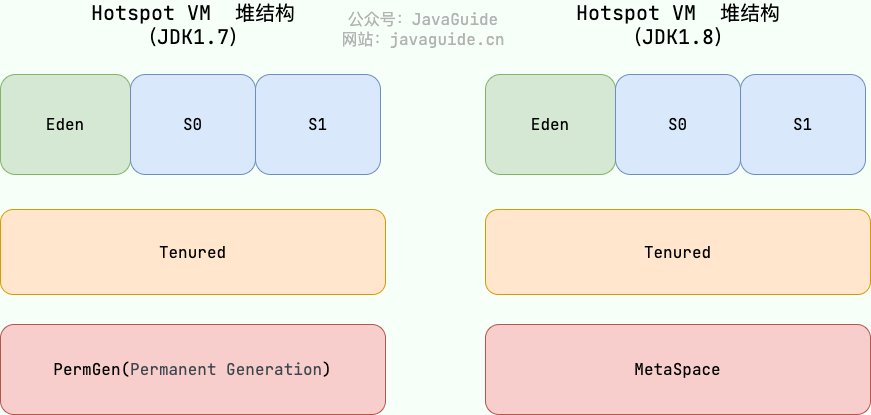
大部分情况,对象都会首先在 **Eden 区域(第一次)**分配,在一次**新生代垃圾回收后**,如果对象还**存活**,则会进入 **S0 或者 S1(Survivor 区** **)**,并且对象的年龄还会加 1(Eden 区->Survivor 区后对象的初始年龄变为 1),当它的年龄增加到一定程度(默认为 15 岁),就会被晋升到老年代中。对象晋升到老年代的年龄阈值,可以通过参数 `-XX:MaxTenuringThreshold` 来设置。不过,设置的值应该在 0-15,否则会爆出以下错误:因为设置二进制就4位,最大为1111=15MaxTenuringThreshold of 20 is invalid; must be between 0 and 15堆这最容易出现的就是 OutOfMemoryError 错误,分为以下几种表现形式:
OutOfMemoryError: GC Overhead Limit Exceeded:当 JVM 花太多时间执行垃圾回收并且只能回收很少的堆空间时,就会发生该错误。java.lang.OutOfMemoryError: Java heap space:假如在创建新的对象时, 堆内存中的空间不足以存放新创建的对象, 就会引发该错误。和本机的物理内存无关,和我们配置的虚拟机内存大小有关!
总结:
- 新对象 → Eden区 → Minor GC后存活 → Survivor区(年龄递增)→ 年龄超阈值 → 老年代。
- 大对象 → 直接进入老年代。
- 老年代满 → 触发Full GC。
字符串常量池
JVM 为了提升性能和减少内存消耗针对字符串(String 类)专门开辟的一块区域,主要目的是为了避免字符串的重复创建。如下图放在堆中,
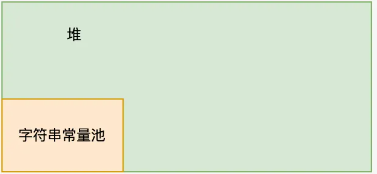
创建字符串常量池有两种方法:直接使用字面量 String = "abc";或使用 new 创建 String s = new Strin("abc");前者不会重复创建,后者不管存在重复字符,都会在堆中创建新对象;
使用 new 方法创建会导致对象冗余,可以使用 String.intern()方法,如果存在重复字符会返回引用,反之才会创建,不会重复创建
其中 String.intern()方法就是直接到字符串常量池中查字符(equals()方法 ),如果存在,则不会在堆中再创建,而是直接引用
方法区与元空间,及运行时常量池
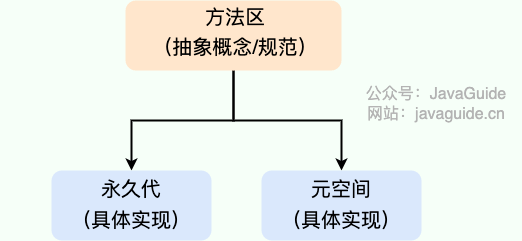
方法区属于是 JVM 运行时数据区域的一块逻辑区域,是各个线程共享的内存区域。在不同的虚拟机实现上,方法区的实现是不同的。
当虚拟机要使用一个类时,它需要读取并解析 Class 文件获取相关信息,再将**信息存入到方法区(在 JDK8 中存入元空间)**。方法区会存储已被虚拟机加载的 **类信息、字段信息、方法信息、常量、静态变量、即时编译器编译后的代码缓存等数据**。方法区和永久代以及元空间是什么关系呢?都是方法区的具体实现,只是在jdk7使用永久代,jdk8使用元空间。
为什么抛弃永久代?
1、在 JDK8,合并 HotSpot 和 JRockit 的代码时, JRockit 从来没有一个叫永久代的东西,有JIN, 合并之后就没有必要额外的设置这么一个永久代的地方了。(合并版本兼容性问题)
2、内存溢出:整个永久代有一个 JVM 本身设置的固定大小上限,无法进行调整(也就是受到 JVM 内存的限制),可以通过 -XX:PermSize 设置永久代初始容量,通过-XX:MaxPermSize 设置永久代最大容量。而元空间使用的是本地内存(直接内存),受本机可用内存的限制,虽然元空间仍旧可能溢出,但是比原来出现的几率会更小。(增加内存空间,防止溢出OOM)
3、**动态调整内存:**元空间里面存放的是类的元数据,这样加载多少类的元数据就不由 MaxPermSize 控制了, 而由系统的实际可用空间来控制,这样能加载的类就更多了。
4、永久代会为 GC 带来不必要的复杂度,并且回收效率偏低,无法回收常量池中的内存。
运行时常量池
在JDK7时放在方法区中,在JDK8中放在元空间中。
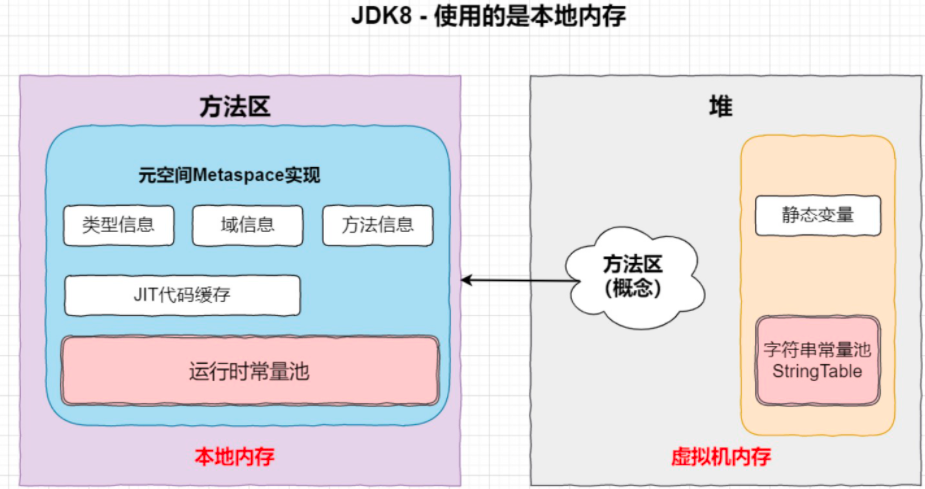
在第二章讲class字节码文件时,讲到了常量池:存字面量(Literals)和符号引用(Symbolic References)。那么在class文件在类加载放到对应版本的“方法区”中,方便堆调用。
ps:既然运行时常量池是方法区的一部分,自然受到方法区内存的限制,当常量池无法再申请到内存时会抛出 OutOfMemoryError 错误
总结:
来总结一下运行时数据区的主要组成:
- PC 寄存器(PC Register),也叫程序计数器(Program Counter Register),是一块较小的内存空间,它的作用可以看做是当前线程所执行的字节码的信号指示器。
- JVM 栈(Java Virtual Machine Stack),与 PC 寄存器一样,JVM 栈也是线程私有的。每一个 JVM 线程都有自己的 JVM 栈(也叫方法栈),这个栈与线程同时创建,它的生命周期与线程相同。
- 本地方法栈(Native Method Stack),JVM 可能会使用到传统的栈来支持 Native 方法的执行,这个栈就是本地方法栈。
- 堆(Heap),在 JVM 中,堆是可供各条线程共享的运行时内存区域,也是供所有类实例和数据对象分配内存的区域。
- 方法区(Method area),JDK 8 开始,使用元空间取代了永久代。方法区是 JVM 中的一个逻辑区域,用于存储类的结构信息,包括类的定义、方法的定义、字段的定义以及字节码指令。不同的是,元空间不再是 JVM 内存的一部分,而是通过本地内存(Native Memory)来实现的。
- 运行时常量池,运行时常量池是每一个类或接口的常量在运行时的表现形式,它包括了编译器可知的数值字面量,以及运行期解析后才能获得的方法或字段的引用。简而言之,当一个方法或者变量被引用时,JVM 通过运行时常量区来查找方法或者变量在内存里的实际地址。
在 JVM 启动时,元空间的大小由 MaxMetaspaceSize 参数指定,JVM 在运行时会自动调整元空间的大小,以适应不同的程序需求。
直接内存(元空间的内存)
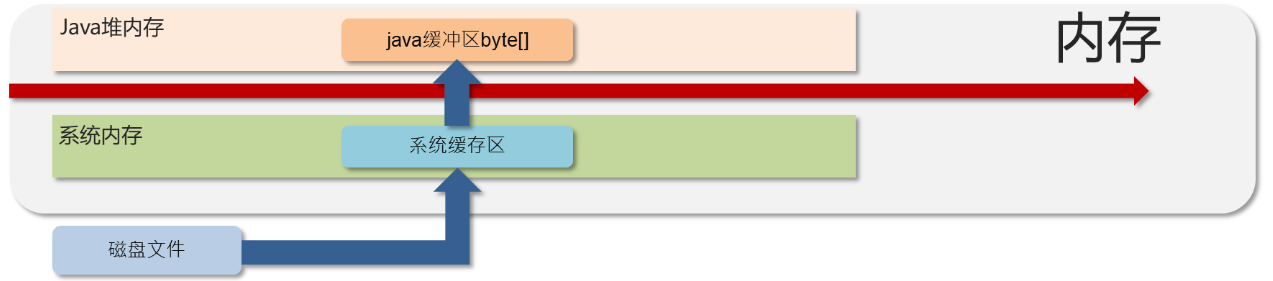
直接内存是一种特别的内存空间,它不在 Java 堆或方法区里分配,而是通过 JNI(Java Native Interface)技术在计算机本地内存中分配。你可以用 ByteBuffer.allocateDirect 方法来创建这种内存。虽然直接内存不是 JVM(Java 虚拟机)运行时数据区的一部分,也不是 JVM 规范里定义的标准内存区域,但它经常被使用。而且,如果使用不当,也可能会导致 OutOfMemoryError 错误。
与堆内存的区别:
使用堆内存:
使用直接内存:
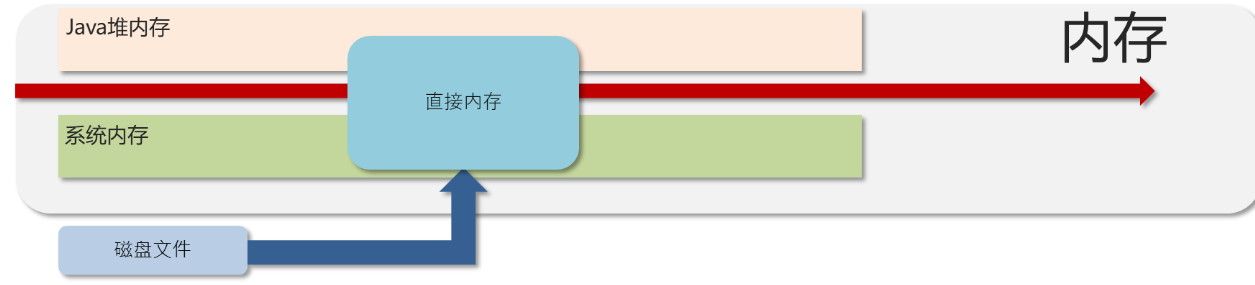
区别:直接内存访问更快,可以理解为缓存机制,避免先到堆中读取复制的过程,垃圾回收使用 cleaner 进行回收,与 JVM 回收器无关。
直接内存的原理:
JDK1.4 中新加入的 NIO(Non-Blocking I/O,也被称为 New I/O),引入了一种基于通道(Channel)与缓存区(Buffer)的 I/O 方式,它可以直接使用 Native 函数库直接分配堆外内存,然后通过一个存储在 Java 堆中的 DirectByteBuffer 对象作为这块内存的引用进行操作。这样就能在一些场景中显著提高性能,因为避免了在 Java 堆和 Native 堆之间来回复制数据。
类似的概念还有 堆外内存 。在一些文章中将直接内存等价于堆外内存,个人觉得不是特别准确。堆外内存就是把内存对象分配在堆外的内存,这些内存直接受操作系统管理(而不是虚拟机),这样做的结果就是能够在一定程度上减少垃圾回收对应用程序造成的影响。
六、执行引擎(Execution Engine)
执行过程
概述:执行引擎负责将字节码转化为机器指令并执行
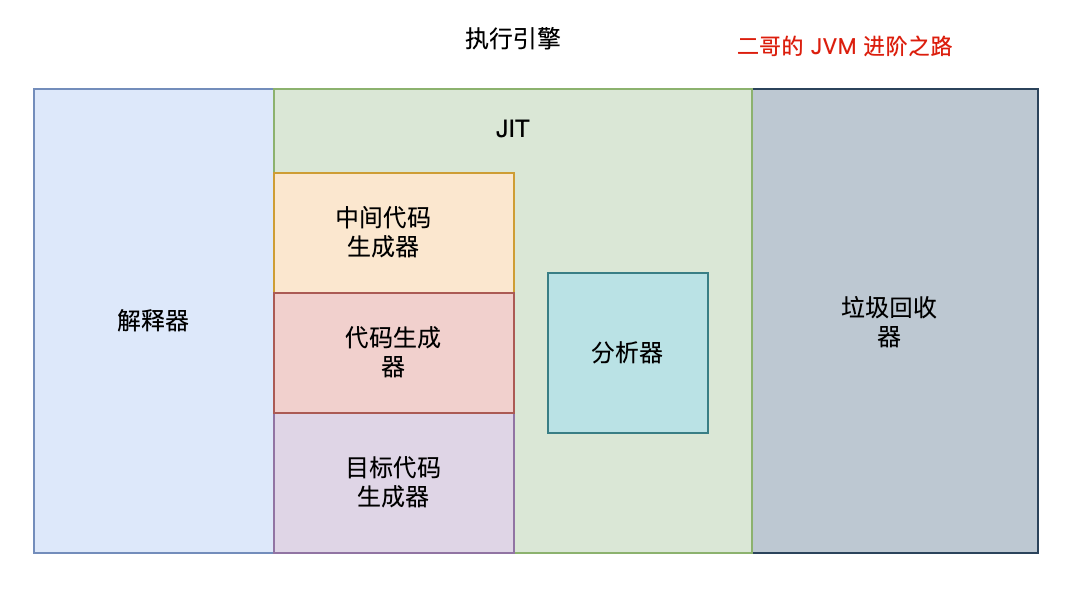
包含:
1、解释器(Interpreter):逐行解释字节码并执行,适用于程序首次运行时。速度快,效率低
2、即时编译器(JT Compiler):将热点代码(频繁执行的代码)编译为机器码,执行提升效率。JIT还可能会发生指今重排序:一般用 voliate 来解决该问题
编译器类型:将热点字节码编译为本地机器码
C1(ClientComplier客户端编译器): 快速编译,优化较少
C1 通常会做这三件事:
①局部简单可靠的优化,比如在字节码上进行一些基础优化,方法内联、常量传播等。
②将字节码编译成 HIR(High-level Intermediate Representation),即消除冗余代码,
③最后将 HIR 转换成 LIR(Low-level Intermediate Representation),比较接近机器码了。这期间会做一些寄存器分配(比内存访问速度快)、窥孔优化等。
C2(Server服务端编译器):深度优化,编译耗时较长
C2 会使用一种控制流与数据流结合的图数据结构,称为 Ideal Graph,我愿称之为“理想图”。Ideal Graph 表示当前程序的数据流向和指令间的依赖关系,依靠这种图结构,某些优化步骤(尤其是涉及浮动代码块的优化步骤)会变得不那么复杂。
中间代码生成器:生成中间表示(IR)供优化使用,包括字节码→IR转换和优化过程。
代码缓存(Code Cache) :存储已编译的本地机器码,大小可通过JVM参数配置(-XX:ReservedCodeCacheSize)
**3、垃圾回收协调器:**与GC协同工作,处理安全点(Safepoint)等问题
工作流程
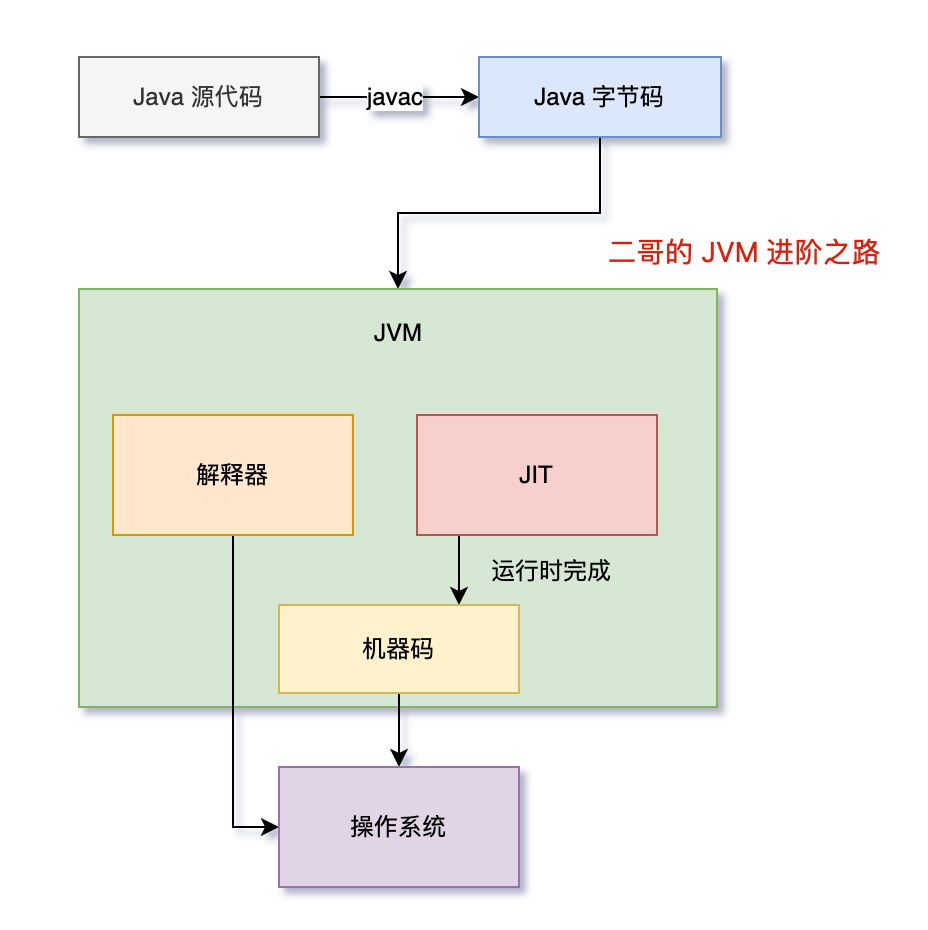
- 初始执行 阶段:
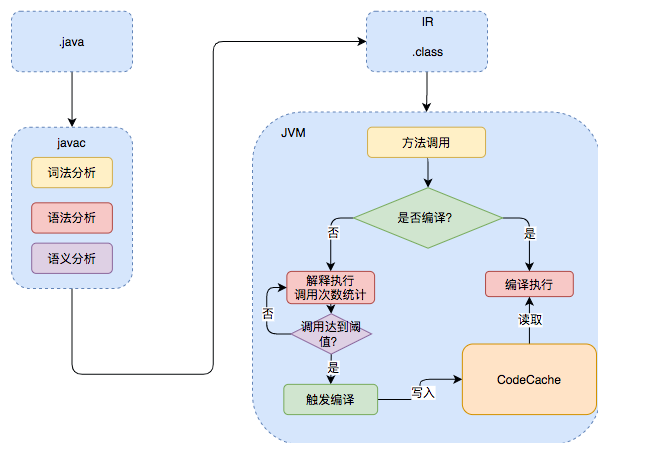
所有方法最初由解释器执行,收集方法调用频率等运行时信息,但不会记住之前的解释结果。
- 热点检测:在第一步的基础上,JIT 将热点代码对应的字节码编译成机器码。说白话就是设一个阈值,超过就使用:
- 阈值为:方法调用计数器(Invocation Counter)和回边计数器(Back Edge Counter,用于循环)
- 默认阈值:客户端模式1500次,服务端模式10000次
什么是热点代码呢?
在JVM中,使用****方法的调用次数以及循环回边的执行次数来触发 JIT。,会被视为热点代码并编译后存储于codeCache。后续执行时直接从codeCache读取机器码运行,从而提高程序性能。
整体的执行过程大致如下图所示:
- 编译优化:
//
int add(int a, int b) { return a + b; }
// 调用处
int result = add(x, y);
// 优化后变为
int result = x + y;- 分层编译(Tiered Compilation):
- Java 7+默认启用(-XX:+TieredCompilation)
- 0级:纯解释器执行
- 1级:C1简单编译,应用了一些基本的优化,如方法内联。
- 2级:C1 完整优化,此层级仍由 C1 编译器处理,但应用了更多优化技术,如逃逸分析。
- 3级:C1完全优化,C1 编译器除了执行优化,还收集方法执行的详细分析数据(如分支频率、热点代码等)。这些数据将用于 C2 编译器的后续优化。
- 4级:C2深度优化,最终阶段由 C2 编译器处理,它使用收集的分析数据进行深入优化。C2 编译器的优化更加彻底和复杂,适用于长时间运行的代码,能够提供最佳的运行性能。
| 编译级别(Tier) | 编译器 | 优化程度 | 触发条件 | 存储位置 |
|---|---|---|---|---|
| Tier 0 | 解释器 | 无编译 | 所有方法初始执行 | 不占用 Code Cache |
| Tier 1 | C1(客户端编译器) | 简单优化(如方法内联、栈替换) | 方法调用次数达到阈值 | Code Cache(普通方法代码区) |
| Tier 2 | C1 | 更多优化(如空检查消除) | 更高调用频率 | Code Cache(普通方法代码区) |
| Tier 3 | C1 | 完全优化(含部分 profiling) | 长期热点方法 | Code Cache(可能存于 Profiled 区) |
| Tier 4 | C2(服务端编译器) | 激进优化(如逃逸分析、循环展开) | 极高频热点方法 | Code Cache |
太深入的学不了一点。
JIT 代码存放地址:
编译后的机器码放在 Code Cache 中:
Code Cache 不属于 Java 堆(Heap)或方法区(Metaspace),而是位于 JVM 的本地内存(Native Memory) 中,由 JVM 直接管理。
Code Cache 的大小和行为可以通过以下参数调整:
| 参数 | 作用 | 默认值(不同 JDK 版本可能不同) |
|---|---|---|
-XX:InitialCodeCacheSize |
初始 Code Cache 大小 | 32MB(JDK 8) / 240KB(JDK 11+) |
-XX:ReservedCodeCacheSize |
Code Cache 最大容量 | 240MB(JDK 8) / 512MB(JDK 11+) |
-XX:CodeCacheMinimumFreeSpace |
触发 Code Cache 清理的剩余空间阈值 | 500KB |
-XX:+UseCodeCacheFlushing |
允许在 Code Cache 满时清理无用代码 | 默认启用 |
-XX:+PrintCodeCache |
打印 Code Cache 使用情况(调试用) | 默认禁用 |
JIT 失效的情况,退回解释模式:
1、 在 JIT 优化失败时(如动态加载类),JIT 可能对丢掉 code Cache 中的代码,退回解释模式。
2、 内存溢出:JDK 8: 240MB, JDK 11+: 512MB(可调整)
Code Cache 与 Tiered Compilation(分层编译)的关系:
在 JDK8 后,引入分层编译,code cache 按代码类型划分:
Code Cache
├── Non-method Code(JVM 内部代码)
├── Method Code 方法代码
│ ├── Non-Profiled(Tier 1~2, Tier 4)
│ └── Profiled(Tier 3)
└── AOT Code(如果启用)| 分区类型 | 存储内容 | 是否与编译级别直接相关 | 示例 |
|---|---|---|---|
| Non-method Code(非方法代码) | JVM 内部使用的非方法代码(如运行时桩代码、调试代码) | 无关 | 动态生成的适配器代码(如 JNI 调用桩) |
| Non-Profiled Code**(非预测代码)** | 普通优化后的代码 | 对应 Tier 1~2(C1)和 Tier 4(C2) | 大多数 JIT 编译后的方法 |
| **Profiled Code **(预测代码) | 带性能分析数据(Profiling Data)的代码(用于进一步优化) | 对应 Tier 3 的 C1 编译结果 | 收集了分支预测数据的方法 |
| AOT Code(JDK 9+) | 提前编译(AOT)生成的代码 | 无关 | jaotc 工具生成的代码 |
总结:
| 关键点 | 说明 |
|---|---|
| Code Cache 位置 | JVM 本地内存(Native Memory),独立于 Java 堆 |
| 存储内容 | JIT 编译后的机器码(优化后的热点方法) |
| 默认大小 | JDK 8: 240MB, JDK 11+: 512MB(可调整) |
| 溢出影响 | JIT 编译停止,性能回退到解释模式 |
| 优化建议 | 监控使用情况,必要时调大 ReservedCodeCacheSize |
上述一下基本名词解释:
窥孔优化(Peephole Optimization)是一种在生成机器码阶段进行的局部优化技术。编译器“窥视”一小段生成的机器码,并尝试找出并替换更高效的指令序列。
方法内联**:**简单来说,假如执行方法 A 需要调方法 B,经过方法内联之后,将方法 A 的字节码直接插入到 方法 B 中,不用再去调用方法 B 了,直接执行方法 A。
逃逸分析(Escape Analysis)是一种编译器优化技术,用于判断对象的作用域和生命周期。如果编译器确定一个对象不会逃逸出方法或线程的范围,它可以选择在栈上分配这个对象,而不是在堆上。这样做可以减少垃圾回收的压力,并提高性能。
逃逸的类似就是:方法逃逸、线程逃逸
逃逸的优化:
① 栈上分配:没方法逃逸,在栈上分配这个对象,而不是在堆上,减少堆的内存压力和垃圾回收的压力,并提高性能
② 标量替换:没有逃逸可拆解。将对象的字段转换成标量(如基本类型),减少对象内存的分配
**③ 同步消除:**没线程逃逸,**移除不要的锁,**减少开销
在 JVM 中默认开启逃逸分析:
- -XX:+DoEscapeAnalysis:启用逃逸分析(默认开启)
- -xx:+EliminateLocks:启用同步消除(基于逃逸分析)
- -xx:+EliminateAllocations:启用标量替换(基于逃逸分析)
方法逃逸:如果一个对象在方法内部创建,并作为返回值或通过参数传递给其他方法,则该对象会逃逸到方法之外。线程逃逸:如果对象被另一个线程访问,或者被保存为静态变量或共享变量,该对象会逃逸到该线程或全局作用域
七、垃圾回收机制
学习大纲:
1、垃圾回收的地方在哪?(堆结构是什么,内存分配的原则,内存分配安全机制)
2、怎么样的对象叫垃圾?(垃圾对象的判定方法)
3、怎么回收垃圾?(垃圾回收算法理论)
4、有哪些垃圾回收器(对算法的具体实现)
最终的目的:
吞吐量和停顿时间的优化,本质上是多线程和对 STOP-The-World 的优化。比如对批处理需要提高吞吐量,对于实时系统,需要减少停顿时间导致的延迟
1、堆的数据结构:
Java 的自动内存管理主要是针对对象内存的回收和对象内存的分配。同时,Java 自动内存管理最核心的功能是堆内存中对象的分配与回收。
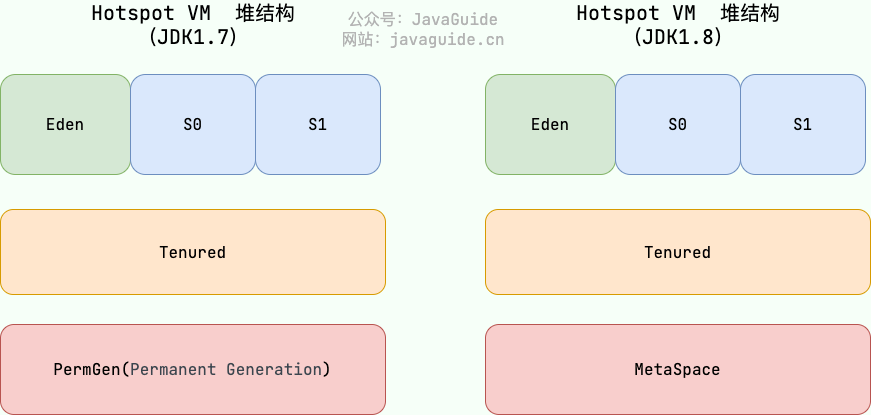
1、Java 的对象是在堆中创建的,但堆(JDK8)又分为新生代和老年代(内存 1:2),新生代又细分为 Eden、From Survivor、To Survivor。(默认 8:1:1)
2、在JDK8中又分成新生代内存(Young Generation)、老生代(Old Generation)。然后在垃圾回收(Garbage Collection,GC)中有分为:针对 HotSpot VM 的实现,它里面的 GC 其实准确分类只有两大种:
①部分收集 (Partial GC):
- 新生代收集(Minor GC / Young GC):只对新生代进行垃圾收集;
- 老年代收集(Major GC / Old GC):只对老年代进行垃圾收集。需要注意的是 Major GC 在有的语境中也用于指代整堆收集;
- 混合收集(Mixed GC):对整个新生代和部分老年代进行垃圾收集。
②整堆收集 (Full GC):收集整个 Java 堆和方法区。
了解了上述堆的结构:新生代,老年代。以及GC回收的两大类:Partial GC和Full GC
下面就了解怎么去分配内存,怎么回收内存?
2.java 中分代回收中 yong GC,old GC ,Full GC,mixed GC 有什么区别?
①部分收集 (Partial GC):
- 新生代收集(Minor GC / Young GC):只对新生代进行垃圾收集;
- 老年代收集(Major GC / Old GC):只对老年代进行垃圾收集。需要注意的是 Major GC 在有的语境中也用于指代整堆收集;
- 混合收集(Mixed GC):对整个新生代和部分老年代进行垃圾收集。
②整堆收集 (Full GC):收集整个 Java 堆和方法区。
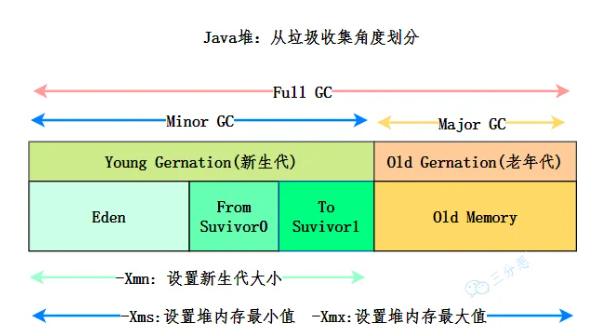
整个机制还是因为内存分配的问题,输入的对象大小和生命周期不同,会导致触发不同的 GC(其实就是分区 GC)。保证每个分区效率最大。
触发 Minor GC 的条件:Eden 、Eden+survivor 区内存不足,使用复制算法(可以理解为 Minor GC 就是执行复制算法),优点就是**快,**STW(Stop-The-World)时间短,无内存碎片
一下垃圾收集器,会有触发 Minor GC 的机制,如****和Parallel Scavenge 收集器会在 full GC 之前执行一遍 Minor GC,避免 full GC 时间过长
触发 Major GC 的条件:老年代内存不足。使用标记-清除或标记-整理算法 GC 老年代(同上),优点就是针对性回收,减少Full GC。
触发 Mixed GC 的条件:特定于 G1 垃圾回收器,当老年代空间>阈值的 45%,G1 会对老年代和新生代同时回收。优点就是平衡效率
触发 Full GC 的条件:
①Minor GC 无法回收空间放入对象,退化成 full GC;
② 方法区(元空间)内存不足。
③ 显式调用 System.gc()(依赖 JVM 实现)。
④ 垃圾回收器策略失败(如 G1 的 Evacuation Failure)。
**作用范围是:**回收整个堆 + 方法区(元空间)。没优点,兜底机制。
| GC 类型 | 触发条件 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|---|
| Minor GC | Eden 区不足 | 速度快,STW 短 | 可能引发晋升,不处理老年代 | 高频触发,优化新生代回收效率 |
| Major GC | 老年代不足或晋升失败 | 减少Full GC 频率 | STW 较长,可能退化为 Full GC | 老年代对象生命周期长 |
| Mixed GC | G1 老年代占用阈值 | 平衡吞吐量与延迟,增量回收 | 仅限 G1,内存开销大 | 大堆内存,低延迟需求 |
| Full GC | 整堆或方法区不足、显式调用,major GC 都清不出空间 | 彻底释放内存 | 长时间 STW,性能影响严重 | 最后手段,需尽量避免(进行 majorGC 都无法装入对象,退化成父类 GC) |
3、 如何避免 JVM 新生代垃圾回收的全堆扫描?(如何解决 JVM 中跨代引用问题?)
这个问题很奇怪的。先理解问题吧,什么情况会触发全堆扫描:Full GC 或并发标记阶段(并发)
哪些情况会导致全堆扫描?
(1) Full GC 触发全堆扫描
大多数情况下,全堆扫描是由 Full GC 引起的,例如:
- 老年代空间不足(晋升失败,
HandlePromotionFailure)。 - 元空间(Metaspace)耗尽(
Metaspace OOM)。 - 显式调用
System.gc()(除非禁用-XX:+DisableExplicitGC)。 - 堆内存分配失败(
Allocation Failure)。
特点:
Stop-The-World (STW),应用线程暂停。
回收整个堆(新生代 + 老年代 + 元空间)。
(2) 并发标记阶段的全堆扫描(不触发 Full GC)
某些 GC(如 G1、CMS、ZGC)在 并发标记阶段 会扫描整个堆,但 不触发 Full GC:
G1 的并发标记(Concurrent Marking):
- 扫描所有 Region(新生代 + 老年代)。
- 不 STW(与应用程序并发执行)。
CMS 的初始标记(Initial Mark):
- 短暂 STW,仅标记 GC Roots 直接引用的对象。
- 不算 Full GC。
特点:
不 STW(或短暂 STW),对应用影响较小。
仅标记,不立即回收。
上述都是很常规的全堆扫描?是问这个吗?其实是在问跨代引用问题,即老年代对象引用了新生对象。是不是和三色标记法里面漏标的情况很像,
怎么避免呢?也是和三色标记法里面解决漏标问题一样。使用写屏障,即卡表(Card Table 记忆集的一种实现),来记录并发环境下老年代引用新生对象并触发写屏障,标记成“脏卡”如果 GC 去重新扫描。这里只找老对象的引出(在记忆集中叫 points-out)。
4、分配内存和内存回收原则:
优先进入eden区
98%的对象是朝生夕死的,所以对象优先在eden中分配,当eden空间不足时,JVM发起Minor GC 回收内存,小部分存活的对象,将进入survivor区,即S0区(From survivor区)内存够进S0区,反之进S1(To survivor区)。
1、为什么设置survivor区?
Survivor 区相当于是 Eden 区和 Old 区的一个缓冲。减少被送到老年代的对象,进而减少 Major GC 的发生。Survivor 的预筛选保证,只有经历 16 次 Minor GC 还能在新生代中存活的对象,才会被送到老年代。
2、为什么survivor区又分成两个小区?
设置两个 Survivor 区最大的好处就是解决内存碎片化(设计到回收算法,如标记和清除算法导致的内部碎片)。而分太多区了,又回导致内存不够。
大对象,存活时间长的对象,动态年龄判定的对象
大对象直接进入老年代,这种策略的目的是减少垃圾回收时的复制开销,因为大对象的复制比小对象更耗时。可以通过 -XX:PretenureSizeThreshold 参数设置直接分配大对象到老年代的阈值。
长期存活的对象将进入老年代,对象在每次从一个 Survivor 区转移到另外一个 Survivor 区时,它的年龄就会增加。当对象的年龄达到一定阈值(默认为 15),则它会被转移到老年代。可以用 -XX:PretenureSizeThreshold=10 来设置年龄。
在实际过程中,年龄计数器在某些JVM虚拟机是4个bit,所以取值范围是0-15.其他虚拟机就不一定了。其次通age计数器一个变量去判定进入老年代的时机,太绝对了。——>根据占用空间大小动态判断。
动态年龄判断:
除了年龄达到 MaxTenuringThreshold,还有另外一个方式进入老年代,那就是动态年龄判断:JVM 会检查每个年龄段的对象大小,并估算它们在 Survivor 空间中所占的总体积。JVM 会选择一个最小的年龄,使得该年龄及以上的对象可以填满 Survivor 空间的一部分(通常小于总空间的一半),然后将这些对象晋升到老年代。
这种情况是高频使用对象的情况下,age计数器大小都在0-15,而且空间又大。会选择某个年龄区间,该区间占Survivor的一半以上,则进入老年代
总结:
梳理刚刚提到的内存分配流程:
1、对象进入eden区,随着eden内存的变小,触发了第一次Minor GC,判定垃圾对象和存活对象,垃圾对象被回收,**存活对象,则会进入 S0 或者 S1,并且对象的年龄还会加 1(**Eden 区->Survivor 区后对象的初始年龄变为 1),**PS:**通常会进入S区,但受空间、年龄、大对象规则等因素影响,可能直接进入老年代。并非绝对。
2、进入老年区的原因:age计数器,大空间对象,动态年龄判断等规则
5、内存分配安全机制
空间分配(HandlePromotion)担保是为了确保在 Minor GC 之前老年代本身还有容纳新生代所有对象的剩余空间。
《深入理解 Java 虚拟机》第三章对于空间分配担保的描述如下:
JDK 6 Update 24 之前,在发生 Minor GC 之前,虚拟机必须先检查老年代最大可用的连续空间是否大于新生代所有对象总空间,如果这个条件成立,那这一次 Minor GC 可以确保是安全的。如果不成立,则虚拟机会先查看 -XX:HandlePromotionFailure 参数的设置值是否允许担保失败(Handle Promotion Failure);如果允许,那会继续检查老年代最大可用的连续空间是否大于历次晋升到老年代对象的平均大小,如果大于,将尝试进行一次 Minor GC,尽管这次 Minor GC 是有风险的;如果小于,或者 -XX: HandlePromotionFailure 设置不允许冒险,那这时就要改为进行一次 Full GC。
JDK 6 Update 24 之后的规则变为只要老年代的连续空间大于新生代对象总大小或者历次晋升的平均大小,就会进行 Minor GC,否则将进行 Full GC。
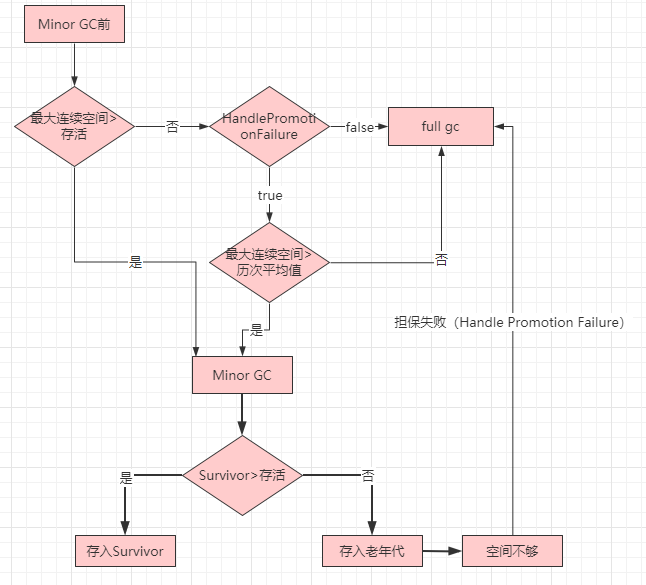
6、死亡对象判断方法(GC 判定垃圾的依据)
堆中几乎放着所有的对象实例,对堆垃圾回收前的第一步就是要判断哪些对象已经死亡(即不能再被任何途径使用的对象)
6.1 引用计数法
给对象中添加一个引用计数器:
- 每当有一个地方引用它,计数器就加 1;
- 当引用失效,计数器就减 1;
- 任何时候计数器为 0 的对象就是不可能再被使用的。很简单的实现内存敏感
这个方法实现简单,效率高,适合内存敏感的场景但是目前主流的虚拟机中并没有选择这个算法来管理内存,其最主要的原因是它很难解决对象之间循环引用的问题。
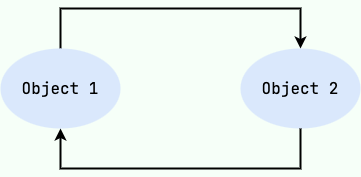
所谓对象之间的相互引用问题,如下面代码所示:除了对象 objA 和 objB 相互引用着对方之外,这两个对象之间再无任何引用。但是他们因为互相引用对方,导致它们的引用计数器都不为 0,于是引用计数算法无法通知 GC 回收器回收他们。
6.2 可达性分析算法
这个算法的基本思想就是通过一系列的称为 “GC Roots” 的对象作为起点,从这些节点开始向下搜索,节点所走过的路径称为引用链,当一个对象到 GC Roots 没有任何引用链相连的话,则证明此对象是不可用的,需要被回收。(利用标记-清除算法 mark-and-sweep)
下图中的 Object 6 ~ Object 10 之间虽有引用关系,但它们到 GC Roots 不可达,因此为需要被回收的对象。
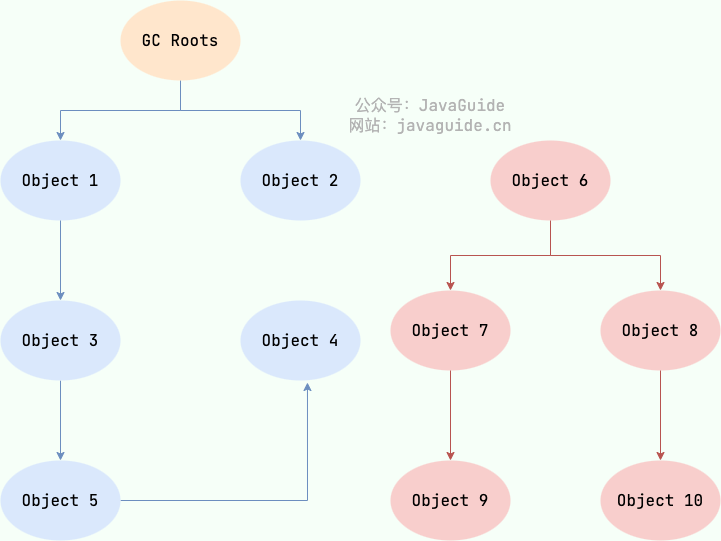
哪些对象可以作为 GC Roots 呢?
- 虚拟机栈(栈帧中的局部变量表)中引用的对象
- 本地方法栈(Native 方法)中引用的对象
- 方法区中类静态属性引用的对象
- 方法区中常量引用的对象
- 所有被同步锁持有的对象
- **JNI(**Java Native Interface)引用的对象
对象可以被回收,就代表一定会被回收吗?
即使在可达性分析法中不可达的对象,也并非是“非死不可”的,这时候它们暂时处于“缓刑阶段”,要真正宣告一个对象死亡,至少要经历两次标记过程;可达性分析法中不可达的对象被第一次标记并且进行一次筛选,筛选的条件是此对象是否有必要执行 finalize 方法。当对象没有覆盖 finalize 方法,或 finalize 方法已经被虚拟机调用过时,虚拟机将这两种情况视为没有必要执行。
被判定为需要执行的对象将会被放在一个队列中进行第二次标记,除非这个对象与引用链上的任何一个对象建立关联,否则就会被真的回收。
Object 类中的 finalize 方法一直被认为是一个糟糕的设计,成为了 Java 语言的负担,影响了 Java 语言的安全和 GC 的性能。JDK9 版本及后续版本中各个类中的 finalize 方法会被逐渐弃用移除。忘掉它的存在吧
对比两种判定算法:引用计数器是消耗平摊在运行中的,计数器也是占少量内存的;循环引用是最后攒着先标记,再一次性清除
小知识点:
Stop The World
"Stop The World"是Java垃圾收集过程中暂停所有用户线程的事件,旨在避免用户线程干扰导致的垃圾收集不准确。虽然这对内存管理有益,但过长的停顿会影响应用性能,特别是对实时性要求高的系统。因此,选择和优化垃圾收集器(如G1、ZGC)以减少"Stop The World"时间,成为提高应用响应性的关键。
如何判断一个常量是废弃常量?
运行时常量池主要回收的是废弃的常量。那么,我们如何判断一个常量是废弃常量呢?答案:没有任何引用。即没有对象引用
如何判断一个类是无用的类?
一个类在满足以下条件时可被视为无用并可能被回收:所有实例已被垃圾回收;加载它的ClassLoader也被回收;且其Class对象不再被任何地方引用。但请注意,即使满足这些条件,该类也不一定会立即被回收。
引用类型总结
强引用,软引用,弱引用,虚引用
强引用是普遍的赋值引用,GC空间不足抛异常也不会回收。软引用****是空间不足,会回收。结合引用队列(ReferenceQueue)联合使用,如果软引用所引用的对象被垃圾回收,JAVA 虚拟机就会把这个软引用加入到与之关联的引用队列中。弱引用,GC一旦发现,不管内存空间是否不足,直接回收。但是可能查不到弱引用对象。虚引用主要用来**跟踪对象被垃圾回收的活动,**必须和引用队列(ReferenceQueue)联合使用。当垃圾回收器准备回收一个对象时,如果发现它还有虚引用,就会在回收对象的内存之前,把这个虚引用加入到与之关联的引用队列中。程序可以通过判断引用队列中是否已经加入了虚引用,来了解被引用的对象是否将要被垃圾回收。程序如果发现某个虚引用已经被加入到引用队列,那么就可以在所引用的对象的内存被回收之前采取必要的行动。
JDK 9 中虚引用对 GC 的影响及后续版本的改进: JDK 9 之前的问题:
- 延迟回收问题:虚引用对象在被垃圾回收时先加入 ReferenceQueue,若未及时处理这些队列中的对象,会导致内存堆积,降低 GC 效率。
- G1 GC 影响:G1 需要追踪虚引用,大量虚引用会加重标记阶段的工作负担,并可能引起额外的暂停(STW)。 JDK 10+ 的优化:
- 并行化处理:通过 JEP 304 引入了对虚引用处理的并行化支持,减少了 STW 时间,提高了 G1 和 ZGC 等现代 GC 的效率。
- 更智能的引用队列管理:增强了 JVM 对 ReferenceQueue 的管理能力,减少了因未处理引用而导致的堆积。
- 针对特定 GC 的优化:
- G1 GC 在 JDK 10 及以后版本中改进了引用处理机制,降低了额外开销。
- ZGC 和 Shenandoah 等低延迟 GC 能够非常高效地处理包括虚引用在内的各种引用类型,几乎不影响性能。
特别注意,在程序设计中一般很少使用弱引用与虚引用,使用软引用的情况较多,这是因为软引用可以加速 JVM 对垃圾内存的回收速度,可以维护系统的运行安全,防止内存溢出(OutOfMemory)等问题的产生。
7、垃圾收集算法
总结:四种算法
标记-清除(Mark-and-Sweep)
复制算法
标记-整理算法
分代收集算法
标记-清除算法
标记-清除(Mark-and-Sweep)算法分为“标记(Mark)”和“清除(Sweep)”阶段:首先标记出所有不需要回收的对象(存活对象),在标记完成后统一回收掉所有没有被标记的对象。
它是最基础的收集算法,后续的算法都是对其不足进行改进得到。这种垃圾收集算法会带来两个明显的问题:
- 效率问题:标记和清除两个过程效率都不高。
- 空间问题:标记清除后会产生大量不连续的内存碎片。
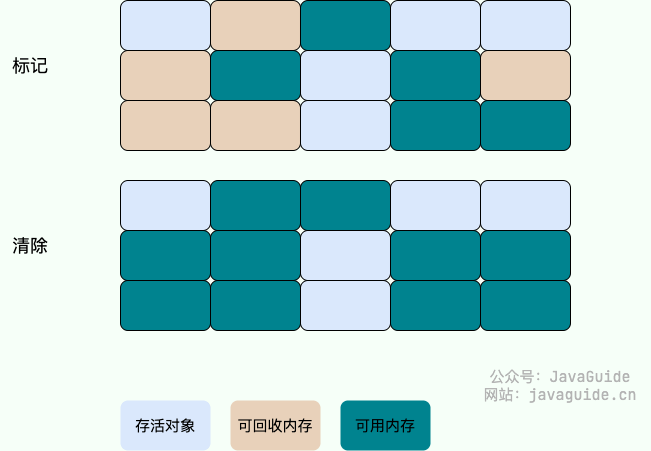
关于具体是标记可回收对象(不可达对象)还是不可回收对象(可达对象),众说纷纭,两种说法其实都没问题,我个人更倾向于是后者。
如果按照前者的理解,整个标记-清除过程大致是这样的:
- 当一个对象被创建时,给一个标记位,假设为 0 (false);
- 在标记阶段,我们将所有可达对象(或用户可以引用的对象)的标记位设置为 1 (true);
- 扫描阶段清除的就是标记位为 0 (false)的对象。
复制算法
为了解决标记-清除算法的效率和内存碎片问题,复制(Copying)收集算法出现了。它可以将内存分为大小相同的两块,每次使用其中的一块。当这一块的内存使用完后,就将还存活的对象复制到另一块去,然后再把使用的空间一次清理掉。这样就使每次的内存回收都是对内存区间的一半进行回收。
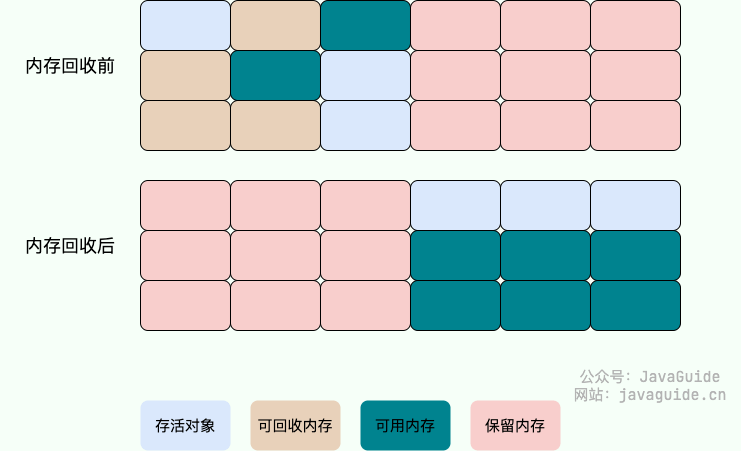
虽然改进了标记-清除算法,但依然存在下面这些问题:
- 可用内存变小:可用内存缩小为原来的一半。
- 不适合老年代:如果存活对象数量比较大,复制性能会变得很差。
标记-整理算法
标记-整理(Mark-and-Compact)算法是根据老年代的特点提出的一种标记算法,标记过程仍然与“标记-清除”算法一样,但后续步骤不是直接对可回收对象回收,而是让所有存活的对象向一端移动,然后直接清理掉端边界以外的内存。
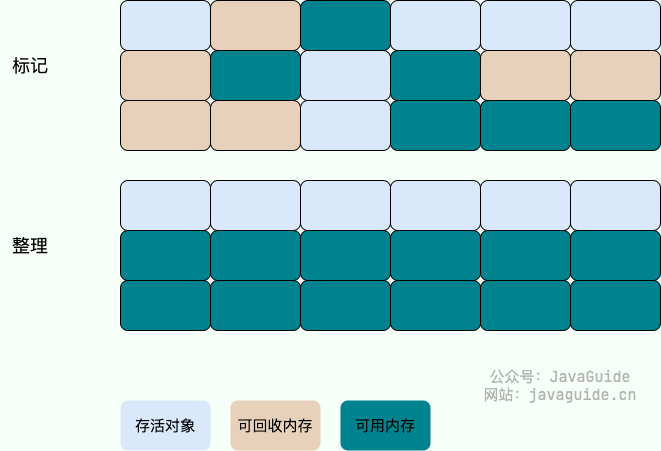
由于多了整理这一步,因此效率也不高,适合老年代这种垃圾回收频率不是很高的场景。
分代收集算法
当前虚拟机的垃圾收集都采用分代收集算法,这种算法没有什么新的思想,只是根据对象存活周期的不同将内存分为几块。一般将 Java 堆分为新生代和老年代,这样我们就可以根据各个年代的特点选择合适的垃圾收集算法。
比如在新生代中,每次收集都会有大量对象死去,所以可以选择“复制”算法,只需要付出少量对象的复制成本就可以完成每次垃圾收集。而老年代的对象存活几率是比较高的,而且没有额外的空间对它进行分配担保,所以我们必须选择“标记-清除”或“标记-整理” 算法进行垃圾收集。
延伸面试问题:
HotSpot 为什么要分为新生代和老年代?
本质上还是提供 GC 回收效率,根据对象的生命周期的不同,新生代对象朝生暮死,可以用复制算法,老年代用标记-清除算法。
为什么新生代分成 Eden 区,S0,S1 区?
为了复制算法的内存效率,如果定义两个区域,每次使用一个,GC 将存活的复制到另外一个区域,这样交替使用,但是缺点就是每次只能使用一半的区域。分成 3 个区动态调整其比例,即提高了 GC 回收效率,又避免了内部碎片
提高 GC 回收效率,大部分对象是朝生暮死的(短生命周期),分配在新生代;少部分对象存活时间长,晋升在老年代。这样根据不同的对象生命周期分配不同的回收算法:新生代使用复制算法,即大部分对象会“死亡”,对小部分存活的对象复制到 survivor 区即可,效率就高了;老年代使用标记-整理算法(少了内部碎片,但是效率降低了)或标记-清除算法(容易产生内部碎片),虽然效率不高,但是老年代回收次数很少的。
8、 什么是三色标记法?
**作用范围:**现在的 CMS 和 G1 垃圾回收器使用的三色标记法。
原理:增量标记法,通过“白-灰-黑”+可达性分析算法(设置 GC Roots 遍历节点,判断垃圾)。个人感觉就是****引用计数法+可达性分析算法的结合
白色对象:没有访问到的对象,可能是垃圾
灰色对象:已经被访问到了,但其引用的对象没有访问(想像成非叶子结点,还没有访问其叶子结点)
黑色对象:已经被访问到了,其引用对象也被访问到了(根+叶子都访问到了)
标记过程:
(类比成 B+树森林,通过一个根去访问一棵树 A;没有访问到的,就是白色对象即其他树;访问到一半的,就是灰色对象,还有下面的子树没遍历到。全部访问到了就是黑色对象。)
优点:
并发执行:GC 回收器和该程序并发执行。只需要简短的 Stop-The-World
避免误回收:通过颜色标记,保证每个对象都遍历过。
(其他的垃圾回收算法的缺点:如可达性分析算法要多次标记,引用计数法无法避免循环引用的问题。)
**效率高:**避免了一次性全量检查的开销。
缺点:
漏标问题(mutaor):
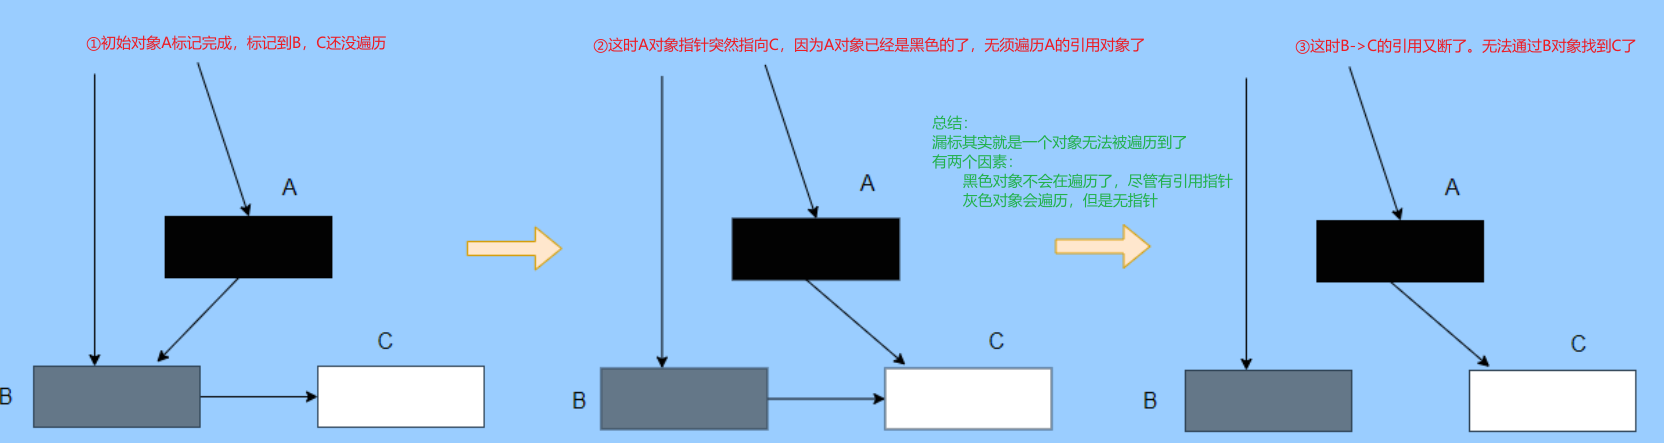
**多标问题:**即对象在标成黑色对象时,上面的父结点把指针断开了,这样这个黑色对象是需要被清除的,但是已经标成黑色了。(没有漏标问题大)
总结:三色标记法的缺点就是在多并发情况下漏标和多标问题(也就是 CMS 和 G1 的问题) 漏标其实就是一个对象无法被遍历到了。有两个因素:黑色对象不会在遍历了,尽管有引用指针。灰色对象会遍历,但是无指针
解决方法很明确:都是指针的改变(肯定就是写操作,利用写屏障)。黑色对象指向白色对象时,利用写屏障,把白色变灰色,这叫增量更新。灰色对象删除白色对象时,利用写屏障,把白色变灰色,保留旧的引用关系(snapshot 快照的意思),这叫 STAB(snapshot-at-the-begining)
多标也是对象的引用问题,是标成黑色对象后,不被引用了,黑色对象又不会被清除。
肯定是漏标严重,因为把漏标的**白色对象可能是一棵大树的 root,**就有很多结点不会被标记了。多标是已经遍历后,再出问题,影响范围可控。
根据上面的对分代收集算法的介绍回答。
9、JVM 的 Thread-Local Allocation Buffer(TLAB 本地线程分配缓存区) 是什么?
JVM 的 TLAB(Thread-Local Allocation Buffer)是什么? - 面试鸭 - 程序员求职面试刷题神器
类比 ThreadLocal 是创建一个本地线程实例,解决多线程下数据对的共享问题;而 TLAB 是 JVM 会为每个线程分配一个“小的堆内存”,优化对象的内存分配,减少多线程下内存竞争问题,提高分配效率。
产生的原因:多并发情况下,多线程都在堆中竞争内存分配指针(内存指针是线性增加的,相当于多线程在抢堆内存的一把锁,)
优化策略:为每个线程都分配一个单独的 TLAB(缓存区)。小的对象没必要“吵”到堆
**”小“是多小呢?**小于堆中 eden 内存,通常是几 KB(没具体数字)
**设置 TLAB 会有内存浪费吗?**会有的,因为申请 TALB 是按照一块一块的申请,会出现内部碎片的
启用和配置
TLAB 默认是开启的,但可以通过 JVM 参数来配置或禁用,
-XX:+UseTLAB:启用TLAB.-XX:-UseTLAB:禁用 TLAB。-XX:TALBSize: 设置每个 TLAB 的初始大小。
10、 什么是 PLAB(Promotion Local AIIocation Buffer 本地晋升缓存区)?
PLAB 是主要用于多线程 G1 垃圾回收器的机制,主要是为了提升对象晋升(Promotion)到老年代的效率。
问题来源:在多线程情况下,执行 yong GC 会出现很多对象晋升成老年代。还是因为内存分配是依靠指针加法(一个指针增加到高地址,在多线程的情况下,就跟争抢一把锁一样,这个和 TLAB 一样的原因),这个会导致效率降低。
解决方法:申请多个小的区域嘛,那个线程要用,自己去拿,变成并发执行。即从老年代区域申请一块空间(就是 PLAB),某个线程在这块小空间内通过指针加法分配内存,在多线程的情况下,由原来的多线程->多块内存空间,变成多线程->多块内存空间,自然效率上去了
相关参数:
-XX:PLABSize:设置 PLAB 的大小。-XX:+ResizePLAB:允许 JVM 动态调整 PLAB 大小(默认开启)-XX:G1PLABMasterPercent=10(默认值可修改)定义 PLAB 空间中可容忍的浪费百分比。
PS:什么是指针加法(Bump the Pointer)?其实就是内存的顺序分配
11、垃圾收集器:
单词补充:
并行(Parallel),并发(Concurrent)
如果说收集算法是内存回收的方法论,那么垃圾收集器就是内存回收的具体实现。
垃圾收集器是内存回收的具体实现,不同应用场景需选择适合的收集器。不存在完美的垃圾收集器,因此HotSpot虚拟机提供了多种选择。JDK 8默认使用Parallel Scavenge(新生代)+ Parallel Old(老年代),而JDK 9至22则默认使用G1。
这里的实现垃圾回收器要注意:新生代合老生代的垃圾回收器都是不一样的策略。所以有:
- Serial(串行)收集器:串行,用在新生代上
- Serial old :串行的老生代版本
- ParNew 收集器: Serial 收集器+多线程版本
- Parallel Scavenge 收集器:
- Parallel Old 收集器:Parallel Scavenge 收集器的老年代版本。
- CMS(Concurrent Mark Sweep)收集器
- G1 (Garbage-First)
- ZGC 收集器
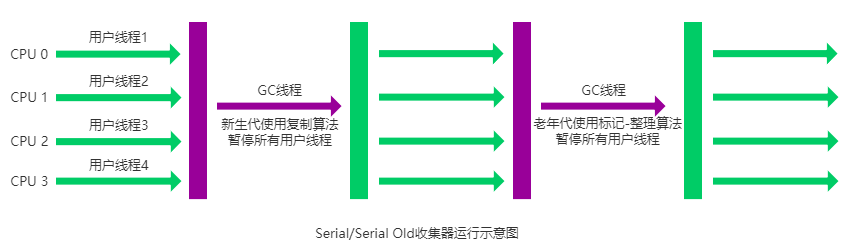
Serial 收集器
Serial(串行)收集器是最基本的单线程垃圾收集器,使用标记-复制算法处理新生代,标记-整理算法处理老年代。其工作时会暂停所有其他线程("Stop The World")。尽管这带来了不好的用户体验,但Serial收集器简单高效,特别适合运行在Client模式下的虚拟机。
新生代采用标记-复制算法+Serial收集器,老年代采用标记-整理算法+Serial old收集器。
ParNew 收集器(Serial+多线程)
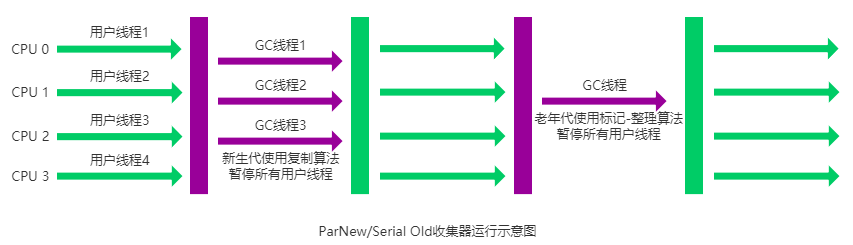
ParNew收集器是Serial收集器的多线程版本,除了使用多线程外,其他如控制参数、算法等与Serial相同。是许多Server模式下虚拟机的首选,并且能够与CMS收集器配合工作。
它在新生代使用标记-复制算法**+ParNew收集器,在老年代使用标记-整理算法+**Serial old收集器,
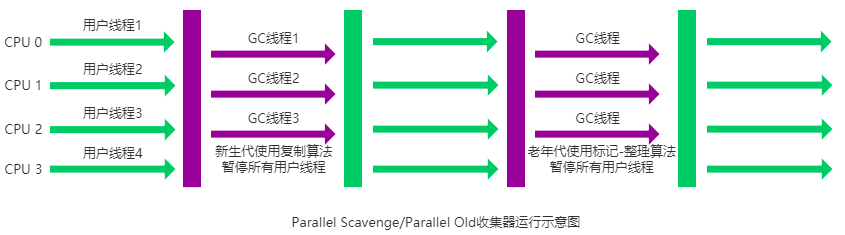
Parallel Scavenge 收集器
Parallel Scavenge 收集器是多线程的,使用标记-复制算法,专注于提高吞吐量(CPU利用率)。它与ParNew类似,但更注重于通过自适应调节策略优化内存管理。JDK1.8默认采用Parallel Scavenge + Parallel Old组合。
新生代采用标记-复制算法+Parallel Scavenge 收集器,老年代采用标记-整理算法+Serial old收集器。
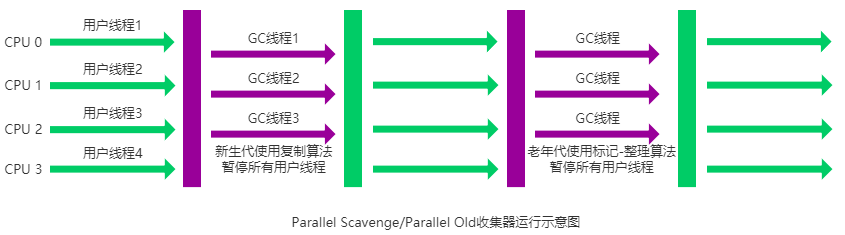
可通过-XX:+UseParallelGC启用Parallel收集器搭配老年代串行处理,
或使用-XX:+UseParallelOldGC实现老年代并行处理。
该收集器适合对停顿时间不太敏感而追求高效率的应用场景。
-XX:+UseParallelGC
使用 Parallel 收集器+ 老年代串行
-XX:+UseParallelOldGC
使用 Parallel 收集器+ 老年代并行使用 Parallel Scavenge 收集器配合自适应调节策略,把内存管理优化交给虚拟机去完成也是一个不错的选择。
这是 JDK1.8 默认收集器
使用 java -XX:+PrintCommandLineFlags -version 命令查看
-XX:InitialHeapSize=262921408 -XX:MaxHeapSize=4206742528 -XX:+PrintCommandLineFlags -XX:+UseCompressedClassPointers -XX:+UseCompressedOops -XX:+UseParallelGC
java version "1.8.0_211"
Java(TM) SE Runtime Environment (build 1.8.0_211-b12)
Java HotSpot(TM) 64-Bit Server VM (build 25.211-b12, mixed mode)JDK1.8 默认使用的是 Parallel Scavenge + Parallel Old,如果指定了-XX:+UseParallelGC 参数,则默认指定了-XX:+UseParallelOldGC,可以使用-XX:-UseParallelOldGC 来禁用该功能
Serial Old 收集器
Serial 收集器的老年代版本是单线程收集器,主要用于JDK1.5及之前与Parallel Scavenge收集器搭配使用,或作为CMS收集器的后备方案。
Parallel Old 收集器
Parallel Scavenge 收集器的老年代版本。使用**多线程和“标记-整理”**算法。在注重吞吐量以及 CPU 资源的场合,都可以优先考虑 Parallel Scavenge 收集器和 Parallel Old 收集器。
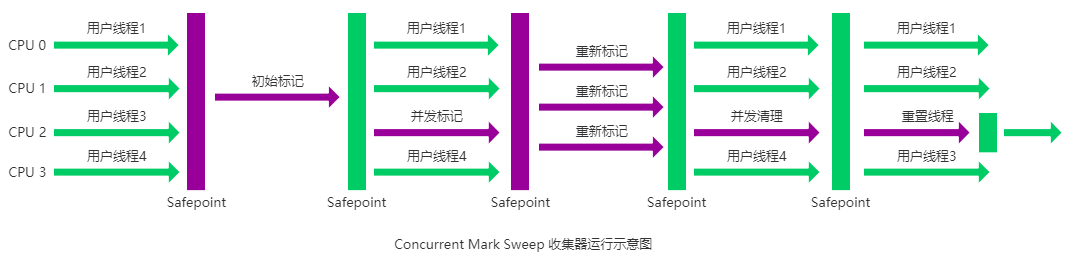
CMS 收集器(并行标记清除)
**CMS(Concurrent Mark Sweep)收集器旨在最小化垃圾回收停顿时间,适合注重用户体验的应用。作为HotSpot虚拟机首款真正并发的收集器,它允许垃圾收集线程与用户线程基本上同时运行。基于“标记-清除”算法,**整个过程分为四个步骤:
- 初始标记: 短暂停顿,标记直接与 root 相连的对象(根对象);
- 并发标记: 同时开启 GC 和用户线程(不停程序),标记 GC Roots 开始所有可达对象
- 重新标记: 短暂停顿,(完成所有需要标记的对象)重新标记阶段就是为了修正并发标记期间因为用户程序继续运行而导致标记产生变动的那一部分对象的标记记录,这个阶段的停顿时间一般会比初始标记阶段的时间稍长,远远比并发标记阶段时间短
- 并发清除: 不停程序,开启用户线程,清理所有没标记的对象
CMS 过程有四个阶段,初始标记:停顿一下,并发标记,线程和 GC 并发进行,由于线程会不断更新引用域,GC 更新肯定是不到位的。重新标记,GC 修正并发标记阶段线程修改的引用域。这个时间比初始标记时间长,比并发标记时间短。最后进行并发清除,重新开启线程和 GC 并行,GC 进行清除。
CMS垃圾回收器优点是并发收集和低停顿,但存在对CPU资源敏感、无法处理浮动垃圾、产生大量空间碎片的问题。它在Java 9中被标记为过时,并于Java 14中移除。
CMS 并发清理两个关键限制为:
① 内存碎片化:本质还是使用标记 -清除(mark-sweep)算法,不会压缩内存,导致内存碎片
② 并发清理时内存分配不行:并发清理,可以理解为一边加入对象,一边清除对象。这个很容易碰到一个大对象而加不进去的情况。即Concurrent mode failure
这时只能立刻进行一次完全停顿的兜底方案 Full GC 来回收内存(这也是为什么 Full GC 是单线程的原因,但是大部分原因是开发保守使用的是 serial old 并不是 parallel old 同时还有早期使用parallel old 需要加很多兼容性问题 )
Concurrent mode failure 并行模块失败:
这个是因为在最后一个阶段“并发清除”阶段,发现老年区内存不足,无法重新循环阶段和传入新对象。(其实这个错误的本质就是“Major GC”清不干净(CMS 是并发标记清除而已)然后退化成 Full GC)
解决方法(和 Major GC 无奈退化成 Full GC 的解决方法差不多,只是在 CMS 场景下具体进行):
① 增大老年代内存大小(无直接调整大小的参数,可以通过设置堆大小和 yong 和 old 区域的比例间接调整)
② 整理内部碎片 -XX:+UseCMSCompactAtFullCollection \
③ 修改触发 major GC 的阈值:当老年代的内存阈值>95%时,触发垃圾回收(一般触发 major GC)。 -XX:CMSInitiatingOccupancyFraction=70 \
④ 增加 yong old 内存大小。-Xmx4g -Xms4g YourApplication
⑤CMS 在 JDK9 已经停用了,JDK14 移除了。 换 G1 吧,大哥,过时的人还想这么多解决方法。
CMS 和 G1 在记忆集维护上有什么不同?(CMS 和 G1 的区别?为什么 G1 比 CMS 强)
上面提到过 CMS 并发清理有两大关键问题:标记 -清除算法导致的内存碎片化问题;并发导致的 GC 清除不干净(本质是线程中对象在引用变化,类比三色标记法的漏标和多标问题,CMS 是使用写屏障来解决)
G1 比 CMS 强,具体在整体使用标记-复制算法(几乎不产生内部碎片),从局部上看是标记-整理算法;以及在并发环境下维护了****优先级列表,可以细化到区域(Region)然后选择高优先级的 Region 进行回收;手动控制最大停顿时间,这样又降低停顿问题
下面从 GC 回收器在并发上的不同机制详细解释:
- CMS 使用卡表(Card Table 记忆集的一种实现),来记录并发环境下老年代引用新生对象并触发写屏障,标记成“脏卡”如果 GC 去重新扫描。这里只找老对象的引出(在记忆集中叫 points-out)。缺点就是不细,复杂结构回收不了,
- G1 使用的记忆集(本质是 hashtable),粒度更细(划分成区域 Region)并记录了各区域的关系(在记忆集中交 points-into),即 Region 知道自己的指针,以及 region 之间的相互引用。(?理解为图的数据结构)。优点就是细+优先级的结构回收高效。缺点就是复杂度上去了。后面使用 logging write Barrier(日志写屏障,就是并发写屏障),避免了单线程写屏障的时间消耗。
- Region 的优势:CMS 是用分代划分的。而 G1 使用 Region 逻辑隔离。有大对象区域(Humongous Region),优化了大对象的存入导致的碎片。
PS: 写屏障write Barrier和日志写屏障logging write Barrier有什么区别?
本质上日志写屏障是写屏障的具体实现。写屏障在 GC 中发生引用修改然后执行必要操作,是单线程。日志写屏障,将修改写入日志,再启用其他线程并发+批量处理引用变化。
总结:这个点可以作为 G1 为什么好的原因?还是从算法选择+并发机制说,G1 并发使用 Region +优先级列表+日志写屏障+标记-复制算法 .CMS 使用分代+标记-清除算法
参数含义
-XX:NewRatio:控制年轻代与老年代的比例。
-XX:SurvivorRatio:设置Eden区与Survivor区的比例,影响对象在年轻代中的存活情况。
-XX:CMSInitiating0ccupancyFraction:指定老年代达到此值时启动CMS回收。怎么调阈值,然后继续 major GC
-XX:CMSMaxAbortablePrecleanTime:设置CMS预清理阶段的最大时间,以防止过长的停顿。
-XX:+UsecMsInitiatingOccupancyonly:仅根据 cMSInitiating0ccupancyFraction 进行CMS回收,不在其它情况下触发。
G1
G1 (Garbage-First) 是一款面向服务器的垃圾收集器,主要针对配备多颗处理器及大容量内存的机器. 以极高概率满足 GC 停顿时间要求的同时,还具备高吞吐量性能特征。
被视为 JDK1.7 中 HotSpot 虚拟机的一个重要进化特征。它具备以下特点:
G1收集器通过并行和并发利用多核硬件优势减少停顿(STW)时间,支持分代收集,并采用“标记-整理”与“标记-复制”算法实现空间整合。此外,G1能够建立可预测的停顿时间模型,允许用户设定垃圾收集的时间限制。
G1 收集器的运作大致分为以下几个步骤:
- 初始标记: 短暂停顿(Stop-The-World,STW),标记从 GC Roots 可直接引用的对象,即标记所有直接可达的活跃对象
- 并发标记:与应用并发运行,标记所有可达对象。 这一阶段可能持续较长时间,取决于堆的大小和对象的数量。
- 最终标记: 短暂停顿(STW),处理并发标记阶段结束后残留的少量未处理的引用变更。
- 筛选回收:根据标记结果,选择回收价值高的区域,复制存活对象到新区域,回收旧区域内存。这一阶段包含一个或多个停顿(STW),具体取决于回收的复杂度。
- 筛选回收阶段的具体步骤:
1.计算每个Region存活对象和回收比例
2.根据存活对象和回收比例,G1会对所有Region进行排序,排序的依据通常是回收价值,即回收比例高,存活对象少的Region会被优先回收
3.排序完成后,G1会根据用户设定的GC停顿时间目标(如-X%:MaxGcpauseMilis),选择一定数量的Region进行回收。这些Recion构成了本次垃圾回收的回收集(Colection set)
4.复制存活对象(标记-复制算法的复制部分)
对于回收集中的每个Region,G1会将其中的存活对象复制到空闲的Region中,以减少内存碎片
5**.复制完成后**,G1会释放原Reqion中的空间,并将其标记为空闲,以便后续使用
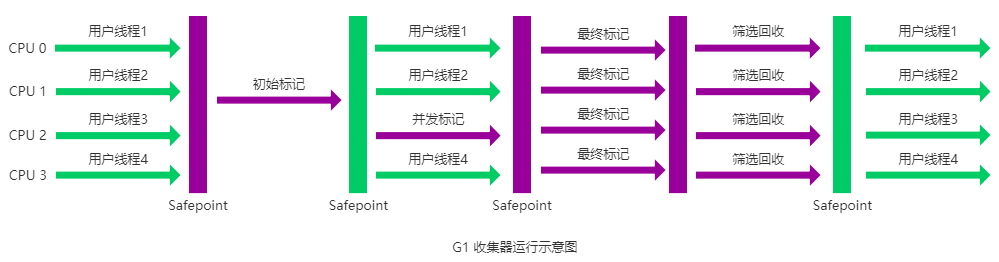
ps:根据算法(标记-赋值)+Region 区域(不是严格的按照分代来划分区域了)+优先列表来讲
G1 收集器在后台维护了一个优先列表,每次根据允许的收集时间,优先选择回收价值最大的 Region(这也就是它的名字 Garbage-First 的由来) 。这种使用 Region 划分内存空间以及有优先级的区域回收方式,保证了 G1 收集器在有限时间内可以尽可能高的收集效率(把内存化整为零)。
从 JDK9 开始,G1 垃圾收集器成为了默认的垃圾收集器。
G1 垃圾回收器调优参数
1)最大停顿时间:
使用参数 -XX:maxGcpausemi11is=<N>设置希望的最大停顿时间(毫秒)。G1 会尽量在这个时间范围内完成垃圾回收,以满足响应时间要求。
2)堆区域大小:
通过 -XX:G1HeapRegionsize=<size>设置每个区域的大小。合适的区域大小可以影响回收效率,通常选择的大小为1MB、2MB 或 4MB。
3)保留比例:
使用 -XX:G1ReservePercent=<percentage>设置 G1的保留比例,指的是保留未分配的堆内存的百分比,以避免频繁的 Fu GC
4)年轻代占比:
通过 -XX:G1NewsizePercent=<percentage>和-XX:G1maxdiemsizePercent=<percentage>设置年轻代的最小和最大占比,控制新生代的大小,影响年轻代的回收频率和效率。
5)并发线程数:
使用-XX:G1concMarkThreads=<N>设置并发标记阶段使用的线程数量。增加线程数可以提高标记速度,适合多核处理器。
6)启用混合回收:
使用参数-XX:G1Mixed6cliveThresholdpercent=<percentage>设置活跃对象在区域回收中的阈值,以决定哪些区域进行混合回收
为什么 G1 不使用 major GC 收集老年代的区域?而使用 yong GC 和 Full GC?
这里从分代的 GC 算法说,是不符合 G1 和 CMS 的特点(虽然还是按分代划分内存),但是多并发的情况下,使用记忆集来非收集区域(非自己 Root 根下的)和收集区域(自己 Root 根下的)的引用情况。特别是在 G1 使用 region 区域+优先队列+日志读屏障+标记-复制算法的策略。本质上是没有具体区分老年代和新生代的,而且使用 yong GC 和 Full GC 都可以回收到这两个代,没有必要再使用 major GC 回收新生代和老年代的跨引用。
ZGC 收集器
ZGC 的目标就是多并发+减少停顿 STW。与 CMS 中的 ParNew 和 G1 类似,ZGC 也采用标记-复制算法,不过 ZGC 对该算法做了重大改进。
ZGC 可以将暂停时间控制在几毫秒以内,且暂停时间不受堆内存大小的影响,出现 Stop The World 的情况会更少,但代价是牺牲了一些吞吐量。ZGC 最大支持 16TB 的堆内存。
ZGC 在 Java11 中引入,处于试验阶段。经过多个版本的迭代,不断的完善和修复问题,ZGC 在 Java15 已经可以正式使用了。
不过,默认的垃圾回收器依然是 G1。你可以通过下面的参数启用 ZGC:
java -XX:+UseZGC className在 Java21 中,引入了分代 ZGC,暂停时间可以缩短到 1 毫秒以内。
你可以通过下面的参数启用分代 ZGC:
java -XX:+UseZGC -XX:+ZGenerational classNameZGC 做的优点:
指针染色体:从 64 位指针中,拿出几位做标识对象。(指针压缩)
读屏障:是在读取的时候进行检查,然后并发转移对象(并发收集)。写屏障在操作时就要 STW 停一下
STAB: STAB(snapshot-at-the-begining)解决漏标问题的
关于 ZGC 收集器的详细介绍推荐看看这几篇文章:
八、常见的 JVM 配置参数:
-X:表示这是一个 非标准选项
ms:是 Memory Startup 的缩写,直接关联到初始堆内存
冒号:分隔符,用于分隔选项类型和具体操作(启用/禁用/赋值)。有些选项可能需要赋值,比如-XX:MaxHeapSize=512m,这时候用冒号来分隔选项名和值。
-XX:表示这是一个 JVM 的“高级选项”,通常用于调优或调试
+/-号:启用/禁用某个功能。布尔类型的选项则用+或-来开关,其他类型则是冒号后面跟着A=B这种
配置堆内存大小的参数有哪些?
-Xms:初始堆大小,如-Xms512m-Xmx:最大堆大小-XX:NewSize=n:设置年轻代大小-XX:NewRatio=n:设置年轻代和年老代的比值。如:n 为 3 表示年轻代和年老代比值为 1:3,即占75%,年轻代占总和的 1/4-XX:SurvivorRatio=n:年轻代中 Eden 区与两个 Survivor 区的比值。如 n=3 表示 Eden 占 3 Survivor 占 2,一个 Survivor 区占整个年轻代的 1/5
配置 GC 收集器的参数有哪些?
-XX:+UseSerialGC:设置串行收集器-XX:+UseParallelGC:设置并行收集器-XX:+UseParalledlOldGC:设置并行老年代收集器-XX:+UseConcMarkSweepGC:设置并发收集器
配置并行收集的参数有哪些?
-XX:MaxGCPauseMillis=n:设置最大垃圾回收停顿时间-XX:GCTimeRatio=n:设置垃圾回收时间占程序运行时间的比例-XX:+CMSIncrementalMode:设置增量模式,适合单 CPU 环境-XX:ParallelGCThreads=n:设置并行收集器的线程数
打印 GC 回收的过程日志信息的参数有哪些?
-XX:+PrintGC:输出 GC 日志-XX:+PrintGCDetails:输出 GC 详细日志-XX:+PrintGCTimeStamps:输出 GC 的时间戳(以基准时间的形式)-Xloggc:filename:日志文件的输出路径