
一、集合框架(java数据结构的集合接口)
定义:用于存储数据的容器。
集合框架是为表示和操作集合统一的标准的体系结构
集合框架包含三大块内容:
对外的接口、
接口的实现
对集合运算的算法。
接口:表示集合的抽象数据类型。接口允许我们操作集合时不必关注具体实现,从而达到“多态”。在面向对象编程语言中,接口通常用来形成规范。(所以说集合是接口,而接口又是抽象方法,所以要利用多态来使用)
实现:集合接口的具体实现,是重用性很高的数据结构。
算法:在一个实现了某个集合框架中的接口的对象身上完成某种有用的计算的方法,例如查找、排序等。这些算法通常是多态的,因为相同的方法可以在同一个接口被多个类实现时有不同的表现。事实上,算法是可复用的函数。它减少了程序设计的辛劳。
集合当中存储的都是java对象的内存地址。(或者说集合中存储的是引用。)
java.util.*; 所有的集合类和集合接口都在java.util包下
在API文档中可以看到Collection这个超级接口并且继承Iterable(迭代接口,父接口)
特点
- 对象封装数据,对象多了也需要存储。集合用于存储对象。
- 对象的个数确定可以使用数组,对象的个数不确定的可以用集合。因为集合是可变长度的。
集合和数组的区别
- 数组是固定长度的;集合可变长度的。
- 数组可以存储基本数据类型,也可以存储引用数据类型;集合只能存储引用数据类型。
- 数组存储的元素必须是同一个数据类型;集合存储的对象可以是不同数据类型。
数据结构:就是容器中存储数据的方式。
对于集合容器,有很多种。因为每一个容器的自身特点不同,其实原理在于每个容器的内部数据结构不同。
集合容器在不断向上抽取过程中,出现了集合体系。在使用一个体系的原则:参阅顶层内容。建立底层对象。
使用集合框架的好处
- 容量自增长;
- 提供了高性能的数据结构和算法,使编码更轻松,提高了程序速度和质量;
- 允许不同 API 之间的互操作,API之间可以来回传递集合;
- 可以方便地扩展或改写集合,提高代码复用性和可操作性。
- 通过使用JDK自带的集合类,可以降低代码维护和学习新API成本。
1.Collection接口
所有集合类都位于java.util包下。Java的集合类主要由两个接口派生而出:Collection和Map,Collection和Map是Java集合框架的根接口,这两个接口又包含了一些子接口或实现类。
- Collection一次存一个元素,是单列集合;这一类集合中超级父接口:java.util.Collection;
- Map一次存一对元素,是双列集合。Map存储的一对元素:键–值,**键(key)与值(value)间有对应(映射)关系。**这一类集合中超级父接口:java.util.Map;
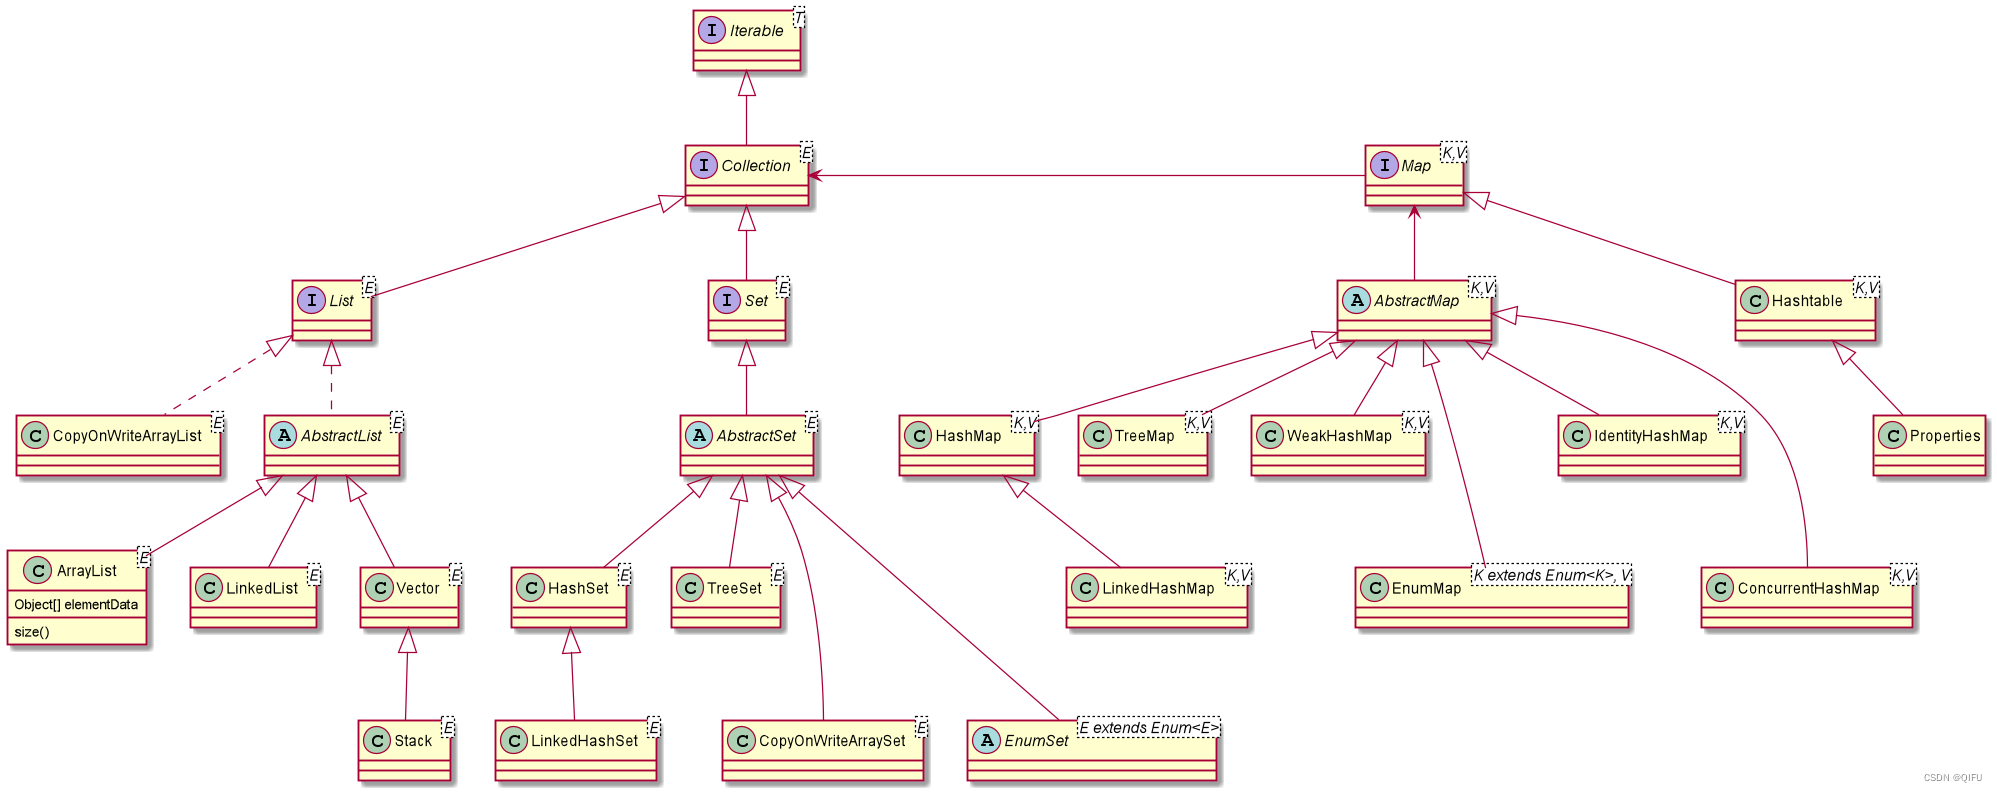
实现类特征总结
List接口下:
- ArrayList:底层是数组
- LinkedList:底层是双向链表
- Vector:底层是数组,线程安全的,效率低,使用较少
Set接口下:
- HashSet:底层是HashMap,放到HashSet集合中的元素等同于放到HashMap集合key部分了
- TreeSet:底层是TreeMap,放到TreeSet集合中的元素等同于放到TreeMap集合key部分了
Map接口下:
- HashMap:底层是哈希表。
- Hashtable:底层是哈希表,线程安全的,效率低,使用较少
- Properties:线程安全的,并且key和value只能存储字符串String
- TreeMap:底层是二叉树。TreeMap集合的key可以自动按照大小顺序排序
下面介绍Collection接口的细节:
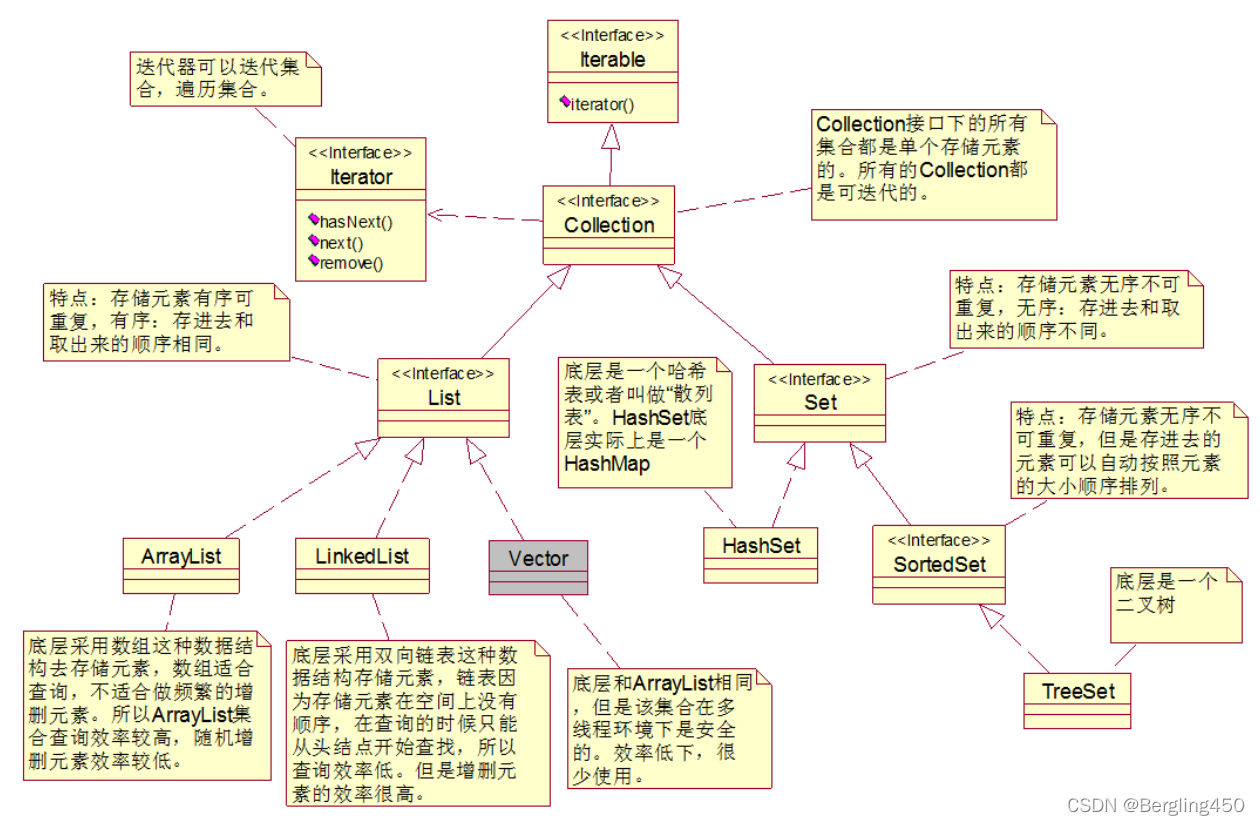
Collection下的单列集合(List集合,Set集合):
List集合存储元素的特点: 有序可重复
解释:
TEXT有序:存进去的顺序和取出的顺序相同,每一个元素都有下标。 可重复:存进去1 ,可以再存储一个1
Set(Map)集合存储的特点:无序不可重复
解释:
无序:存进的顺序和取出的顺序不一定相同。另外Set集合中元素没有下标
不可重复:存进去1,不能再存储1了
Set中比较特殊的集合:
SortedSet(SortMap)集合存储的特点:首先是无序不可重复的,但SortedSet集合中元素是可以排序的
解释:可排序:可以按照大小顺序排列。
Map集合:
Map集合的key就是一个Set集合。
往Set集合中放数据,实际上放到了Map集合的key部分。
Collection接口方法()
(1)Collection 接口是List、Set和Queue接口的父接口,该接口里定义的方法既可用于操作Set集合,也可用于操作List和Queue集合。
(2)JDK不提供此接口的任何直接实现,只提供更具体的子接口(如:Set和List实现)。
(3)在Java5之前,Java集合会丢失容器中所有对象的数据类型,把所有对象都当成Object类型处理;从JDK5.0增加了泛型之后,Java集合可以记住容器中对象的数据类型。
(1)添加
- add(Object obj)
// 创建一个集合对象
//Collection c = new Collection(); // 接口是抽象的,无法实例化。
// 多态
Collection c = new ArrayList();
// 测试Collection接口中的常用方法
c.add(1200); // 自动装箱(java5的新特性。),实际上是放进去了一个对象的内存地址。Integer x = new Integer(1200);
c.add(3.14); // 自动装箱
c.add(new Object());
c.add(new Student());
c.add(true); // 自动装箱
// 获取集合中元素的个数
System.out.println("集合中元素个数是:" + c.size()); // 5- addAll(Collection coll)
//批量添加,也就是添加集合
Collection<String> c1 = new ArrayList<>();
c1.add('java1');
c1.add('java2');
c1.add('java3');
Collection<String> c2 = new ArrayList<>();
c2.add('java4');
c2.add('java5');
c2.add('java6');
c1.addAll(c2)
//结果:[java1,java2,java3,java4,java5,java6](2)获取有效元素的个数
int size()
(3)清空集合
void clear()
// 清空集合
c.clear();
System.out.println("集合中元素个数是:" + c.size()); // 0(4)是否是空集合
boolean isEmpty() :集合为空为ture
(5)是否包含某个元素
boolean contains(Object obj):是通过元素的equals方法来判断是否是同一个对象。
boolean containsAll(Collection coll):也是调用元素的equals方法来比较的。拿两个集合的元素挨个比较。
(6)删除
boolean remove(Object obj):通过元素的equals方法来判断是都是要删除的那个元素。只会删除找到的第一个元素。
boolean removeAll(Collection coll):取当前集合的差集。
(7)取两个集合的交集
boolean retainAll(Collection coll):把交集的结果存在当前集合中,不影响coll。
(8)集合是否相等
boolean equals(Object obj)
(9)转成对象数组
Object[] toArray()
(10)获取集合对象的哈希值
hashCode()
(11)遍历
iterator():返回迭代器对象,用于集合遍历。
==遍历器怎么用呢?==
2.Iterator接口(迭代器)
Iterator接口,用于遍历集合元素的接口。
在Iterator接口中定义了三个方法:
| 修饰与类型 | 方法与描述 |
|---|---|
boolean |
hasNext() 如果仍有元素可以迭代,则返回true。(很像IsEmpty()) |
E |
next() 获取当前元素的值,并返回迭代的下一个元素的地址。 |
void |
remove() 从迭代器指向的 collection 中移除迭代器返回的最后一个元素(可选操作)。 |
每一个集合都有自己的数据结构(就是容器中存储数据的方式),都有特定的取出自己内部元素的方式。为了便于操作所有的容器,取出元素。将容器内部的取出方式按照一个统一的规则向外提供,这个规则就是Iterator接口,使得对容器的遍历操作与其具体的底层实现相隔离,达到解耦的效果。
也就说,只要通过该接口就可以取出Collection集合中的元素,至于每一个具体的容器依据自己的数据结构,如何实现的具体取出细节,
这个不用关心,这样就降低了取出元素和具体集合的耦合性。
【注意】:以下的遍历方式/迭代方式,是所有Collection通用的一种方式。
在Map集合中不能用。在所有的Collection以及子类中使用。
使用
//第一步:获取集合对象的迭代器对象Iterator
Iterator it = c.iterator();
//第二步:通过以上获取的迭代器对象开始迭代/遍历集合。
while(it.hasNext()){
Object obj = it.next();//不管你当初存进去什么,取出来统一都是Object。
System.out.println(obj);
}使用迭代器遍历集合元素
public static void main(String[] args) {
List<String> list1 = new ArrayList<>();
list1.add("abc0");
list1.add("abc1");
list1.add("abc2");
// while循环方式遍历
//获取迭代器对象
Iterator it1 = list1.iterator();
//判断集合是否为空
while (it1.hasNext()) {
System.out.println(it1.next());
}
// foreach循环方式遍历
for (Iterator it2 = list1.iterator(); it2.hasNext(); ) {
System.out.println(it2.next());
}
}使用foreach循环遍历集合元素
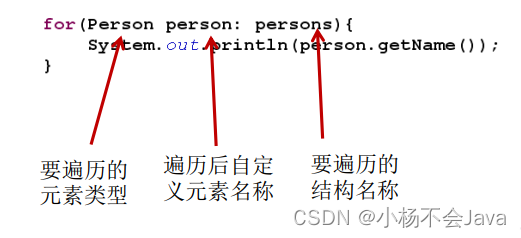
(1)Java5.0提供了foreach循环迭代访问Collection和数组。
(2)遍历操作不需获取Collection或数组的长度,无需使用索引访问元素。
(3)遍历集合的底层调用Iterator完成操作。
(4)foreach还可以用来遍历数组。
注意事项
1.迭代器初始位置并没有指向元素(类似栈中的栈帧的初始位置为int index = -1;一样)
2.:在调用it.next()方法之前必须要调用it.hasNext()进行检测。若不调用,且下一条记录无效,直接调用it.next()会抛
出’NoSuchElementException异常.
3.Iterator可以删除集合的元素,但是是遍历过程中通过迭代器对象的remove方法,不是集合对象的remove方法
4.如果还未调用next()或在上一次调用naxt方法之后已经调用了remove方法,再调用remove 都会报IllegalStateException。
5.当集合的结构发生改变时,迭代器必须重新获取,如果还是用以前老的迭代器,会出现异常java.util.ConcurrentModificationException
public class CollectionTest{
public static void main(String[] args){
List<String> list = new ArrayList<>();
list.add("wang1");
list.add("wang2");
list.add("wang3");
list.add("wangming4");
}
//使用迭代器遍历来删除(删除的方法是list集合自带的remove方法)
Iterator<String> it = list.iterator();
while(it.hasNext()){
String name = it.next();
if(name.contains("ming"))
list.remove(name);
}
//list集合自带的remove方法在删除时,集合元素-1,下标为3的元素变成下标为2的元素,但是迭代器会i++,这样这个下标为2元素就没遍历到
}6.在迭代元素的过程当中,一定要使用迭代器Iterator的remove方法,删除元素,不要使用集合自带的remove方法删除元素。会出现:java.util.ConcurrentModificationException(并发异常)
//使用迭代器遍历来删除(删除的方法是list集合自带的remove方法)
Iterator<String> it = list.iterator();
while(it.hasNext()){
String name = it.next();
if(name.contains("ming"))
it.remove(name);//使用迭代器自带的删除方法
}
7.使用Iterator迭代器进行删除集合元素,则不会出现并发修改异常。
因为:在执行remove操作时,同样先执行checkForComodification(),然后会执行ArrayList的remove()方法,该方法会将modCount值
加1,这里我们将expectedModCount=modCount,使之保持统一。
注意:使用增强for循环来遍历删除元素,没有办法解决并发修改异常,因为增强for循环没有迭代器的remove方法,也无法调用。
同理forEach的lambda表达式也是一样的。
怎么保证遍历集合同时删除数据时不出bug?
使用迭代器遍历集合,但用迭代器自己的删除方法删除数据即可
如果能用for循环遍历时:可以倒着遍历并删除;或者从前往后遍历,但删除元素后做i --操作。
使用lambda表达式遍历iterator迭代器
ava 8 为 Iterator 引入了一个 forEachRemaining(Consumer action) 默认方法,该方法所需的 Consumer 参数同样也是函数式接口。当
程序调用 Iterator 的 forEachRemaining(Consumer action) 遍历集合元素时,程序会依次将集合元素传给 Consumer 的 accept(T t) 方
法(该接口中唯一的抽象方法)。
java.util.function 中的 Function、Supplier、Consumer、Predicate和其他函数式接口被广泛用在支持 Lambda 表达式的 API 中。“void accept(T t);”是 Consumer的核心方法,用来对给定的参数 T 执行定义操作。
如下程序示范了使用 Lambda 表达式来遍历集合元素。
public class collection_API {
public static void main(String[] args) {
//创建一个集合
Collection objs=new HashSet();
objs.add("111");
objs.add("222");
objs.add("333");
objs.add("444");
objs.add("555");
// 获取objs集合对应的迭代器
Iterator it = objs.iterator();
// 使用Lambda表达式(目标类型是Comsumer)来遍历集合元素
it.forEachRemaining(new Consumer() {
@Override
public void accept(Object o) {
System.out.println(o);
}
});
//简化为方法引用
//it.forEachRemaining(System.out::println);
//简化为lambda表达式
//it.forEachRemaining(o -> System.out.println(o));
}
}结果:
111 222 333 444 555
3.ListIterator接口
ListIterator是一个功能更加强大的迭代器, 它继承于Iterator接口,只能用于各种List类型的访问。可以通过调用listIterator()方法产生一个指向List开始处的ListIterator, 还可以调用listIterator(n)方法创建一个一开始就指向列表索引为n的元素处的ListIterator。
特点
- 允许我们向前、向后两个方向遍历 List;
- 在遍历时修改 List 的元素;
- 遍历时获取迭代器当前游标所在位置。
常用API
| 修饰与类型 | 方法与描述 |
|---|---|
void |
add(E e) 将指定的元素插入到列表 (可选操作)。 |
boolean |
hasNext() 如果此列表迭代器在前进方向还有更多的元素时,返回 true。 |
boolean |
hasPrevious() 如果此列表迭代器在相反方向还有更多的元素时,返回 true。 |
E |
next() 返回列表中的下一个元素和光标的位置向后推进。 |
int |
nextIndex() 返回调用 next()后返回的元素索引。 |
E |
previous() 返回列表中的上一个元素和光标的位置向前移动。 |
int |
previousIndex() 返回调用previous() 后返回的元素索引 。 |
void |
remove() 删除列表中调用next()或previous()的返回最后一个元素。 |
void |
set(E e) 用指定元素替换列表中调用next()或previous()的返回最后一个元素。 |
==前提:==
Collection集合主要有List和Set两大接口
- List:有序(元素存入集合的顺序和取出的顺序一致),元素都有索引。元素可以重复。
- Set:无序(存入和取出顺序有可能不一致),不可以存储重复元素。必须保证元素唯一性。
4.1 List集合(数组和链表的接口)
List是元素有序并且可以重复的集合。
List的主要实现:ArrayList, LinkedList, Vector。
List常用方法
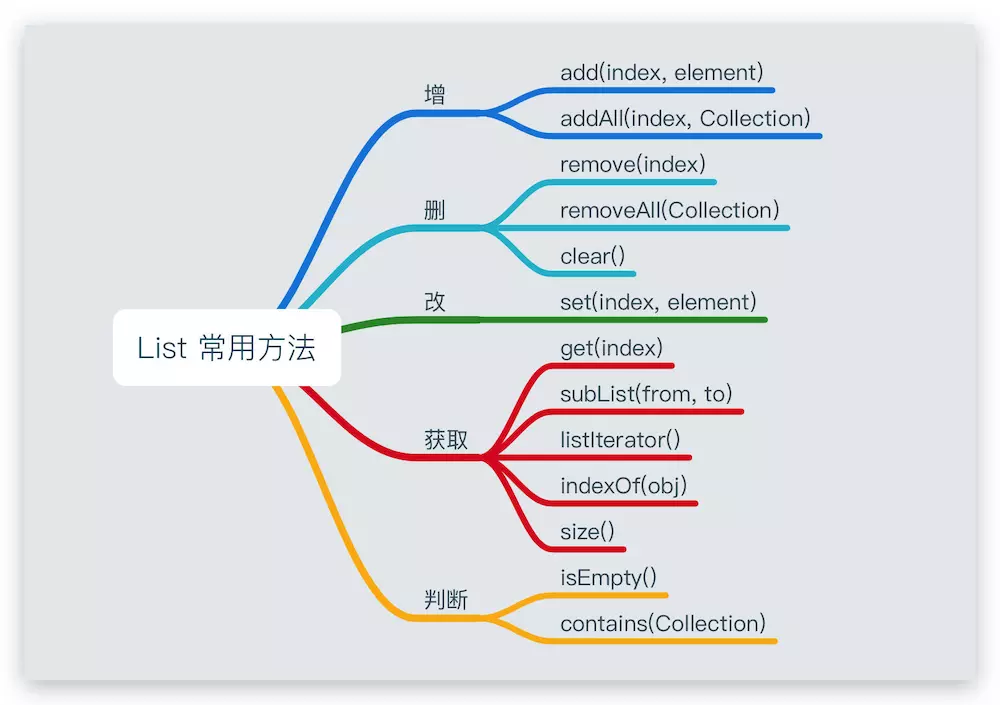
1.List接口概述
(1)鉴于Java中数组用来存储数据的局限性,我们通常使用List替代数组
(2)List集合类中元素有序、且可重复,集合中的每个元素都有其对应的顺序索引。
(3)List容器中的元素都对应一个整数型的序号记载其在容器中的位置,可以根据序号存取容器中的元素。
(4)JDK API中List接口的实现类常用的有:ArrayList、LinkList和Vector。
2.List接口方法
List除了从Collection集合继承的方法外,List集合里添加了一些根据索引来操作集合元素的方法。
(1)void add(int index,Object ele):在index位置插入ele元素。
(2)boolean addAll(int index,Collection eles):从index位置开始将eles中的所有元素添加进来。
(3)Object get(int index):获取指定index位置的元素。
(4)int indexOf(Object obj):返回obj在集合中首次出现的位置。
(5)int lastIndexOf(Object obj):返回obj在集合中末次出现的位置。
(6)Object remove(int index):移除指定Index位置的元素,并返回此元素。
(7)Object set(int index,Object ele):设置指定index位置的元素为ele。
(8)List subList(int fromIndex,int toIndex):返回从fromIndex到toIndex位置的子集合。
3.List实现类之一:ArrayList(动态数组)
(1)ArrayList 是List接口的典型实现类、主要实现类。
(2)本质上,ArrayList是对象引用的一个“变长”数组。
(3)ArrayList的JDK1.8之前与之后的实现区别?
JDK1.7:ArrayList像饿汉式,直接创建一个初始容量为10的数组
JDK1.8:ArrayList像懒汉式,一开始创建一个长度为0的数组,当添加第一个元素时在创建一个始容量为10的数组。
(4)Arrays.List(...)方法返回的List集合,既不是ArrayList实例,也不是Vector实例。ArrayList(...)返回值是一个固定长度的List集合。
ArrayList构造和添加方法
| 方法名 | 说明 |
|---|---|
public ArrayList<E>() |
创建一个空集合 |
public boolean add(E e) |
将指定的参数元素追加到集合的末尾 |
public void add(int index ,E e) |
在集合的指定位置添加指定的元素(插入元素) |
public void addAll(E object) |
用于将指定集合中所有元素添加到当前集合中 |
/**
* @Description ArrayList构造和添加方法
*/
public class ArrayList_01 {
public static void main(String[] args) {
//创建空集合
ArrayList<String> list = new ArrayList<>();//泛型定义为String
//采用默认追加的方式添加元素
System.out.println(list.add("刘德华"));
System.out.println(list.add("张学友"));
System.out.println(list.add("郭富城"));
System.out.println(list.add("黎明"));
//插入的方式添加元素
// list.add(10,"谭咏麟");//插入元素方法索引值不能大于集合中元素个数
// list.add(4,"谭咏麟");//表示在集合中最后位置插入元素,与追加相同
list.add(1,"谭咏麟");//指定位置插入元素,索引位置之后的元素会自动向后进行移动
ArrayList<String> newList = new ArrayList<>();//创建新的集合
newList.add("小沈阳");
newList.add("宋小宝");
newList.add("赵四");
newList.add("刘能");
//查看集合中的元素
System.out.println("原集合内部元素:" + list);
System.out.println("新集合内部元素:" + newList);
list.addAll(newList); //将新集合全部元素添加到原集合中
System.out.println("原集合内部元素:" + list);
}
}ArrayList集合常用方法
| 方法名 | 说明 |
|---|---|
public boolean remove(Object o) |
删除指定的元素,成功则返回true |
public E remove(int index) |
删除指定索引位置的元素,返回被删除的元素 |
public E set(int index,E e) |
修改指定索引位置的元素,返回修改前的元素 |
public E get(int index) |
获取指定索引对应的元素 |
public int size() |
获取结合中元素个数 |
import java.util.ArrayList;
import java.util.Iterator;
/**
* @Description ArrayList集合常用方法
*/
public class ArrayList_02 {
public static void main(String[] args) {
ArrayList<String> list = new ArrayList<>();
//追加方式添加元素
list.add("东邪");
list.add("西毒");
list.add("南帝");
list.add("北丐");
list.add("中神通");
//删除
System.out.println(list.remove("西毒"));//通过元素名称删除,返回boolean
System.out.println(list.remove(1));//通过索引删除元素,返回被删除元素名
//修改
System.out.println(list.set(1,"西毒"));//指定索引位置修改元素,并返回被修改元素
System.out.println("原集合中元素有:" + list);
//获取方法
System.out.println(list.get(1));//通过指定索引位置获取集合元素
//获取集合元素个数
System.out.println(list.size());
//集合的遍历,普通for循环
for (int i = 0; i < list.size(); i++) {
System.out.print(list.get(i) + "\t");
}
System.out.println();
//增强版for循环
for (String name : list) {
System.out.print(name+ "\t");
}
System.out.println();
//迭代器
Iterator<String> it = list.iterator();//创建迭代器
while (it.hasNext()){//判断下一个位置是否有元素
System.out.print(it.next() + "\t"); //next方法表示获取下一个位置的元素
}
System.out.println();
//Stream流
list.stream().forEach(System.out::println);
}
}ArrayList实现原理
底层代码:
属性:
DEFAULT_CAPACITY = 10 默认长度,初始化容量为10
Object[] EMPTY_ELEMENTDATA = {} //有参构造所创建
Object[] DEFAULTCAPACITY_EMPTY_ELEMENTDATA = {} //无参构造所创建的
Object[] elementData;底层为Object类型的数组,存储的元素都在此。
int size 实际存放的个数-
ArrayList集合底层是数组,怎么优化?
尽可能少的扩容。因为数组扩容效率比较低,建议在使用ArrayList集合 的时候预估计元素的个数,给定一个初始化容量。
-
数组优点:
TEXT**检索效率比较高**。(每个元素占用空间大小相同,内存地址是连续的,知道首元素内存地址, 然后知道下标,通过数学表达式计算出元素的内存地址,所以检索效率最高。) -
数组缺点:
TEXT随机**增删**元素效率比较低。 另外数组无法存储大数据量。(很难找到一块非常巨大的连续的内存空间。)
向数组末尾添加元素,效率很高,不受影响。
-
面试官经常问的一个问题?
TEXT这么多的集合中,你用哪个集合最多? 答:**ArrayList集合。**
因为往数组末尾添加元素,效率不受影响。
另外,我们检索/查找某个元素的操作比较多。
ArrayList集合是非线程安全的。(不是线程安全的集合。)
4.List实现类之二:LinkedList(链表)
(1)对于频繁的插入或删除元素的操作,建议使用LinkedList类,效率较高。
(2)新增方法:
-
void addFirst(Object obj):首结点添加数据
-
void addLast(Object obj):尾结点添加数据
-
Object getFirst():获取首结点数据
-
Object getLast():获取尾结点数据
-
Object removeFirst():删除首结点数据
-
Object removeLast():删除尾结点数据
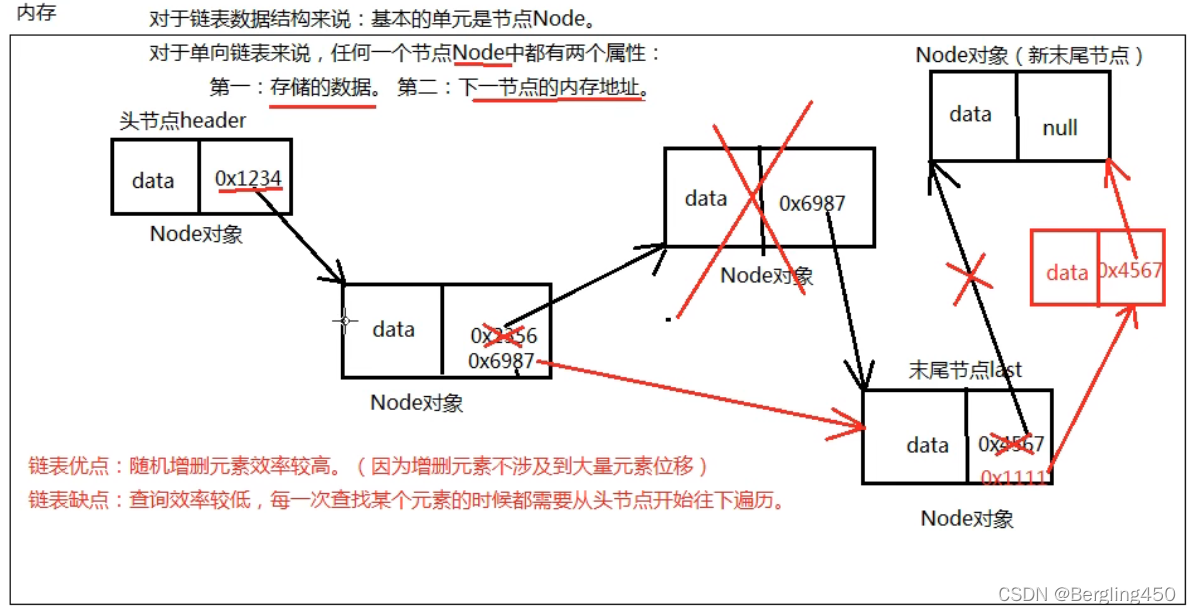
(3)单向链表数据结构
节点是单向链表中基本的单元。
每一个节点Node都有两个属性:
一个属性:是存储的数据。
另一个属性:是下一个节点的内存地址。
//数据结构
public class ListNode {
// 存储的数据
Object data;
// 下一个节点的内存地址
ListNode next;
public Node(){
}
public ListNode(Object data, ListNode next){
this.data = data;
this.next = next;
}
}
注意:ArrayList之所以检索效率比较高,不是单纯因为下标的原因。是因为底层数组发挥的作用。
LinkedList集合照样有下标,但是检索/查找某个元素的时候效率比较低,因为只能从头节点开始一个一个遍历。
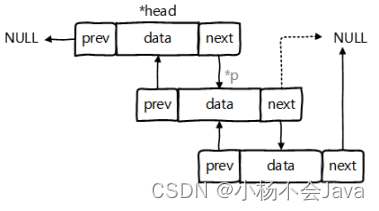
(3)LinkedList:双向链表,内部没有声明数组,而是定义了Node类型的first和last,用于记录首末元素。同时,定义内部类Node,作为
LinkedList中保存数据的基本结构。Node除了保存数据,还定义了两个变量:
//数据结构
private static class Node<E>{
E item;
Node<E> next;
Node<E> prev;
Node(Node<E> prev,E element,Node<E> next){
this.item=element;
this.next=next;
this.prev=prev;
}
}
链表的应用:
实现队列
LinkedList<String> queue = new LinkedList<>();
queue.addLast("入队");
queue.removeFirst("出队");实现栈:
LinkedList<String> stack = new LinkedList<>();
stack.addFirst("入栈");//LinkedList封装了push方法,本质就是addFirst
stack.removeFirst("出栈");//LinkedList封装了pop方法,本质就是removeFirst链表总结
链表的优点:(删除快,增加快)
由于链表上的元素在空间存储上内存地址不连续。所以随机增删元素的时候不会有大量元素位移,因此随机增删效率较高。
在以后的开发中,如果遇到随机增删集合中元素的业务比较多时,建议使用LinkedList。
链表的缺点:(查找慢)
不能通过数学表达式计算被查找元素的内存地址,每一次查找都是从头节点开始遍历,直到找到为止。所以LinkedList集合检索/查找的效率较低。
对比:
ArrayList:把检索发挥到极致。(末尾添加元素效率还是很高的。)
LinkedList:把随机增删发挥到极致。
加元素都是往末尾添加,所以ArrayList用的比LinkedList多。
5.List实现类之三:Vector(线程安全的集合)
(1)Vector是一个古老的集合,JDK1.0就有了。大多数操作与ArrayList相同,区别之处在于Vector是线程安全的,自带synchronized关键字。
(2)在各种list中,最好把ArrayList作为缺省选择。当插入、删除频繁时,使用LinkedList。Vector总是比ArrayList慢,所以尽量避免使用。
(3)新增方法:
**void addElement(Object obj)**增
**void insertElement(Object obj,int index)**插
**void set ElementAt(Object obj,int index)**查
**void removeElement(Object obj)**删
**void removeAllElements()**删所有
ArrayList、LinkedList、Vector 的区别
| ArrayList | LinkedList | Vector | |
|---|---|---|---|
| 底层实现 | 数组 | 双向链表 | 数组 |
| 同步性及效率 | 不同步,非线程安全,效率高,支持随机访问 | 不同步,非线程安全,效率高 | 同步,线程安全,效率低 |
| 特点 | 查询快,增删慢 | 查询慢,增删快 | 查询快,增删慢 |
| 默认容量 | 10 | / | 10 |
| 扩容机制 | int newCapacity = oldCapacity + (oldCapacity >> 1);//1.5 倍 | / | 2 倍 |
总结:
- ArrayList 和 Vector 基于数组实现,对于随机访问get和set,ArrayList优于LinkedList,因为LinkedList要移动指针。
- LinkedList 不会出现扩容的问题,所以比较适合随机位置增、删。但是其基于链表实现,所以在定位时需要线性扫描,效率比较低。
- 当操作是在一列数据的后面添加数据而不是在前面或中间,并且需要随机地访问其中的元素时,使用ArrayList会提供比较好的性能;
- 当你的操作是在一列数据的前面或中间添加或删除数据,并且按照顺序访问其中的元素时,就应该使用LinkedList了。
遍历时操作元素
遍历集合时,同时操作集合中的元素(增删等)
/**
* Description: for循环遍历
* 输出结果:
* [a, b, c, d, e]
* 由结果可知,第二个元素b并未删除,原因是当第一个元素b被删除后,它后面所有的元素都向前移动了一个单位,循环时导致第二个元素b漏掉了
*/
public static void remove(List<String> list) {
for (int i = 0; i < list.size(); i++) {
String s = list.get(i);
if (s.equals("b")) {
list.remove(s);
}
}
}
/**
* Description: foreach循环遍历
*
* 会报错:java.util.ConcurrentModificationException。这是因为在这里,foreach循环遍历容器本质上是使用迭代器进行遍历的,会对修改次数modCount进行检查,不允许集合进行更改操作
*/
public static void remove2(List<String> list) {
for (String s : list) {
if (s.equals("b")) {
list.remove(s);
}
System.out.println(s);
}
}
/**
* Description: 使用迭代器遍历
*/
public static void remove3(List<String> list) {
Iterator<String> it = list.iterator();
while (it.hasNext()) {
String s = it.next();
if (s.equals("b")) {
it.remove();
}
}
}
使用迭代器遍历删除时,能够避免方法二中出现的问题。这是因为:在ArrayList中,modCount是指集合的修改次数,当进行add或者delete时,modCount会+1;expectedModCount是指集合的迭代器的版本号,初始值是modCount,但是当集合进行add或者delete操作时,modCount会+1,而expectedModCount不会改变,所以方法二中会抛出异常。但是it.remove操作时,会同步expectedModCount的值,把modCount的值赋予expectedModCount。所以不会抛出异常。
总结:如果想正确的循环遍历删除(增加)元素,需要使用方法三,也就是迭代器遍历删除(增加)的方法。
在迭代元素的过程当中,一定要使用迭代器Iterator的remove方法,删除元素,不要使用集合自带的remove方法删除元素。会出现:java.util.ConcurrentModificationException
4.2 Set集合
Set集合元素无序(存入和取出的顺序不一定一致),并且没有重复对象。
- 特点
- 不允许包含重复的值
- 没有索引(就不能使用普通的for循环进行遍历)
Set的主要实现类:HashSet, TreeSet。
(哈希表中顺序表形式 HashSet,链表形式LinkedHashSet 及红黑树TreeSet)
- HashSet:无序、不重复、无索引。
Set<In1teger> set = new HashSet<>();
2.LinkedHashSet :有序、不重复、无索引。
Set<Integer>set=new LinkedHashSet<>();
3.TreeSet:排序、不重复、无索引
Set<Integer>set=new TreeSet<>();
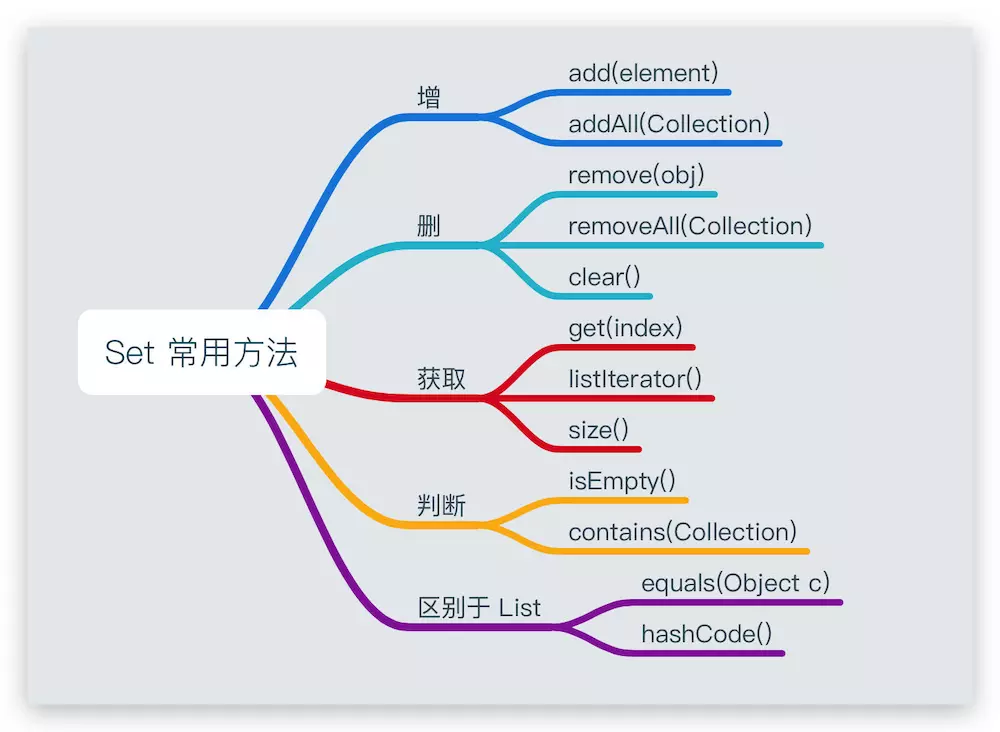
1.Set常用方法
2.Set实现类之一:HashSet
(1)HashSet概述
①HashSet是Set接口的典型实现,大多数时候使用Set集合时都是用这个实现类。
②HashSet按Hash算法来存储集合中的元素,因此具有很好的存取、查找、删除性能。
③HashSet具有的特点:
>不能保证元素的排列顺序
>HashSet不是线程安全的
>集合元素可以是null
④HashSet集合判断两个元素相等的标准:两个对象通过hashCode()方法比较相等,并且两个对象的equals()方法返回值也相同
⑤对于存放在Set容器中的对象,对应的类一定要重写equals()和hashCode(Object obj)方法,以实现对象想等原则。即:“相等的对象必须具有相等的散列码”。
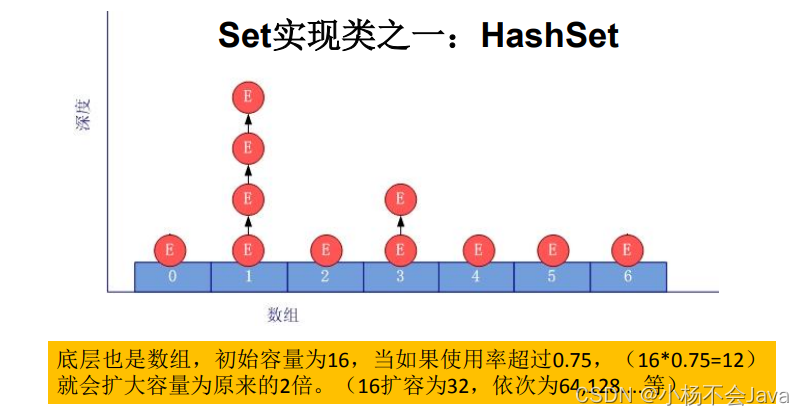
(2)向HshSet中添加元素的过程
①当向HashSet集合中存入一个元素时,HashSet会调用该对象的hashCode()方法来得到该对象的hashCode值,然后根据hashCode
值,通过某种散列函数决定该对象在HashSet底层数组中的存储位置。(这个散列函数会与底层数组的长度相计算得到在数组中的下标,
并且这种散列函数计算还尽可能保证能均匀存储元素,越是散列分布,该散列函数设计的越好)
②如果两个元素的hashCode()值相等,会在调用equals方法,如果equals方法结果为true,添加失败;如果为false,那么会保存该元
素,但是该数组的位置已经有元素了,那么会通过链表的方式继续连接。
③如果两个元素的equals()方法返回为true,但他们的hashCode()返回值不相等,hashSet将会把它们存储在不同的位置,但依然可以添加成功。
(3)重写hashCode()方法的基本原则
①在程序运行时,同一个对象多次调用hashCode()方法应该返回相同的值。
②当两个对象的equals()方法比较返回为true时,这两个对象的hashCode()方法的返回值也应相等。
③对象中用作equals()方法比较的Field,都应该用来计算hashCode值。
(4)重写equals()方法的基本准则
①当一个类有自己特有的“逻辑相等”概念,当改写equals()的时候,总是要改写hashCode(),根据一个类的equals()方法(改写之
后),两个截然不同的实例有可能是在逻辑上是相等的,但是,根据Object.hashCode()方法,它们仅仅是两个对象。
②因此违反了“相等的对象必须具有相等的散列码”。
③结论:复写equals方法的时候一般需要同时复写hashCode方法。通常参与计算hashCode的对象的属性也应该参与到equals()中进行
计算。
3.Set实现类之二:LinkedHashSet
(1)LinkedHashSet是HashSet的子类
(2)LinkedHashSet根据元素的hashCode来决定元素的存储位置,但它同时使用双向链表维护元素的次序,这使得元素看起来是以插入
顺序保存的。
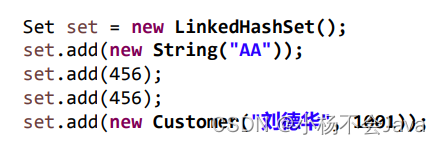
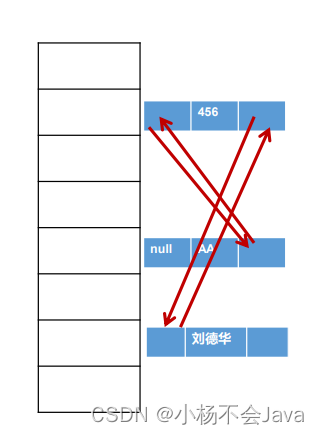
(3)LinkedHashSet插入性能略低于HashSet,但在迭代访问Set里的全部元素时有很好的性能。
(4)LinkedHashSet不允许集合元素重复
4.Set实现类之三:TreeSet
(1)Tree概述
①Tree是SortedSet接口的实现类,TreeSet可以确保集合元素除余排序状态。
②Tree底层使用红黑树结构存储数据。这样保证排序的性质
③新增的方法:(了解)
>Comparator comparator() >Object higher(Object e)
>Object first() >SortedSet subSet(fromElement,toElement)
>Object last() >SortedSet headSet(toElement)
>Object lower(Object e) >SortedSet taiSet(fromElement)
④Tree两种排序方法:自然排序和定制排序。默认情况下,Tree采用自然排序。
⑤TreeSet和后面的TreeMap采用红黑树的存储结构。特点:有序,查询速度比List快。
(2)排序--自然排序
①自然排序(默认):Tree会调用集合元素的compareTo(Object obj)方法来比较元素之间的大小关系,然后将集合元素按升序(默认情况)排列
②如果试图把一个对象添加到TreeSet时,则该对象的类必须实现Comparable接口(没有给定排序标准,需要定义排序标准)
>实现Comparable的类必须实现compareTo(Object obj)方法,两个对象即通过 compareTo(Object obj)方法的返回值来比较大小。
//Student自定义类
public class Student implements Comparable<Student>{
private String name;
private int age;
private double height;
@Override
public int compareTo(Student o){//传入的是需要比较的对象
return this.age - o.age;
//使用age来排序
//this-o,为升序,o-this为降序
}
//空参有参方法
//getter/setter
} ③Comparable的典型实现:
>BigDecimal、BigInteger以及所有的数值型对应的包装类:按它们对应的数值大小进行 比较。
>Character:按字符的unicode值来进行比较。
>Boolean:true对应的包装类实例大于false对应的包装类实例。
>String: 按字符中字符的unicode值进行比较。
>Date、Time:后边的时间、日期比前面的时间、日期大向
④向 TreeSet 中添加元素时,只有第一个元素无须比较compareTo()方法,后面添 加的所有元素都会调用compareTo()方法进行比较。
⑤因为只有相同类的两个实例才会比较大小,所以向 TreeSet 中添加的应该是同 一个类的对象。
⑥对于 TreeSet 集合而言,它判断两个对象是否相等的唯一标准是:两个对象通 过 compareTo(Object obj) 方法比较返回值。
⑦当需要把一个对象放入 TreeSet 中,重写该对象对应的 equals() 方法时,应保 证该方法与 compareTo(Object obj) 方法有一致的结果:如果两个对象通过 equals() 方法比较返回 true,则通过 compareTo(Object obj) 方法比较应返回 0。 否则,让人难以理解。
(3)排序--定制排序
①TreeSet的自然排序要求元素所属的类实现Comparable接口,如果元素所属的类没 有实现Comparable接口,或不希望按照升序(默
认情况)的方式排列元素或希望按照 其它属性大小进行排序,则考虑使用定制排序。
②利用int compare(T o1,T o2)方法,比较o1和o2的大小:如果方法返回正整数,则表 示o1大于o2;如果返回0,表示相等;返回负整数,表示o1小于o2。
③要实现定制排序**,需要将实现Comparator接口的实例作为形参传递给TreeSet的构造器。**
Set<Student> students = new TreeSet<>(new Comparator<Student>{
@Override
public int compare(Student o1,Student o2){
return Double.compare(o1.getHeight(),o2.getHeight());//o1-o2为升序
}
});
//简化用lambda表达式
Set<Student> students = new TreeSet<>((o1,o2)->Double.compare(o1.getHeight(),o2.getHeight())); ④此时,仍然只能向TreeSet中添加类型相同的对象。否则发生ClassCastException异常
⑤使用定制排序判断两个元素相等的标准是:通过Comparator比较两个元素返回了0。
5.HashSet、TreeSet、LinkedHashSet的区别
-
TreeMap:基于红黑树实现。
-
HashMap:基于哈希表实现。
-
HashTable:和 HashMap 类似,但它是线程安全的,这意味着同一时刻多个线程可以同时写入 HashTable 并且不会导致数据不一
致。它是遗留类,不应该去使用它。现在可以使用 ConcurrentHashMap 来支持线程安全,并且 ConcurrentHashMap 的效率会更
高,因为 ConcurrentHashMap 引入了分段锁。
-
LinkedHashMap:使用双向链表来维护元素的顺序,顺序为插入顺序或者最近最少使用(LRU)顺序。
| HashSet | TreeSet | LinkedHashSet | |
|---|---|---|---|
| 底层实现 | HashMap | 红黑树 | LinkedHashMap |
| 重复性 | 不允许重复 | 不允许重复 | 不允许重复 |
| 有无序 | 无序 | 有序,支持两种排序方式,自然排序和定制排序,其中自然排序为默认的排序方式。 | 有序,以元素插入的顺序来维护集合的链接表 |
| 时间复杂度 | add(),remove(),contains()方法的时间复杂度是O(1) | add(),remove(),contains()方法的时间复杂度是O(logn) | LinkedHashSet在迭代访问Set中的全部元素时,性能比HashSet好,但是插入时性能稍微逊色于HashSet,时间复杂度是 O(1)。 |
| 同步性 | 不同步,线程不安全 | 不同步,线程不安全 | 不同步,线程不安全 |
| null值 | 允许null值 | 不支持null值,会抛出 java.lang.NullPointerException 异常。因为TreeSet应用 compareTo() 方法于各个元素来比较他们,当比较null值时会抛出 NullPointerException异常。 | 允许null值 |
| 比较 | equals() | compareTo() | equals() |
6.HashSet如何检查重复
当你把对象加入HashSet时,HashSet会先计算对象的hashcode值来判断对象加入的位置,同时也会与其他加入的对象的hashcode值作
比较,如果没有相符的hashcode,HashSet会假设对象没有重复出现。但是如果发现有相同hashcode值的对象,这时会调用equals()方
法来检查hashcode相等的对象是否真的相同。如果两者相同,HashSet就不会让加入操作成功。
hashCode()与equals()的相关规定:
-
如果两个对象相等,则hashcode一定也是相同的
-
两个对象相等,equals方法返回true
-
两个对象有相同的hashcode值,它们也不一定是相等的
-
综上,equals方法被覆盖过,则hashCode方法也必须被覆盖
hashCode()的默认行为是对堆上的对象产生独特值。如果没有重写hashCode(),则该class的两个对象无论如何都不会相等(即使这
两个对象指向相同的数据)。
总结: HashSet是一个通用功能的Set,而LinkedHashSet 提供元素插入顺序保证,TreeSet是一个SortedSet实现,由Comparator 或者
Comparable指定的元素顺序存储元素。
5. Map接口
Map 是一种把键对象和值对象映射的集合,它的每一个元素都包含一对键对象和值对象。 Map没有继承于Collection接口,从Map集合
中检索元素时,只要给出键对象,就会返回对应的值对象。
Map 的常用实现类:HashMap、TreeMap、HashTable、LinkedHashMap、ConcurrentHashMap
5.1双列集合继承关系图
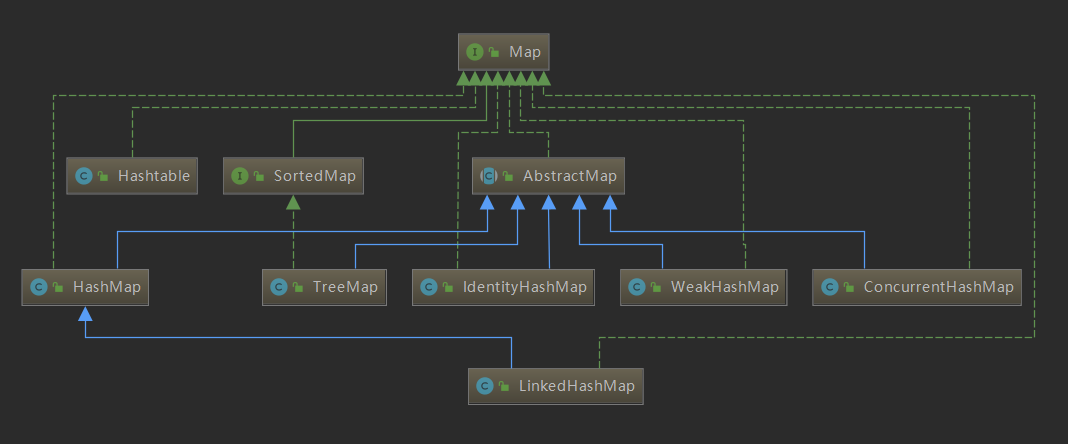
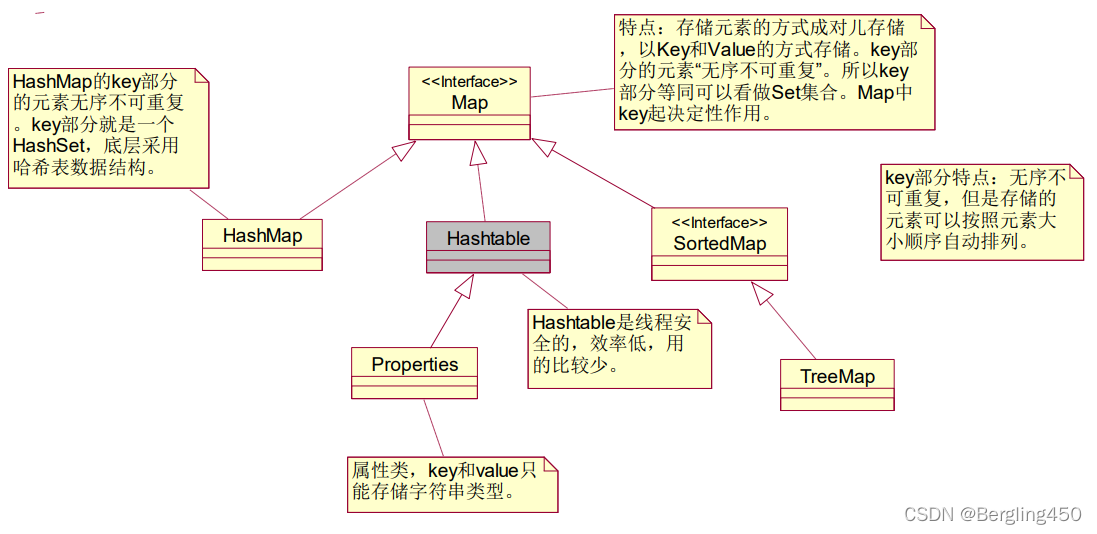
Map集合体系的特点:
HashMap(由键决定特点):无序、不重复、无索引;(用的最多)
LinkedHashMap (由键决定特点):由键决定的特点:有序、不重复、无索引。
TreeMap (由键决定特点):按照大小默认升序排序、不重复、无索引。
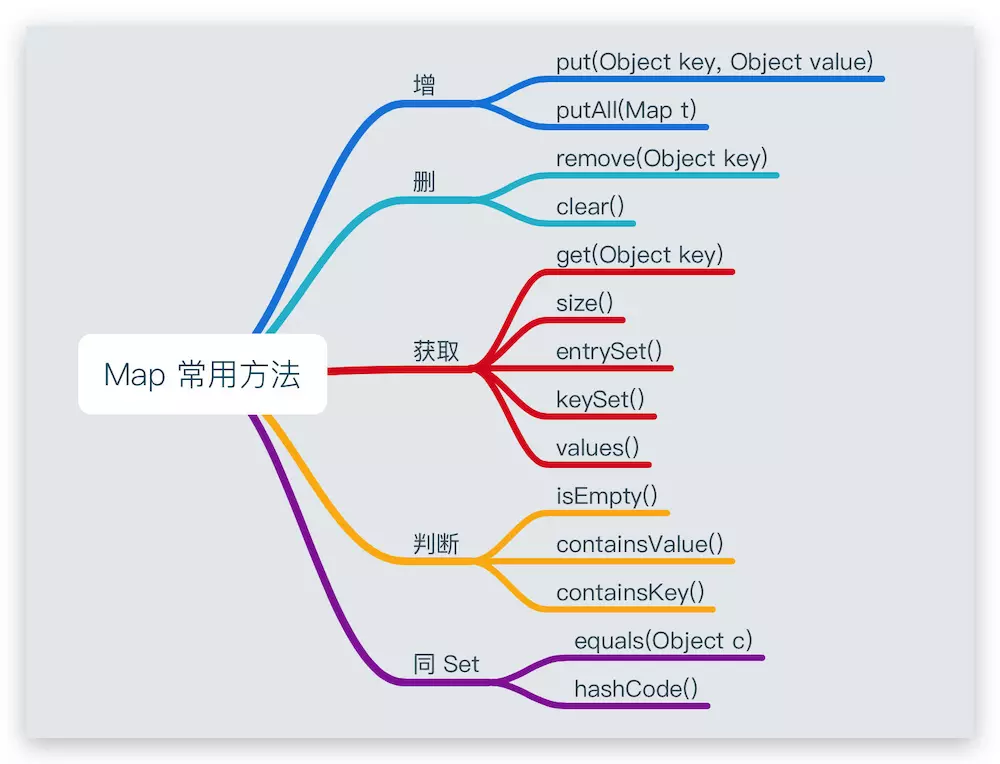
5.2Map常用方法
① 添加、删除、修改操作:
-
Object put(Object key,Object value):将指定key-value添加到(或修改)当前map对象中
-
void putAll(Map m):将m中的所有key-value对存放到当前map中
-
Object remove(Object key):移除指定key的key-value对,并返回value
-
void clear():清空当前map中的所有数据
② 元素查询的操作:
-
Object get(Object key):获取指定key对应的value
-
boolean containsKey(Object key):是否包含指定的key
-
boolean containsValue(Object value):是否包含指定的value
-
int size():返回map中key-value对的个数
-
boolean isEmpty():判断当前map是否为空 boolean equals(Object obj):判断当前map和参数对象obj是否相等
③ 元视图操作的方法:
-
Set keySet():返回所有key构成的Set集合
-
Collection values():返回所有value构成的Collection集合
-
Set entrySet():返回所有key-value对构成的Set集合,可以整体k-v遍历
-
map.forEach:lambda表达式遍历
④map集合的遍历
//添加数据
Map<String,Double> map =new HashMap<>();
map.put("蜘蛛精",162.5);
map.put("蜘蛛精",169.8);
map.put("紫霞",165.8);
map.put("至尊宝",1623.8);
map.put("紫霞",157.2);
System.out.println(map);- 获取key,根据key遍历
Set<String> keys = map.keySet();//获取集合中的key
for ( String key : keys) {
System.out.println(map.get(key));//根据key遍历获取value
}
}- 根据整体k-v遍历
Set<String> keys = map.keySet();//获取集合中的key
for ( String key : keys) {
System.out.println(map.get(key));//根据key遍历获取value
}- lambda表达式遍历
Set<Map.Entry<String, Double>> entries = map.entrySet();
for (Map.Entry<String, Double> entry : entries) {
System.out.println(entry.getKey() + "=" + entry.getValue());
}
5.3.Map实现类之一:HashMap
(1)HashMap概述
①HashMap是Map接口使用频率最高的实现类。
②允许使用null键和null值,与HashSet一样,不保证映射的顺序。
③所有的key构成的集合是Set:无序的、不可重复的。所以,key所在的类要重写equals()和hashCode()
④所有的value构成的集合是Collection:无序的、可以重复的。所以,value所在的类要重写equals()
⑤一个key-value构成一个entry
⑥所有的entry构成的集合是Set:无序的、不可重复的
⑦HashMap 判断两个key相等的标准是:两个key通过equals()方法返回true,hashCode值也相等。
⑧HashMap 判断两个value相等的标准是:两个value通过equals()方法返回true。
⑨HashMap集合的默认初始化容量是16,默认加载因子是0.75 这个默认加载因子是当HashMap集合底层数组的容量达到75%的时候,数组以二叉树开始扩容。
重点,记住:HashMap集合初始化容量必须是2的倍数,这也是官方推荐的, 这是因为达到散列均匀,为了提高HashMap集合的存取效率,所必须的。
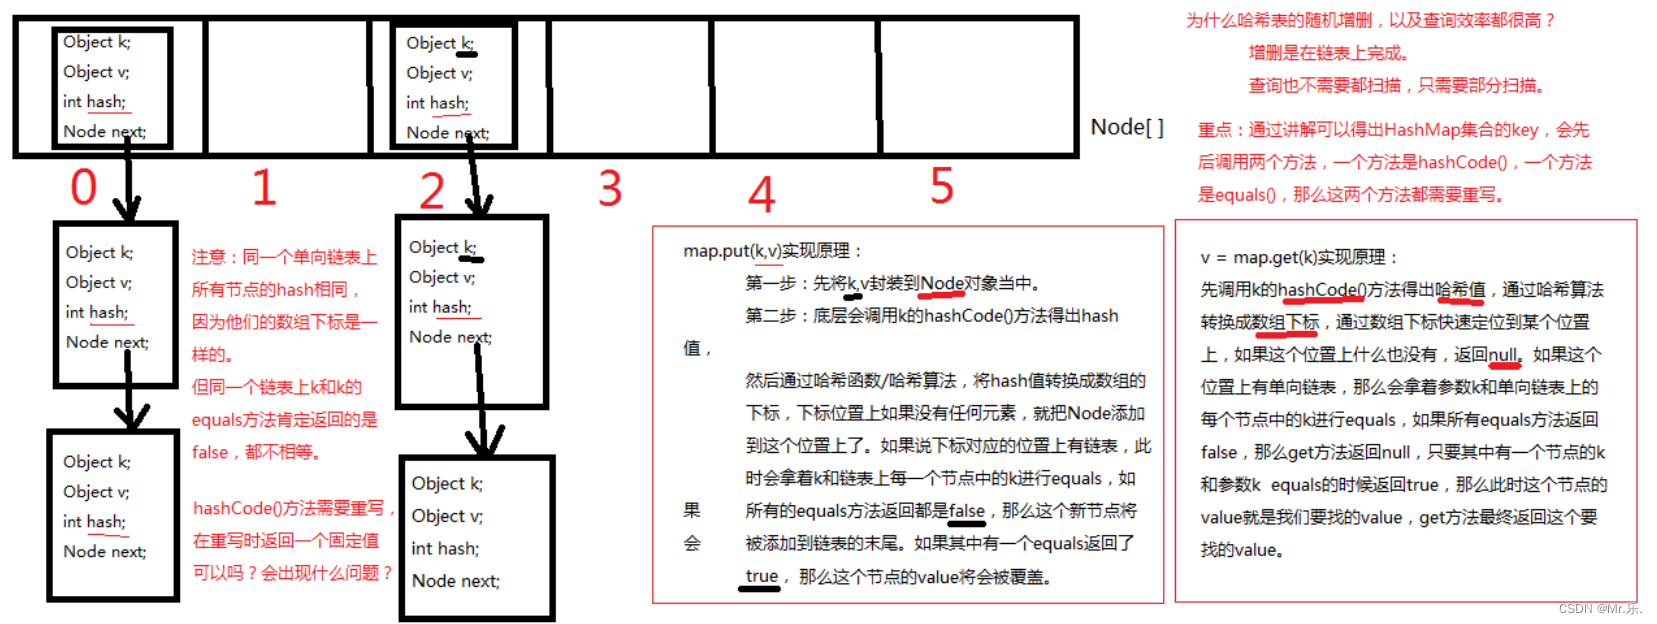
(1.1)哈希表
通过 数组 + 链表 实现的一种数据结构
哈希表的构造方法的参数是一个长度为16个元素的数组,通过哈希值 % 16 的值,作为头节点在数组中选择对应的位置,就形成了哈希表。
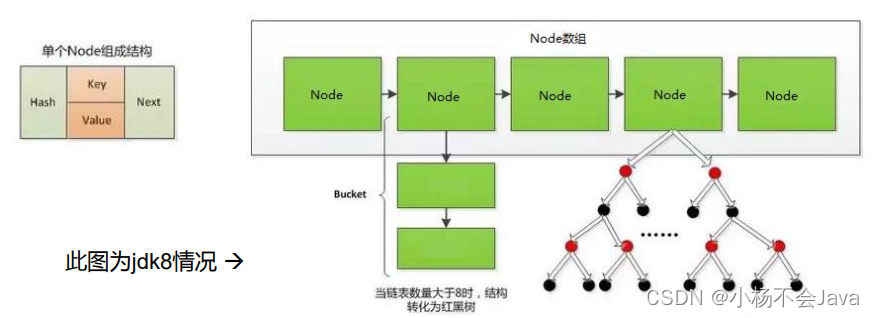
(2)HashMap的存储结构
4.Map实现类之二:LinkedHashMap
(1) LinkedHashMap概述
①LinkedHashMap是HashMap的子类
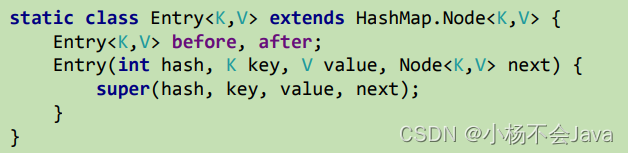
②在HashMap存储结构的基础上,使用了一堆双向链表来记录添加元素的顺序
③与LinkedHashSet类似,LinkedHashMap可以维护Map的迭代顺序:迭代顺序与Key-Value对的插入顺序一致
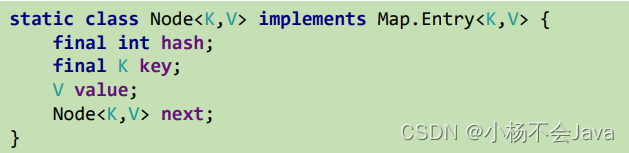
(2)LinkedHashMap中的内部类
HashMap中的内部类
5.Map实现类之三:TreeMap
(1)TreeMap存储 Key-Value 对时,需要根据 key-value 对进行排序。 TreeMap 可以保证所有的 Key-Value 对处于有序状态。
(2)TreeSet底层使用红黑树结构存储数据
(3)TreeMap 的 Key 的排序:
自然排序:TreeMap 的所有的 Key 必须实现 Comparable 接口,而且所有 的 Key 应该是同一个类的对象,否则将会抛出 ClasssCastException
定制排序:创建 TreeMap 时,传入一个 Comparator 对象,该对象负责对 TreeMap 中的所有 key 进行排序。此时不需要 Map 的 Key 实现 Comparable 接口
(4) TreeMap判断两个key相等的标准:两个key通过compareTo()方法或 者compare()方法返回0。
6.Map实现类之四:Hashtable
(1)Hashtable是个古老的 Map 实现类,JDK1.0就提供了。不同于HashMap, Hashtable是线程安全的。
(2) Hashtable实现原理和HashMap相同,功能相同。底层都使用哈希表结构,查询 速度快,很多情况下可以互用。
(3) 与HashMap不同,Hashtable 不允许使用 null 作为 key 和 value
(4)与HashMap一样,Hashtable 也不能保证其中 Key-Value 对的顺序
(5)Hashtable判断两个key相等、两个value相等的标准,与HashMap一致。
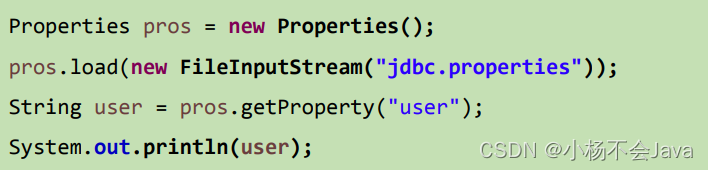
7.Map实现类之五:Properties
(1)Properties 类是 Hashtable 的子类,该对象用于处理属性文件 由于属性文件里的 key、value 都是字符串类型,所以 Properties 里的 key 和 value 都是字符串类型
(2)存取数据时,建议使用setProperty(String key,String value)方法和 getProperty(String key)方法
HashMap、HashTable、TreeMap的区别
-
TreeMap:基于红黑树实现。
-
HashMap:基于哈希表实现。
-
HashTable:和 HashMap 类似,但它是线程安全的,这意味着同一时刻多个线程可以同时写入 HashTable 并且不会导致数据不一
致。它是遗留类,不应该去使用它。现在可以使用 ConcurrentHashMap 来支持线程安全,并且 ConcurrentHashMap 的效率会更
高,因为 ConcurrentHashMap 引入了分段锁。
- LinkedHashMap:使用双向链表来维护元素的顺序,顺序为插入顺序或者最近最少使用(LRU)顺序。
| HashMap | HashTable | TreeMap | |
|---|---|---|---|
| 底层实现 | 哈希表(数组+链表) | 哈希表(数组+链表) | 红黑树 |
| 同步性 | 线程不同步 | 同步 | 线程不同步 |
| null值 | 允许 key 和 Vale 是 null,但是只允许一个 key 为 null,且这个元素存放在哈希表 0 角标位置 | 不允许key、value 是 null | value允许为null。 当未实现 Comparator 接口时,key 不可以为null 当实现 Comparator 接口时,若未对 null 情况进行判断,则可能抛 NullPointerException 异常。如果针对null情况实现了,可以存入,但是却不能正常使用get()访问,只能通过遍历去访问。 |
| hash | 使用hash(Object key)扰动函数对 key 的 hashCode 进行扰动后作为 hash 值 | 直接使用 key 的 hashCode() 返回值作为 hash 值 | |
| 容量 | 容量为 2^4 且容量一定是 2^n | 默认容量是11,不一定是 2^n | |
| 扩容 | 两倍,且哈希桶的下标使用 &运算代替了取模 | 2倍+1,取哈希桶下标是直接用模运算 |
HashMap在JDK1.7和JDK1.8中有哪些不同
| 不同 | JDK 1.7 | JDK 1.8 |
|---|---|---|
| 存储结构 | 数组 + 链表 | 数组 + 链表 + 红黑树 |
| 初始化方式 | 单独函数:inflateTable() |
直接集成到了扩容函数resize()中 |
| hash值计算方式 | 扰动处理 = 9次扰动 = 4次位运算 + 5次异或运算 | 扰动处理 = 2次扰动 = 1次位运算 + 1次异或运算 |
| 存放数据的规则 | 无冲突时,存放数组;冲突时,存放链表 | 无冲突时,存放数组;冲突 & 链表长度 < 8:存放单链表;冲突 & 链表长度 > 8:树化并存放红黑树 |
| 插入数据方式 | 头插法(先讲原位置的数据移到后1位,再插入数据到该位置) | 尾插法(直接插入到链表尾部/红黑树) |
| 扩容后存储位置的计算方式 | 全部按照原来方法进行计算(即hashCode ->> 扰动函数 ->> (h&length-1)) | 按照扩容后的规律计算(即扩容后的位置=原位置 or 原位置 + 旧容量) |
集合工具类Collections
Collections:集合工具类,操作集合的类。这个类不需要创建对象,内部提供的都是静态方法。
静态方法:
1. sort((List<T> list,Comparator<? super E>,):void List
对集合中的元素排序。提供Comparator方法升序和降序
public class collection_API {
public static void main(String[] args) {
List<Integer> list = new ArrayList<Integer>();
list.add(2);
list.add(5);
list.add(3);
list.add(4);
list.add(1);
Collections.sort(list, new Comparator<Integer>() {
@Override
public int compare(Integer o1, Integer o2) {
return o2-o1;
}
});
System.out.println(list);
}
}
Output:
[5,4,3,2,1]
2.reverse(List<?>):void
反转集合中的元素。
public class Main {
public static void main(String[] args) {
List<Integer> list = new ArrayList<Integer>();
for(int i = 0;i< 5; i++){
list.add(i+1);
}
System.out.println(list);
Collections.reverse(list);
System.out.println(list);
}
}
Output:
[1, 2, 3, 4, 5]
[5, 4, 3, 2, 1]3.shuffle(List<?>):void
打乱元素中的元素。
public class Main {
public static void main(String[] args) {
List<Integer> list = new ArrayList<Integer>();
for(int i = 0;i< 5; i++){
list.add(i+1);
}
Collections.shuffle(list);
System.out.println(list);
}
}
Output:(每次都不同)
eg:[4, 2, 1, 3, 5]
4.fill(List<? super T>,T):void
用T元素替换掉集合中的所有的元素。
public class Main {
public static void main(String[] args) {
List<Integer> list = new ArrayList<Integer>();
for(int i = 0;i< 5; i++){
list.add(i+1);
}
System.out.println(list);
Collections.fill(list,6);
System.out.println(list);
}
}
Output:
[1, 2, 3, 4, 5]
[6, 6, 6, 6, 6]5.copy(List<? super T>,List<? extend T>):void
复制并覆盖相应索引的元素。
public class Main {
public static void main(String[] args) {
List<Integer> list1 = new ArrayList<Integer>();
for(int i = 0;i< 5; i++){
list1.add(i+1);
}
List<Integer> list2 = new ArrayList<Integer>();
for(int i = 0;i<5;i++){
list2.add(i+6);
}
System.out.println(list1);
Collections.copy(list1,list2);
System.out.println(list1);
}
}
Output:
[1, 2, 3, 4, 5]
[6, 7, 8, 9, 10]
6.min/max(Collection<? extends T>):T
找到集合中最大/小的元素。
public class Main {
public static void main(String[] args) {
List<Integer> list = new ArrayList<Integer>();
for(int i = 0;i< 10; i++){
list.add(i+1);
}
System.out.println(Collections.max(list));
System.out.println(Collections.min(list));
}
}
Output:
10
1
7.swap(List<?>,int,int):void
交换集合中指定元素索引的位置.
public class Main {
public static void main(String[] args) {
List<Integer> list = new ArrayList<Integer>();
for(int i = 0;i< 10; i++){
list.add(i+1);
}
Collections.swap(list,3,4);
System.out.println(list);
}
}
Output:
[1, 2, 3, 5, 4, 6, 7, 8, 9, 10]
8.rotate(List<?>,int):void
**集合中的元素向后移m个位置,在后面被遮盖的元素循环到前面来.
(负数向左移动,正数向右移动)**
public class Main {
public static void main(String[] args) {
List<Integer> list = new ArrayList<Integer>();
for(int i = 0;i< 5; i++){
list.add(i+1);
}
Collections.rotate(list,2);
System.out.println(list);
Collections.rotate(list,-2);
System.out.println(list);
}
}
Output:
[4, 5, 1, 2, 3]
[1, 2, 3, 4, 5]
9.indexOfSubList(List<?>,List<?>):int
lastIndexOfSubList(List<?>,List<?>):int
找出参数2在参数1第一次出现的位置。
public class Main {
public static void main(String[] args) {
List<Integer> list = new ArrayList<Integer>(Arrays.asList(1,2,3,3,3,4,5));
List<Integer> subList = new ArrayList<Integer>();
subList.add(3);
System.out.println(Collections.indexOfSubList(list,subList));
System.out.println(Collections.lastIndexOfSubList(list,subList));
}
}
Output:
2
4
10.replaceAll(List,T,T):boolean
替换成指定的元素。
public class Main {
public static void main(String[] args) {
List<Integer> list = new ArrayList<Integer>(Arrays.asList(1,2,3,4,5,6));
System.out.println(Collections.replaceAll(list,3,36));
System.out.println(list);
}
}
Output:
true
[1, 2, 36, 4, 5, 6]
11.synchronizedXxx方法
可以将某集合转化成线程安全的容器之后再使用。
eg:
public class Main {
public static void main(String[] args) {
List<String> slist = Collections.synchronizedList(new ArrayList<String>());
...
}
}12.unmodifiableCollection(Collection<? extends T>):Collection
将集合变为不可修改。
public class Main {
public static void main(String[] args) {
List<Integer> list = new ArrayList<Integer>();
list.add(10);
Collection<Integer> clist = Collections.unmodifiableCollection(list);
try{
clist.add(10);
}catch (Exception e){
System.out.println("Exception");
}
}
}
Output:
Exception
Collections.sort(list);//list集合进行元素的自然顺序排序。
Collections.sort(list,new ComparatorByLen());//按指定的比较器方法排序。
class ComparatorByLen implements Comparator<String>{
public int compare(String s1,String s2){
int temp = s1.length()-s2.length();
return temp==0?s1.compareTo(s2):temp;
}
}
Collections.max(list);//返回list中字典顺序最大的元素。
int index = Collections.binarySearch(list,"zz");//二分查找,返回角标。
Collections.reverseOrder();//逆向反转排序。
Collections.shuffle(list);//随机对list中的元素进行位置的置换。
//将非同步集合转成同步集合的方法:Collections中的 XXX synchronizedXXX(XXX);
//原理:定义一个类,将集合所有的方法加同一把锁后返回。
List synchronizedList(list);
Map synchronizedMap(map);
Collection 和 Collections的区别
// Collections是个java.util下的类,是针对集合类的一个工具类,提供一系列静态方法,实现对集合的查找、排序、替换、线程安全化(将非同步的集合转换成同步的)等操作。
// 这个可能以后要使用!!!!
List myList = new ArrayList(); // 非线程安全的。
// 变成线程安全的
Collections.synchronizedList(myList); // 这里没有办法看效果
// myList集合就是线程安全的了。
// Collection是个java.util下的接口,它是各种集合结构的父接口,继承于它的接口主要有Set和List,提供了关于集合的一些操作,如插入、删除、判断一个元素是否其成员、遍历等。数组工具类 Arrays
用于操作数组对象的工具类,里面都是静态方法。
数组 -> 集合:asList方法,将数组转换成list集合。
String[] arr ={"abc","kk","qq"};
List<String> list =Arrays.asList(arr);//将arr数组转成list集合。将数组转换成集合,有什么好处呢?用aslist方法,将数组变成集合;
可以通过list集合中的方法来操作数组中的元素:isEmpty()、contains、indexOf、set;
注意(局限性):数组是固定长度,不可以使用集合对象增加或者删除等,会改变数组长度的功能方法。比如add、remove、clear。(会报不支持操作异常UnsupportedOperationException);
如果数组中存储的引用数据类型,直接作为集合的元素可以直接用集合方法操作。
如果数组中存储的是基本数据类型,asList会将数组实体作为集合元素存在。集合 -> 数组:用的是Collection接口中的toArray()方法;
如果给toArray传递的指定类型的数据长度小于了集合的size,那么toArray方法,会自定再创建一个该类型的数据,长度为集合的size。
如果传递的指定的类型的数组的长度大于了集合的size,那么toArray方法,就不会创建新数组,直接使用该数组即可,并将集合中的元素存储到数组中,其他为存储元素的位置默认值null。
所以,在传递指定类型数组时,最好的方式就是指定的长度和size相等的数组。将集合变成数组后有什么好处?限定了对集合中的元素进行增删操作,只要获取这些元素即可。
用基本数据类型的数组转换ArrayList,ArrayList的size有问题
public static void main(String[] args) {
int[] arr1 = { 1, 2, 3, 4, 5 };
List<int[]> intList = Arrays.asList(arr1);
// intList size: 1
System.out.println(String.format("intList size: %s", intList.size()));
Integer[] arr2 = { 1, 2, 3, 4, 5 };
List<Integer> integerList = Arrays.asList(arr2);
// integerList size: 5
System.out.println(String.format("integerList size:%s", integerList.size()));
}asList方法接受的参数是一个泛型的变长参数,我们知道基本数据类型是无法泛型化的,也就是说基本类型是无法作为asList方法的参数的, 要想作为泛型参数就必须使用其所对应的包装类型。但是这个这个实例中为什么没有出错呢?因为该实例是将int 类型的数组当做其参数,而在Java中数组是一个对象,它是可以泛型化的。所以该例子是不会产生错误的。既然例子是将整个int 类型的数组当做泛型参数,那么经过asList转换就只有一个int 的列表了.
结论:
在使用asList()时尽量不要将基本数据类型数组转List.
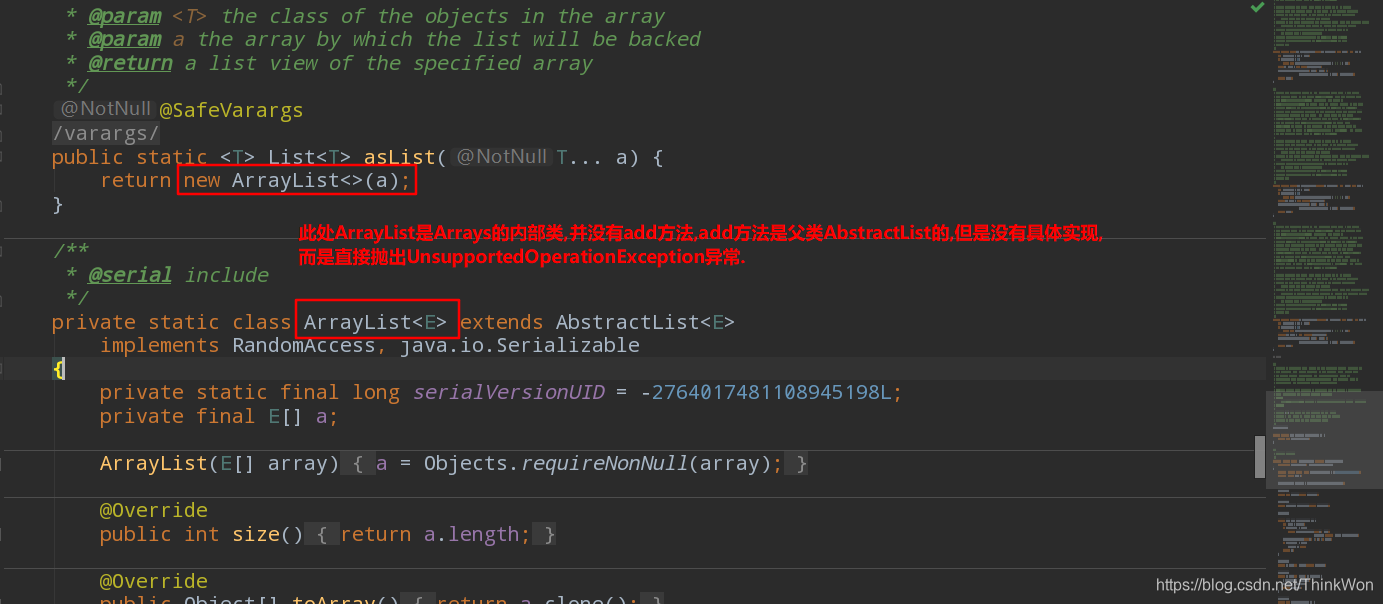
asList转换得到的ArrayList不是java.util.ArrayList
public static void main(String[] args) {
String[] arr = {"abc", "kk", "qq"};
List<String> list = Arrays.asList(arr);
// 添加一个元素,抛出异常UnsupportedOperationException
list.add("bb");
}原因:
此处ArrayList是Arrays的内部类,并没有add方法,add方法是父类AbstractList的,但是没有具体实现, 而是直接抛出UnsupportedOperationException异常.
正确操作
public static void main(String[] args) {
String[] arr = {"abc", "kk", "qq"};
// 使用new ArrayList包裹一层
List<String> list = new ArrayList<>(Arrays.asList(arr));
list.add("bb");
}如何选用集合?
主要根据集合的特点来选用,比如我们需要根据键值获取到元素值时就选用Map接口下的集合,需要排序时选择TreeMap,不需要排序时就选择HashMap,需要保证线程安全就选用ConcurrentHashMap.当我们只需要存放元素值时,就选择实现Collection接口的集合,需要保证元素唯一时选择实现Set接口的集合比如TreeSet或HashSet,不需要就选择实现List接口的比如ArrayList或LinkedList,然后再根据实现这些接口的集合的特点来选用。
可变参数
定义:就是一种特殊形参,定义在方法、构造器的形参列表里,格式是:数据类型..参数名称;
可变参数的特点和好处:
- 特点:可以不传数据给它;可以传一个或者同时传多个数据给它;也可以传一个数组给它。
- 好处:常常用来灵活的接收数据。
可变参数的注意事项:
- 可变参数在方法内部就是一个数组,
- 一个形参列表中可变参数只能有一个
- 可变参数必须放在形参列表的最后面
public class collection_API {
public static void main(String[] args) {
test();//空参
test(10);//一个参
test(10,20);//多个参
test(new int[]{10,20});//传入数组参
}
public static void test(int...nums){
System.out.println(Arrays.toString(nums));
}
}
out
[]
[10]
[10, 20]
[10, 20]嵌套集合
定义:集合中的k-v中value值可能是一个list集合,set集合。在这种情况下一个k对应对个value值
例子:
江苏省=”南京市”“扬州市”"苏州市”,"无锡市”,"常州市“
大湖北省 =“武汉市”,“孝感市",“十堰市”"宜昌市”“鄂州市”
河北省 =“石家庄市""唐山市",“邢台市",“保定市”,“张家口市”
public class collection_API {
public static void main(String[] args) {
//k为String类型,v为List<String>类型
Map<String, List<String>> map = new HashMap<>();
//初始化list集合
List<String> list1 = new ArrayList<>();
//addAll方法批量添加元素
list1.addAll(Arrays.asList("南京市", "扬州市", "苏州市","无锡市","常州市"));
//使用Collections工具类批量添加方法
// Collections.addAll(list1, "南京市", "扬州市", "苏州市","无锡市","常州市");
map.put("江苏省", list1);
System.out.println(map);
}
}
out
{江苏省=[南京市, 扬州市, 苏州市, 无锡市, 常州市]}