
并发编程的基础:
并发编程的目的:
本质是配合多核 CUP 同时处理不同的任务,优化资源的使用(软件层面的优化并行)
带来的缺点:
内存泄露:多个线程变量无法释放。使用 ThreadLocal,key 为弱引用。
上下文切换:用户核和内核态切换。引入了原子性原则,就是加锁
线程安全:避免多线程下变量和状态发生不可预知的改变。引入了可见性和有序性原则,如 volatile 关键字(底层是读写屏障),ThreadLocal,原子操作类,线程安全容器 ConcurrentHashMap 等
并发编程的三要素:
- 原子性: 通过同步关键字 synchronized 或原子数据结构(如 AtomicInteger)
- 可见性: 共享变量修改可见,使用 volatile 保证可见性(强制刷盘)和有序性(禁止指令重排)
- 有序性: 要确保线程不会因为死锁、饥饿、活锁等问题导致无法继续执行。或指令重排等问题。
体现在 JMM 内存中
线程池的基本数据结构和原理(重点)
工作原理:
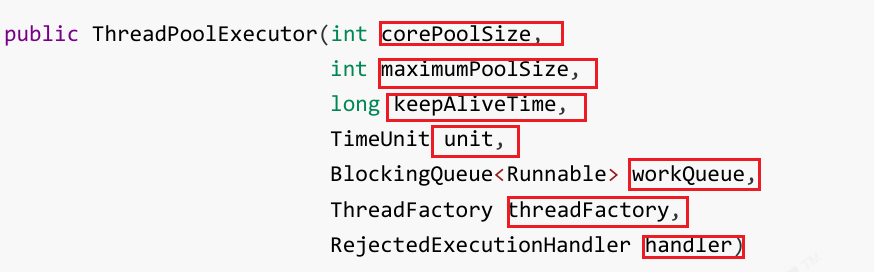
默认情况下线程不会预先创建,任务提交后才会创建,设置presartAllCoreThreads可预先创建核心线程。
线程池有5大核心参数,即核心线程,阻塞队列,最大线程数,急救线程数,拒绝策略。
- 进程数<核心线程数,创建线程来完成
- 进程数>核心线程数,核心线程已满,新任务会放到阻塞队列
- 如果选着有界队列,当阻塞队列满了,会创建急救线程来救急,当高峰过去,keepAlivetime和unit会控制救急线程的释放,减少资源的利用
- 进程数=最大线程数,即核心线程+阻塞队列+救急线程(有界队列的情况下)都满了,会采取拒绝策略
注意:最大线程数=核心线程+阻塞队列+救急线程(有界队列下)
1、设置allowCoreThreadTimeOut=true**,可回收核心线程,默认为false**
2、修改核心线程数的方法
使用 ThreadpolIExecutor.setCorePoolSizel(int corePoolSize)方法可以动态修改核心线程数。corePoolSize参数代表线程池中的核心线程数,当线程池中线程数量少于核心线程数时,会创建新的线程来处理任务。这个修改可以在线程池运行的过程中进行,立即生效。
3、怎么合理的设置线程池的线程数呢?
CPU 密集型任务
设置cpu核心线程数=核心线程数+1,因为cpu密集型任务不会阻塞线程,开的线程太多会占用内存
I/0 密集型任务
I/0 密集型任务线程数 = CPU 核心数*2
PS:以上都是经验之谈,需要根据实际情况修改
注意事项:
- 核心线程数的修改不会中断现有任务,新的核心线程数会在新任务到来时生效。
- setCorePoolSize()方法可以减少核心线程数,但如果当前线程池中的线程数量超过了新的核心线程数,多余的线程不会立即被销毁,直到这些线程空闲后被回收。
3、工作队列类型
- SynchronousQueue:不存储任务,直接将任务提交给线程。
- LinkedBlockingQueue:链表结构的阻塞队列,大小无限。
- ArrayBlockingQueue:数组结构的有界阻塞队列。
- PriorityBlockingQueue:带优先级的无界阻塞队列。
- DelayQueue :一个无界队列,队列中的元素必须实现Delayed接口,只有当元素的延迟时间到期时,才能被取出,常用于延迟任务调度。
哪些是无界队列和有界队列?
- 有界队列(如
ArrayBlockingQueue):队列容量固定。 - 无界队列(如
LinkedBlockingQueue):队列无限增长,可能导致OOM。
有哪些拒绝策略?
jdk提供的有四种:
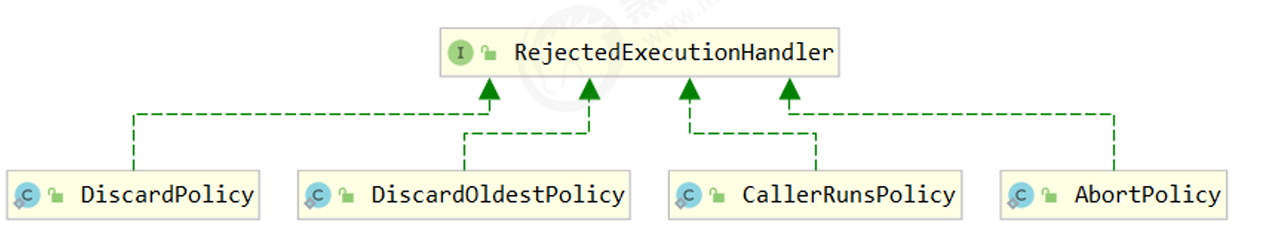
- AbortPolicy 让调用者抛出 RejectedExecutionException 异常,这是默认策略
- CallerRunsPolicy 让调用者线程运行任务,叫人
- DiscardPolicy 放弃本次任务,
- DiscardOldestPolicy 放弃队列中最早的任务(直接丢弃被拒绝的任务),本任务取而代之,放弃最早
其他拒绝策略
- Dubbo 的实现,在抛出 RejectedExecutionException 异常之前会记录日志,并 dump 线程栈信息,方便定位问题
- Netty 的实现,是创建一个新线程来执行任务
- ActiveMQ 的实现,带超时等待(60s)尝试放入队列,类似我们之前自定义的拒绝策略
- PinPoint 的实现,它使用了一个拒绝策略链,会逐一尝试策略链中每种拒绝策
自定义拒绝策略:RejectedExecutionHandler
// 继承RejectedExecutionHandler
public class CustomRejectedExecutionHandler implements RejectedExecutionHandler {
@Override
public void rejectedExecution(Runnable r, ThreadPoolExecutor executor) {
System.out.println("mianshiya.com Task " + r.toString() + " rejected");
// 可以在这里实现日志记录或其他逻辑
}
}EXecutors工具类提供了ThreadPoolExecutors线程池的类型选择(5种):
- 单线程的线程池;
- 固定数目线程的线程池;
- 每接收一个请求,就创建一个线程来执行;
- 单线程具有周期调度功能的线程池;
- 多线程,有调度功能的线程池。
ps:不要用ExecutorService executor = Executors.newFixedThreadPool(10);创建线程池,无法精准控制参数。
创建线程池的方式:(重点)
ThreadpolIExecutor 类
Executors 工厂类:
ForkJoinPool 类:
| 特性 | ThreadPoolExecutor | Executors | ForkJoinPool |
|---|---|---|---|
| 类型 | 基础线程池实现类 | 线程池工厂类 | 特殊任务分解线程池 |
| 创建方式 | 直接实例化 | 通过工厂方法创建 | 直接实例化或commonPool() |
| 任务处理 | 固定大小线程处理任务 | 包装各种线程池配置 | 工作窃取(work-stealing) |
| 适用场景 | 常规异步任务处理 | 快速创建预配置线程池 | 分治/递归/并行流任务 |
| 核心实现 | 基于任务队列 | 返回配置好的ThreadPoolExecutor | 基于工作窃取算法 |
| 线程数量 | 固定或动态 | 取决于工厂方法 | 并行度(parallelism)控制 |
关闭线程池原理和相关 API(shotdown(),shotdownNow())
前提:JDK7中有一个ctl变量(使用cas原子状态),他组合了线程数量(workerCount)和线程池状态(runState)。ThreadPoolExecutor 使用 int 的高 3 位来表示线程池状态,低 29 位表示线程数量。小知识:最高的1为,1代表负数,0代表正数
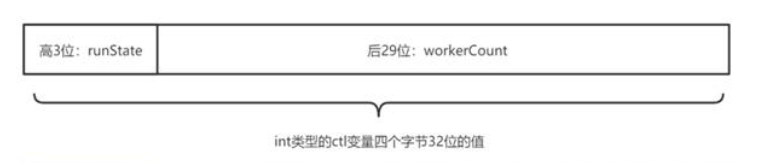
提供了五种状态:
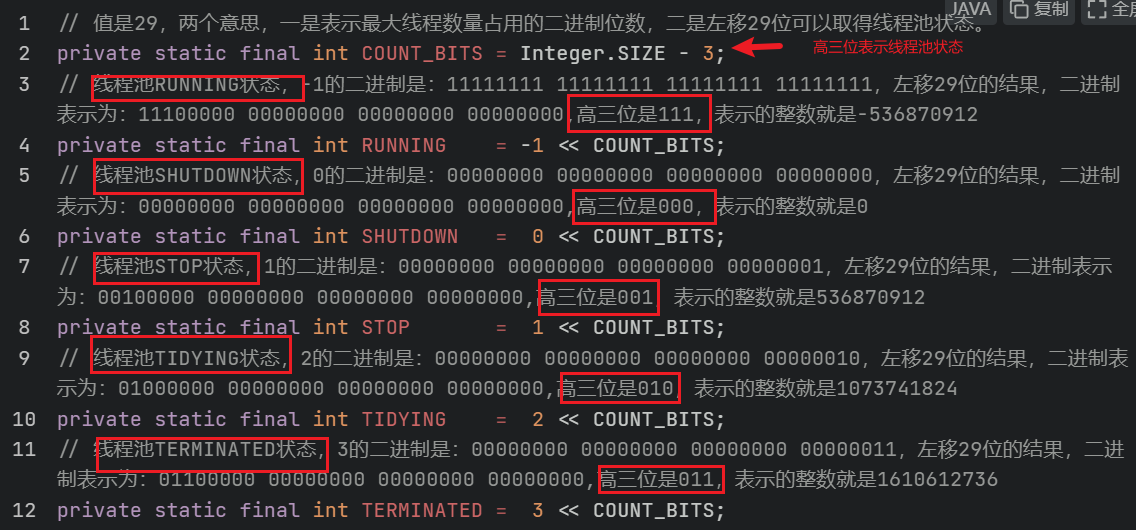
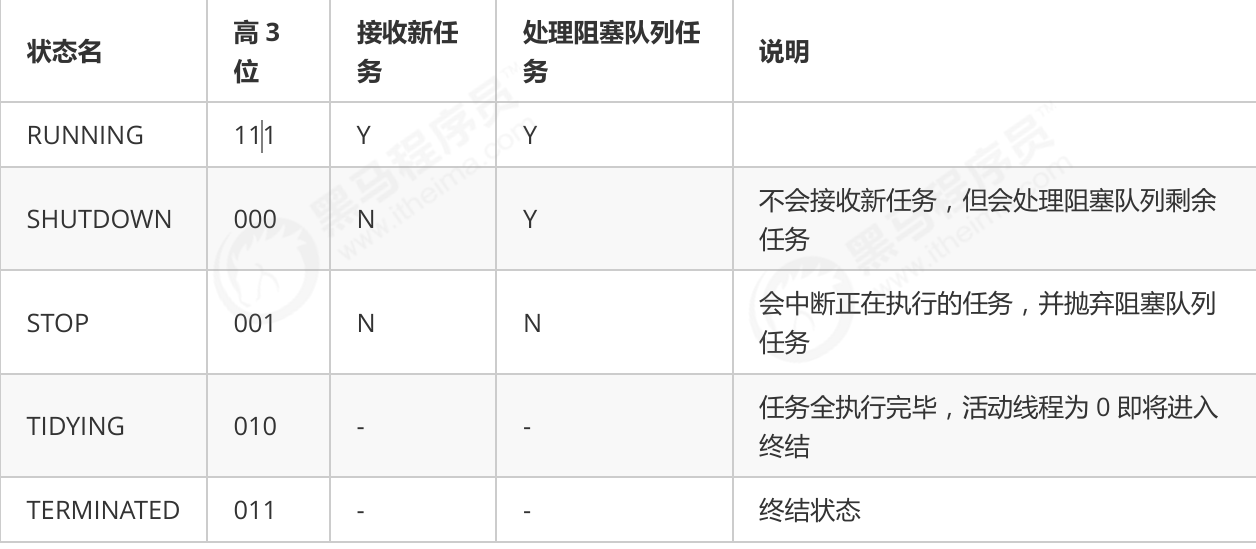
从数字上比较,TERMINATED > TIDYING > STOP > SHUTDOWN > RUNNING。
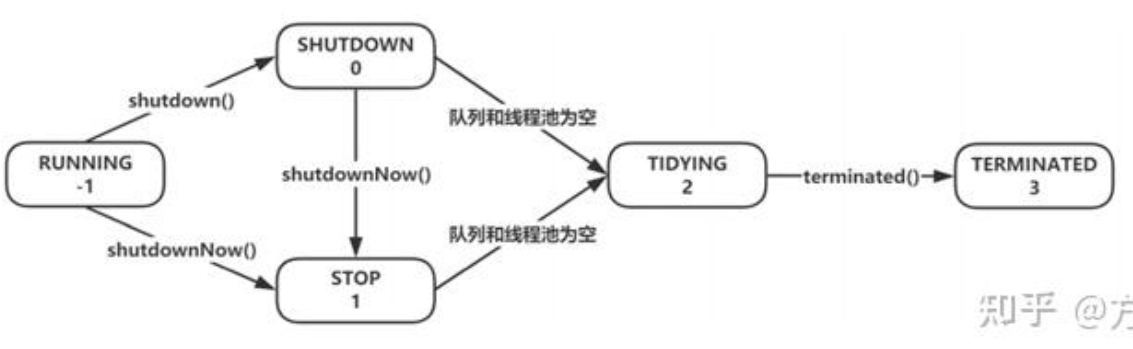
这五种状态是一个迁移的过程,从小到大迁移,-1,0,1,2,3,只会从小的状态值往大的状态值迁移,不会逆向迁移。通过shutdown()和shutdownNow()进行关闭,但是他不是真正的关闭,只是切换了状态,只有最后调用了钩子方法terminated(),进入TERMINATED状态,线程池才真正关闭。
线程池核心 API:
- 提交任务
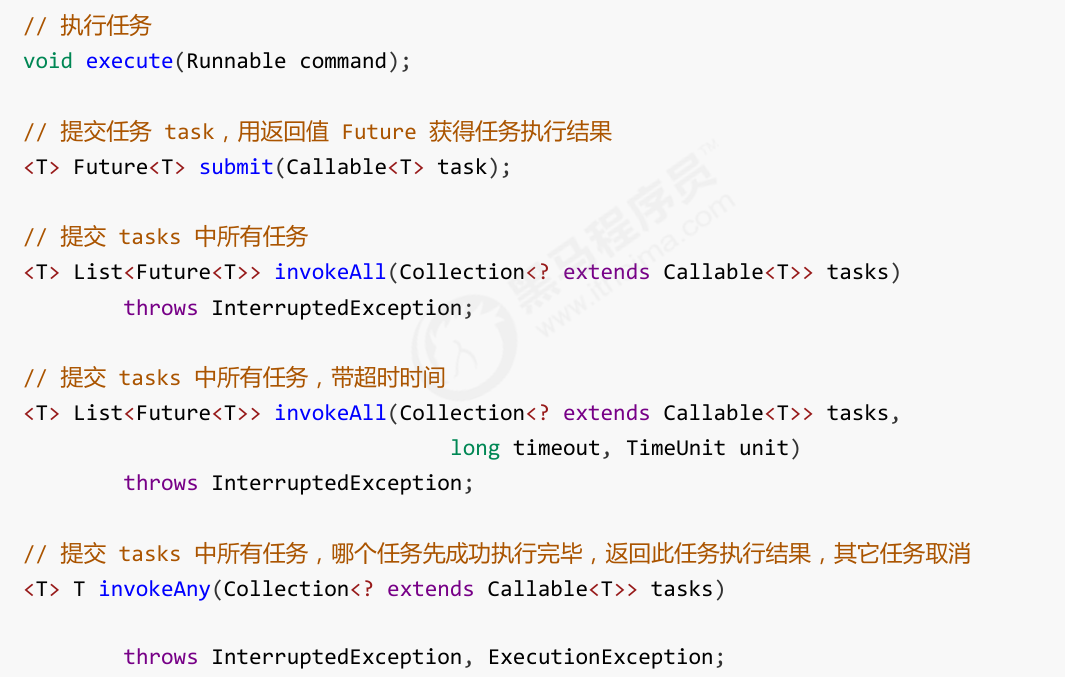
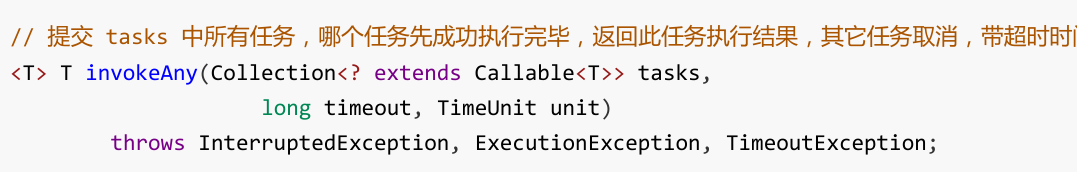
关闭线程池:shutdown()和 shutdowenNow()的异同
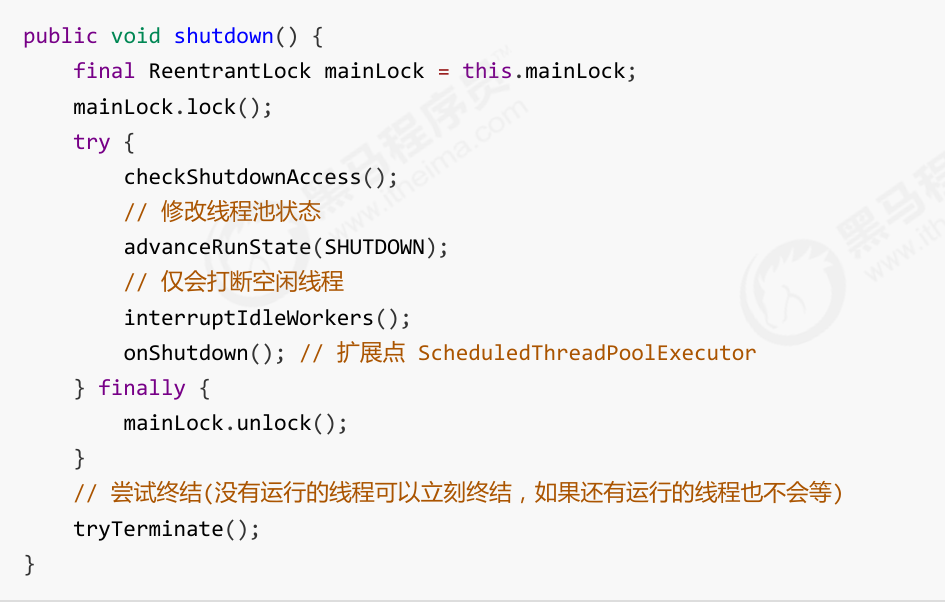
shutdown()是温和关闭线程,等待已提交的任务执行完成,不会中断正在执行的任务,返回参数为 void
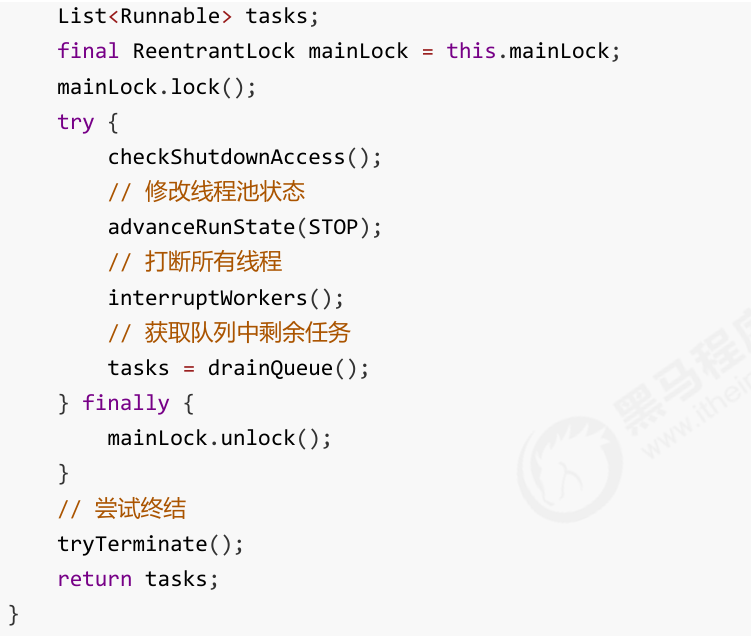
shutdowenNow()是立即关闭,通过interrupt()中断正在执行的线程(不能保证一定打断),清空任务队列,返回未执行的任务列表(List<Runnable>)
线程池中提供的 5 种 Executors工具类
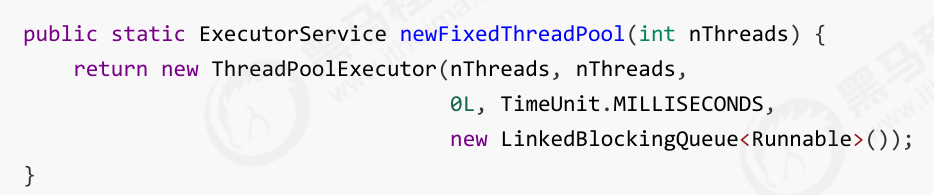
1、newFixedThreadPool(固定数目线程的线程池)
-
参数解释:
-
核心线程数nThreads=最大线程数nThreads,无救急线程,也无须对应存活时间
-
队列为双向链表,无界队列
评价 :适用于任务量已知,相对耗时的任务
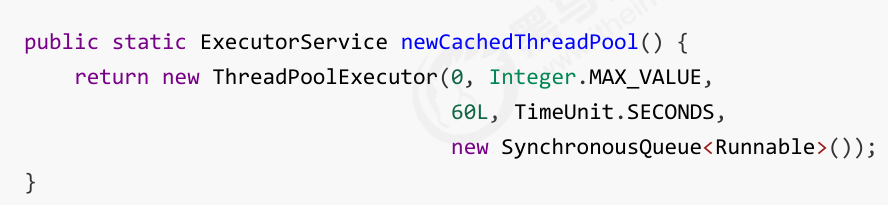
2、newCachedThreadPool(缓存线程池)
-
参数分析:
-
核心线程数是 0, 最大线程数是 Integer.MAX_VALUE,救急线程的空闲生存时间是 60s。
-
①全部都是救急线程(60s 后可以回收)
-
②救急线程可以无限创建
-
队列采用了 SynchronousQueue 实现特点是,它没有容量,没有线程来取是放不进去的(一手交钱、一手交货)
评价:整个线程池表现为线程数会根据任务量不断增长,没有上限,当任务执行完毕,空闲 1分钟后释放线程。 适合任务数比较密集,但每个任务执行时间较短的情况
3、newSingleThreadExecutor(单线程的线程池)->串行顺序执行
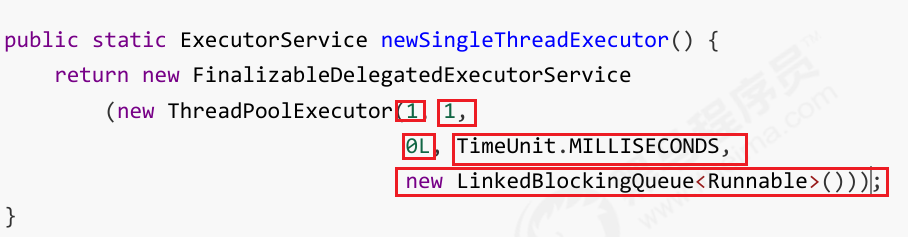
-
参数分析:
-
核心线程数是 1, 最大线程数是1,任务数多于 1 时,会放入无界队列排队。任务执行完毕,这唯一的线程也不会被释放。(相当于单线程串行执行)
-
问题:单线程的线程池和单线程的区别在哪?
-
自己创建一个单线程串行执行任务,如果任务执行失败而终止那么没有任何补救措施,而线程池还会新建一个线程,保证池的正常工作
-
和newFixedThreadPool(1) 的区别在哪?固定线程池也可以设置线程数为1呀?
-
Executors.newSingleThreadExecutor() 线程个数始终为1,不能修改
-
FinalizableDelegatedExecutorService 应用的是装饰器模式,只对外暴露了 ExecutorService 接口,因 此不能调用 ThreadPoolExecutor 中特有的方法
-
Executors.newFixedThreadPool(1) 初始时为1,以后还可以修改
-
对外暴露的是 ThreadPoolExecutor 对象,可以强转后调用 setCorePoolSize 等方法进行修改
**4、**ScheduledThreadPoolExecutor支持定时任务和周期性任务的线程池
ScheduledThreadPoolExecutor executor = new ScheduledThreadPoolExecutor(
int corePoolSize,//核心线程数
ThreadFactory threadFactory,//定义线程池的名称
RejectedExecutionHandler handler//拒绝策略
);参数分析:
- corePoolSize:核心工作的线程数量
- threadFactory:线程工厂,用来创建线程
- handler: 拒绝策略,饱和策略
DelayedWorkQueue(一种优先级队列的变种),最小堆结构,保证最早的任务先执行
评价:适合时间优先级调度,周期性性、延迟任务,但是队列是无界的,可能导致内存溢出OMM
**5、**WorkStealingPool (ForkJoinPool):基于任务窃取算法的线程池
//1.使用executor创建,不建议
ExecutorService executor = Executors.newWorkStealingPool(int parallelism);
//2.使用ForkJoinPool创建
ForkJoinPool executor = new ForkJoinPool(
int parallelism,//并行度(工作线程数)
ForkJoinPool.ForkJoinWorkerThreadFactory factory,
UncaughtExceptionHandler handler,//未捕获异常处理器
boolean asyncMode
//true:使用FIFO模式,适合事件风格任务
//false:默认的LIFO模式,适合计算密集型任务
);参数:
- 核心线程数=最大线程数=并行度,这是动态调整的
- 阻塞队列使用Deque(动态分配的双端队列),无界
- 空闲线程会超时终止
- 无显示拒绝服务,通过队列窃取解决
评价:适合处理大量小任务,充分利用CPU
创建线程的四种方法:()
1、继承Thread类
- 语法
//1、 创建线程对象
Thread t = new Thread() { public void run() { // 要执行的任务 } };
//2、 启动线程
t.start();- 例子
// 构造方法的参数是给线程指定名字,推荐
Thread t1 = new Thread("t1") {
@Override
// run 方法内实现了要执行的任务
public void run() {
// 要执行的任务
log.debug("hello");
}
};
t1.start();- 特点:直接创建线程和任务
2、实现Runnable接口
- 语法
// 1、创建Runnable接口
Runnable runnable = new Runnable() {
public void run(){
// 要执行的任务
}
};
// 2、创建线程对象
Thread t = new Thread( runnable );
// 启动线程
t.start(); - 例子
// 创建任务对象
Runnable task2 = new Runnable() {
@Override
public void run() {
log.debug("hello");
}
};
// 参数1 是任务对象; 参数2 是线程名字,推荐
Thread t2 = new Thread(task2, "t2");
t2.start();- 使用lambda创建
// 创建任务对象
Runnable task2 = () -> log.debug("hello");
// 参数1 是任务对象; 参数2 是线程名字,推荐
Thread t2 = new Thread(task2, "t2");
t2.start()-
特点:先创建任务,再创建线程
-
Thread 与 Runnable 的关系
-
Thread
-
把线程和任务合并在了一起
-
Runnable
-
把线程和任务分开了
-
更容易与线程池等高级 API 配合
-
任务类脱离了 Thread 继承体系
3、使用Callable和Future创建线程
- 语法
// 1、创建任务对象
FutureTask<Integer> task3 = new FutureTask<>(() -> {
log.debug("hello");
return 100;
});
// 参数1 是任务对象; 参数2 是线程名字,推荐
new Thread(task3, "t3").start();
// 主线程阻塞,同步等待 task 执行完毕的结果
Integer result = task3.get();
log.debug("结果是:{}", result);- 使用
- 特点
先创建任务,再创建线程。优点在于可以返回参数和异常
4、使用Executor框架创建线程池
- Executors提供了一系列工厂方法用于创先线程池,返回的线程池都实现了ExecutorService接口。
主要有newFixedThreadPool,newCachedThreadPool,newSingleThreadExecutor,newScheduledThreadPool,后续详细介绍这四种线程池
(面试)为何说只有 1 种实现线程的方法?
在面试过程中:问到线程的创建可以讲继承Thread和实现Runnable接口(这两种):
① 继承Thread是先重写run()方法再调用Thread.start()调用重写的run()方法。
② 实现runnable接口是先实现接口,再重写run()方法,最后还是调用Thread.start()调用。
我还知道线程池和Callable 也是可以创建线程的,但是它们本质上也是通过前两种基本方式实现的线程创建。
为什么说这两种方式本质上是一种呢?本质上,就是构造一个 Thread 类,这是创建线程的唯一方式。而要想实现线程执行的内容,却有两种方式,也就是可以通过 实现 Runnable 接口的方式重写run()方法,或是继承 Thread 类重写 run() 方法的方式,把我们想要执行的代码传入,让线程去执行,在此基础上,如果我们还想有更多实现线程的方式,比如线程池和 Timer 定时器,只需要在此基础上进行封装即可。
而其他的线程创建仅仅是在 new Thread() 外做了一层封装,
Runnable接口的优点在哪?
解耦(低耦合):runnable接口实现了 Runnable 与 Thread 类的解耦,Thread 类负责线程启动和属性设置等内容,权责分明。继承Thread方法就没有。
空间开销:继承Thread方式在每次执行都需要创建一个独立的栈,使用Runnable接口可以直接将任务传入线程池,不需要专门创建线程栈,浪费空间。
代码的扩展性:Java不支持多继承,接口间接的实现了多继承。
上述提到了 4 种实现线程的方法,其中一种还是创建线程池的,可以发现只有一种Callable 有返回值,而且还是Future 返回值,
这样就会导致在创建线程时,没有基础的 API 来获取线程的异常,获取线程生命周期的状态或中间值。这就引入了下面的问题:
- 线程异常的捕获
- 线程顺序的制定
- 子线程创建的返回
- ...............等。
现在版本的更新,可以获取现成的工具类来实现。
线程异常的捕获
多线程返回值没有异常返回,所以一般使用自定义线程、使用 Future 获取、在执行线程时手动 try-catch 捕获、JDK19 可以使用虚线程、设置回调函数
自定义线程、手动 try-catch 捕获、虚线程:不举例子
使用Future获取异常:同步阻塞(get()时捕获。使用 submit 提交(返回值为 Future),而不是 execute 方法,然后手动单线程 get 获取异常(会阻塞线程)
ExecutorService executor = Executors.newFixedThreadPool(2);
Future<?> future = executor.submit(() -> {
throw new RuntimeException("线程池任务异常");
});
try {
future.get(); // 这里会抛出ExecutionException
} catch (ExecutionException e) {
System.out.println("捕获到线程异常: " + e.getCause());
} catch (InterruptedException e) {
Thread.currentThread().interrupt();
}CompletableFuture(异步**Future,**推荐):
- 提供链式异常处理方法 (
exceptionally(),handle(),whenComplete())。非阻塞方式处理异常。可以直接访问原始异常。
CompletableFuture.runAsync(() -> {
throw new RuntimeException("CompletableFuture任务异常");
}).exceptionally(e -> {
System.out.println("捕获到异常: " + e.getCause());
return null; // 提供恢复值
});Future 和CompletableFuture是什么?
java5中引入的多线程中经典的 Future 模式,核心思想是异步调用。
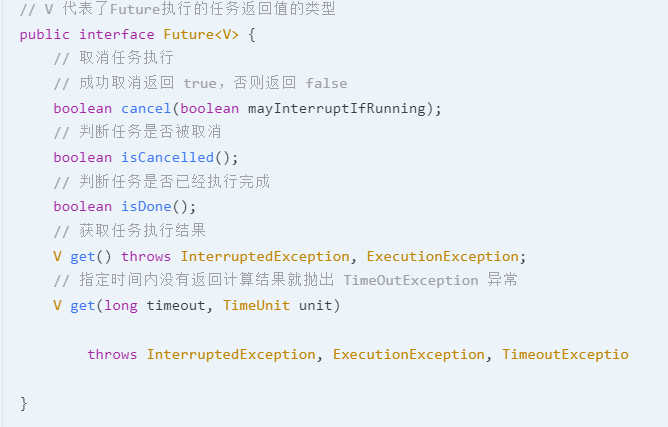
Future 类只是一个泛型接口,位于 java.util.concurrent 包下,其中定义了 5 个方法,主要包括下面这 4 个功能:
-
4大功能
-
取消任务;
-
判断任务是否被取消;
-
判断任务是否已经执行完成;
-
获取任务执行结果。
-
5大方法
-
boolean cancel(boolean mayInterruptIfRunning):尝试取消执行任务
-
boolean isCancelled():判断任务是否被取消。
-
boolean isDone():判断任务是否已经被执行完成。
-
get():等待任务执行完成并获取运算结果。
-
get(long timeout, TimeUnit unit):多了一个超时时间。
-
缺点
-
1、只能通过get方法阻塞的获取结果
-
2、无链式调用任务的能力
-
3、无异常处理功能
在java8中,解决上述Future的缺点,引入的CompletableFuture。将很多计算可以分成多个阶段或步骤,此时可以通过它将所有步骤组合起来,形成异步计算的流水线。+Future的异步功能,
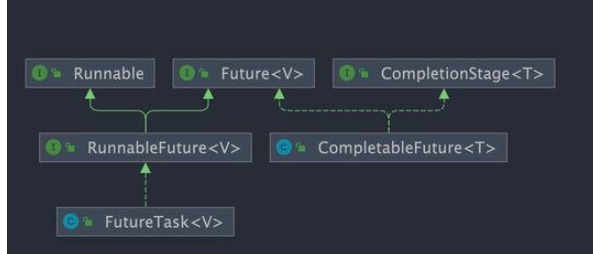
-
核心特性:
-
1.异步执行:使用 runAsync()或 supplyAsync()方法,可以非阻塞地执行任务。
-
2.任务的组合:可以使用 thenApply()、thenAccept()等方法在任务完成后进行后续操作,支持链式调用。
-
3.异常处理:提供 exceptionally()、hand1e()等方法来处理异步任务中的异常,
-
4.并行任务:支持多个异步任务的组合,如 thencombine()、a11of()等方法,可以在多个任务完成后进行操作
-
5.非阻塞获取结果:相比 Future,completableFuture 支持通过回调函数获取结果,而不需要显式的阻塞等待。
详细使用省略
怎么知道主线程中的子线程是否执行成功?(因为大部分线程执行无返回函数)
那就使用带返回值的创建线程函数如 Callable 方法,或者使用 JUC 其他相关类,或者使用****回调机制。
当使用线程执行无返回值的任务时,回调是一种常见的处理方式:回调是指将一个函数(或方法)作为参数传递给另一个函数,并在特定条件满足或事件发生时由接收方调用该函数的技术。
回调的核心本质
回调的核心不在于函数是否有返回值,而在于:
- 控制反转:由被调用方决定何时调用回调函数
- 异步通知:在某个条件满足时通知调用方
- 结果处理:通过参数(而非返回值)传递结果
控制多线程的执行顺序:
| 方法 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|
join() |
简单易用 | 必须等待线程结束 | 简单顺序控制 |
| 单线程线程池 | 自动管理线程 | 无法实现复杂交互 | 任务队列顺序执行 |
CompletableFuture |
功能强大,链式调用 | 学习曲线略高 | 异步任务流水线 |
同步工具类CountDownLatch |
灵活控制 | 代码相对复杂 | 多线程复杂协作 |
LockSupport.park() |
最底层控制,非常灵活 | 需要手动管理每个线程的状态 | 需要精确控制线程阻塞/唤醒的场景 |
1、使用join方法
Thread t1 = new Thread(() -> System.out.println("线程1"));
Thread t2 = new Thread(() -> System.out.println("线程2"));
Thread t3 = new Thread(() -> System.out.println("线程3"));
t1.start();
t1.join(); // 等待t1完成
t2.start();
t2.join(); // 等待t2完成
t3.start();
t3.join(); // 等待t3完成
----------------------------------------------------------------------------
2、单线程线程池内部是顺序执行的
ExecutorService executor = Executors.newSingleThreadExecutor();
executor.submit(() -> System.out.println("任务1"));
executor.submit(() -> System.out.println("任务2"));
executor.submit(() -> System.out.println("任务3"));
executor.shutdown();
----------------------------------------------------------------------------
3、CompletableFuture链式调用
CompletableFuture.runAsync(() -> System.out.println("阶段1"))
.thenRun(() -> System.out.println("阶段2"))
.thenRun(() -> System.out.println("阶段3"));
---------------------------------------------------------------------------
4、LockSupport.park() 更加底层
Thread t1 = new Thread(() -> {
System.out.println("线程1执行");
});
Thread t2 = new Thread(() -> {
LockSupport.park(); // 等待被唤醒
System.out.println("线程2执行");
});
Thread t3 = new Thread(() -> {
LockSupport.park(); // 等待被唤醒
System.out.println("线程3执行");
});
t1.start();
t2.start();
t3.start();
// 控制顺序
LockSupport.unpark(t2); // 唤醒t2
LockSupport.unpark(t3); // 唤醒t3主线程和守护线程区别
JAVA中的线程主要分为两类:用户线程(User Thread)和守护线程(Daemon Thread)。
- 默认都是用户线程,因此用户线程也被称为普通线程。
- 守护线程也被称之为后台线程(经典的就是垃圾回收器),为用户线程服务的,优先级与用户线程一致,生命周期和线程一致。
设置为守护线程:在创建完用户线程后,使用 start 方法前(启动后不能设置了),使用线程名称.setDaemon(true) ;设置为守护线程。用线程名称.isDaemon()判定是否为守护线程。
线程同步:
这是指多线程下导致资源不同步的问题,解决方法:加锁(悲观锁)。使用Synchronized或 ReentrantLock,还有原子类和其他并发工具类。
Synchronized 原理是基于 JVM 的 Montior 和对象头。
ReentrantLock 原理是基于 AQS 原理
什么是协程?Java 中协程的实现?
协程是比线程更加轻量级的执行单位,它的调度是由应用程序实现的,比线程更加轻量级,切换不涉及到内核态的参与,开销小。
jdk19引入了虚拟线程,jdk21确认,可以认为是java对协程的一种实现。
线程与协程的区别:
- 线程由操作系统调度,涉及内核态与用户态的切换:协程由应用程序进行调度,不涉及内核态与用户态的切换,
2.1O操作会阻塞线程;协程只会挂起,整个线程不阻塞,其它协程还能继续运行。
**场景:**高并发应用;1O密集型应用
| 特性 | 虚线程 | 平台线程 |
|---|---|---|
| 资源占用 | 非常轻量(KB级) | 较重(MB级) |
| 创建数量 | 百万级别 | 千级别 |
| 调度方式 | JVM调度(用户态) | OS调度(内核态) |
| 阻塞代价 | 几乎无代价 | 高代价 |
| 适用场景 | IO密集型任务 | CPU密集型任务 |
多线程之间如何进行通信?
1、共享变量
2、同步机制
synchronized:确保只有一个线程能访问资源
ReentrantLock:配合Condition类的wait、notify方法实现等待/通知机制
volatile:确保变量的可见性,防止指令重排
blockingQueue:阻塞队列实现生产者-消费者模式
悲观锁(管程):
Java 线程的状态和对应调度方法()
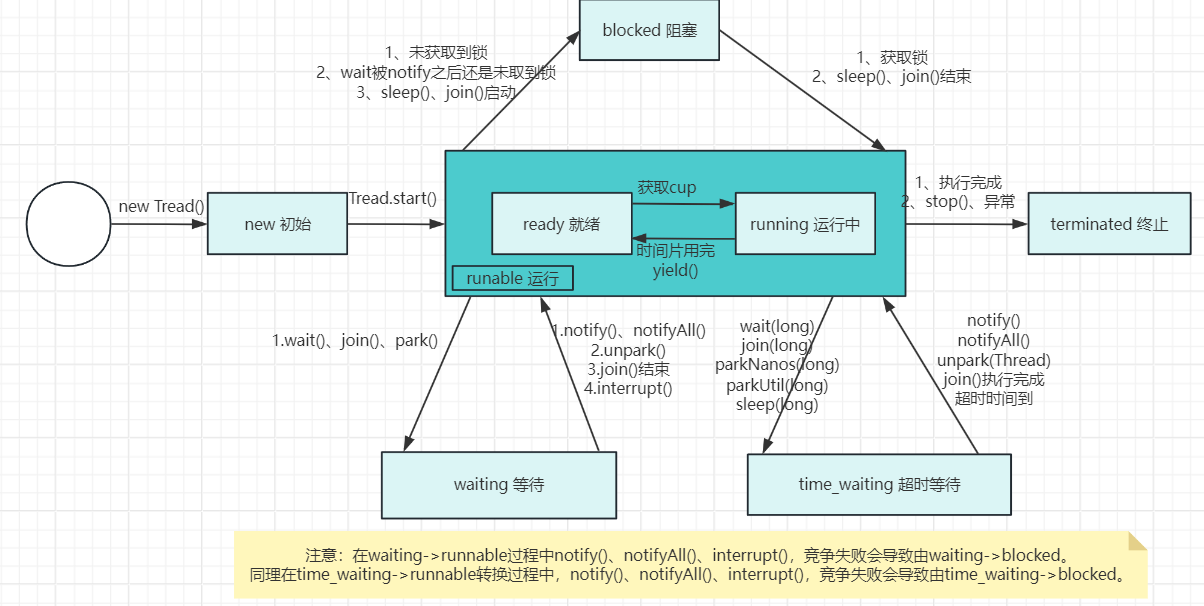
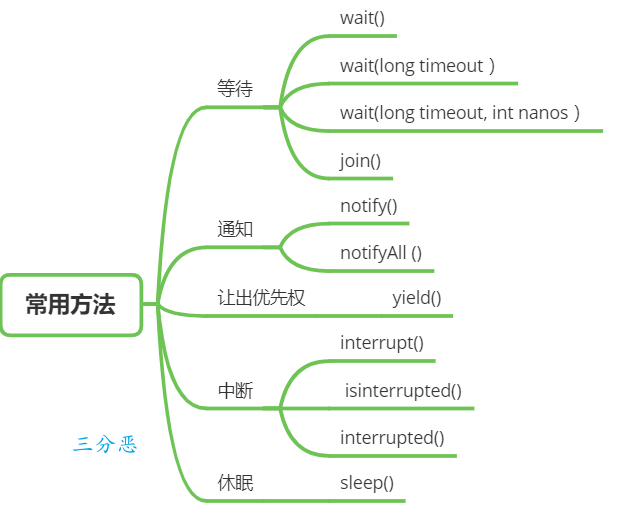
启动方法类:
start(): 启动一个新线程,在新的线程运行 run 方法中的代码run():新线程启动后会调用的方法,在主线程中启动
线程等待类:
join([long n]):让调用它的线程(如主线程)等待子线程结束。可以理解为子线程.join(),实际是主线程调用,然后主线程根据实现的不同进入 blocked 或 waiting 状态。这样可以让主线程等待子线程执行完成。wait([long timeout,int nanos]): 根据使用的参数不同, 使线程进入等待队列。不会自动唤醒,需要在同步(Synchronized)加锁再配合 notify(),notifyAll()唤醒线程。
通知方法类:
notify(): 唤醒 wait 线程是任意的(本质是获取 Monitor 获取 Owner 变量的顺序导致的),但具体看实现类型;通常JVM 使用 hotspot ,在调用该方法时:本质是实现一个队列 DequeueWaiter()获取Monitor 的 Owner 变量,所以是按先进先出的顺序唤醒的。notifyAll():唤醒全部线程。
打断线程类(取消阻塞状态):
interrupt():如果被打断线程正在 sleep,wait,join 会导致被打断的线程抛出 InterruptedException,并清除打断线程标记为false。如果打断的正在运行的线程,则会设置打断标记为true。park 的线程被打断,也会设置打断标记为ture。这些为ture的标记会在执行sleep,wait,join时重新唤醒并抛出异常。注意:调用interrupt()方法,立刻改变的是中断状态,但如果不是在阻塞态,就不会抛出异常;如果在进入阻塞态后,中断状态为已中断,就会立刻抛出异常isInterrupted():判断是否被打断,不会清除 打断标记interrupted():静态方法。判断当前线程是否被打断,会清除 打断标记
暂停类:(是 AQS 的基石,释放 CUP,不释放锁)
LockSupport.park();暂停当前线程LockSupport.unpark(暂停线程对象);恢复某个线程
休眠类:(让出 cup 资源,从 running 进入到 Blocked)
sleep(long n):让当前执行的线程休眠n毫秒, 休眠时让出 cpu 的时间片给其它线程。sleep(0):至少暂停指定时间(即使0ms),强制重新调度,进入TIMED_WAITING状态 。**yield()**只是一个提示,可能重新调度(现代 JVM 可能会忽略),保持RUNNABLE状态(说成就绪状态也行)
优先权类:(是让出时间片,从 running->就绪状态)
yield():提示线程调度器 让出当前线程对 CPU的使用- 应用场景:主要是为了测试和调试。
ps:
1、cup和锁的释放:本质上 blocked 、waiting、timeout_waiting 都是释放了 cup 资源,释放锁就是 wait()方法由于是在Synchronized 临界区上的,作用的线程是有锁的,所以需要释放锁。其他方法不会释放锁。
2、细讲一下 wait 和 notify 方法原理:
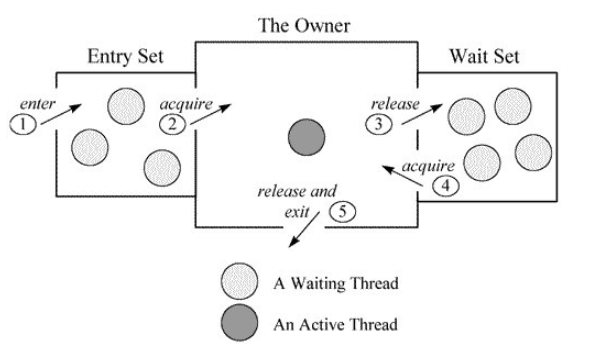
底层是针对对象的 Monitor 监控器进行竞争,线程调用对象的 wait()释放该对象 Monitor( _Owner 变量=null),我的理解就是释放锁了。然后只有拥有对象的 Monitor 才能调用 notify,notifyAll 方法,(所以才说唤醒线程是随机的,但是在 JVM 中 hotspot 是队列,所以是按顺序的。)
3、LockSupport.park();和 LockSupport.unpark();原理: 是 AQS 的基石,提供了线程挂起和唤醒的能力。
4**、sleep和wait区别 难度系数:☆**
1.sleep方法 属于Thread类中的方法 释放cpu给其它线程 不释放锁资源 seep(1000) 等待超过1s被唤醒
2.wait方法 属于Object类中的方法 释放cpu给其它线程,同时释放锁资源 wait(100)等待超过1s,被唤醒 wait()一直等待需要通过notify或者notifyAI进行唤醒 。wait方法必须配合 synchronized 一起使用,不然在运行时就会抛出"egalMonitorStateException异常"s
AQS是什么?
简单来说 AQS 抽象队列同步器”(AbstractQueuedSynchronizer) 就是起到了一个抽象、封装的作用,将一些排队、入队、加锁、中断等方法提供出来,便于其他相关 JUC 锁的使用,具体加锁时机、入队时机等都需要实现类自己控制。(我的理解为制定了一个加锁解锁的模版)
常见的实现类:ReentrantLock、countDownLatch、semaphore 、ReadWriteLock等等
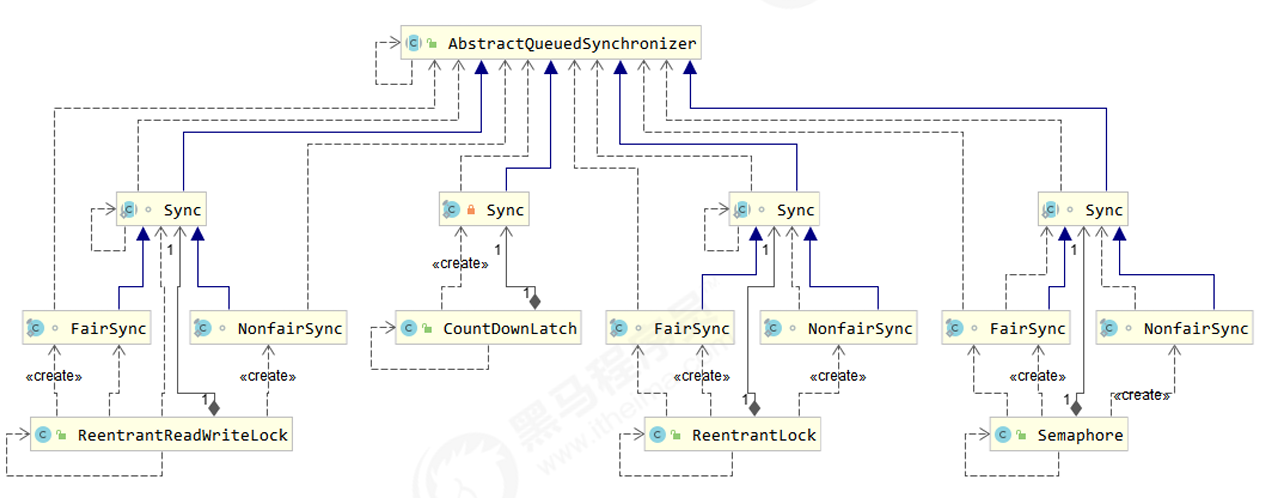
核心机制:
-
1、维护一个共享状态(state)
-
(分独占模式(排它锁)和共享模式(非排它锁)),子类需要定义如何维护这个状态,控制如何获取锁和释放锁
-
getState - 获取 state 状态
-
setState - 设置 state 状态
-
compareAndSetState - cas 机制设置 state 状态
-
独占模式是只有一个线程能够访问资源如,而共享模式可以允许多个线程访问资源
独占模式:只有一个线程能获取同步状态,例如ReentrantLock。
共享模式:多个线程可以同时获取同步状态,例如 Semaphore 和 ReadWriteLock
这个 state 结合判断语句,可以实现公平和非公平锁的实现,类似 Monitor 机制,来实现顺序执行。
-
2、提供了基于 FIFO 的等待队列,类似于 Monitor 的 EntryList
-
队列是一个变体的 CLH 队列,采用双向链表结构,节点包含线程的引用、等待状态以及前驱和后继节点的指针。单向无锁队列
-
数据结构:
-
static final class Node { static final Node SHARED = new Node(); static final Node EXCLUSIVE = null; volatile int waitStatus; volatile Node prev; volatile Node next; volatile Thread thread; // 保存等待的线程 Node nextWaiter; ..... }
-
CLH 好处:
-
无锁,使用自旋
-
快速,无阻塞
-
3、条件变量来实现等待、唤醒机制,支持多个条件变量,类似于 Monitor 的 WaitSet
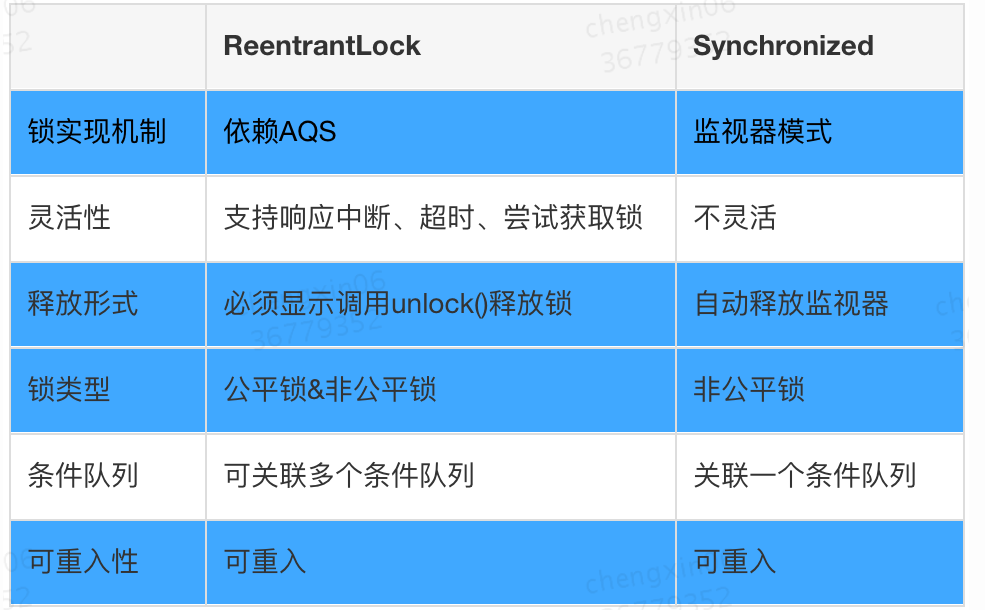
Synchronized 原理和ReentrantLock的区别?
Synchronized 是 Java 内置的关键字,实现基本的同步机制,不支持超时,非公平,不可中断,不支持多条件。
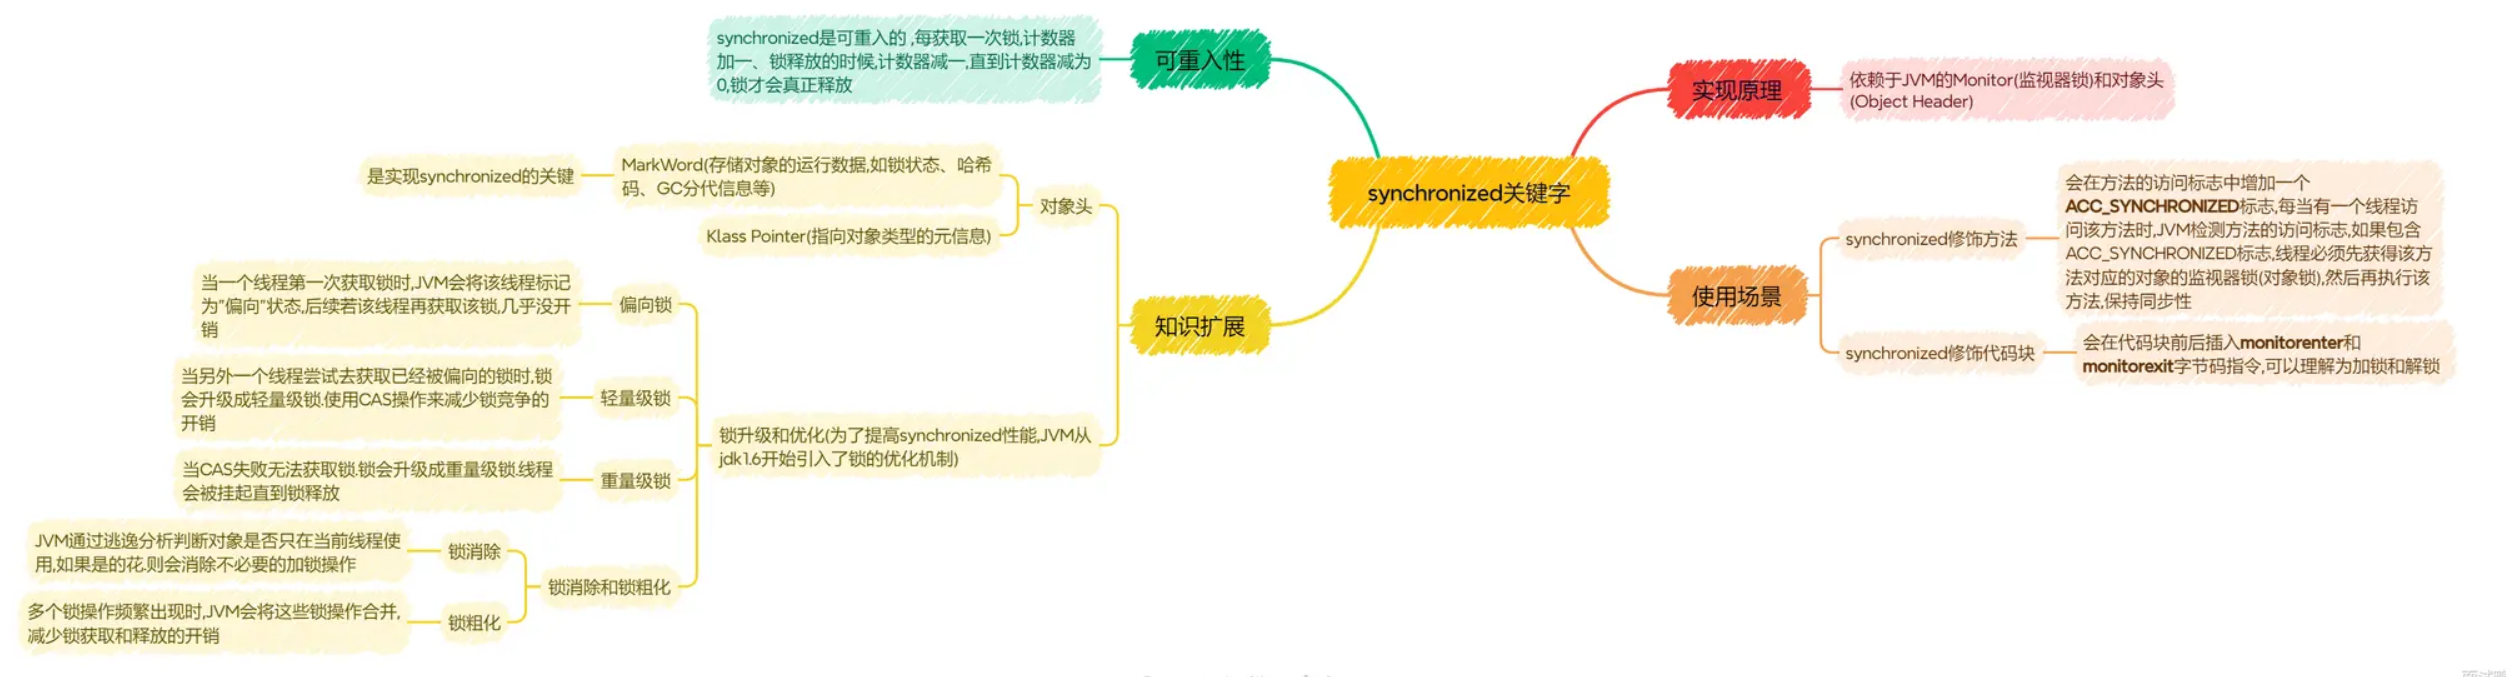
Synchronized 修饰静态方法,本质是在 class 类上加锁(类锁),所以创建多个相同的类对象,都是共享一个锁。
修饰实例方法,本质是在一个实例对象上加锁(this 上加锁),多个对象就是多个不同的锁。
修饰代码块,更细化的范围。
ReentrantLock 是JUC类库提供的,由 JDK1.5引入,支持设置超时时间,可以避免死锁,比较灵活,并且支持公平锁,可中断,支持多条件判断。
ReentrantLock 需要手动解锁,而 Synchronized 不需要,它们都是可重入锁。
-
(1) 可中断并且可以设置超时时间。
-
tryLock()
-
(2) 可以根据业务场景使用公平锁或非公平锁。
-
//默认是不公平锁false,需要在创建时指定为公平锁(true)
ReentrantLock lock = new ReentrantLock(true); -
(3) 获取锁可设置超时。
-
(4) 可绑定多个条件(Condition)。
-
由前面的Synchronized原理是由 Monitor(锁)来制定的,但是缺点是只能关联一个队列。那一旦条件队列多了起来呢?用条件变量Condition来控制
一般情况下用 Synchronized 足矣,比较简单,而 ReentrantLock 比较灵活,支持的功能比较多,所以复杂的情况用ReentrantLock
**性能问题:**很多年前,Synchronized 性能不如 ReentrantLock,现在基本上性能是一致的。
重入锁的本质是state状态变量的加减,=0则释放锁,+1代表抢到锁,又抢到锁再+1。释放锁-1,直至=0释放锁。不可重入锁,state只有1和0。
Synchronized是可修饰代码块和方法
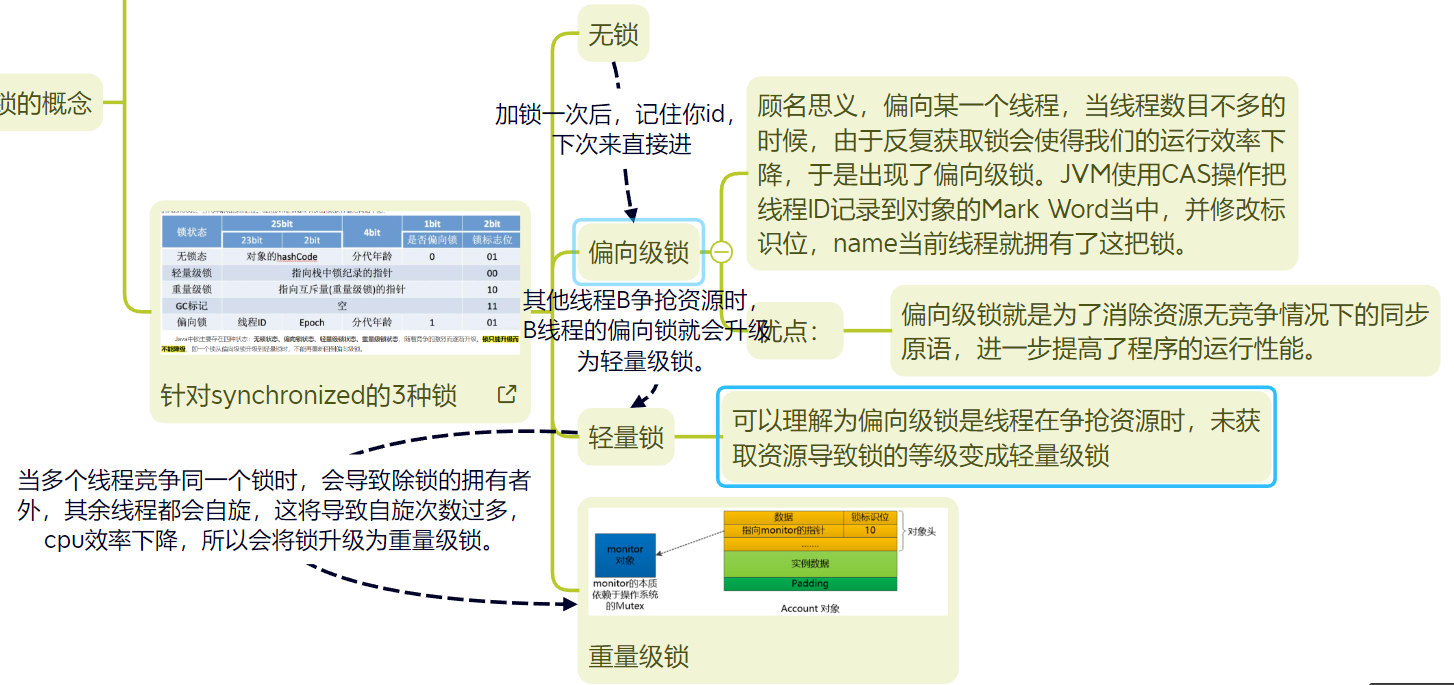
Synchronized锁升级过程:
**偏向锁:**一个线程第一次获取锁,JVM记录线程ID到对象头Mark Word,即为“偏向”状态,后续该线程再次进入该锁,不需要额外的同步操作。当另外一个线程申请该锁时,JVM撤销偏向锁,变成轻量级锁。
**轻量锁:**当多个线程争抢同一锁时,使用CAS操作减少锁的竞争开销。
**重量级锁:**当多个线程争抢激烈时,轻量锁 CAS 失败,升级成重量级锁,阻塞当前线程,唤醒(竞争)其他线程来获取该锁(竞争失败出现自旋)。但是会导致进行上下文切换(即线程状态的切换导致的 CPU 内存消耗),导致性能下降。
最后重量锁释放之后(释放的条件是Synchronized 内代码执行完成或抛异常),变成无锁。然后有线程竞争时,开始锁升级的过程。
ReentrantLock 原理(独占锁,只允许一个线程获取锁)
-
(1) 可中断并且可以设置超时时间。
-
tryLock()
-
(2) 可以根据业务场景使用公平锁或非公平锁。
-
-
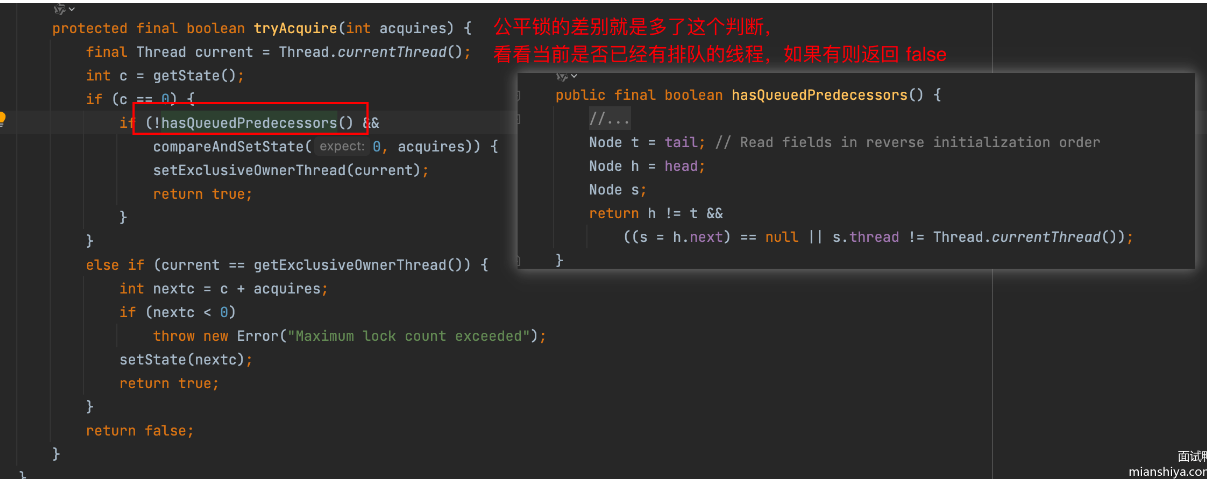
公平锁代码,与非公平锁的区别就是tryAcquire()函数,会检查CLH队列的前驱结点,有则不会去竞争
-
公平,不论是读锁,还是写锁,只要队列中有其他线程在排队(排队等读锁,或者排队等写锁),就不能直接去抢锁,要排在队列尾部。
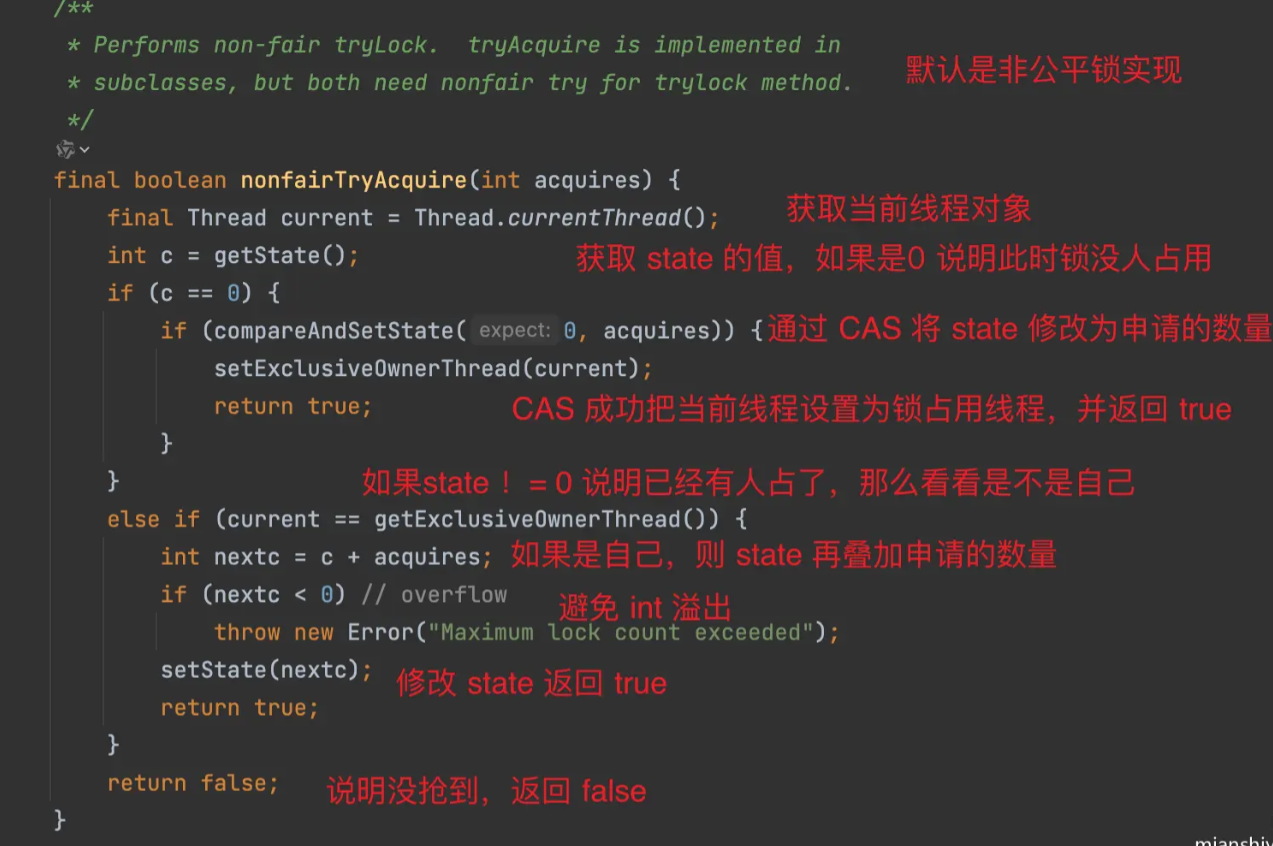
-
非公平锁代码,可以发现是通过CAS中的state值来实现可重入
-
-
非公平锁的流程
-
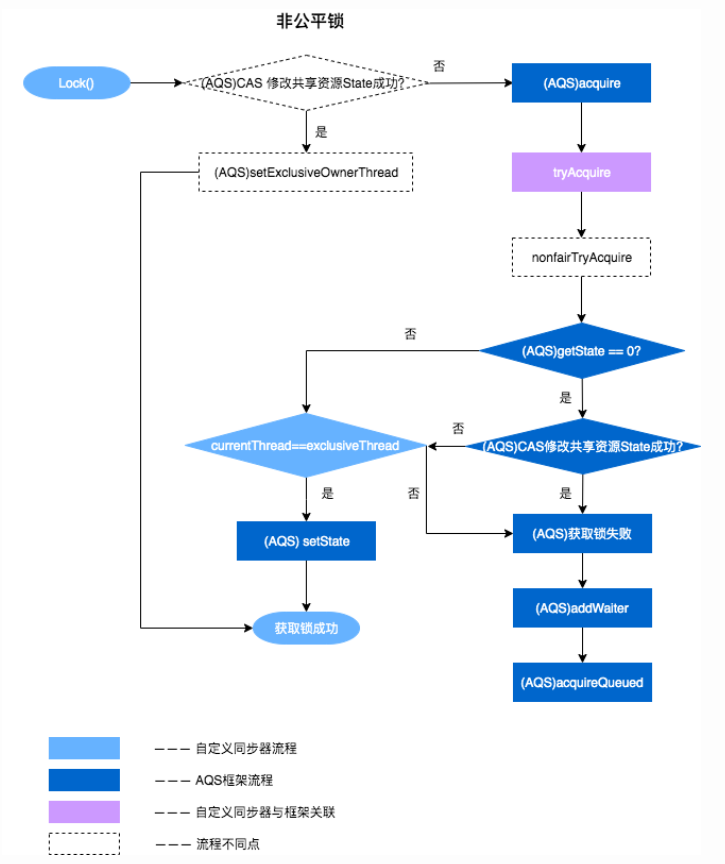
-
非公平(读锁):读锁是共享锁,多个线程会同时持有读锁,所以读线程就不是直接抢了,有一个约束,如果队列的第1个元素是写线程的时候,读线程也要阻塞,不能直接去抢。即偏向写线程。因为如果当前读锁被一个读线程持有,其他读线程又在抢,那么可能写锁永远都没机会拿到锁了,无法写入。
-
非公平(写锁):写锁是排他锁,写线程能抢锁,前提是state=0,只有在没有其他线程持有读锁或写锁的情况下,它才有机会去抢锁。或者state != 0,但那个持有写锁的线程是它自己,再次重入。
-
(3) 获取锁可设置超时。
-
(4) 可绑定多个条件(Condition)。
-
如state,本质上可重入,不可重入。公平锁,非公平锁都是根据state的大小判定来执行的
-
ReentrantLock()源码分析:
-
加锁原理
-
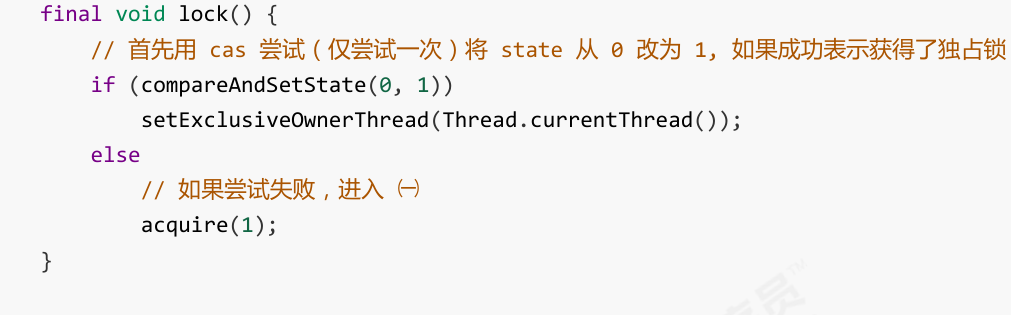
-
lock(),就是将state设置为1
-
acquire()获取锁。检查state,进入队列
-
解锁原理:.....
-
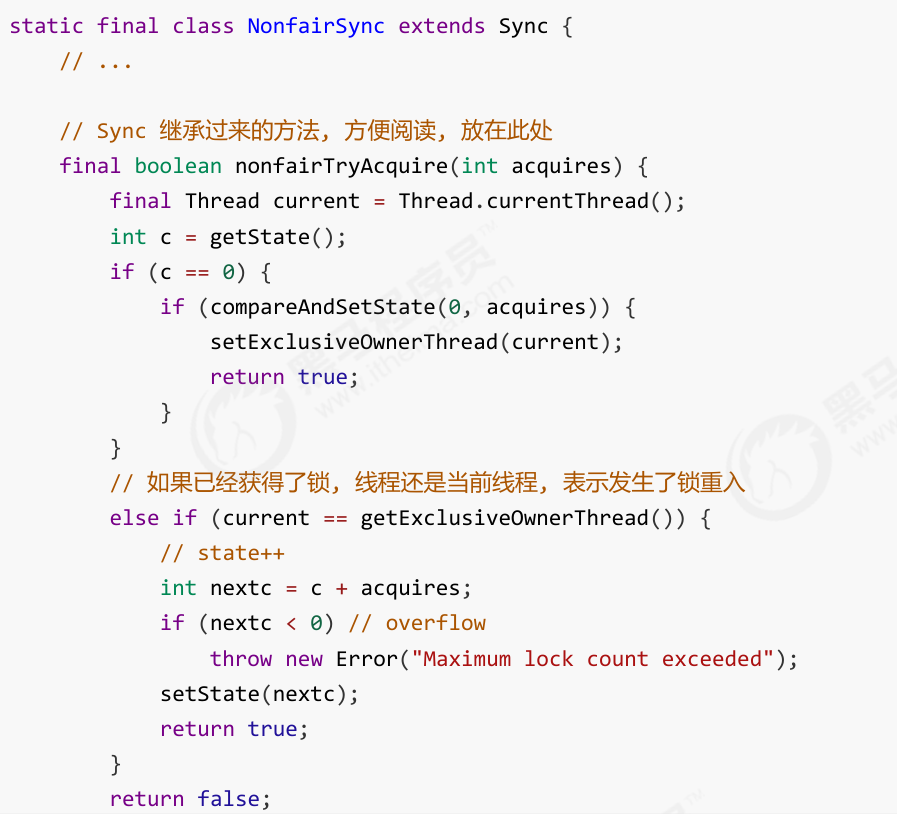
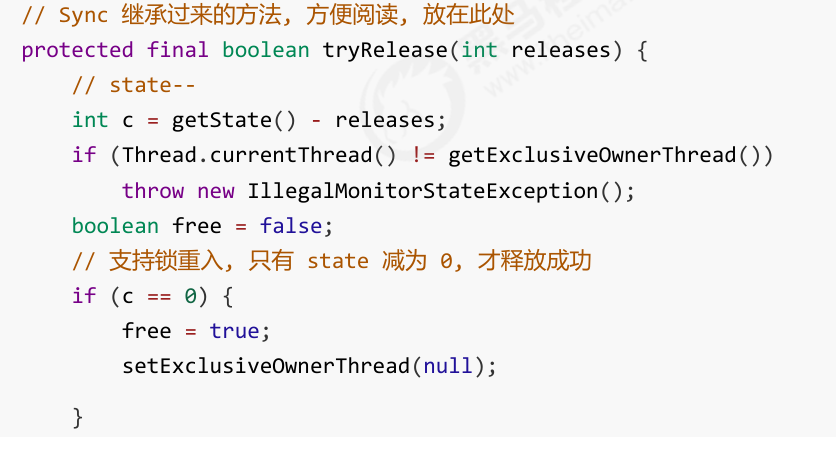
可重入源码:
-
可重入源码1
-
本质上过程为:
-
1、lock():线程A进入锁,state由0变1.
-
2、nonfairTryAcquire():重入时,判定是否为该线程,是的话state++
-
3、 tryRelease():释放时,只有state--到0时,才释放成功。
-
可打断
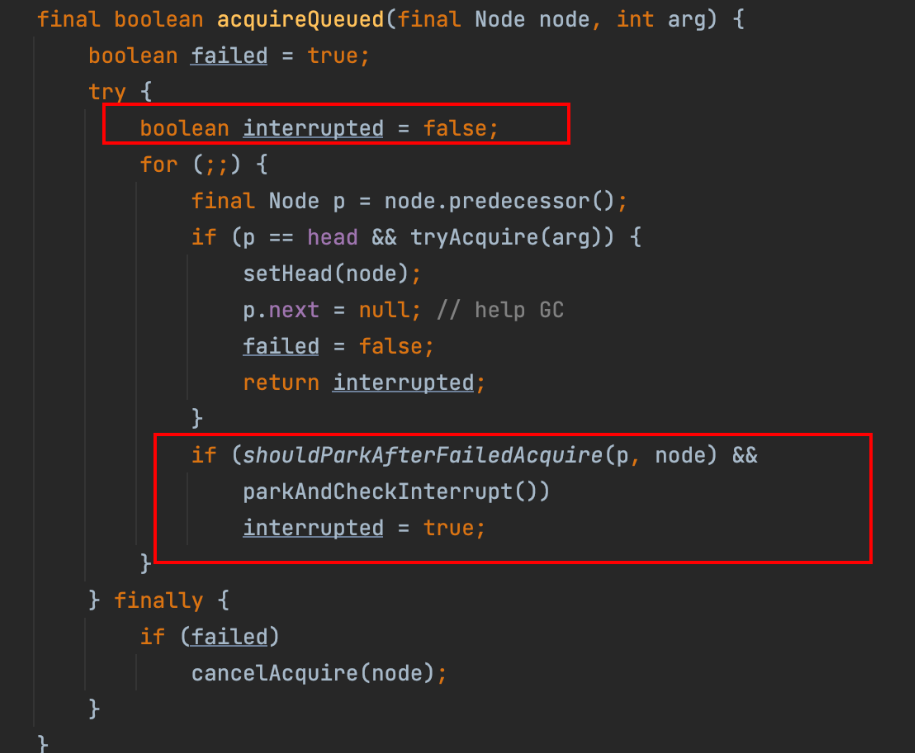
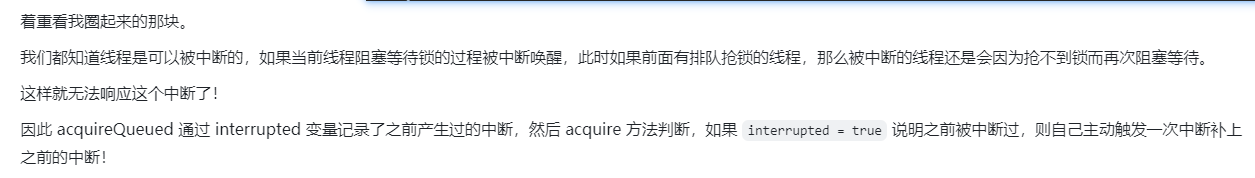
读写锁 ReentrantReadWriteLock(共享锁+独占)
在悲观锁中,基于 AQS 思想实现的有很多,其中在独享锁和共享锁之间,经典的有ReadWriteLock 接口,仅实现了读写锁两个方法。而 ReentrantReadWriteLock 是它的主要实现类。
// 接口定义
public interface ReadWriteLock {
Lock readLock();
Lock writeLock();
}
// 主要实现类
public class ReentrantReadWriteLock implements ReadWriteLock {
// 实现接口方法
public Lock readLock() { /*...*/ }
public Lock writeLock() { /*...*/ }
// 其他实现细节...
}注意:
- 读锁是共享锁,可以多个线程同时获得;写锁是独占锁,同一个时间只能一个线程获取。
- 写锁线程可以直接获取读锁,不用先释放写锁,但是不能读锁直接获取写锁。
- 读写锁提供了两种模式,公平和非公平锁,即可以顺序执行也可以非顺序执行
StampedLock :
Java 8 引入的一种 新型读写锁,它在 ReentrantReadWriteLock 的基础上进行了重大优化,主要特点包括:
- 乐观读锁:允许读操作不加锁,通过"邮戳(Stamp)"机制验证数据一致性,所以读更快,支持锁升级/降级,但是这样容易造成死锁。
- 无重入设计:不同于
ReentrantReadWriteLock,StampedLock 不可重入,吞吐量高。
缺点:不可重入(导致获取尝试重复获取已持有的锁时,会立即阻塞),还是有悲观锁,可能导致饥饿;
ReentrantReadWriteLock 之前只有悲观读锁,现在增加了乐观锁(用版本号机制控制状态,最终验证有效性)
读写特性:
- 写锁(write lock):独占锁,和
ReentrantLock一样,拥有排他性。 - 悲观读锁(read lock):共享模式的加锁,可以多个线程读,写锁需要等待读锁才能获取。
- 乐观读锁(optimistic read lock):无锁机制(CAS),可以快速读数据,利用 stamp 验证数据的最终一致性,如果不一致,告知调用方需要处理不一致状态(变成悲观锁)。(不跟数据库一样有回滚机制)
| 特性 | **StampedLock** |
**ReentrantReadWriteLock** |
|---|---|---|
| 锁类型 | 悲观读锁 + 乐观读锁 | 仅悲观锁 |
| 重入性 | ❌ 不支持 | ✅ 支持 |
| 公平性 | ❌ 仅非公平模式 | ✅ 可配置公平/非公平 |
| 条件变量 | ❌ 不支持 Condition | ✅ 支持 |
| 性能 | 高吞吐(低竞争时) | 中等 |
| 锁降级 | ✅ 需手动控制 | ✅ 内置支持 |
自适应自旋锁、锁膨胀(锁升级)、锁消除 、锁粗化
-
自适应自旋锁的背景是多并发悲观锁的情况下,另一线程未抢到锁,有两种处理方式:自旋锁(不阻塞,循环等待),互斥锁(阻塞自己)。其中自旋锁(spinlock)就是间隔一段时间后再尝试获取,好处就是只需要自旋(循环等待),无须进行用户进程和内核切换的花销。
-
锁膨胀是指 synchronized 从无锁升级到偏向锁,再到轻量级锁,最后到重量级锁的过程,它叫做锁膨胀也叫做锁升级。
-
锁消除指的是在某些情况下,JVM 虚拟机如果检测不到某段代码被共享和竞争的可能性,就会将这段代码所属的同步锁消除掉,从而到底提高程序性能的目的。
-
锁粗化是指,将多个连续的加锁、解锁操作连接在一起,扩展成一个范围更大的锁
-
可以理解为扩大加锁范围,不用在小范围的频繁加锁和解锁
如何优化Java锁的使用:
1)减小锁的粒度(使用的时间)
- 尽量缩小加锁的范围,减少锁的持有时间。即在必要的最小代码块内使用锁,避免对整个方法或过多代码块加锁。
- 使用更细粒度的锁,比如将一个大对象锁拆分为多个小对象锁,以提高并行度(参考HashTable和concurrentHashMap 的区别)
- 对于读多写少的场景,可以使用读写锁(ReentrantReadwriteLock)代替独占锁。
2)减少锁的使用:
- 通过无锁编程、CAS(Compare-And-swap)操作和原子类(如 AtomicInteger 、atomicReference)来避免使用锁,从而减少锁带来的性能损耗,
- 通过减少共享资源的使用,避免线程对同一个资源的竞争。例如,使用局部变量或线程本地变量(Threadlocal)来减少多个线程对同一资源的访问。
Java并发类工具(同步类工具)有哪些?
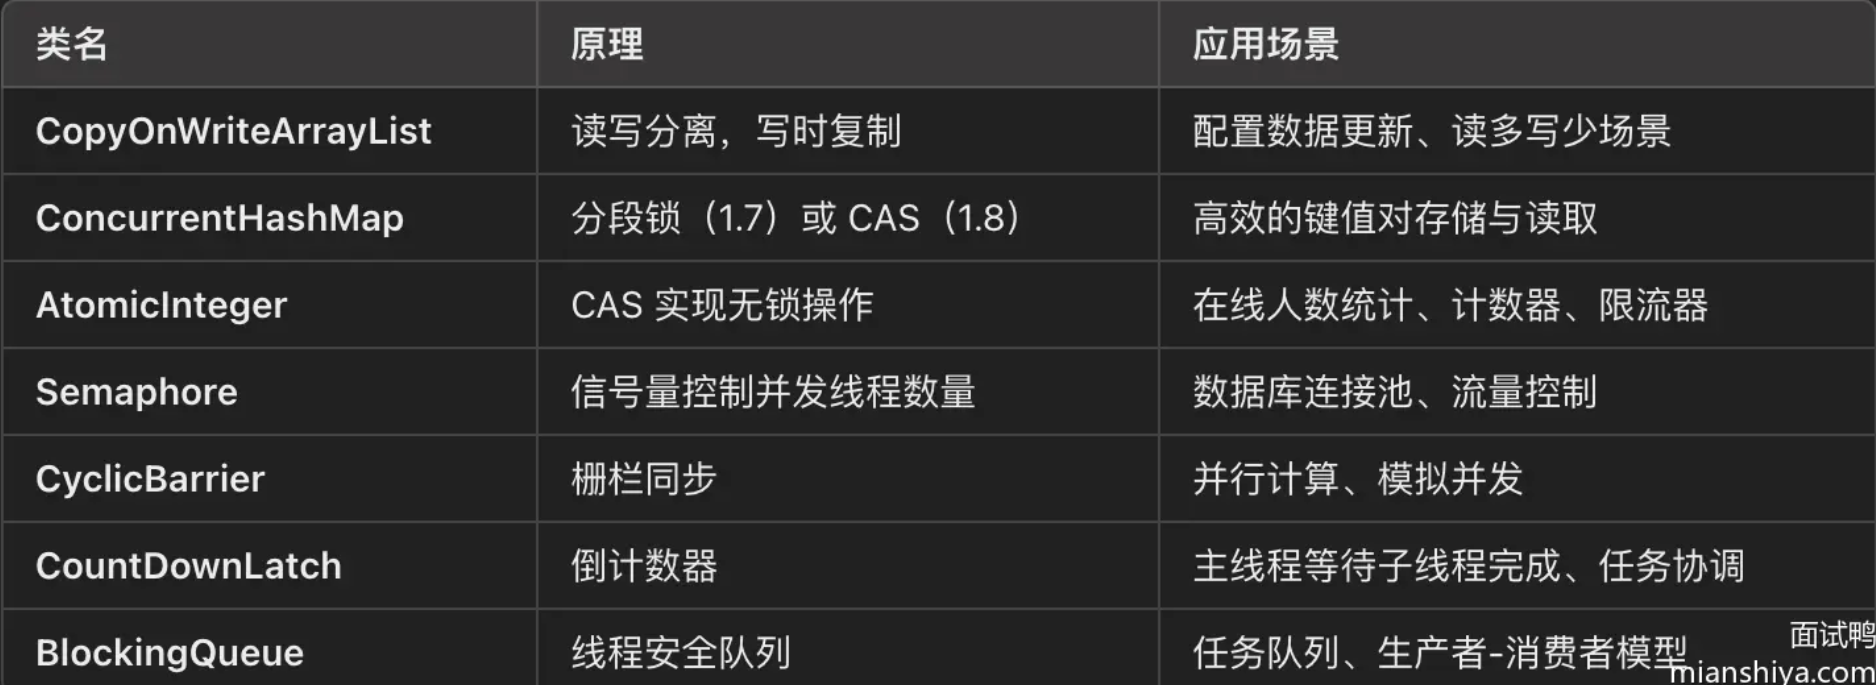
semaphore(信号量)
-
Semaphore(信号量)是Java 并发包中的一个同步工具类,用于管理一组许可(permits)。每个许可可以被一个线程持有,当许可被持有时,其他线程需要等待才能获取许可。即可以限制同时访问特定资源的线程数量,确保在特定时刻只有有限数量的线程能够访问资源。(OS 中 PV 操作时,要有多少个资源来能执行)
-
当初始的资源个数为1的时候,Semaphore退化为排他锁
-
底层是AQS,所谓的许可其实就是state状态值,初始化时填入
-
acquire获取许可,如果没有可用许可则会阻塞等待 -
release释放许可,等待的线程可以获取许可 -
支持公平/非公平策略
CountdownLatch(倒计数信号量)
-
概念:
-
是JUC中的一个同步辅助类,它允许一个或多个线程等待,直到在其他线程中执行的一组操作完成。
CountDownLatch通过一个计数器来实现,计数器的初始值由构造方法传入。每当一个线程完成工作后,计数器会递减。当计数器到达零时,所有等待的线程会被唤醒并继续执行。(一次性的多线程延迟执行器) -
使用频率较高,主要作用是通过
CountDownLatch来实现让主线程来等待其他worker线程,也就是子线程执行完才能退出。 -
功能
-
1.等待事件完成:通过 await()方法,线程可以等待其他线程完成某些操作。
-
2.递减计数器:其他线程在完成各自的任务后,通过调用 countDown()方法将计数器减 1。
-
3.线程同步:当计数器变为 0时,所有调用了await()的线程将被唤醒并继续执行。
-
原理+实现
-
CountDownLatch原理和Semaphore原理类似,同样是基于AQS,不过没有公平和非公平之分。 -
阻塞实现:通过state状态来判断,只要不为0调用await()方法的线程就会被放入阻塞队列。
-
唤醒实现:基于AQS阻塞队列来实现的,所以可以让多个线程都阻塞在state=0条件上,通过countDown()一直减state,减到0后一次性唤醒所有线程。
-
使用场景
-
并行计算结果汇总:可以用于汇聚多个线程的结果,等所有子任务完成后再执行后续逻辑。
-
任务完成信号:在某些场景下,需要多个任务都完成后才能继续执行后续逻辑,比如在应用启动时,等待所有服务启动后再提供服务测试并发场景:在编写并发测试时,利用countDownlatch 可以确保多个线程在某一时刻同时开始执行,测试并发场景下的行为。
-
与CyclicBarrier 的对比
-
CountDownLatch:一次性使用,计数器减到0后,不能再次复用。 -
CyclicBarrier:可以重用,所有线程到达屏障后会自动重置,允许多次使用。
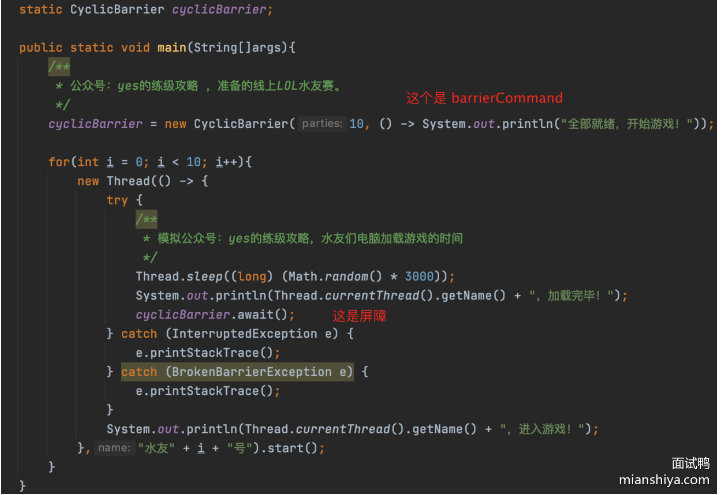
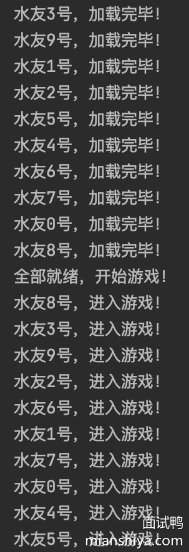
CyclicBarrier
设计目标:解决多线程并发任务中需要同步的场景,确保所有参与的线程都在特定的点上完成执行,然后一起继续后续的任务。
基本概念
- 屏障(Barrier):一个线程在调用 await()方法时会被阻塞,直到所有参与的线程都到达屏障点。屏障点可以是一个特定的任务步骤。
- 线程数量:
cyclicBarrier需要的线程数量是预设的,当所有线程都到达屏障时,屏障被释放,所有线程可以继续执行。 - 重用性:
cyclicBarrier可以被重用,允许在多个阶段中同步线程。例如,在每个阶段的同步点上都可以使用cyclicBarrier。
构造函数:
CyclicBarrier(int parties):初始化一个 cyclicBarrier 对象,设置需要等待的线程数量。cyclicBarrier(int parties,Runnable barrierction):除了设置线程数量外,还可以指定一个 Runable 回调,在所有线程到达屏障后执行
原理:
- 基于 ReentrantLock和 Condition 的封装来实现这一功能的。(AQS 机制)
- 内部维护了一个计数器,即达到屏障的线程数量,当线程调用 awat的时候计数器会减一,如果计数器减一不等于0的时候,线程会调用condition.await 进行阻塞等待。
- 如果计数器减一的值等于0,说明最后一个线程也到达了屏障,于是如果有 barierAction 就执行 barierAction,然后调用 condion.signalA 唤醒之前等待的线程,并且重置计数器,然后开启下一代,所以它可以循环使用。
注意:在等待期间,如果屏障被打破(即出现异常),其他线程会被通知并抛出BrokenBarrierException 异常。
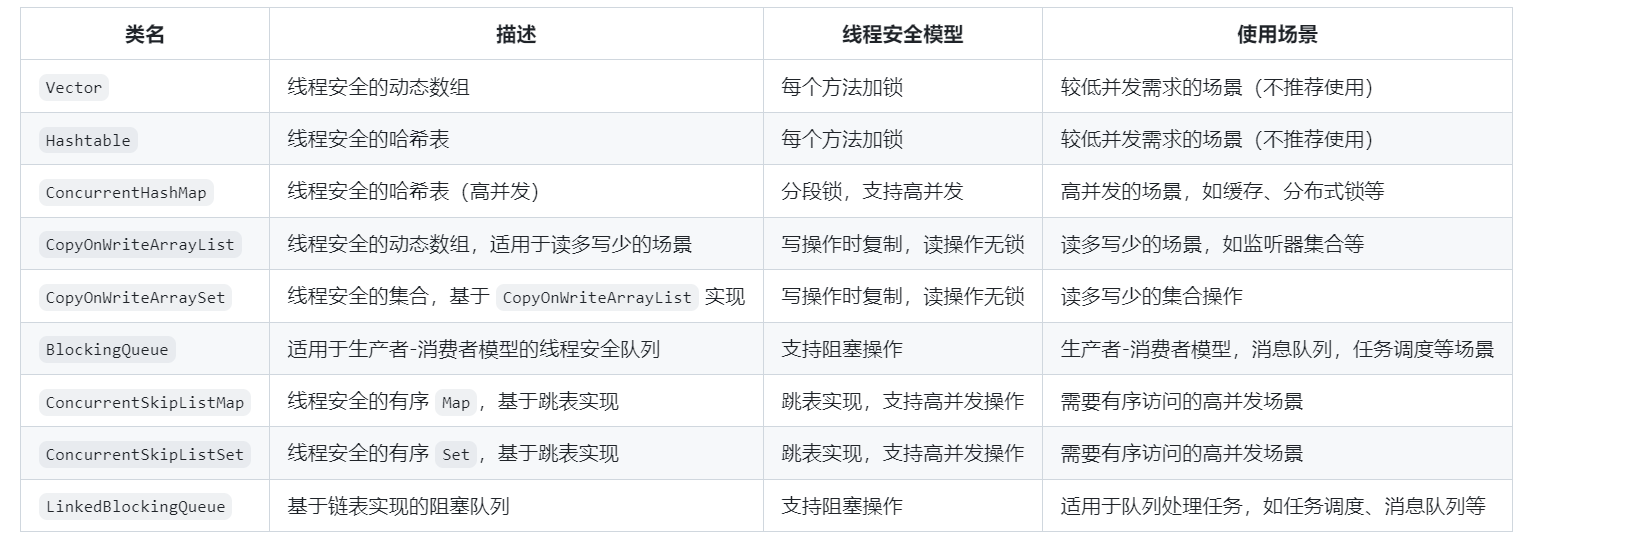
Java 线程安全的集合有哪些?
JMM 内存
JMM是什么?volatile关键字的作用?
A1:JMM(Java Memory Model)是一套规范,描述了Java程序中各种变量(线程共享变量)的访问规则,以及在JVM中将变量存储到内存和从内存中读取变量这样的底层细节。
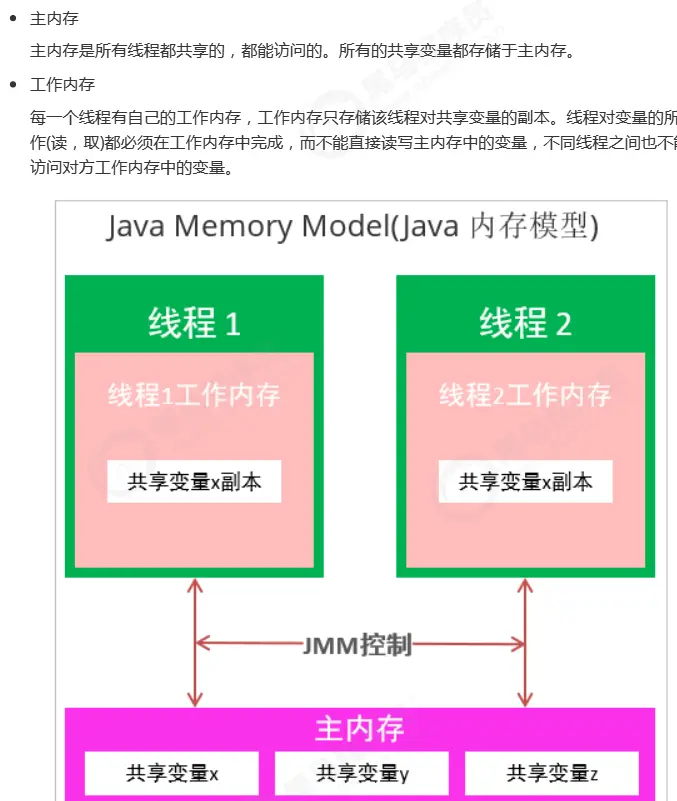
本质就是在每个线程加一个工作内存
特点:
-
JMM体现在以下几个方面(本质上是Java的原子性)
-
原子性 - 保证指令不会受到线程上下文切换的影响
有原子类,如java.unti.cocurrent.atomic中的atomicLong和AtomicInteger
锁:synchronized和Lock接口
CAS原子性操作
- 可见性 - 保证指令不会受 cpu 缓存的影响
volatile关键字,synchronized关键字保证临界区是释放后变量的可见性,JMM模型定义了变量在不同线程间的可见性和有序性
- 有序性 - 保证指令不会受 cpu 指令并行优化的影响
volatile的指令重排(内存屏障),happens-before原则,
volatile关键字是JMM中的组成部分,解决了可见性和有序性(禁止指令重排)。
保证可见性,不保证原子性(volatile):
(1)当修改一个volatile变量时,JMM会把该线程本地内存中的变量强制刷新到主内存中去,从而其他线程能立马看到这次更新.
(2)这个写操作会导致其他线程中的volatile变量缓存无效。
内存间的交互操作(8种操作必须原子性)
Java 内存模型定义了八种操作,用于控制主内存和工作内存之间的交互,这些操作都是原子的:
1.**lock(锁定):**把一个变量标识为一条线程独占的状态。
2.**unlock(解锁):**把一个变量从独占状态中释放出来,释放后的变量才能被其他线程锁定。
3**.read(读取):**从主内存中读取一个变量到工作内存中。
4.load(载入):把 read 操作从主内存中得到的变量值放入工作内存的变量副本中。
5.**use(使用):**把工作内存中的一个变量值传递给执行引擎。
6.**assign(赋值):**把一个从执行引擎接收到的值赋给工作内存中的变量。
7.**store(存储):**把工作内存中的一个变量的值传送到主内存中。
8.**write(写入):**把 store 操作从工作内存中得到的变量值放入主内存的变量中。
可以看成一个变量的存储过程,有加锁解锁,读写,赋值载入,使用存储
针对 long 和 double 型变量的特殊规则(long 和 double 的非原子协定)
- 非原子性:在一些平台上,对64位的long和 doube 类型的变量的读/写操作是非原子的。这意味着读取一个64 位变量时,可能只读取了其中的 32 位数据,从而导致读取到的值是不完整的。
- 解决方案:可以通过使用 volatile关键字或者使用锁来保证对 long 和 double 类型变量的操作是原子的。
指令重排:
编译器或处理器为优化性能,在保证语义不变的情况下,对底层指令进行重排序的结果。这样会导致多线程读写发生未知的错误。
比如 new 一个对象,实际分成 3 步,① 分配内存② 初始化对象③ 将对象指向内存空间。
但是实际上编译器或处理器会将 ②③ 变成 ③② 的顺序,导致另一个线程在读取到未初始化的对象。
禁止指令重排序:
(1)为了提高执行效率,编译器和处理器可能会对代码进行重排列,即调整指令的执行顺序。这可能会导致程序的执行结果与预期不符。volatile 关键字可以防止对其修饰的变量相关的操作被重排列,从而保证程序的正确性。
(2)在底层实现上,volatile 的原理依赖于处理器提供的内存屏障(Memory Barrier)。内存屏障是一种 CPU指令,它的作用是防止指定的内存操作被重排列。当一个变量被声明为 volatile 时,IM 会在生成的字节码中插入内存屏障指令,以确保对这个变量的读写操作符合 volatile 的语义。
volatile关键字虽然解决了指令重排和可见性,但是使用读写屏障这两个操作是分开的,针对的是单线程。导致在多线程下指令交错问题,如多线程的i++操作,不同线程执行下,结果会出错。
解决方法:使用基于CAS中的原子类或同步代码块+double check(单例模式中的double check)
volatile关键字不能保证原子性、顺序性
volatile与synchronized的区别?
Synchronized 原理是基于 JVM 的 Montior 和对象头。
ReentrantLock 原理是基于 AQS 原理
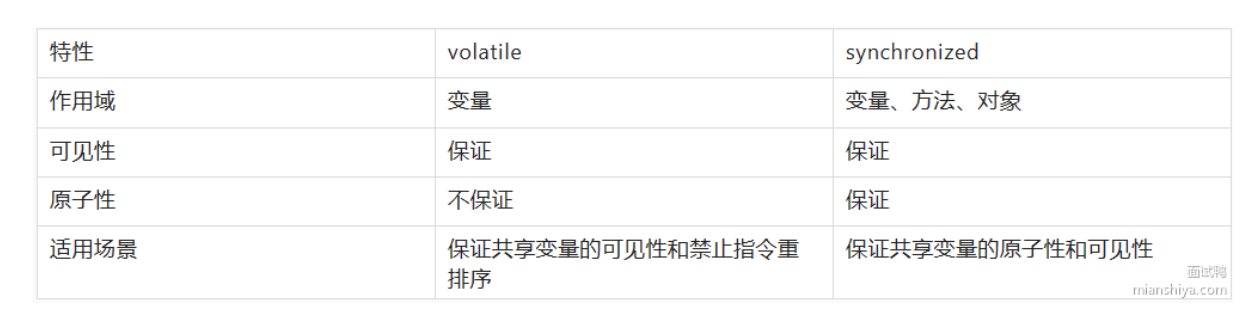
volatile 和 synchronized 都用于确保多线程环境下的数据一致性,但它们有几个重要的区别:·
- volatile 用于修饰变量,不提供互斥性,保证可见性,不能保证原子性(多个线程变量的线程顺序)
- synchronized 用于修饰代码块或方法,提供互斥性,同时也保证可见性和原子性。另外,synchronized 会引入性能开销,而 volatile 不会。
happens-before规则(多线程下可见性和有序性的规则保障)
这是程序员需要遵循的代码规则
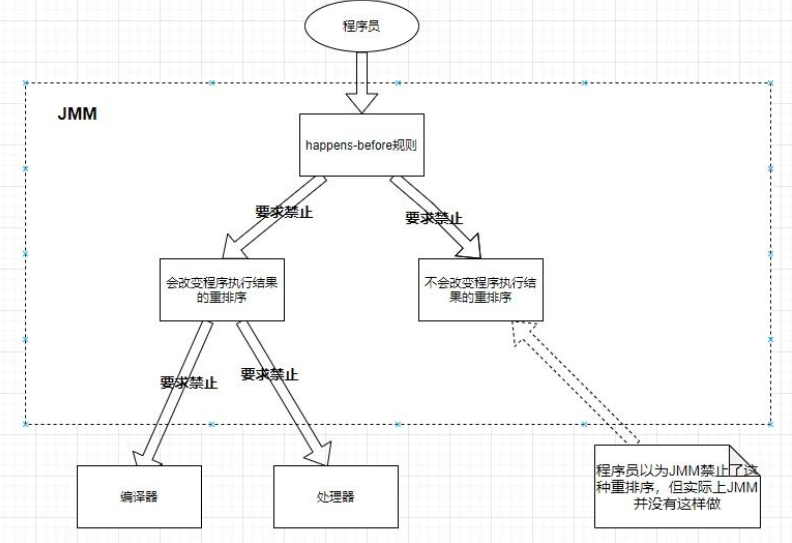
- 程序顺序规则:单线程中,前面的操作对后续操作可见。
- 监视器锁规则:线程解锁后,后续加锁线程可看到解锁前的操作(如
synchronized锁)。 - volatile 变量规则:对 volatile 变量的写操作对后续读操作可见。
- 传递性:若 A happens-before B 且 B happens-before C,则 A happens-before C。
- 线程生命周期规则:
- 线程启动 start()、终止 join()、中断 interrupt() 等操作对其它线程可见。
- 对象构造完成发生在其
finalize()方法之前。 这些规则确保线程间操作的有序性和数据一致性。同理保障可见性,在finalize()之前的数据是可见的
Final关键字能保证java中的可见性吗?
首先是java中的可见性:当一个变量进行修改,其他变量可看到修改,得到修改的新值。
Final关键字的可见性是final字段在构造函数完成时保证对其他线程可见。但如果 final变量指向的是一个可变对象(如 List),那么 final 仅能保证引用的可见性,不能保证对象内部状态的可见性。
| 特性 | final | volatile |
|---|---|---|
| 可变性 | 不可变 | 可变 |
| 写入时机 | 只在构造时 | 任何时间 |
| 可见性范围 | 对象完整构造后的状态 | 每次写操作后的最新值 |
| 性能影响 | 无额外开销 | 有内存屏障开销 |
| 主要用途 | 创建不可变对象 | 共享可变状态 |
在 java 多线程环境中,对象发布指是将一个对象的引用首次暴露给其他线程的过程。如果一个对象还没有完全构造好就被提前暴露出去,其他线程可能会看到一个未完成的对象状态,这就是所谓的“引用逃逸"
(在Final域中java编译器需要执行重排序的原则)
1.构造函数内的写操作与对象引用赋值之间不能重排序
在构造函数内对一个 final 域的写入,与随后把这个被构造对象的引用赋值给一个引用变量,这两个操作之间不能重排序。(这样可以保证 final 域在对象被其他线程可见前,已经被正确初始化)
2.对象引用的读取与 final 字段的初次读取之间不能重排序
当一个线程首次读取某个对象的引用时,不能与随后读取该对象的 final 域的操作重排序。
(这确保了当一个线程看到对象引用时,也能正确读取 final 域的值,而不会拿到过期数据。)
上述两个重排序保证了final重排序的可见性(范围小),但是这并非是多并发环境下的可见性的定义(范围更大)
TreadLocal 本地线程
ThreadLocal线程变量,在每个线程中都创建了一个副本(实例),那么每个线程可以访问自己内部的副本变量。
优点:不存在多线程间共享的问题,生命周期和线程一样,会被回收。
缺点:使用 ThreadLocalMap 使用的是 hash 线性探测法,效率低;会有内存泄漏问题,尽管 key 使用弱引用减轻了内存泄露,而且 get 或 set 方法查该弱引用发现 key=null 会进行清除,但是遇到冷数据会导致速度变慢。
适用场景:
-
1、每个线程需要有自己单独的实例
-
2、实例需要在多个方法中共享,但不希望被多线程共享
-
具体场景
-
场景一、存储用户Session
-
场景二、数据库连接,处理数据库事务
-
场景三、数据跨层传递(controller,service, dao)
原理:ThreadLocal 内部用 set 方法维护一个ThreadLocalMap 方法
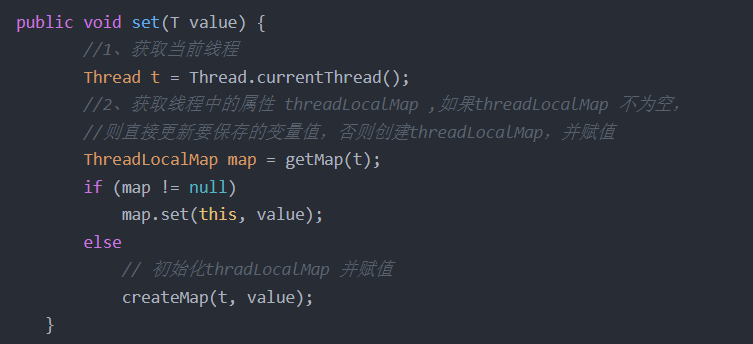
其中ThreadLocalMap 是使用开放地址法来实现 hash 查找的,是使用数组存数据。
开始 1、获取当前线程。2、使用 getMap 方法获取 map,若为空:createMap;反之 set 更新 map
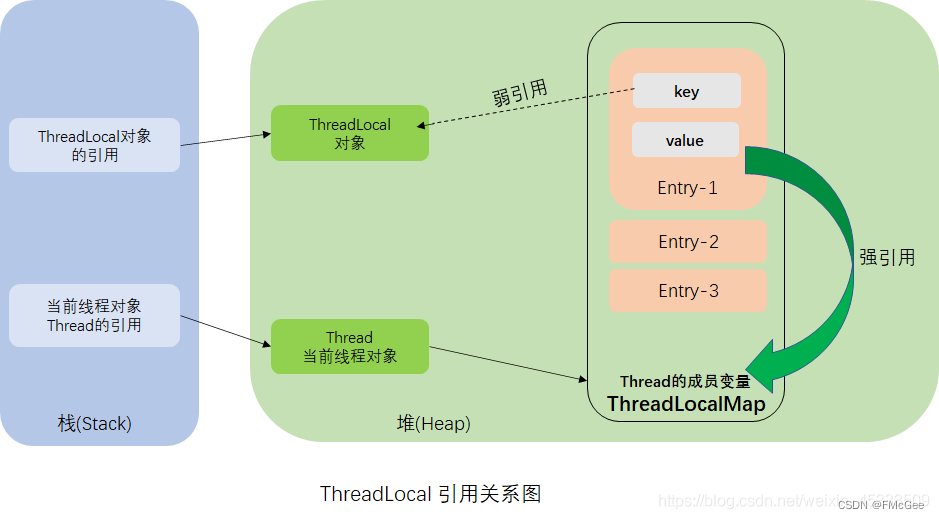
代码里面的问题:即ThreadLocal内存泄露的问题,即 ThreadLocalMap 和 ThreadLocal 生命周期一样,而 k-v 均为强引用,而 (null ,value)这种对象会不可避免的出现,导致需要手动 remove()。这肯定不现实。(设计到为什么强引用不会被 GC)
**解决方法:**将 key 改为弱引用,value 还是强引用,
原因:
- 第一次调用:弱引用的 ThreadLocal 会被回收.
- 第二次调用:对应value在下一次 ThreadLocaI 调用 get()/set()/remove() 中的任一方法的时候发现是key=NULL,从而清除,从而避免内存泄漏.
- 然后最终有时间再 remove()删除保险一下。
InheritableThreadLoacl 类是什么?
是 ThreadLocal 的扩展,解决子线程无法继承父线程本地变量的问题。
原理:使用该类时,当创建子线程会继承父线程的本地变量(本质是复制),而修改子线程的值,不会改变父线程
public class InheritableThreadLocalExample {
// 创建一个 InheritableThreadLocal 用来存储上下文信息
private static final InheritableThreadLocal<String> context = new InheritableThreadLocal<>();
public static void main(String[] args) {
// 设置父线程中的变量
context.set("Parent Thread Data");
// 创建子线程
Thread childThread = new Thread(() -> {
System.out.println("Child Thread Initial Value: " + context.get());
// 子线程中修改值
context.set("Child Thread Data");
System.out.println("Child Thread Modified Value: " + context.get());
});
// 启动子线程
childThread.start();
// 主线程输出
System.out.println("Parent Thread Value: " + context.get());
}
}FastThreadLocal
Netty 中使用的是这个类型的 ThreadLocal,如其名(fast)将 ThreadLocal 的速度慢的缺点完善。
设计目标:提高性能,减少 GC 开销,适用于高并发环境。
ThreadLocal 中使用ThreadLocalMap 使用线性探测法,速度慢,K 为弱引用,还是可能会发生内存泄漏。使用一个新的ThreadLocalMap 替换掉,但是不能局部替换变量。所以设计了个新的FastThreadLocal。
解决方法:直接数组索引访问实现快速查找,即维护一个数组直接访问 value,清理内存直接将数组置 null 即可
| 维度 | ThreadLocal | FastThreadLocal |
|---|---|---|
| 数据结构 | 每个线程维护 ThreadLocalMap(哈希表) |
每个线程维护 Object[](数组) |
| 哈希冲突 | 需要处理(拉链法/开放寻址) | 无冲突(索引唯一) |
| 内存占用 | 每个 Entry 额外存储 key(弱引用) |
仅存储值,无额外对象 |
| 扩容成本 | 需 rehash | 数组直接扩容 |
| GC 友好性 | 依赖弱引用,可能需手动 remove() |
线程退出时自动清理数组 |
TransmittableThreadLocal
TTl 设计目标:阿里造的轮子,为支持跨线程池的复用并控制上下文周期(自动清除上下文)
| 特性 | **ThreadLocal** |
**InheritableThreadLocal** |
**TransmittableThreadLocal** |
|---|---|---|---|
| 线程内共享 | ✅ | ✅ | ✅ |
| 父子线程继承 | ❌ | ✅(仅新建线程) | ✅(支持线程池复用) |
| 线程池兼容性 | ❌ | ❌(线程池复用失效) | ✅ |
| 手动清理要求 | 需显式 remove() |
需显式 remove() |
支持自动/手动清理 |
对比以上:
ThreadLocal无法进行父子继承本地变量;
InheritableThreadLocal可以进行父子继承变量,但是只能在创建子线程时,将本地变量复制;
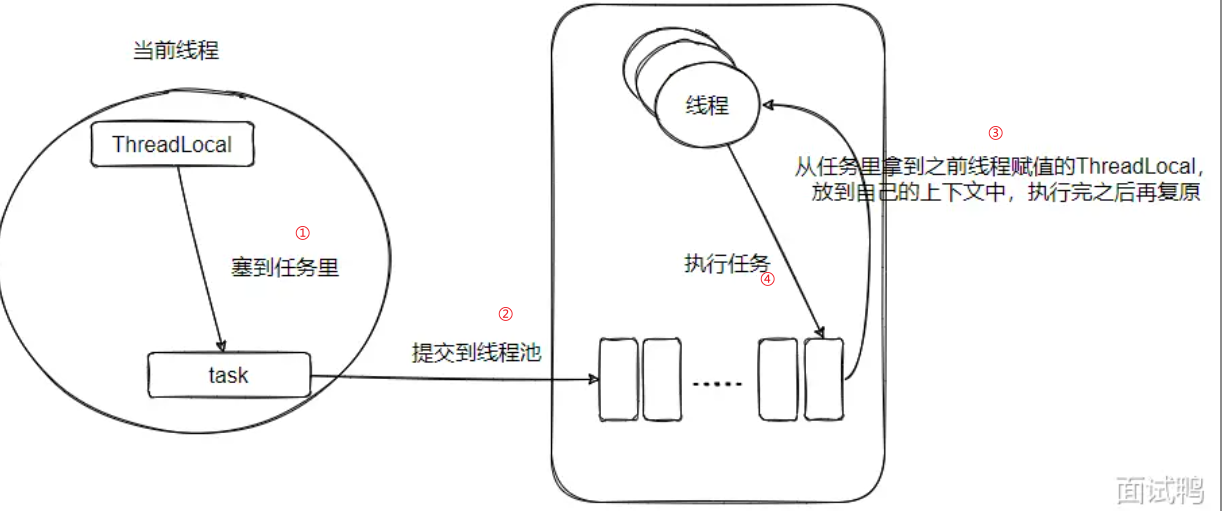
TransmittableThreadLocal支持父子继承变量,而且是在子线程执行前,去查找本地变量并复制,而且在执行完成后,将任务带来的本地变量清除。
可以理解为线程池的增强(AOP):通过 包装 **Runnable/Callable** 实现上下文捕获与传递:
// 原始任务
Runnable task = () -> System.out.println("Task running");
// 包装为 TTL 任务
Runnable ttlTask = TtlRunnable.get(task);
executorService.submit(ttlTask);执行流程:
- 捕获:在任务提交时,TTL 会保存当前线程的所有
TransmittableThreadLocal值。 - 传递:在线程池执行任务前,将捕获的值注入到子线程中。
- 恢复:任务执行完成后,自动清理子线程的上下文,避免污染后续任务。
乐观锁(非阻塞、无锁)
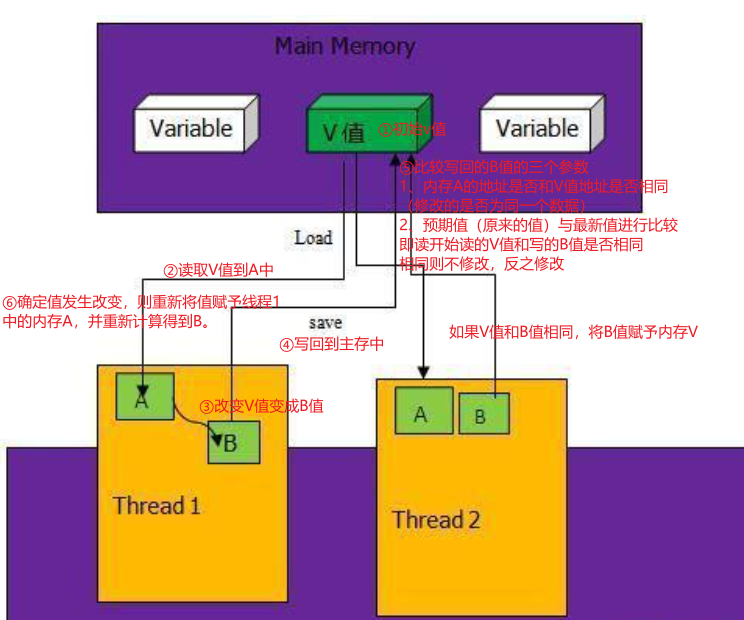
CAS(Compare and Swap)
由来:java需要原子性操作
核心原理:
1、比较(Compare): CAS会检查内存中的某个值是否与预期值相等。
2、交换(Swap):如果相等,则将内存中的值更新为新值。
3、失败重试: 如果不相等,说明有其他线程已经修改了该值,CAS操作失败,一般会利用重试,直到成功。
优点:
- 无锁并发
- 原子性
缺点:
-
1.ABA问题
-
ABA 问题,就是一个值原来是 A,变成了 B,又变回了 A。这个时候使用 CAS 是检查不出变化的,但实际上却被更新了两次。
-
解决思路
-
ABA 问题的解决思路是在变量前面追加上版本号或者时间戳,除了比较内存中的实际值与期望值外,还比较版本号,版本号相同就修改,否则失败重试(加版本号)
-
从JDK1.5开始,JDK的 aiomic包里提供了一个AtomicStampedReference类来解决ABA问题、这个类的compareAndSet方法的作用是首先检查当前引用是否等于预期,并且检查当前标志是否等于预期标志,如果两者都相等,才使用CAS设置为新的值和标志。
AtomicMarkableReference<Integer> markableRef = new AtomicMarkableReference<>(1, false);-
2.长时间自旋(消耗大量资源)
-
CAS 多与自旋结合。如果自旋 CAS 长时间不成功,会占用大量的 CPU 资源,
-
解决思路
-
让 JVM 支持处理器提供的pause 指令。
-
pause 指令能让自旋失败时 cpu 睡眠一小段时间再继续自旋,从而使得读操作的频率降低很多,为解决内存顺序;中突而导致的 CPU 流水线重排的代价也会小很多。
-
3.多个共享变量的原子操作
-
当对一个共享变量执行操作时,CAS 能够保证该变量的原子性。但是对于多个共享变量,CAS 就无法保证操作的原子性
-
解决思路
-
使用AtomicReference类保证对象之间的原子性,把多个变量放到一个对象里面进行 CAS 操作;
-
使用锁。锁内的临界区代码可以保证只有当前线程能操作。
实际应用:CAS提供的Atomic 原子类
CAS 提供的原子类(无锁机制)
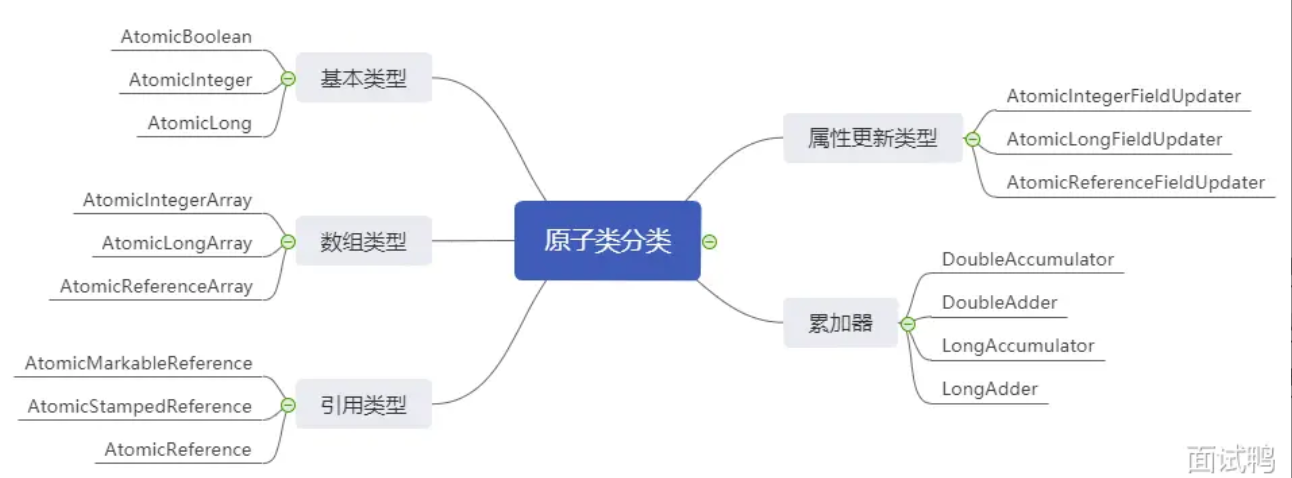
在util,concurrent.atomic 下:
1、 基本原子类型:(基于 volatile+CAS 操作)
缺点:高并发下竞争一个变量会导致 CAS 失败重试
| 类名 | 特点 | 核心方法 |
|---|---|---|
AtomicBoolean |
原子布尔类型 | getAndSet(boolean newValue) |
AtomicInteger |
原子整型 | getAndIncrement(), incrementAndGet(), getAndUpdate(IntUnaryOperator) |
AtomicLong |
原子长整型 | 同AtomicInteger类似 |
方法说明:
getAndXxx():先获取当前值再操作,返回操作前的值xxxAndGet():先操作再获取值,返回操作后的值updateAndGet()/accumulateAndGet():支持函数式操作
2、 原子数组类型
| 类名 | 特点 |
|---|---|
AtomicIntegerArray |
原子整型数组 |
AtomicLongArray |
原子长整型数组 |
AtomicReferenceArray |
原子引用类型数组 |
3. 引用类型原子类
| 类名 | 特点 | 解决的核心问题 |
|---|---|---|
AtomicReference |
原子引用类型 | 基本引用原子操作 |
AtomicMarkableReference |
带标记位的引用 | 部分解决ABA问题(只关心是否被修改过) |
AtomicStampedReference |
带版本号的引用 | 完全解决ABA问题(记录修改历史) |
4. 属性更新器
原理:通过反射机制原子化地更新对象的volatile字段
| 类名 | 功能 |
|---|---|
AtomicIntegerFieldUpdater |
整型字段更新 |
AtomicLongFieldUpdater |
长整型字段更新 |
AtomicReferenceFieldUpdater |
引用类型字段更新 |
5. 累加器类(JDK8+)
| 类名 | 特点 | 适用场景 |
|---|---|---|
LongAdder |
分段累加策略 | 高并发统计场景 |
DoubleAdder |
同LongAdder | 双精度浮点统计 |
LongAccumulator |
可自定义累加规则 | 复杂累加逻辑 |
DoubleAccumulator |
同LongAccumulator | 双精度版本 |
CAS 提供的原子类核心原理深度解析
1. 传统原子类(AtomicLong)原理
- 基于volatile变量+CAS操作
- 缺点:高并发下大量线程竞争同一个变量,导致CAS失败重试
2. 累加器类(LongAdder)优化原理
分段设计思想:
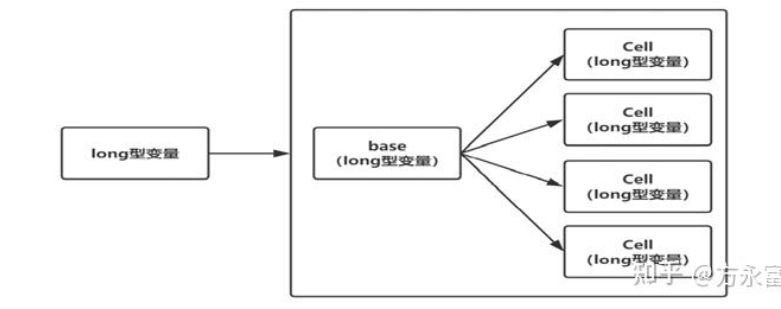
- 基础值base :低竞争时直接操作
- Cell数组:高竞争时分散到多个cell
- 最终值计算:sum = base + ∑cell[i]
优势:
- 减少CAS竞争
- 提高并发吞吐量
- 适合统计场景(最终一致性)
对比:
| 场景 | AtomicLong | LongAdder |
|---|---|---|
| 低并发 | 性能相当 | 性能相当 |
| 高并发写 | 性能下降明显 | 性能稳定 |
| 实时读取 | 精确值 | 最终一致值 |
面试应答技巧
Q1:AtomicInteger和synchronized有什么区别?
- AtomicInteger基于CAS无锁算法,synchronized基于锁
- CAS适用于低竞争场景,锁适用于高竞争场景
- CAS不涉及线程阻塞/唤醒,性能更高
Q2:LongAdder为什么比AtomicLong性能高?
- 分段设计减少竞争:将单一value拆分为base+cell[]
- 空间换时间:高并发时不同线程操作不同cell
- 最终一致性:适合统计场景,不要求实时精确值
Q3:ABA问题如何解决?
- AtomicMarkableReference:关注是否被修改过(true/false)
- AtomicStampedReference:关注修改历史(版本号递增)
- 典型应用场景:链表操作、状态机等
Q4:原子类一定线程安全吗?
- 单个原子操作是线程安全的
- 复合操作仍需同步控制,因为多个线程下的原子操作不一定顺序安全。
CPU 三级缓存和伪共享问题
- cpu缓存框架,其实就是cpu+多个cpu多级缓存+RAM(内存)
- 1 Cache,分为数据缓存和指令缓存,逻辑核独占
- L2 Cache,物理核独占,逻辑核共享
- L3 Cache,所有物理核共享
- 缓存行cache line :一个缓存行一般是64个字节,Cup 读取的最小单位是 8 字节,这样会导致读取一个 8 字节的数据,本质上是读取了 64 字节的数据,由于 MESI 协议规定,会导致缓存失效,重新读取 RAM,导致伪共享。
级别越小的缓存,越接近CPU, 意味着速度越快且容量越少。
- 存储器存储空间大小:内存>L3>L2>L1>寄存器;
- 存储器速度快慢排序:寄存器>L1>L2>L3>内存
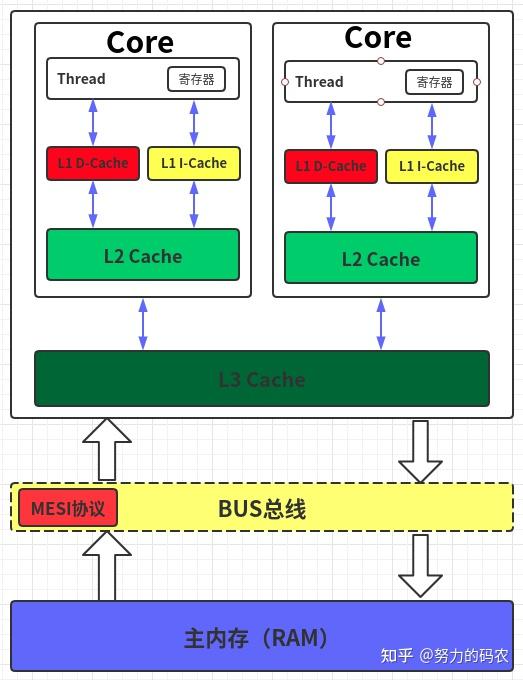
多核CPU多级缓存一致性协议MESI:当核A修改了缓存行中的任意字节,其他核(如核B)中相同缓存行的副本会被标记为Invalid(通过总线嗅探或目录协议),导致缓存行失效,会去查其他的缓存行或 RAM 导致速度减慢,但是数据一致性保证了。
伪共享:多个线程频繁修改同一缓存行中的不同变量,但是 cpu 读取的最小的是 8 字节,为了写入,线程 1 发出“RFO”(Request For Ownership)消息,其他线程读取 RFO,发现相同缓存行发现修改,缓存行状态信息变成Invalid (I),而线程 1 写完之后,其他线程读取该缓存行时,发现状态为Invalid (I), 导致不必要的缓存行失效,又要进行一次缓存填充(缓存更新)。注意:不一全是查 RAM 的,而是一路查临近的缓存行直到最后的 RAM
伪共享解决方法:(本质就是填充一种方法,其他方法都是形式的不同。)
填充(Padding):确保变量独占缓存行。
使用自定义数据结构:变相的填充 64 个字节。这样就不会导致缓存行出现状态失败,空间换时间。
例子:
- jdk中的ConcurrentHashMap类
@sun.misc.Contended static final class CounterCell { volatile long value; CounterCell(long x) { value = x; } }-
jdk8中LongAdder的父类Striped64
-
// Striped64中的内部类Cell(),使用@sun.misc.Contended注解,说明里面的值消除了伪共享
-
著名的disruptor中的ringBuffer
// Disruptor 中的 Sequence 类(简化版)
class Sequence {
private volatile long value;
// 填充至 64 字节(假设缓存行大小为 64)
private long p1, p2, p3, p4, p5, p6, p7;
}特殊的线程池:
多线程并行计算框架(ForkJoinPool)
Java 7 引入的分治并行计算框架,专为递归任务分解和多核CPU优化设计,核心思想是 “分而治之” + “工作窃取(Work-Stealing)”
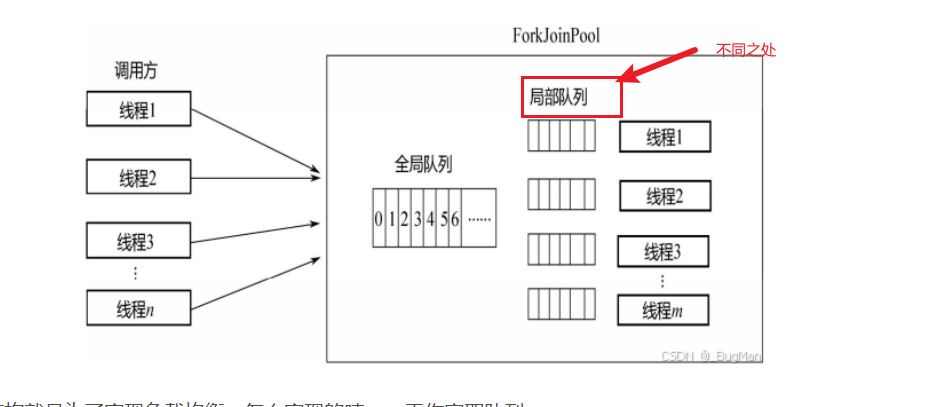
分而治之:典型的递归思想,比如快排。原理是通过 Fork 递归分解为小任务,最终 join 为结果。
工作窃取:一个线程执行完自己的任务后,可以窃取别人队列中的任务来执行。
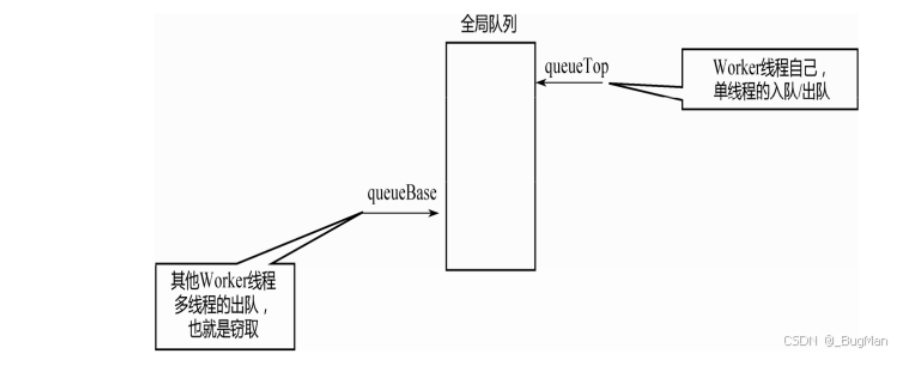
虽然操作名称等都是数组,但是实际是使用普通的数组来实现。每个工作线程维护一个 WorkQueue,底层是 ForkJoinTask<?>[] 数组
- 队头(Base):所有者线程通过
poll()/pop()LIFO 方式获取任务(栈行为) - 队尾(Top):其他线程通过
steal()FIFO 方式窃取任务(队列行为)
fork() |
将子任务异步推入当前线程的任务队列 |
|---|---|
join() |
阻塞等待子任务结果(内部可能执行其他任务避免线程闲置) |
invoke() |
同步执行任务并返回结果 |
invokeAll() |
批量执行多个任务 |
其中 join就是将当前线程wait在分出来的线程上面,各个线程执行完成后去唤醒 notify/notifyAll当前线程。(等待子任务都完成了,再一起同步提交结构)
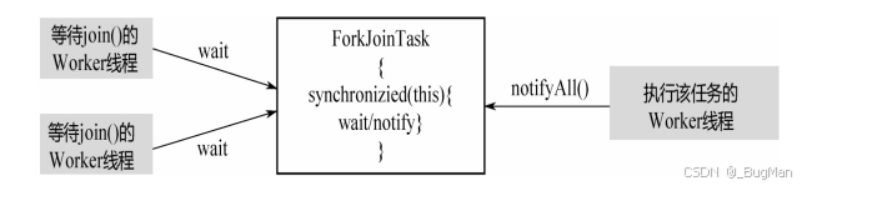
任务调度器工具类(Executors 工具类):
在 jdk3 使用 **timer** 单线程任务调度器、在 jdk5 之后使用**ScheduledThreadPoolExecutor**,在 Spring 框架中使用@Scheduled 注解
| 特性 | Timer | ScheduledThreadPoolExecutor |
|---|---|---|
| 线程模型 | 单线程 | 线程池(可配置线程数) |
| 异常处理 | 未捕获异常会终止整个Timer | 异常仅影响当前任务 |
| 任务隔离 | 所有任务相互影响 | 任务间隔离性更好 |
| 灵活性 | 功能简单 | 支持更多调度策略 |
| Java版本 | 1.3+ | 1.5+ |
ScheduledExecutorService executor = Executors.newScheduledThreadPool(2);
executor.schedule(() -> {
System.out.println("延迟执行");
}, 1, TimeUnit.SECONDS);
executor.scheduleAtFixedRate(() -> {
System.out.println("周期性执行");
}, 0, 1, TimeUnit.SECONDS);Timer Wheel 时间轮
用于管理和调度大量定时任务的数据结构,是一种高效的定时任务调度算法,主要用在处理大量定时任务。
例如 Kafka 内部用的是多层次的时间轮算法。