
一.基础语法
参考文章:
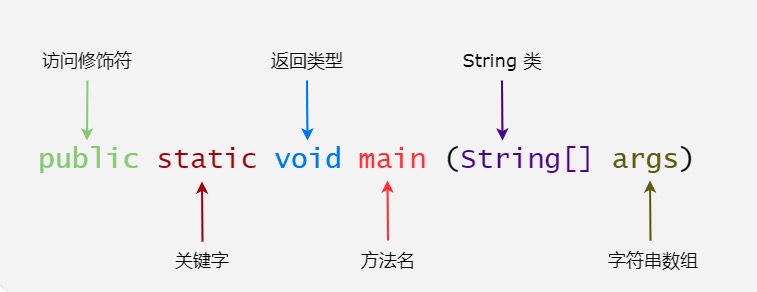
1.2:IDEA中的快捷键
//主方法、打印的快捷键
//psvm
public static void main(String[] args) {
//sout
System.out.println()
}//idea中复制的快捷键
在IntelliJ IDEA中,可以通过以下快捷键进行复制操作:
-
Ctrl + C:复制选中文本或者整个行的内容。
-
Ctrl + X:剪切选中文本或者整个行的内容。
-
Ctrl + V:粘贴剪贴板上的内容。
-
Ctrl + Shift + C:复制选中文件所在路径。
-
Ctrl + D:复制当前行并粘贴到下一行。
-
Ctrl + Y:删除当前行。
-
Ctrl + A:全选文本。
-
Ctrl + Shift + A:选择所有匹配项。
-
Alt + Enter:在当前行之前插入新行。
-
Ctrl + Shift + L:格式化代码(通常用于自动完成)
4.1、字体设置 file --> settings --> 输入font --> 设置字体样式以及字号大小。 4.2、快速生成main方法 psvm
4.3、快速生成System.out.println() sout
4.4、注意:IDEA是自动保存,不需要ctrl + s
4.5、删除一行 ctrl + y
4.6、怎么运行: 代码上右键-->run 或者点击左侧的绿色箭头。 ctrl + shift + F10
4.7、左侧窗口中的列表怎么展开?怎么关闭? 左箭头关闭。 右箭头展开。 上下箭头移动。
4.8、idea中退出任何窗口,都可以使用esc键盘。(esc就是退出)
4.9、任何新增/新建/添加的快捷键是: alt + insert
4.10、窗口变大,变小: ctrl + shift + F12
4.11、切换java程序:从HelloWorld切换到User alt + 右箭头 或者 alt + 左箭头
4.12、切换窗口: alt + 标号 alt + 1(打开,关闭) alt + 2
4.13、提示方法的参数:ctrl + p
4.14、注释: 单行注释:ctrl + / 多行注释:ctrl + shift + /
4.15、idea中怎么定位方法/属性/变量? 光标停到某个单词的下面,这个单词可能是: 方法名、变量名 停到单词下面之后,按ctrl键,出现下划线,点击跳转。
4.16、idea当中复制一行是ctrl + d
二、java注释
单行注释
单行注释以双斜杠 // 开始:
多行注释
多行注释以 **/***开始,以 ***/**结束:
文档注释
文档注释以 /** 开始,以 */ 结束,通常出现在类、方法、字段等的声明前面,用于生成代码文档,这种注释可以被工具提取并生成 API 文档,如 JavaDoc。
注:这些在IDEA中有快捷键,没写
关键字1:
三、对象和类
- 多态
- 继承
- 封装
- 抽象
- 类
- 对象
- 实例
- 方法
- 重载
3.1 类
public class 类名称{
//属性
数据类型1 数据名称1;//成员变量
static 数据类型2 数据名称2;//类变量
//服务(方法)
返回类型 方法名称(形参){
数据类型3 数据名称3;//局部变量
具体服务;
}
}一个类可以包含以下类型变量(属性的类型):
- 局部变量:在方法、构造方法或者语句块中定义的变量被称为局部变量。变量声明和初始化都是在方法中,方法结束后,变量就会自动销毁。
- 成员变量:成员变量是定义在类中,方法体之外的变量。这种变量在创建对象的时候实例化。成员变量可以被类中方法、构造方法和特定类的语句块访问。
- 类变量:类变量也声明在类中,方法体之外,但必须声明为 static 类型。
3.2 构造方法
class Student {
String name; //学生类的属性
int age;
public void eat() {
System.out.println(name + "在吃饭"); // 学生类的行为(方法)
}
public Student() {
System.out.println("这是自定义的一个不带参数的构造方法");
}
}
public class TestDemo3 {
public static void main(String[] args) {
Student student1 = new Student();
}
}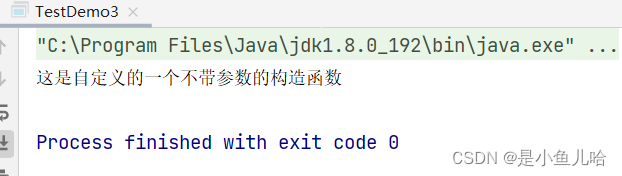
main方法里明明就只是实例化了一个对象,但是还是输出构造方法中的内容
🍑原因就是:当类的对象被创建时,该构造方法将被*自动调用*。
🍑其实我们在用new关键字实例化对象时 , 程序一定干了这两件事(但可能不只有这两步)
-
📝在堆区分配对象需要的内存
-
📝调用合适的构造方法
😊是这样的,当一个类中没有提供任何构造方法,系统默认提供一个无参数的构造方法,就像这样:
JavaStudent() { }🔔 但如果类中显式地定义了一个或多个构造方法,则系统不再提供默认构造方法。
JavaStudent() { System.out.println("这是自定义的一个没有参数的构造方法"); } Student(String name) { this.name = name; System.out.println("这是自定义的带有一个参数的构造方法"); }- 🌻 该示例就定义了两个构造方法,分别是无参构造方法和有参构造方法。
- 🌻如果在一个类中定义多个具有不同参数的同名方法,称作方法的重载。
- 🌻这两个构造方法的名称都与类名相同,均为Student。在实例化该类时可以调用不同的构造方法进行初始化。
- 🌻在创建一个对象的时候,至少要调用一个构造方法。构造方法的名称必须与类同名,一个类可以有多个构造方法。
构造方法的使用
class Student {
String name;
String gender;
int age;
long studentID;
// 该构造方法可由IDEA自动生成
public Student(String name, String gender, int age, long studentID) {
this.name = name;
this.gender = gender;
this.age = age;
this.studentID = studentID;
}
}
public class TestDemo2 {
public static void main(String[] args) {
Student stu1 = new Student("张三", "男", 19, 231245431);
System.out.println("姓名:" + stu1.name + " 性别:" + stu1.gender + " 年龄:" + stu1.age + " 学号:" + stu1.studentID);
}
}// 该构造方法可由IDEA自动生成 (快捷键:Alt+Ins)
在创建类中的变量进行传参时,出现个问题:
当构造方法的参数与类所定义的属性同名时,对于方法中的year = year,虚拟机不清楚在这里year到底是传过来的参数还是对象的成员变量
public Date(int year, int month, int day) {
// 那函数体中到底是谁给谁赋值?成员变量给成员变量?参数给参数?参数给成员变量?
// 成员变量给参数?估计自己都搞不清楚了
year = year; // 当传入的参数相同是怎么办!
month = month;
day = day;
}借助java中this这个关键字
public Date(int year, int month, int day) {
this.year = year;
this.month = month;
this.day = day;
}
Date date1 = new Date(2022, 4, 2)为什么用this.name = name 赋值就好了呢?
this.xx的用法
1、this关键字的意义被解释为**“指向当前对象的引用”**,比如在上述代码中当前所实例化的对象是date1,那么this其实就指向date1,是date1的一个引用(也可以理解为是date1的一个别名)那么this.xxx其实就代表了date1.xxx
2、所以在执行”this.name=name;”这条语句的时候,虚拟机就会把参数year的值”2022”赋值给对象date1的year成员变量。也就是说在这条赋值语句中,”=”左边的”this.year”表示对象date1的year成员变量,而”=”右边的year表示传给我们构造方法的参数。
3、它能够接收从主调方法中传递过来的值。**因此,当我们说到”参数”这个概念的时候,都是相对于一个”方法”而不是一个”对象”而言的,**所以也就不会有”某个对象的参数”这一说法。因此,”this.year”只能被虚拟机认定为当前对象date1自己的year成员变量,绝不会被当作参数。
this.xxx此时的作用不就相当于对象名.xxx
class Cat {
public void jump() {
System.out.println("这个猫在跳!!!");
}
public void run() {
this.jump(); // 在run方法中用this.方法名调用当前对象的一个成员方法jump
System.out.println("这个猫在跑!!!");
}
}
public class TestDemo2 {
public static void main(String[] args) {
Cat cat = new Cat();
cat.run();
}
}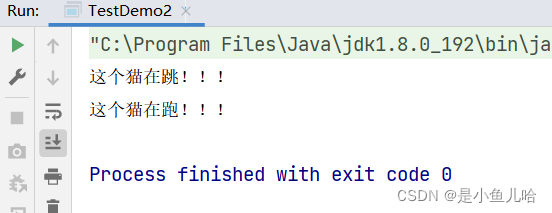
可以看出在我们成功的在run方法中用this.方法名调用了同一个类下的其他方法。
this()用于构造函数的调用
同一个类中可以同时有多个构造函数,通过this()还可以在一个构造函数里调用另一个构造函数,有利于代码重用
class Cat {
String name;
int age;
Cat() {
System.out.println("这是自定义的一个不带参数的构造函数");
}
public Cat(String name, int age) {
this(); // 调用另一个不带参数的构造方法
this.name = name;
this.age = age;
System.out.println(this.name + this.age + "岁了");
System.out.println("这是自定义的一个带两个参数的构造函数");
}
}
public class TestDemo2 {
public static void main(String[] args) {
Cat cat = new Cat("小花", 3);
}
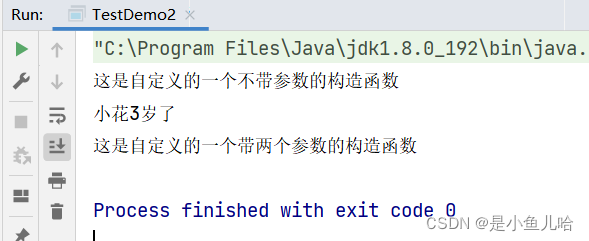
}
🔔但有几个问题需要我们注意一下
-
this( ) 不能在普通方法中使用,只能写在构造方法中。
-
在构造方法中使用时,必须是第一条语句。
3.3 创建对象
对象是根据类创建的。在Java中,使用关键字 new 来创建一个新的对象
-
声明:声明一个对象,包括对象名称和对象类型。
-
实例化:使用关键字 new 来创建一个对象。
-
初始化:使用 new 创建对象时,会调用构造方法初始化对象。
Java//创建类 public class Puppy{ //成员变量 int puppyAge; //类中服务1(方法1) public Puppy(String name){ System.out.println("小狗的名字是 : " + name ); } //类中服务2(方法2) public void setAge( int age ){//注入age puppyAge = age; } //类中服务3(方法3) public int getAge( ){ System.out.println("小狗的年龄为 : " + puppyAge ); return puppyAge; } //调用方法 public static void main(String[] args){ /* 创建对象 */ Puppy myPuppy = new Puppy( "tommy" ); //通过对象调用类中的方法 /* 通过方法来设定(注入)age */ myPuppy.setAge( 2 ); /* 调用另一个方法获取age */ myPuppy.getAge( ); /*你也可以像下面这样访问成员变量 */ System.out.println("变量值 : " + myPuppy.puppyAge ); } } //创建对象 对象类型 对象名称 = new 对象类型(实参or 空) //访问类中变量 对象名称.变量名 //访问类中方法 对象名称.方法名
四、变量类型
4.1 分类
成员变量
定义:方法外部,类内部定义的变量
-
类变量(静态变量):独立于方法之外的变量,用 static 修饰。
-
实例变量(非静态变量、成员变量):独立于方法之外的变量,不过没有 static 修饰。
类变量和实例变量的区别
- 调用方式
- 静态变量也称为类变量,可以直接通过类名调用。也可以通过对象名调用。这个变量属于类。
- 成员变量也称为实例变量,只能通过对象名调用。这个变量属于对象。
- 存储位置
- 静态变量存储在方法区长中的静态区。
- 成员变量存储在堆内存。
- 生命周期
- 静态变量随着类的加载而存在,随着类的消失而消失。生命周期长。
- 成员变量随着对象的创建而存在,随着对象的消失而消失。
- 与对象的相关性
- 静态变量是所有对象共享的数据。
- 成员变量是每个对象所特有的数据。
局部变量
-
局部变量:类的方法中的变量。
-
局部变量声明在方法、构造方法或者语句块中;
-
局部变量在方法、构造方法、或者语句块被执行的时候创建,当它们执行完成后,变量将会被销毁;
-
访问修饰符不能用于局部变量;
-
局部变量只在声明它的方法、构造方法或者语句块中可见;
-
局部变量是在栈上分配的。
-
局部变量没有默认值,所以局部变量被声明后,必须经过初始化,才可以使用。
成员变量和局部变量的区别
- 作用域
- 成员变量:针对整个类有效。
- 局部变量:只在某个范围内有效。(一般指的就是方法,语句体内)
- 存储位置
- 成员变量:随着对象的创建而存在,随着对象的消失而消失,存储在堆内存中。
- 局部变量:在方法被调用,或者语句被执行的时候存在,存储在栈内存中。当方法调用完,或者语句结束后,就自动释放。
- 生命周期
- 成员变量:随着对象的创建而存在,随着对象的消失而消失
- 局部变量:当方法调用完,或者语句结束后,就自动释放。
- 初始值
- 成员变量:有默认初始值。
- 局部变量:没有默认初始值,使用前必须赋值。
使用原则
- 在使用变量时需要遵循的原则为:就近原则 首先在局部范围找,有就使用;接着在成员位置找。
按所属的数据类型划分
基本数据类型变量
- 基本数据类型
- byte,short,int,long,float,double,char,boolean
- 变量的定义格式
- 数据类型 变量名 = 初始化值;
- 注意
- 整数默认是int类型,定义long类型的数据时,要在数据后面加L。
- 浮点数默认是double类型,定义float类型的数据时,要在数据后面加F。
引用数据类型变量
定义格式
- 数据类型 变量名 = 初始化值; 注意:格式是固定的,记住格式,以不变应万变
- 举例
-
Java
public class Variable{ // 类变量 static int allClicks=0; // 实例变量(一般情况下把在dao层把实例变量设成私有) String str="hello world"; public void method(){ // 局部变量 int i =0; } }
- 作用域
注意事项
- 类外面不能有变量的声明
4.2 访问修饰符
定义
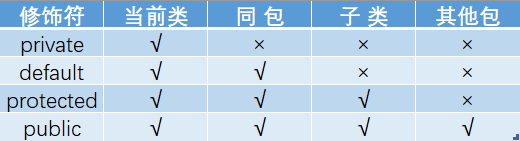
- Java中,可以使用访问修饰符来保护对类、变量、方法和构造方法的访问。Java 支持 4 种不同的访问权限。
分类
- private : 在同一类内可见。使用对象:变量、方法。 注意:不能修饰类(外部类)
- default (即缺省,什么也不写,不使用任何关键字): 在同一包内可见,不使用任何修饰符。使用对象:类、接口、变量、方法。
- protected : 对同一包内的类和所有子类可见。使用对象:变量、方法。 注意:不能修饰类(外部类)。
- public : 对所有类可见。使用对象:类、接口、变量、方法
五、流程控制语句
分类:顺序、选择(分支)、循环
5.1 顺序 (略)
5.2 选择
5.2.1 if结构(三种格式)
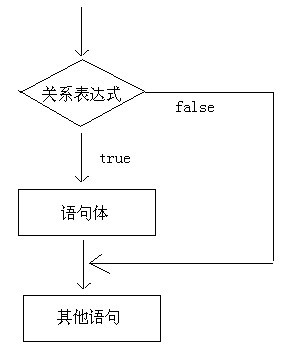
格式1
if(条件表达式){ 执行的代码块; }
执行流程
格式2
if(条件表达式){ 执行的代码块; }else{ 执行的代码块; }
执行流程
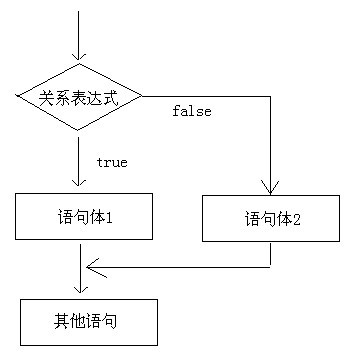
if (a % 2 == 0) {
System.out.println("a是偶数");
} else {
System.out.println("a是奇数");
}格式3
if(条件表达式){ 执行的代码块; }else if(条件表达式){ 执行的代码块; }…(此处省略N个else if) else if{ 执行代码块; }
执行流程
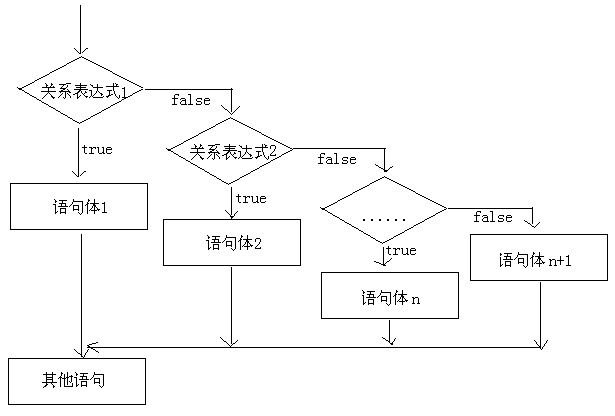
if (x >= 3) {
y = 2 * x + 1;
} else if (x >= -1 && x < 3) {
y = 2 * x;
} else if (x <= -1) {
y = 2 * x - 1;
}5.2.2 switch分支结构
格式
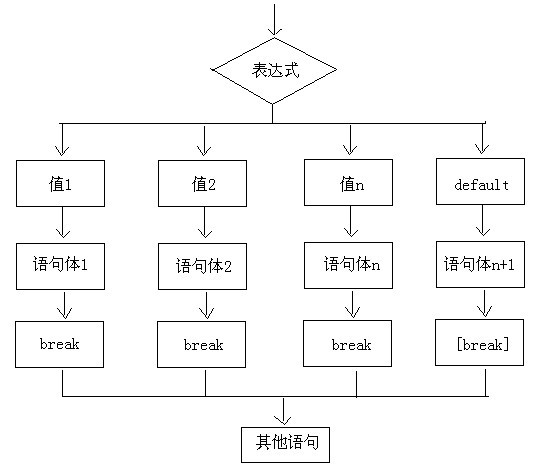
执行流程说明
首先计算出表达式的值 其次,和case依次比较,一旦有对应的值,就会执行相应的语句,在执行的过程中,遇到break就会结束。 最后,如果所有的case都和表达式的值不匹配,就会执行default语句体部分,然后程序结束掉。
执行流程
public class SwitchDemo {
public static void main(String[] args) {
//创建键盘录入对象
Scanner sc = new Scanner(System.in);
//接收数据
System.out.println("请输入一个数字(1-7):");
int weekday = sc.nextInt();
//switch语句实现选择
switch(weekday) {
case 1:
System.out.println("星期一");
break;
case 2:
System.out.println("星期二");
break;
case 3:
System.out.println("星期三");
break;
case 4:
System.out.println("星期四");
break;
case 5:
System.out.println("星期五");
break;
case 6:
System.out.println("星期六");
break;
case 7:
System.out.println("星期日");
break;
default:
System.out.println("你输入的数字有误");
break;
}
}
}
注意事项
1、swich(表达式)中表达式的返回值必须是以下几种类型之一: byte,short,char,int,枚举(jdk1.5),String(jdk1.7)
2、case子句中的值必须是常量,且所有case子句中的值应是不同的;
3、default子句是可任选的,当没有匹配的case时,执行default;
4、break语句用来在执行完一个case分支后使程序跳出swich语句块;如果没有break程序会顺序执行到swich结尾;
if分支结构和switch分支结构区别
if和swich语句很想,如果判断的具体数值不多,而且复合byte、short、int、char这四种类型。建议使用swich语句,因为效率稍高;
其他情况:对区间进行判断,对结果为boolean类型进行判断,使用if,if的使用范围比较广泛。
5.3 循环结构(三种)
while循环语句、do···while循环语句和for循环语句
5.3.1 for循环语句
格式
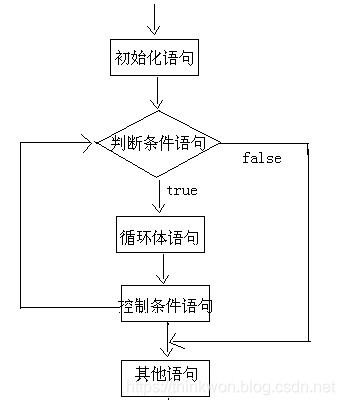
for(初始化语句;判断条件语句;控制条件语句) { 循环体语句; }
执行流程
5.3.2 foreach循环语句
格式
for (声明语句 : 表达式) { //代码句子 }
public class Test {
public static void main(String args[]) {
int [] numbers = {10, 20, 30, 40, 50};
for ( int x : numbers ) {
System.out.print( x );
System.out.print(",");
}
System.out.print();
String [] names = {"James", "Larry", "Tom", "Lacy"};
for ( String name : names ) {
System.out.print( name );
System.out.print(",");
}
}
}
它是Java5后新增的for语句的特殊简化版本,并不能完全替代for语句,但所有foreach语句都可以改写为for语句。foreach语句在遍历数组等时为程序员提供了很大的方便。
5.3.3 while循环语句(先判断再执行)
格式
基本格式 while(判断条件语句) { 循环体语句; } 扩展格式 初始化语句; while(判断条件语句) { 循环体语句; 控制条件语句; }
执行流程
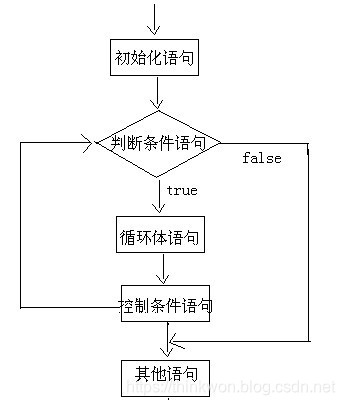
利用一个条件来控制是否要继续反复执行这个语句。
int x=1;
while(x<=10) {
System.out.println("HellloWorld");
x++;
}5.3.4 do…while循环语句(先执行再判断,相当于until语句)
格式
基本格式 do { 循环体语句; }while((判断条件语句); 扩展格式 初始化语句; do { 循环体语句; 控制条件语句; } while((判断条件语句);
执行流程
执行流程图

执行流程说明
A:执行初始化语句; B:执行循环体语句; C:执行控制条件语句; D:执行判断条件语句,看是true还是false 如果是true,回到B继续 如果是false,就结束
三种的区别
do…while循环至少会执行一次循环体。 for循环和while循环只有在条件成立的时候才会去执行循环体 for循环语句和while循环语句的小区别: 使用区别:控制条件语句所控制的那个变量,在for循环结束后,就不能再被访问到了,而while循环结束还可以继续使用,如果你想继续使用,就用while,否则推荐使用for。原因是for循环结束,该变量就从内存中消失,能够提高内存的使用效率。
跳转语句(控制循环结构)
3种跳转语句,分别是break语句、continue语句和return语句
/*
* break:中断的意思
* 使用场景:
* A:switch语句中
* B:循环中
* 注意:
* 离开使用场景是没有意义的。
* 作用:
* 跳出循环,让循环提前结束
*/
public class BreakDemo {
public static void main(String[] args) {
//break;
for(int x=1; x<=10; x++) {
if(x == 3) {
break;
}
System.out.println("HelloWorld");
}
}
}
/*
* continue:继续的意思
* 使用场景:
* 循环中
* 注意:
* 离开使用场景是没有意义的
* 作用:
* 结束一次循环,继续下一次的循环
* 区别:
* break:退出循环
* continue:结束一次循环,继续下一次的循环
*/
public class ContinueDemo {
public static void main(String[] args) {
//continue;
for(int x=1; x<=10; x++) {
if(x == 3) {
//break;
continue;
}
System.out.println("HelloWorld");
}
}
}
public class ReturnDemo {
public static void main(String[] args) {
getStr();
}
public String getStr() {
return "Hello";
}
}
六、运算符
6.1算术运算符
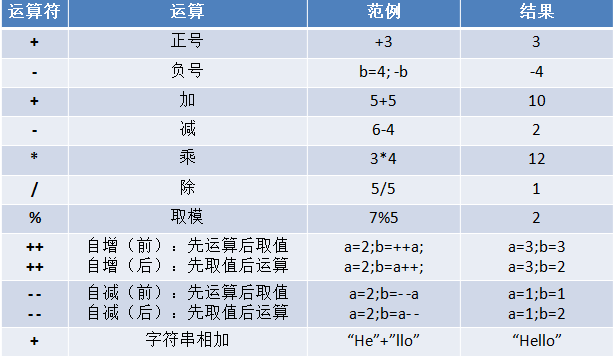
- 注意事项
- 1、/ 左右两端的类型需要一致;
- 2、%最后的符号和被模数相同;
- 3、前++;先+1,后运算 后++;先运算,后+1;不管出现在变量前还是后,总之++执行结束之后,变量的值一定会自加1。
- 4、+:当String字符串与其他数据类型只能做连接运算;并且结果为String类型;
6.2比较运算符
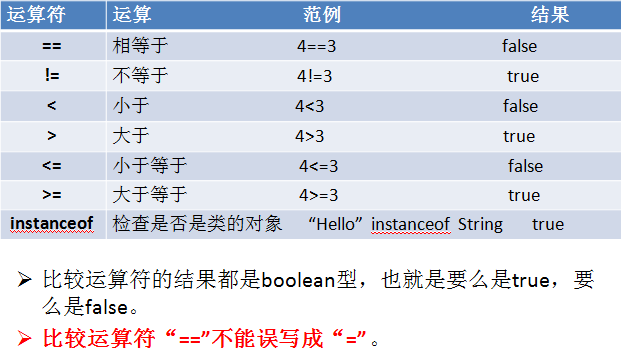
- 注意事项
- 1、比较运算符的两端都是boolean类型,也就是说要么是true,要么是false;
- 2、比较运算符的"==“与”="的作用是不同的,使用的时候需要小心。
6.3赋值运算符(自加、自减、自乘、自除、自模)
= 、+= 、-=、 *=、 /=、 %=
+=: a+=20;相当于a = (a的数据类型)(a + 20);
6.4逻辑运算符(符号的两端都是boolean类型)
& | ^ ! && ||- 注意事项
- 1、& 与 &&以及|与||的区别:
- &:左边无论真假,右边都会进行运算;
- &&:如果左边为假,则右边不进行运算;
- | 与 || 的区别同上;在使用的时候建议使用&&和||;
- 2、(^)与或(|)的不同之处是:当左右都为true时,结果为false。
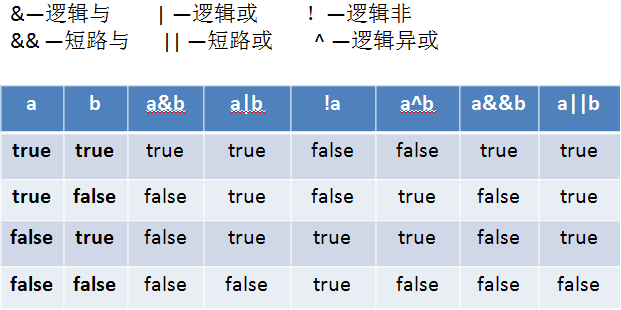
^
相同为0,不同为1,即
1 ^ 1 = 0
0 ^ 0 = 0
1 ^ 0 = 1
由运算规则可知,任何二进制数与零异或,都会等于其本身,即 A ^ 0 = A。
6.5位运算符
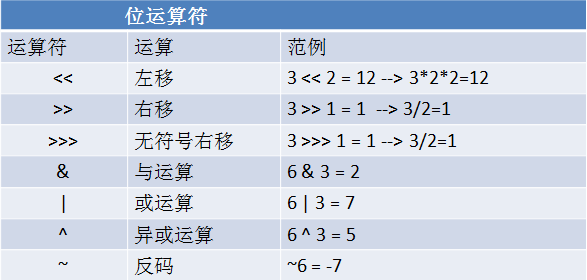
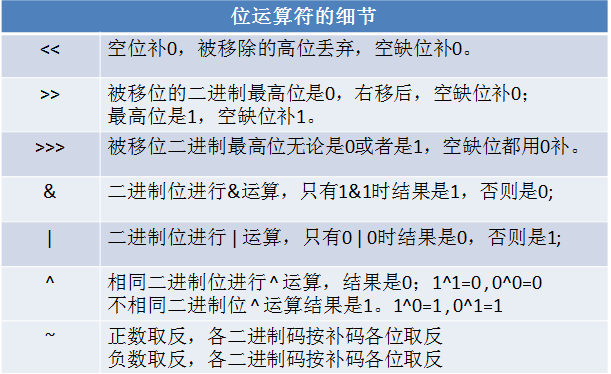
6.6三元运算符
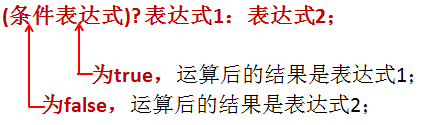
- 注意事项
- 1、表达式1与表达式2的类型必须一致;
- 2、使用三元运算符的地方一定可以使用if…else代替,反之不一定成立;
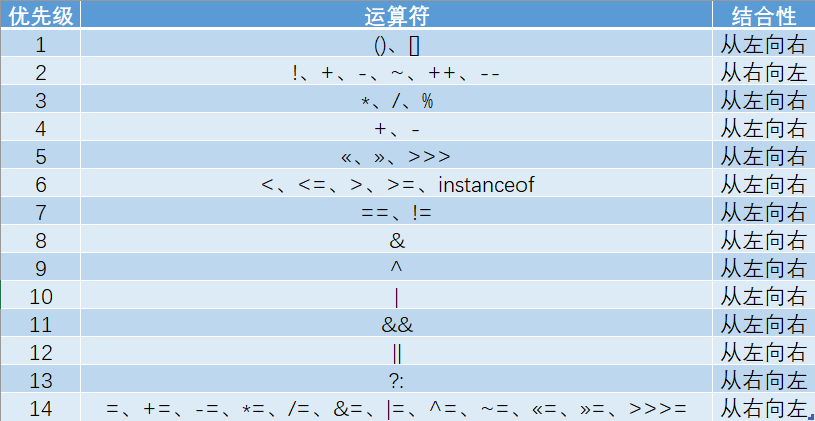
6.7运算符的优先级(从高到低)
七、常量(final)
- 常量值定义:常量和常量值是不同的概念,常量值又称为字面常量,它是通过数据直接表示的。
- Java 语言使用 final 关键字来定义一个常量 final int COUNT=10; final float HEIGHT=10.2F;
注意事项
- 在定义常量时就需要对该常量进行初始化。
- final 关键字不仅可以用来修饰基本数据类型的常量,还可以用来修饰对象的引用或者方法。
- 为了与变量区别,常量取名一般都用大写字符。
八、数据类型
定义
- Java语言是强类型语言,对于每一种数据都定义了明确的具体的数据类型,在内存中分配了不同大小的内存空间。
分类
- 基本数据类型
- 数值型
- 整数类型(byte,short,int,long)
- 浮点类型(float,double)
- 字符型(char)
- 布尔型(boolean)
- 数值型
- 引用数据类型
- 类(class)
- 接口(interface)
- 数组([])
计算机存储单元
-
定义:变量是内存中的小容器,用来存储数据。那么计算机内存是怎么存储数据的呢?无论是内存还是硬盘,计算机存储设备的最小信息单元叫“位(bit)”,我们又称之为“比特位”,通常用小写的字母b表示。而计算机最小的存储单元叫“字节(byte)”,通常用大写字母B表示,字节是由连续的8个位组成。
-
常用存储单元关系
-
1B= 8b 1KB = 1024B 1MB = 1024KB 1GB = 1024MB 1TB = 1024GB
Java基本数据类型图
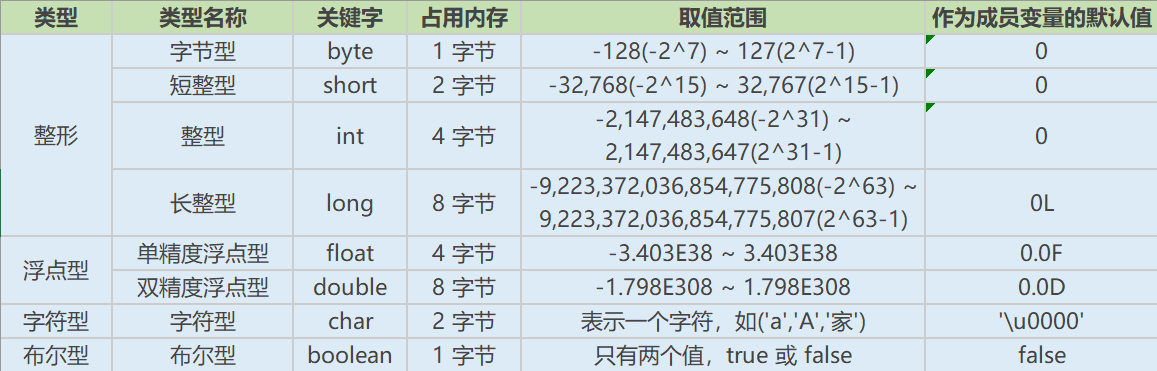
-
数据类型转换
- 分类
- 隐式转换
- 定义
- 在运算过程中,由于不同的数据类型会转换成同一种数据类型,所以整型、浮点型以及字符型都可以参与混合运算。自动转换的规则是从低级类型数据转换成高级类型数据。
- 转换规则
- 数值型数据的转换:byte→short→int→long→float→double。
- 字符型转换为整型:char→int。
- 转换条件
- 自动类型转换的实现需要同时满足两个条件:①两种数据类型彼此兼容,②目标类型的取值范围大于源数据类型(低级类型数据转换成高级类型数据)。例如 byte 类型向 short 类型转换时,由于 short 类型的取值范围较大,会自动将 byte 转换为 short 类型。
- 定义
- 显式转换
- 定义
- 当两种数据类型不兼容,或目标类型的取值范围小于源类型时,自动转换将无法进行,这时就需要进行强制类型转换。
- 语法格式
- 目标类型 变量名 = (目标类型) (被转换的数据); 举例:int b = (byte)(a + b);
- 注意
- 如果超出了被赋值的数据类型的取值范围得到的结果会与你期望的结果不同
- 不建议强制转换,因为会有精度的损失。
- 定义
- 隐式转换
九、反射
定义
Java反射机制是在运行状态中,对于任意一个类,都能够知道这个类的所有属性和方法;对于任意一个对象,都能够调用它的任意方法和属性。这种动态获取信息以及动态调用对象方法的功能称为Java语言的反射机制
用途
通过反射,Java 代码可以发现有关已加载类的字段,方法和构造函数的信息,并可以在安全限制内对这些字段,方法和构造函数进行操作。
当我们在使用 IDE(如 IDEA/Eclipse)时,当我们输入一个对象或者类并调用它的属性和方法时,一按 (“.”)点号,编译器就会自动列出她的属性或方法,这里就会用到反射。
反射最重要的用途就是开发各种通用框架(spring系列)
java反射框架提供一下功能:
- 在运行时判定任意一个对象所属的类
- 在运行时构造任意一个类的对象
- 在运行时判定任意一个类所具有的成员变量和方法
- 在运行时调用任意一个对象的方法
反射的优缺点
反射的优点
使用反射机制,代码可以在运行时装配,提高了程序的灵活性和扩展性,降低耦合性,提高自适应能力。它允许程序创建和控制任何类的对象,无需硬编码目标类
反射的缺点
性能问题:使用反射基本上是一种解释操作,JVM无法对这些代码进行优化,因此,反射操作的效率要比那些非反射操作低得多。反射机制主要应用在对灵活性和扩展性要求很高的系统框架上,对性能要求高的程序中不建议使用
安全限制:使用反射技术要求程序必须在一个没有安全限制的环境中运行
内部暴露:由于反射允许代码执行一些在正常情况下不被允许的操作(比如访问私有的属性和方法),所以使用反射可能会导致意料之外的副作用——代码有功能上的错误,降低可移植性。反射代码破坏了抽象性,因此当平台发生改变的时候,代码的行为就有可能也随着变化。
反射机制的相关类
与Java反射相关的类如下:
| 类名 | 用途 |
|---|---|
| Class类 | 代表类的实体,在运行的Java应用程序中表示类和接口 |
| Field类 | 代表类的成员变量(成员变量也称为类的属性) |
| Method类 | 代表类的方法 |
| Constructor类 | 代表类的构造方法 |
Class类
Class代表类的实体,在运行的Java应用程序中表示类和接口。在这个类中提供了很多有用的方法,这里对他们简单的分类介绍。
- 获得类相关的方法
| 方法 | 用途 |
|---|---|
| asSubclass(Class clazz) | 把传递的类的对象转换成代表其子类的对象 |
| Cast | 把对象转换成代表类或是接口的对象 |
| getClassLoader() | 获得类的加载器 |
| getClasses() | 返回一个数组,数组中包含该类中所有公共类和接口类的对象 |
| getDeclaredClasses() | 返回一个数组,数组中包含该类中所有类和接口类的对象 |
| forName(String className) | 根据类名返回类的对象 |
| getName() | 获得类的完整路径名字 |
| newInstance() | 创建类的实例 |
| getPackage() | 获得类的包 |
| getSimpleName() | 获得类的名字 |
| getSuperclass() | 获得当前类继承的父类的名字 |
| getInterfaces() | 获得当前类实现的类或是接口 |
- 获得类中属性相关的方法
| 方法 | 用途 |
|---|---|
| getField(String name) | 获得某个公有的属性对象 |
| getFields() | 获得所有公有的属性对象 |
| getDeclaredField(String name) | 获得某个属性对象 |
| getDeclaredFields() | 获得所有属性对象 |
- 获得类中注解相关的方法
| 方法 | 用途 |
|---|---|
| getAnnotation(Class annotationClass) | 返回该类中与参数类型匹配的公有注解对象 |
| getAnnotations() | 返回该类所有的公有注解对象 |
| getDeclaredAnnotation(Class annotationClass) | 返回该类中与参数类型匹配的所有注解对象 |
| getDeclaredAnnotations() | 返回该类所有的注解对象 |
- 获得类中构造器相关的方法
| 方法 | 用途 |
|---|---|
| getConstructor(Class…<?> parameterTypes) | 获得该类中与参数类型匹配的公有构造方法 |
| getConstructors() | 获得该类的所有公有构造方法 |
| getDeclaredConstructor(Class…<?> parameterTypes) | 获得该类中与参数类型匹配的构造方法 |
| getDeclaredConstructors() | 获得该类所有构造方法 |
- 获得类中方法相关的方法
| 方法 | 用途 |
|---|---|
| getMethod(String name, Class…<?> parameterTypes) | 获得该类某个公有的方法 |
| getMethods() | 获得该类所有公有的方法 |
| getDeclaredMethod(String name, Class…<?> parameterTypes) | 获得该类某个方法 |
| getDeclaredMethods() | 获得该类所有方法 |
- 类中其他重要的方法
| 方法 | 用途 |
|---|---|
| isAnnotation() | 如果是注解类型则返回true |
| isAnnotationPresent(Class<? extends Annotation> annotationClass) | 如果是指定类型注解类型则返回true |
| isAnonymousClass() | 如果是匿名类则返回true |
| isArray() | 如果是一个数组类则返回true |
| isEnum() | 如果是枚举类则返回true |
| isInstance(Object obj) | 如果obj是该类的实例则返回true |
| isInterface() | 如果是接口类则返回true |
| isLocalClass() | 如果是局部类则返回true |
| isMemberClass() | 如果是内部类则返回true |
Field类
Field代表类的成员变量(成员变量也称为类的属性)。
| 方法 | 用途 |
|---|---|
| equals(Object obj) | 属性与obj相等则返回true |
| get(Object obj) | 获得obj中对应的属性值 |
| set(Object obj, Object value) | 设置obj中对应属性值 |
Method类
Method代表类的方法。
| 方法 | 用途 |
|---|---|
| invoke(Object obj, Object… args) | 传递object对象及参数调用该对象对应的方法 |
Constructor类
Constructor代表类的构造方法。
| 方法 | 用途 |
|---|---|
| newInstance(Object… initargs) | 根据传递的参数创建类的对象 |
获取Class类对象的三种方法
在反射中,要获取一个类或调用一个类的方法,我们首先需要获取到该类的 Class 对象。 在 Java API 中,获取 Class 类对象的三种方法 方法一:使用 Class.forName 静态方法。当你知道该类的全路径名时,你可以使用该方法获取 Class 类对象。但可能抛出 ClassNotFoundException 异常 Class<?> classBook = Class.forName(“com.jourwon.reflect.Book”);
**方法二:**这种方法只适合在编译前就知道操作的 Class。直接通过 类名.class 的方式得到,该方法最为安全可靠,程序性能更高,这说明任何一个类都有一个隐含的静态成员变量 class Class clz = Book.class;
方法三:使用类对象的 getClass() 方法。 Book book1 = new Book(); Class<? extends Book> book1Class = book1.getClass();
@Test
public void getClz() {
try {
// 方法一,使用 Class.forName 静态方法
Class<?> classBook = Class.forName("com.jourwon.reflect.Book");
// 方法二:直接通过 类名.class 的方式得到
Class clz = Book.class;
// 方法三:使用类对象的 getClass() 方法。
Book book1 = new Book();
Class<? extends Book> book1Class = book1.getClass();
System.out.println(classBook == clz);
System.out.println(classBook == book1Class);
} catch (Exception ex) {
ex.printStackTrace();
}
}
public class ReflectClass {
private static final Logger log = LoggerFactory.getLogger(ReflectClass.class);
// 创建对象
@Test
public void reflectNewInstance() {
try {
Class<?> classBook = Class.forName("com.jourwon.reflect.Book");
Object objectBook = classBook.newInstance();
Book book = (Book) objectBook;
book.setName("Java高级特性-反射-创建对象");
book.setAuthor("JourWon");
log.info(book.toString());
} catch (Exception ex) {
ex.printStackTrace();
}
}
// 反射私有的构造方法
@Test
public void reflectPrivateConstructor() {
try {
Class<?> classBook = Class.forName("com.jourwon.reflect.Book");
Constructor<?> declaredConstructorBook = classBook.getDeclaredConstructor(String.class, String.class);
// 暴力反射
declaredConstructorBook.setAccessible(true);
Object objectBook = declaredConstructorBook.newInstance("Java高级特性-反射-反射私有的构造方法", "JourWon");
Book book = (Book) objectBook;
log.info(book.toString());
} catch (Exception ex) {
ex.printStackTrace();
}
}
// 反射私有属性
@Test
public void reflectPrivateField() {
try {
Class<?> classBook = Class.forName("com.jourwon.reflect.Book");
Object objectBook = classBook.newInstance();
Field fieldTag = classBook.getDeclaredField("TAG");
fieldTag.setAccessible(true);
String tag = (String) fieldTag.get(objectBook);
log.info(tag);
} catch (Exception ex) {
ex.printStackTrace();
}
}
// 反射私有方法
@Test
public void reflectPrivateMethod() {
try {
Class<?> classBook = Class.forName("com.jourwon.reflect.Book");
Method methodBook = classBook.getDeclaredMethod("declaredMethod", int.class);
methodBook.setAccessible(true);
Object objectBook = classBook.newInstance();
String string = (String) methodBook.invoke(objectBook, 0);
ReflectClass.
log.info(string);
} catch (Exception ex) {
ex.printStackTrace();
}
}
}
通过反射获取私有属性,方法和构造方法时,需要进行暴力反射,设置setAccessible(true)。否则会报错说无法获取私有属性,方法和构造方法
总结
本文列举了反射机制使用过程中常用的、重要的一些类及其方法,更多信息和用法,反射原理和源码分析需要近一步的阅读反射相关资料。
在阅读Class类文档时发现一个特点,以通过反射获得Method对象为例,一般会提供四种方法,getMethod(parameterTypes)、getMethods()、getDeclaredMethod(parameterTypes)和getDeclaredMethods()。getMethod(parameterTypes)用来获取某个公有的方法的对象,getMethods()获得该类所有公有的方法,getDeclaredMethod(parameterTypes)获得该类某个方法,getDeclaredMethods()获得该类所有方法。带有Declared修饰的方法可以反射到私有的方法,没有Declared修饰的只能用来反射公有的方法。其他的Annotation、Field、Constructor也是如此。
文章知识点与官方知识档案匹配,可进
十、语法糖
语法糖(Syntactic Sugar),也称糖衣语法,是由英国计算机学家 Peter.J.Landin(彼得·兰丁) 发明的一个术语,指在计算机语言中添加的某种语法,这种语法对语言的功能并没有影响,但是更方便程序员使用。语法糖就是对现有语法的一个封装。简而言之,语法糖让程序更加简洁,有更高的可读性。
在编程领域,除了语法糖,还有语法盐和语法糖精的说法Java虚拟机并不支持这些语法糖。这些语法糖在编译阶段就会被还原成简单的基础语法结构,这个过程就是解语法糖。
Java 中最常用的语法糖主要有switch语句支持String与枚举、泛型和类型擦除、自动装箱与拆箱、方法边长参数、枚举、内部类、条件编译、断言、数值字面量、增强for循环、try-with-resources语句、Lambda表达式等。本文主要来分析下这些语法糖背后的原理。一步一步剥去糖衣,
糖块一、switch支持String与枚举
Java 7中switch语句开始支持String。
Java中的swith自身原本就支持基本类型。比如int、char等。
对于int类型,直接进行数值的比较。对于char类型则是比较其ascii码。
所以,对于编译器来说,switch中其实只能使用整型,任何类型的比较都要转换成整型。比如byte。short,char(ackii码是整型)以及int。
那么接下来看下switch对String的支持,有以下代码:
public class SwitchDemoString {
public static void main(String[] args) {
String str = "world";
switch (str) {
case "hello":
System.out.println("hello");
break;
case "world":
System.out.println("world");
break;
default:
break;
}
}
}
反编译后:
public class SwitchStringDemo {
public static void main(String[] args) {
String str;
String string = str = "world";
int n = -1;
switch (string.hashCode()) {
case 99162322: {
if (!string.equals("hello")) break;
n = 0;
break;
}
case 113318802: {
if (!string.equals("world")) break;
n = 1;
}
}
switch (n) {
case 0: {
System.out.println("hello");
break;
}
case 1: {
System.out.println("world");
break;
}
}
}
}
你知道原来字符串的switch是通过equals()和hashCode()方法来实现的。还好hashCode()方法返回的是int,而不是long。
仔细看下可以发现,进行switch比较的实际是哈希值,然后通过使用equals方法比较进行安全检查,这个检查是必要的,因为哈希可能会发生碰撞。因此它的性能是不如使用枚举进行switch或者使用纯整数常量,但这也不是很差。
糖块二、泛型和类型擦除
很多语言都是支持泛型的,但是不同的编译器对于泛型的处理方式是不同的。
通常情况下,一个编译器处理泛型有两种方式:Code specialization和Code sharing。
C++和C#是使用Code specialization的处理机制,而Java使用的是Code sharing的机制。
Code sharing方式为每个泛型类型创建唯一的字节码表示,并且将该泛型类型的实例都映射到这个唯一的字节码表示上。将多种泛型类形实例映射到唯一的字节码表示是通过类型擦除(type erasue)实现的。
也就是说,对于Java虚拟机来说,他根本不认识Map<String, String> map这样的语法。需要在编译阶段通过类型擦除的方式进行解语法糖。
类型擦除的主要过程如下:
- 将所有的泛型参数用其最左边界(最顶级的父类型)类型替换。
- 移除所有的类型参数。
以下代码:
Map<String, String> map = new HashMap<String, String>();
map.put("name", "JourWon");
map.put("wechat", "JourWon");
map.put("blog", "https://blog.csdn.net/ThinkWon");
解语法糖之后会变成:
Map map = new HashMap();
map.put("name", "JourWon");
map.put("wechat", "JourWon");
map.put("blog", "https://blog.csdn.net/ThinkWon"); 虚拟机中没有泛型,只有普通类和普通方法,所有泛型类的类型参数在编译时都会被擦除,泛型类并没有自己独有的Class类对象。比如并不存在List.class或是List.class,而只有List.class。
一:泛型本质
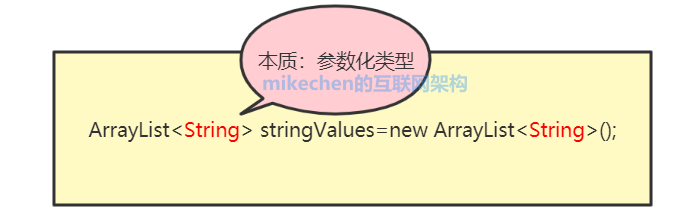
Java 泛型(generics)是 JDK 5 中引入的一个新特性, 泛型提供了编译时类型安全检测机制,该机制允许程序员在编译时检测到非法的类型。
泛型的本质是参数化类型,即给类型指定一个参数,然后在使用时再指定此参数具体的值,那样这个类型就可以在使用时决定了。这种参数类型可以用在类、接口和方法中,分别被称为泛型类、泛型接口、泛型方法。
二:为什么使用泛型
泛型的好处是在编译的时候检查类型安全,并且所有的强制转换都是自动和隐式的,提高代码的重用率。
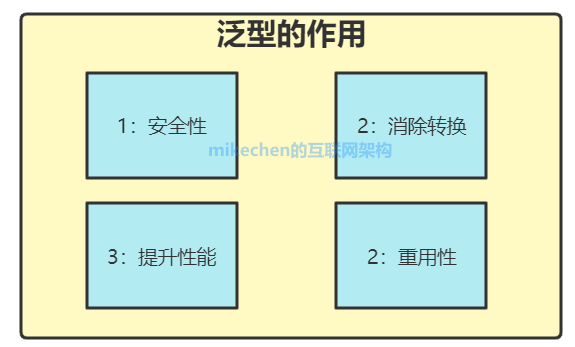
(1)保证了类型的安全性。
相当于告诉编译器每个集合接收的对象类型是什么,编译器在编译期就会做类型检查,告知是否插入了错误类型的对象,使得程序更加安全,增强了程序的健壮性。
(2) 消除强制转换
泛型的一个附带好处是,消除源代码中的许多强制类型转换,这使得代码更加可读,并且减少了出错机会。
(3)避免了不必要的装箱、拆箱操作,提高程序的性能
在非泛型编程中,将筒单类型作为Object传递时会引起Boxing(装箱)和Unboxing(拆箱)操作,这两个过程都是具有很大开销的。引入泛型后,就不必进行Boxing和Unboxing操作了,所以运行效率相对较高,特别在对集合操作非常频繁的系统中,这个特点带来的性能提升更加明显。
(4)提高了代码的重用性。
三:如何使用泛型
泛型有三种使用方式,分别为:泛型类、泛型接口和泛型方法。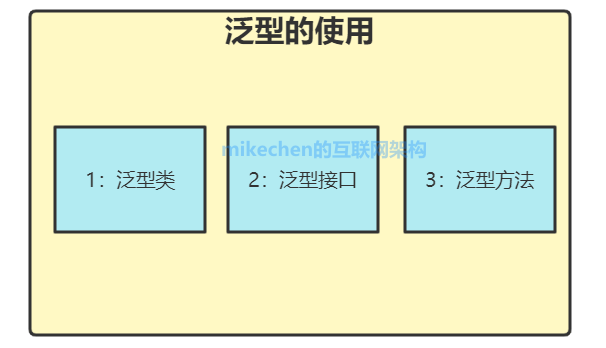
1、泛型类
泛型类:把泛型定义在类上
定义格式:
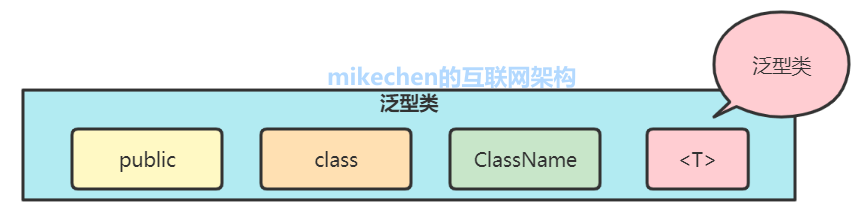
class 类名称 <泛型标识> {
private 泛型标识 /*(成员变量类型)*/ 变量名;
.....
}
}- 尖括号 <> 中的 泛型标识被称作是
类型参数,用于指代任何数据类型。 - 泛型标识是任意设置的(如果你想可以设置为 Hello都行),Java 常见的泛型标识以及其代表含义如下:
T :代表一般的任何类。 E :代表 Element 元素的意思,或者 Exception 异常的意思。 K :代表 Key 的意思。 V :代表 Value 的意思,通常与 K 一起配合使用。 S :代表 Subtype 的意思,文章后面部分会讲解示意。
2.泛型中KTVE的含义
如果点开JDK中一些泛型类的源码,我们会看到下面这些代码:
public class ArrayList<E> extends AbstractList<E> implements List<E>, RandomAccess, Cloneable, java.io.Serializable{
...
}
public class HashMap<K,V> extends AbstractMap<K,V> implements Map<K,V>, Cloneable, Serializable {
...
}
123456上面这些泛型类定义中的泛型参数E、K和V都是什么意思呢?其实这些参数名称是可以任意指定,就想方法的参数名一样可以任意指定,但是我们通常会起一个有意义的名称,让别人一看就知道是什么意思。泛型参数也一样,E一般是指元素,用来集合类中。
常见泛型参数名称有如下:
E: Element (在集合中使用,因为集合中存放的是元素) T:Type(Java 类) K: Key(键) V: Value(值) N: Number(数值类型) ?: 表示不确定的java类型
举例如下:
//设置泛型类Generic
public class Generic<T> {
//泛型里面的变量数据类型为T,在使用时由外部传入
private T key;
public Generic() {
}
// 泛型方法 getKey 的返回值类型为 T,T 的类型由外部指定
public Generic(T key) {
this.key = key;
}
//同上
public T getKey() {
return key;
}
public void setKey(T key) {
this.key = key;
}
}在泛型类中,类型参数定义的位置有三处,分别为:
1.非静态的成员属性类型
eg.
TEXTprivate T key;2.非静态方法的形参类型(包括非静态成员方法和构造器)
eg.
Java//非静态有参的方法 public Generic(T key) { this.key = key; } //构造器 public T getKey() { return key; } public void setKey(T key) { this.key = key; }3.非静态的成员方法的返回值类型
Javapublic T hello(T t){ return key; }
(2)泛型类中的静态方法和静态变量不可以使用泛型类所声明的类型参数
可以这样理解:
泛型是为了在传输变量指定变量类型避免数据类型异常,同时可以使用泛型类,泛型接口,泛型方法来重写代码
而静态方法和静态变量是固定的数据类型,使用泛型肯定不行
eg.
public class Test<T> {
public static T one; // 编译错误
public static T show(T one){ // 编译错误
return null;
}
} - 泛型类中的类型参数的确定是在创建泛型类对象的时候(例如 ArrayList< Integer >)。
- 而静态变量和静态方法在类加载时已经初始化,直接使用类名调用;在泛型类的类型参数未确定时,静态成员有可能被调用,因此泛型类的类型参数是不能在静态成员中使用的。
(3)静态泛型方法中可以使用自身的方法签名中新定义的类型参数(即泛型方法,后面会说到),而不能使用泛型类中定义的类型参数。
eg.
public class Test2<T> {
// 泛型类定义的类型参数 T 不能在静态方法中使用
public static <E> E show(E one){ // 这是正确的,因为 E 是在静态方法签名中新定义的类型参数
return null;
}
}
(4)泛型类不只接受一个类型参数,它还可以接受多个类型参数。用逗号隔开
eg.
public class MultiType <E,T> {
E value1;
T value2;
public E getValue1(){
return value1;
}
public T getValue2(){
return value2;
}
}3. 泛型类的使用
在创建泛型类的对象时,必须指定类型参数 T 的具体数据类型,即尖括号 <> 中传入的什么数据类型,T 便会被替换成对应的类型。如果 <> 中什么都不传入,则默认是 < Object >。
使用:
//泛型类
public class Generic<T> {
private T key;
public Generic(T key) {
this.key = key;
}
public T getKey(){
return key;
}
}
//调用时,在<>中传入具体数据类型
@ Test
public void test() {
Generic<String> generic = new Generic<>();// 传入 String 类型,这样就指定了这个对象的数据类型为String类型
//如果在使用时用了非String类型,则会在编译时报错,不会再运行时报错
// <> 中什么都不传入,等价于 Generic<Object> generic = new Generic<>();
Generic generic = new Generic();
}
//指定类型以后,相对于实体类为
public class Generic {
private String key;
public Generic(String key) {
this.key = key;
}
public String getKey() {
return key;
}
}
- 可以发现,泛型类中的
类型参数 T被 <> 中的 String 类型全部替换了。- 使用泛型的上述特性便可以在集合中限制添加对象的数据类型,若集合中添加的对象与指定的泛型数据类型不一致,则编译器会直接报错,这也是泛型的类型安全检测机制的实现原理。
//如果在使用时用了非String类型,则会在编译时报错,不会再运行时报错
4.总结泛型类
3.1泛型类语法
Javaclass 类名称 <泛型标识> { private 泛型标识 /*(成员变量类型)*/ 变量名; ..... } }3.2泛型<>放在哪?
1..非静态的成员属性类型
2.非静态方法的形参类型(包括非静态成员方法和构造器)
3.非静态的成员方法的返回值类型
3.3泛型类注意点:
1.泛型类中的静态方法和静态变量不可以使用泛型类所声明的类型参数
但是静态泛型方法中可以使用自身的方法签名中新定义的类型参数(即泛型方法,后面会说到),而不能使用泛型类中定义的类型参数。
2.泛型类不只接受一个类型参数,它还可以接受多个类型参数。用逗号隔开
3.4 泛型的使用
在创建泛型类的对象时,指定类型参数 T 的具体数据类型,即尖括号 <> 中传入的什么数据类型,T 便会被替换成对应的类型。如果 <> 中什么都不传入,则默认是 < Object >。
四、泛型接口
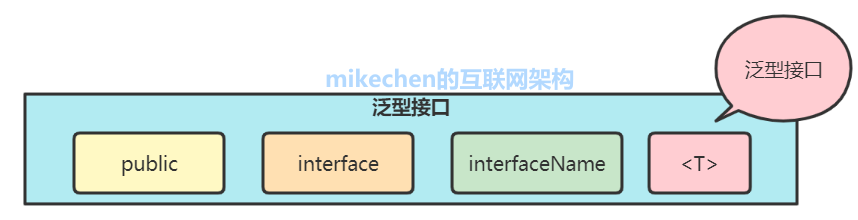
public interface 接口名<类型参数> {
...
}
重要!泛型接口中的类型参数,在该接口被继承或者被实现时确定。解释如下:
(1)定义一个泛型接口如下:
- 注意:在泛型接口中,静态成员也不能使用泛型接口定义的类型参数。(接口里面静态成员默认是final类型的,在JVM阶段就创建了的,而在编译阶段才使用泛型的变量,所以不能使用泛型)
interface IUsb<U, R> {
int n = 10;
U name;// 报错! 接口中的属性默认是静态的,因此不能使用类型参数声明
R get(U u);// 普通方法中,可以使用类型参数
void hi(R r);// 抽象方法中,可以使用类型参数
// 在jdk8 中,可以在接口中使用默认方法, 默认方法可以使用泛型接口的类型参数
default R method(U u) {
return null;
}
}(2)在继承泛型接口时,必须确定泛型接口的类型参数
这个的就是同泛型类一样,在使用时要确定具体的接口,和接口中去写抽象方法一样,在实现时一定要重写该方法
eg.
//定义一个接口 IA 继承了 泛型接口 IUsb,在 接口 IA 定义时必须确定泛型接口 IUsb 中的类型参数。
// 在继承泛型接口时,必须确定泛型接口的类型参数
interface IA extends IUsb<String, Double> {
...
}
// 当去实现 IA 接口时,因为 IA 在继承 IUsu 接口时,指定了类型参数 U 为 String,R 为 Double
// 所以在实现 IUsb 接口的方法时,使用 String 替换 U,用 Double 替换 R
class AA implements IA {
@Override
public Double get(String s) {
return null;
}
@Override
public void hi(Double d) {
...
}
}
(3)定义一个类实现了泛型接口 ,在 类 定义时需要确定泛型接口中的类型参数。
//定义一个类 BB 实现了 泛型接口 IUsb,在 类 BB 定义时需要确定泛型接口 IUsb 中的类型参数。
// 实现接口时,需要指定泛型接口的类型参数
// 给 U 指定 Integer, 给 R 指定了 Float
// 所以,当我们实现 IUsb 方法时,会使用 Integer 替换 U, 使用 Float 替换 R
class BB implements IUsb<Integer, Float> {
@Override
public Float get(Integer integer) {
return null;
}
@Override
public void hi(Float afloat) {
...
}
}(4)定义一个类实现了泛型接口时,若是没有确定泛型接口中的类型参数,则默认为 Object。
// 实现泛型接口时没有确定类型参数,则默认为 Object
// 建议直接写成 IUsb<Object, Object>
class CC implements IUsb {//等价 class CC implements IUsb<Object, Object>
@Override
public Object get(Object o) {
return null;
}
@Override
public void hi(Object o) {
...
}
}(5)定义一个类实现了 泛型接口时,若是没有确定泛型接口中的类型参数,也可以将类也定义为泛型类,其声明的类型参数必须要和接口中的类型参数相同。
// DD 类定义为 泛型类,则不需要确定 接口的类型参数
// 但 DD 类定义的类型参数要和接口中类型参数的一致
class DD<U, R> implements IUsb<U, R> {
...
}总结:
泛型接口的语法:
Javapublic interface 接口名<类型参数> { ... }语法要求:
1.静态成员使用泛型接口定义的类型参数
2.在继承(使用)泛型接口时,必须确定泛型接口的类型参数
3.定义一个类实现泛型接口 ,确定类中的类型参数有三种情况:
3.1确定泛型接口中的类型参数,
3.2 不确定泛型接口中的类型参数,则默认为 Object。
3.3(套娃)定义为泛型类,但是其声明的类型参数必须要和接口中的类型参数相同。
五.泛型方法
当在一个方法签名中的返回值前面声明了一个 < T > 时,该方法就被声明为一个泛型方法。< T >表明该方法声明了一个类型参数 T,并且这个类型参数 T 只能在该方法中使用。当然,泛型方法中也可以使用泛型类中定义的泛型参数。
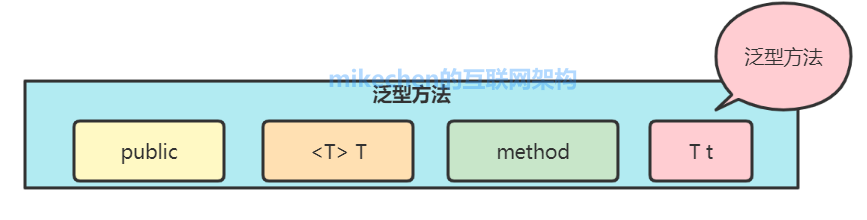
public <类型参数> 返回类型 方法名(类型参数 变量名) {
...
}/**
*
* @param t 传入泛型的参数
* @param <T> 泛型的类型
* @return T 返回值为T类型
* 说明:
* 1)public 与 返回值中间<T>非常重要,可以理解为声明此方法为泛型方法。
* 2)只有声明了<T>的方法才是泛型方法,泛型类中的使用了泛型的成员方法并不是泛型方法。
* 3)<T>表明该方法将使用泛型类型T,此时才可以在方法中使用泛型类型T。
* 4)与泛型类的定义一样,此处T可以随便写为任意标识,常见的如T、E等形式的参数常用于表示泛型。
*/
public <T> T genercMethod(T t){
System.out.println(t.getClass());
System.out.println(t);
return t;
}
public static void main(String[] args) {
GenericsClassDemo<String> genericString = new GenericsClassDemo("helloGeneric"); //这里的泛型跟下面调用的泛型方法可以不一样。
String str = genericString.genercMethod("hello");//传入的是String类型,返回的也是String类型
Integer i = genericString.genercMethod(123);//传入的是Integer类型,返回的也是Integer类型
}
class java.lang.String
hello
class java.lang.Integer
123 注意:
(1)只有在方法签名中声明了< T >的方法才是泛型方法,仅使用了泛型类定义的类型参数的方法并不是泛型方法。
eg.
Javapublic class Test<U> { // 该方法只是使用了泛型类定义的类型参数,不是泛型方法 public void testMethod(U u){ System.out.println(u); } // <T> 真正声明了下面的方法是一个泛型方法 public <T> T testMethod1(T t){ return t; } } 泛型方法中也可以使用泛型类中定义的泛型参数
eg.
Javapublic class TestMethod<U> { public <T> U testMethod(T t, U u) { return u; } } 泛型类中定义的类型参数和泛型方法中定义的类型参数是相互独立的,它们一点关系都没有
< T >表明该方法声明了一个类型参数 T,并且这个类型参数 T 只能在该方法中使用。
为了避免混淆,如果在一个泛型类中存在泛型方法,那么两者的类型参数最好不要同名。
Javapublic class Test<T> { public void testMethod(T t) { System.out.println(t); } public <T> T testMethod1(T t) {//为了避免混淆,尽量不要同名 return t; } } 与泛型类的类型参数定义一样,此处泛型方法中的 T 可以写为
任意标识,常见的如 T、E、K、V 等形式的参数常用于表示泛型(2)泛型方法中可以同时声明多个类型参数。
eg.
Javapublic class TestMethod<U> { public <T, S> T testMethod(T t, S s) { return null; } }(3)将静态方法声明为泛型方法
前面在泛型类的定义中提到,在静态成员中不能使用泛型类定义的类型参数,但我们可以将静态成员方法定义为一个泛型方法
静态泛型方法中可以使用自身的方法签名中新定义的类型参数(即泛型方法),而不能使用泛型类中定义的类型参数。
eg.
Javapublic class Test2<T> { // 泛型类定义的类型参数 T 不能在静态方法中使用 // 但可以将静态方法声明为泛型方法,方法中便可以使用其声明的类型参数了 public static <E> E show(E one) { return null; } }
泛型方法的使用
泛型类,在创建类的对象的时候确定类型参数的具体类型; 泛型方法,在调用方法的时候再确定类型参数的具体类型。
泛型方法签名中声明的类型参数只能在该方法里使用,而泛型接口、泛型类中声明的类型参数则可以在整个接口、类中使用。 当调用泛型方法时,根据外部传入的实际对象的数据类型,
编译器就可以判断出类型参数 T所代表的具体数据类型。
举例如下:
public class Demo {
public static void main(String args[]) {
GenericMethod d = new GenericMethod(); // 创建 GenericMethod 对象
String str = d.fun("汤姆"); // 给GenericMethod中的泛型方法传递字符串
int i = d.fun(30); // 给GenericMethod中的泛型方法传递数字,自动装箱
System.out.println(str); // 输出 汤姆
System.out.println(i); // 输出 30
GenericMethod.show("Lin");// 输出: 静态泛型方法 Lin
}
}
class GenericMethod {
// 普通的泛型方法
public <T> T fun(T t) { // 可以接收任意类型的数据
return t;
}
// 静态的泛型方法
public static <E> void show(E one){
System.out.println("静态泛型方法 " + one);
}
}
- 不难发现,当调用泛型方法时,根据传入的实际对象,
编译器会判断出类型形参 T 所代表的具体数据类型。
泛型方法中的类型推断
在调用泛型方法的时候,可以显式地指定类型参数,也可以不指定。
- 当泛型方法的形参列表中有多个类型参数时,在不指定类型参数的情况下,方法中声明的的类型参数为泛型方法中的几种类型参数的共同父类的最小级,直到 Object。
- 在指定了类型参数的时候,传入泛型方法中的实参的数据类型必须为指定数据类型或者其子类。
举例如下:
public class Test {
// 这是一个简单的泛型方法
public static <T> T add(T x, T y) {
return y;
}
public static void main(String[] args) {
// 一、不显式地指定类型参数
//(1)传入的两个实参都是 Integer,所以泛型方法中的<T> == <Integer>
int i = Test.add(1, 2);
//(2)传入的两个实参一个是 Integer,另一个是 Float,
// 所以<T>取共同父类的最小级,<T> == <Number>
Number f = Test.add(1, 1.2);
// 传入的两个实参一个是 Integer,另一个是 String,
// 所以<T>取共同父类的最小级,<T> == <Object>
Object o = Test.add(1, "asd");
// 二、显式地指定类型参数
//(1)指定了<T> = <Integer>,所以传入的实参只能为 Integer 对象
int a = Test.<Integer>add(1, 2);
//(2)指定了<T> = <Integer>,所以不能传入 Float 对象
int b = Test.<Integer>add(1, 2.2);// 编译错误
//(3)指定<T> = <Number>,所以可以传入 Number 对象
// Integer 和 Float 都是 Number 的子类,因此可以传入两者的对象
Number c = Test.<Number>add(1, 2.2);
}
}总结
泛型方法
语法:
Javapublic <类型参数> 返回类型 方法名(类型参数 变量名) { ... }注意:
1.区别:
1.1泛型类中的泛型方法是使用了泛型类定义的数据类型,泛型方法是在修饰符后面加了<>
1.2 跟定义类和方法一样,类中的泛型可以被用于方法。方法中的泛型是局部变量,只能用于方法内部
2.静态泛型方法是在返回类型上定义泛型
3.使用:
Java**泛型类,在创建类的对象的时候确定类型参数的具体类型; 泛型方法,在调用方法的时候再确定类型参数的具体类型。** 3.2 在对象后用<>指定使用类型,不指定根据传入的数据自动装箱,向上找共同的父类数据类型
六、类型擦除
1. 什么是类型擦除
泛型的本质是将数据类型参数化,它通过擦除的方式来实现,即编译器会在编译期间擦除代码中的所有泛型语法并相应的做出一些类型转换动作。
换而言之,泛型信息只存在于代码编译阶段,在代码编译结束后,与泛型相关的信息会被擦除掉,专业术语叫做类型擦除。也就是说,成功编译过后的 class 文件中不包含任何泛型信息,泛型信息不会进入到运行时阶段。
看一个例子,假如我们给 ArrayList 集合传入两种不同的数据类型,并比较它们的类信息。
代码如下:
public class GenericType {
public static void main(String[] args) {
ArrayList<String> arrayString = new ArrayList<String>();
ArrayList<Integer> arrayInteger = new ArrayList<Integer>();
System.out.println(arrayString.getClass() == arrayInteger.getClass());// true
}
}
1234567- 在这个例子中,我们定义了两个 ArrayList 集合,不过一个是 ArrayList< String>,只能存储字符串。一个是 ArrayList< Integer>,只能存储整型对象。我们通过 arrayString 对象和 arrayInteger 对象的
getClass()方法获取它们的类信息并比较,发现结果为true。 - 明明我们在 <> 中传入了两种不同的数据类型,按照上文所说的,它们的类型参数 T 不是应该被替换成我们传入的数据类型了吗,那为什么它们的类信息还是相同呢? 这是因为,在编译期间,所有的
泛型信息都会被擦除, ArrayList< Integer > 和 ArrayList< String >类型,在编译后都会变成ArrayList< Objec t>类型。
再看一个例子,假设定义一个泛型类如下:
public class Caculate<T> {
private T num;
}在该泛型类中定义了一个属性 num,该属性的数据类型是泛型类声明的类型参数 T ,这个 T 具体是什么类型,我们也不知道,它只与外部传入的数据类型有关。将这个泛型类反编译。
代码如下:
public class Caculate {
public Caculate() {}// 默认构造器,不用管
private Object num;// T 被替换为 Object 类型
}
12345- 可以发现编译器
擦除了 Caculate 类后面的泛型标识 < T >,并且将 num 的数据类型替换为 Object 类型,而替换了 T 的数据类型我们称之为原始数据类型。
那么是不是所有的类型参数被擦除后都以 Object 类进行替换呢?
- 答案是否定的,大部分情况下,类型参数 T 被擦除后都会以 Object 类进行替换;而有一种情况则不是,那就是使用到了 extends 和 super 语法的
有界类型参数(即泛型通配符,后面我们会详细解释)。
再看一个例子,假设定义一个泛型类如下:
public class Caculate<T extends Number> {
private T num;
}
123将其反编译:
public class Caculate {
public Caculate() {}// 默认构造器,不用管
private Number num;
}
12345- 可以发现,使用到了 extends 语法的类型参数 T 被擦除后会替换为 Number 而不再是 Object。
- extends 和 super 是一个限定类型参数边界的语法,extends 限定 T 只能是 Number 或者是 Number 的子类。 也就是说,在创建 Caculate 类对象的时候,
尖括号 <> 中只能传入 Number 类或者 Number 的子类的数据类型,所以在创建 Caculate 类对象时无论传入什么数据类型,Number 都是其父类,于是可以使用 Number 类作为 T 的原始数据类型,进行类型擦除并替换。(这一部分涉及到了泛型通配符,在下面还会具体介绍)
2. 类型擦除的原理
假如我们定义了一个 ArrayList< Integer > 泛型集合,若向该集合中插入 String 类型的对象,不需要运行程序,编译器就会直接报错。这里可能有小伙伴就产生了疑问:
- 不是说泛型信息在编译的时候就会被擦除掉吗?那既然泛型信息被擦除了,如何保证我们在集合中只添加指定的数据类型的对象呢?
- 换而言之,我们虽然定义了 ArrayList< Integer > 泛型集合,但其泛型信息最终被擦除后就变成了
ArrayList< Object > 集合,那为什么不允许向其中插入 String 对象呢?
Java 是如何解决这个问题的?
- 其实在创建一个泛型类的对象时, Java 编译器是先检查代码中传入 < T > 的数据类型,并记录下来,然后再对代码进行编译,
编译的同时进行类型擦除;如果需要对被擦除了泛型信息的对象进行操作,编译器会自动将对象进行类型转换。
可以把泛型的
类型安全检查机制和类型擦除想象成演唱会的验票机制:以 ArrayList< Integer> 泛型集合为例。
- 当我们在创建一个 ArrayList< Integer > 泛型集合的时候,ArrayList 可以看作是演唱会场馆,而< T >就是场馆的验票系统,Integer 是验票系统设置的门票类型;
- 当验票系统设置好为< Integer >后,只有持有 Integer 门票的人才可以通过验票系统,进入演唱会场馆(集合)中;若是未持有 Integer 门票的人想进场,则验票系统会发出警告(编译器报错)。
- 在通过验票系统时,门票会被收掉(类型擦除),但场馆后台(JVM)会记录下观众信息(泛型信息)。
- 进场后的观众变成了没有门票的普通人(原始数据类型)。但是,在需要查看观众的信息时(操作对象),场馆后台可以找到记录的观众信息(编译器会自动将对象进行类型转换)。
举例如下:
public class GenericType {
public static void main(String[] args) {
ArrayList<Integer> arrayInteger = new ArrayList<Integer>();// 设置验票系统
arrayInteger.add(111);// 观众进场,验票系统验票,门票会被收走(类型擦除)
Integer n = arrayInteger.get(0);// 获取观众信息,编译器会进行强制类型转换
System.out.println(n);
}
}擦除 ArrayList< Integer > 的泛型信息后,get() 方法的返回值将返回 Object 类型,但编译器会自动插入 Integer 的强制类型转换。也就是说,编译器把 get() 方法调用翻译为两条字节码指令:
- 对原始方法 get() 的调用,返回的是 Object 类型;
- 将返回的 Object 类型强制转换为 Integer 类型;
代码如下:
Integer n = arrayInteger.get(0);// 这条代码底层如下:
//(1)get() 方法的返回值返回的是 Object 类型
Object object = arrayInteger.get(0);
//(2)编译器自动插入 Integer 的强制类型转换
Integer n = (Integer) object;
1234563. 类型擦除小结
泛型信息(包括泛型类、接口、方法)只在代码编译阶段存在,在代码成功编译后,其内的所有泛型信息都会被擦除,并且类型参数 T 会被统一替换为其原始类型(默认是 Object 类,若有 extends 或者 super 则另外分析);- 在泛型信息被擦除后,若还需要使用到对象相关的泛型信息,编译器底层会
自动进行类型转换(从原始类型转换为未擦除前的数据类型)。
七、 泛型通配符
Java泛型的通配符是用于解决泛型之间引用传递问题的特殊语法, 主要有以下三类:
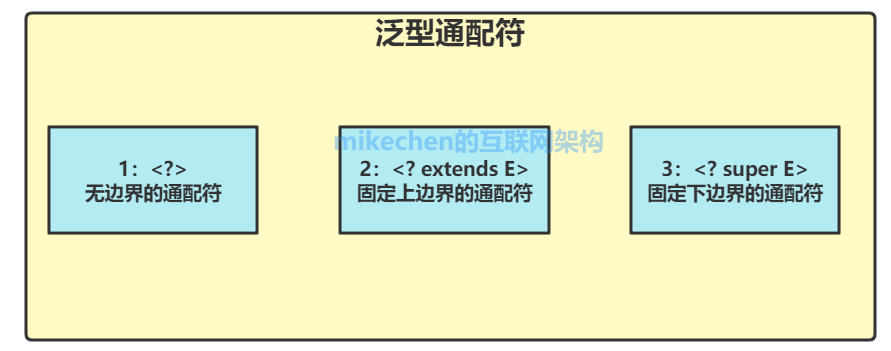
//表示类型参数可以是任何类型 public class Apple<?>{}
//表示类型参数必须是A或者是A的子类 public class Apple<T extends A>{}
//表示类型参数必须是A或者是A的超类型 public class Apple<T supers A>{}
1. 无边界的通配符(Unbounded Wildcards), 就是<?>, 比如List<?>
无边界的通配符的主要作用就是让泛型能够接受未知类型的数据.
2. 固定上边界的通配符(Upper Bounded Wildcards),采用<? extends E>的形式
使用固定上边界的通配符的泛型, 就能够接受指定类及其子类类型的数据。
要声明使用该类通配符, 采用<? extends E>的形式, 这里的E就是该泛型的上边界。
注意: 这里虽然用的是extends关键字, 却不仅限于继承了父类E的子类, 也可以代指显现了接口E的类
3. 固定下边界的通配符(Lower Bounded Wildcards),采用<? super E>的形式
使用固定下边界的通配符的泛型, 就能够接受指定类及其父类类型的数据.。
要声明使用该类通配符, 采用<? super E>的形式, 这里的E就是该泛型的下边界.。
注意: 你可以为一个泛型指定上边界或下边界, 但是不能同时指定上下边界。
<? extends T>与<? super T> 对比
(1)对于<? extends 类型>,编译器将只允许读操作,不允许写操作。即只可以取值,不可以设值。 (2)对于<? super 类型>,编译器将只允许写操作,不允许读操作。即只可以设值(比如 set 操作),不可以取值(比如 get 操作)。
- 以上两点都是针对于源码里涉及到了类型参数的方法而言的。比如对于 List 而言,不允许的写操作有 add 方法,因为它的方法签名是
boolean add(E e);,此时这个形参 E 就变成了一个涉及了通配符的类型参数; - 而不允许的读操作有 get 方法,因为它的方法签名是
E get(int index);,此时这个返回值 E 就变成了一个涉及了通配符的类型参数。
作为方法形参,<? extends T> 类型和 <? super T> 类型的区别在于:
- <? extends T> 允许调用读方法
T get()获取 T 的引用,但不允许调用写方法set(T)传入 T 的引用(传入 null 除外)。- <? super T> 允许调用写方法
set(T)传入 T 的引用,但不允许调用读方法 Tget()获取 T 的引用(获取 Object 除外)
记住上面的结论,我们来看 Java 标准库的 Collections 类定义的 copy() 方法。
(1)copy() 方法的作用是把一个 List 中的每个元素依次添加到另一个 List 中。它的第一个形参是 List<? super T>,表示
目标 List,第二个形参是 List<? extends T>,表示源 List。
代码如下:
public class Collections {
// 把 src 的每个元素复制到 dest 中:
public static <T> void copy(List<? super T> dest, List<? extends T> src) {
for (int i = 0; i < src.size(); i++) {
// 获取 src 集合中的元素,并赋值给变量 t,其数据类型为 T
T t = src.get(i);
// 将变量 t 添加进 dest 集合中
dest.add(t);// 添加元素进入 dest 集合中
}
}
}- 我们可以简单地用 for 循环实现复制。在 for 循环中,我们可以看到,对于 <? extends T> 集合 src,我们可以安全地获取
类型参数 T的引用(即变量 t),而对于 <? super T> 的集合 dest,我们可以安全地传入类型参数 T的引用。
(2)copy() 方法的定义完美地展示了通配符 extends 和 super 的意图:
- copy() 方法内部不会读取 dest,因为不能调用 dest.get() 方法来获取 T 的引用(如果调用则编译器会直接报错)。
- copy() 方法内部也不会修改 src,因为不能调用 src.add(T) 方法(如果调用则编译器会直接报错)。
这是由
编译器检查来实现的。如果在方法代码中意外修改了 src 集合,或者意外读取了 dest ,就会导致一个编译错误。
代码如下:
public class Collections {
// 把 src 的每个元素复制到 dest 中:
public static <T> void copy(List<? super T> dest, List<? extends T> src) {
...
// 获取 <? super T> 集合的元素只能赋值给 Object 对象
T t = dest.get(0); // 编译错误
// 不能向 <? extends T> 集合中添加任何类型的对象,除了 null
src.add(t); // 编译错误
}
}- 根据上面介绍的,获取 <? super T> 集合 dest 的元素后只能赋值给 Object 对象,而不能赋值给其下界类型 T;我们不能向 <? extends T> 集合 src 中添加任何类型的对象,除了 null。
(3)copy() 方法的另一个好处是可以安全地把一个 List< Integer >添加到 List< Number >,但是
无法反过来添加。
代码如下:
// 将 List<Integer> 复制到 List<Number>
List<Number> numList = ...;
List<Integer> intList = ...;
Collections.copy(numList, intList);// 编译正确
// 不能将 List<Number> 复制到 List<Integer>
Collections.copy(intList, numList);// 编译错误- 这个很好理解,List< Number > 集合中可能有 Integer、Float 等对象,所以肯定不能复制到List< Integer > 集合中;而 List< Integer > 集合中只有 Integer 对象,因此肯定可以复制到 List< Number > 集合中。
PECS 原则
我们何时使用 extends,何时使用 super 通配符呢?为了便于记忆,我们可以用 PECS 原则:Producer Extends Consumer Super。
即:如果需要返回 T,则它是生产者(Producer),要使用 extends 通配符;如果需要写入 T,则它是消费者(Consumer),要使用 super 通配符。
还是以 Collections 的 copy() 方法为例:
public class Collections {
public static <T> void copy(List<? super T> dest, List<? extends T> src) {
for (int i = 0; i < src.size(); i++) {
T t = src.get(i); // src 是 producer
dest.add(t); // dest 是 consumer
}
}
}- 需要返回 T 的 src 是生产者,因此声明为
List<? extends T>,需要写入 T 的 dest 是消费者,因此声明为List<? super T>。
面试题
1、Java中的泛型是什么 ? 使用泛型的好处是什么?
- 泛型是一种参数化类型的机制。它可以使得代码适用于各种数据类型,从而编写更加通用的代码,例如集合框架。
- 泛型是一种编译时类型确认机制。它提供了代码编译期的类型安全,确保在泛型类型(通常为泛型集合)上只能使用正确类型的对象,避免了在运行时产生
ClassCastException 异常。
2、Java的泛型是如何工作的 ? 什么是类型擦除 ?
- 泛型的正常工作是依赖编译器在编译源码的时候,先进行类型检查,然后进行类型擦除并且在类型参数出现的地方插入强制转换的相关指令实现的。
类型擦除:编译器在编译时擦除了代码中所有与泛型相关的信息,所以在运行时不存在任何泛型信息。例如 List< String > 类在运行时仅用一个 List 类型来表示。而为什么要进行擦除呢?这是为了避免类型膨胀。
3、什么是泛型中的限定通配符和非限定通配符 ?
- 限定通配符对类型参数的范围进行了限制。有两种限定通配符,一种是
<? extends T>,它通过确保泛型类型必须是T 的子类来设定类型参数的上界;另一种是<?super T>,它通过确保泛型类型必须是T 的父类来设定类型参数的下界。 - 泛型类型必须使用
限定范围内的类型来进行初始化,否则会导致编译错误。另一方面<?>表示了非限定通配符,因为 <?> 可以用任意数据类型来替代。
4、List<? extends T> 和 List <? super T> 之间有什么区别 ?
- 这和上一题有联系,有时面试官会用这个问题来评估你对泛型的理解,而不是直接问你什么是限定通配符和非限定通配符。
- 这两个 List 的声明都是限定通配符的例子,List<? extends T> 可以接受任何继承自
T 的类型的 List,而 List<? super T> 可以接受任何T 的父类构成的 List。 - 例如:
List<? extends Number>可以接受 List< Integer > 或 List< Float >;List <? super Number>可以接受 List< Object > 但不能接受 List< Integer >。
5、如何编写一个泛型方法,让它能接受泛型参数并返回泛型类型?
- 编写泛型方法并不困难,你需要用泛型类型来替代原始类型,比如使用 T,E,K,V 等被广泛认可的
类型占位符。泛型方法的例子请参阅 Java 集合类框架,最简单的情况下,一个泛型方法可能会像这样:
public class TestMethod<U> {
public <T, S> T testMethod(T t, S s) {
return null;
}
}6、Java 中如何使用泛型编写带有类型参数的类?
- 这是上一道题的延伸,面试官可能会要求你用泛型编写一个类型安全的类,而不是编写一个泛型方法。关键仍然是使用泛型类型来代替
原始类型,而且要使用 JDK 中采用的类型占位符。举例如下:
public class Generic<T> {
// key 这个成员变量的数据类型为 T, T 的类型由外部传入
private T key;
// 泛型构造方法形参 key 的类型也为 T,T 的类型由外部传入
public Generic(T key) {
this.key = key;
}
// 泛型方法 getKey 的返回值类型为 T,T 的类型由外部指定
public T getKey(){
return key;
}
}7、编写一段泛型程序来实现 LRU 缓存?
- 对于喜欢 Java 编程的人来说这相当于是一次练习。提示,LinkedHashMap 可以用来实现固定大小的 LRU 缓存,当 LRU 缓存已经满了的时候,它会把最老的键值对移出缓存。LinkedHashMap 提供了一个称为 removeEldestEntry() 的方法,该方法会被 put() 和 putAll() 调用来删除最老的键值对。
8、你可以把 List< String > 传递给一个接受 List< Object > 参数的方法吗?
- 对任何一个不太熟悉泛型的人来说,这个Java泛型题目看起来令人疑惑,因为乍看起来 String 是 Object 的子类,所以 List< String > 应当可以
向上转型为 List< Object > 。但是事实并非如此, List< String > 与 List< Object > 之间没有继承关系,真这样做的话会导致编译错误。
List<Object> objectList;
List<String> stringList;
objectList = stringList;// 编译错误9、Array 中可以用泛型吗?
- 这可能是 Java 泛型面试题中最简单的一个了,当然前提是你要知道 Array 事实上并不支持泛型,这也是为什么《 Effective Java》 一书中建议使用 List 来代替 Array,因为 List 可以提供编译期的
类型安全保证,而 Array 却不能。
10、Java 中 List< Object > 和原始类型 List 之间的区别?
- 原始类型和 < Object > 之间的主要区别是,在编译时编译器不会对原始类型进行类型安全检查,却会对泛型类型 < Object > 进行检查。< Object > 通过使用 Object 作为类型参数,可以告知编译器可以接收任何数据类型的对象,比如 String 或 Integer。 这道题的考察点在于对泛型中
原始类型的正确理解。 - 它们之间的第二点区别是,你可以把
任何泛型类型传递给接收原始类型 List 的方法,但却不能把 List< String > 传递给 List< Object > 的方法,因为会产生编译错误。举例如下:
public class Test {
public static void main(String[] args) {
// 创建一个 ArrayList<String> 集合
List<String> list = new ArrayList();
fillNumList(list);// 编译正确
fillObjList(list);// 编译错误
}
public static void fillList(List list) {
...
}
public static void fillObjList(List<Object> list) {
...
}
}11、Java 中 List<?> 和 List< Object > 之间的区别是什么?
- 这道题跟上一道题看起来很像,实质上却完全不同。List<?> 是一个不确定的未知类型的 List,而 List< Object > 是一个确定的 Object 类型的 List。
- List<?> 在逻辑上是所有 List< T > 的父类,你可以把 List< String >、 List< Integer > 等集合赋值给 List<?> 的引用;而 List< Object > 只代表了自己这个泛型集合类,只能把 List< Object > 赋值给 List< Object > 的引用,但是 List< Object > 集合中可以加入任意类型的数据,因为 Object 类是
最高父类。 举例如下:
List<?> listOfAnyType;
List<Object> listOfObject = new ArrayList<Object>();
List<String> listOfString = new ArrayList<String>();
List<Integer> listOfInteger = new ArrayList<Integer>();
listOfAnyType = listOfString;// 编译正确
listOfAnyType = listOfInteger;// 编译正确
listOfObjectType = listOfString;// 编译错误12、Java 中 List< String > 和原始类型 List 之间的区别。
- 该题类似于“List< Object > 和原始类型 List 之间的区别”。泛型数据类型是
类型安全的,而且其类型安全是由编译器保证的,但原始类型 List 却不是类型安全的。你不能把 String 之外的任何其它类型的对象存入 List< String > 中,而你可以把任何类型的对象存入原始 List 中。 - 使用泛型数据类型你不需要进行
类型转换,但是对于原始类型,你则需要进行显式的类型转换。举例如下:
List listOfRawTypes = new ArrayList();
listOfRawTypes.add("abc");
listOfRawTypes.add(123);
String item = (String) listOfRawTypes.get(0);// 获取元素时需要显式的类型转换
// 编译器不报错,但运行时会产生 ClassCastException异常,因为 Integer不能被转换为 String
item = (String) listOfRawTypes.get(1);
List<String> listOfString = new ArrayList();
listOfString.add("abcd");
listOfString.add(1234);// 编译器直接报错
item = listOfString.get(0); // 不需要显式的类型转换,编译器会自动转换糖块三、自动装箱与拆箱
自动装箱就是Java自动将原始类型值转换成对应的对象,比如将int的变量转换成Integer对象,这个过程叫做装箱,反之将Integer对象转换成int类型值,这个过程叫做拆箱。
因为这里的装箱和拆箱是自动进行的非人为转换,所以就称作为自动装箱和拆箱。
原始类型byte, short, char, int, long, float, double 和 boolean
对应的封装类为Byte, Short, Character, Integer, Long, Float, Double, Boolean。
先来看个自动装箱的代码:
public static void main(String[] args) {
int i = 10;
Integer n = i;
}反编译后代码如下:
public static void main(String args[]) {
int i = 10;
Integer n = Integer.valueOf(i);
}再来看个自动拆箱的代码:
public static void main(String[] args) {
Integer i = 10;
int n = i;
}反编译后代码如下:
public static void main(String args[]) {
Integer i = Integer.valueOf(10);
int n = i.intValue();
}从反编译得到内容可以看出,在装箱的时候自动调用的是Integer的valueOf(int)方法。而在拆箱的时候自动调用的是Integer的intValue方法。
所以,装箱过程是通过调用包装器的valueOf方法实现的,而拆箱过程是通过调用包装器的 xxxValue方法实现的。
糖块四 、方法变长参数
可变参数(variable arguments)是在Java 1.5中引入的一个特性。它允许一个方法把任意数量的值作为参数。
看下以下可变参数代码,其中print方法接收可变参数:
public static void main(String[] args) {
//打印方法的多参数
print("CSDN-ThinkWon", "简书-JourWon", "博客:https://blog.csdn.net/ThinkWon");
}
public static void print(String... strs) {
for (int i = 0; i < strs.length; i++) {
System.out.println(strs[i]);
}
}反编译后代码:
public static void main(String[] args) {
//本质是创建一个数组
print(new String[]{"CSDN-ThinkWon", "\u7b80\u4e66-JourWon", "\u535a\u5ba2:https://blog.csdn.net/ThinkWon"});
}
public static void print(String[] strs) {
for (int i = 0; i < strs.length; i++)
System.out.println(strs[i]);
}从反编译后代码可以看出,可变参数在被使用的时候,他首先会创建一个数组,数组的长度就是调用该方法时传递实参的个数,然后再把参数值全部放到这个数组当中,再把这个数组作为参数传递到被调用的方法中。
糖块五 、枚举
Java SE5提供了一种新的类型-Java的枚举类型,关键字enum可以将一组具名的值的有限集合创建为一种新的类型,而这些具名的值可以作为常规的程序组件使用,这是一种非常有用的功能。参考:Java的枚举类型用法介绍
要想看源码,首先得有一个类吧,那么枚举类型到底是什么类呢?是enum吗?
答案很明显不是,enum就和class一样,只是一个关键字,他并不是一个类。
那么枚举是由什么类维护的呢,我们简单的写一个枚举:
public enum T {
SPRING,SUMMER;
}然后我们使用反编译,看看这段代码到底是怎么实现的,反编译后代码内容如下:
public final class T extends Enum<T> {
public static final /* enum */ T SPRING = new T("SPRING", 0);
public static final /* enum */ T SUMMER = new T("SUMMER", 1);
private static final /* synthetic */ T[] $VALUES;
public static T[] values() {
return (T[])$VALUES.clone();
}
public static T valueOf(String name) {
return Enum.valueOf(T.class, name);
}
private T(String string, int n) {
super(string, n);
}
static {
$VALUES = new T[]{SPRING, SUMMER};
}
}通过反编译后代码我们可以看到,public final class T extends Enum,说明,该类是继承了Enum类的,同时final关键字告诉我们,这个类也是不能被继承的。
*****当我们使用enmu来定义一个枚举类型的时候,编译器会自动帮我们创建一个final类型的类继承Enum类,所以枚举类型不能被继承。
糖块六 、内部类
内部类又称为嵌套类,可以把内部类理解为外部类的一个普通成员。
内部类之所以也是语法糖,是因为它仅仅是一个编译时的概念。
outer.java里面定义了一个内部类inner,一旦编译成功,就会生成两个完全不同的.class文件了,分别是outer.class和outer$inner.class。所以内部类的名字完全可以和它的外部类名字相同。
public class OutterClass {
private String userName;
public String getUserName() {
return userName;
}
public void setUserName(String userName) {
this.userName = userName;
}
public static void main(String[] args) {
}
class InnerClass {
private String name;
public String getName() {
return name;
}
public void setName(String name) {
this.name = name;
}
}
}糖块七 、条件编译
—般情况下,程序中的每一行代码都要参加编译。但有时候出于对程序代码优化的考虑,希望只对其中一部分内容进行编译,此时就需要在程序中加上条件,让编译器只对满足条件的代码进行编译,将不满足条件的代码舍弃,这就是条件编译。
经典的就是if else语句,符合if就不编译else的内容
所以,Java语法的条件编译,是通过判断条件为常量的if语句实现的。根据if判断条件的真假,编译器直接把分支为false的代码块消除。通过该方式实现的条件编译,必须在方法体内实现,而无法在正整个Java类的结构或者类的属性上进行条件编译。
这与C/C++的条件编译相比,确实更有局限性。在Java语言设计之初并没有引入条件编译的功能,虽有局限,但是总比没有更强。
糖块八 、断言
在Java中,assert关键字是从JAVA SE 1.4 引入的,为了避免和老版本的Java代码中使用了assert关键字导致错误,Java在执行的时候默认是不启动断言检查的(这个时候,所有的断言语句都将忽略)。
如果要开启断言检查,则需要用开关-enableassertions或-ea来开启。
其实断言的底层实现就是if语言,如果断言结果为true,则什么都不做,程序继续执行,如果断言结果为false,则程序抛出AssertError来打断程序的执行。
-enableassertions会设置$assertionsDisabled字段的值。
public class AssertTest {
public static void main(String args[]) {
int a = 1;
int b = 1;
assert a == b;
System.out.println("CSDN-ThinkWon");
assert a != b : "ThinkWon";
System.out.println("博客:https://blog.csdn.net/ThinkWon");
}
}跟idea中手动设置测试红点一样
糖块九 、数值字面量
在java 7中,数值字面量,不管是整数还是浮点数,都允许在数字之间插入任意多个下划线。这些下划线不会对字面量的数值产生影响,目的就是方便阅读。
public class Test {
public static void main(String[] args) {
int i = 10_000;
System.out.println(i);
}
}反编译后就是把删除了_。也就是说编译器并不认识在数字字面量中的_,需要在编译阶段把他去掉。
糖块十 、增强for循环
增强for循环(for-each)相信大家都不陌生,日常开发经常会用到的,他会比for循环要少写很多代码,那么这个语法糖背后是如何实现的呢?
优点:
在Java 5中,引入了一种主要用于数组和集合遍历的增强型for循环,我们可以认为它是普通for循环的增强版,主要是用于处理数组或集合中的元素,而不必指定数组或集合的下标。
缺点:
在很多时候,foreach都可以替代for循环,但并不是所有的时候都能替代for,这是因为foreach循环存在着一些缺陷。
虽然foreach是for循环的增强版,简化了编程,提高了代码的可读性和安全性,避免了数组越界。而foreach一般是结合泛型使用,在需要使用数组或者集合索引时,foreach就不好用了。
public static void main(String args[]) {
String[] strs = {"CSDN-ThinkWon", "简书-JourWon", "博客:https://blog.csdn.net/ThinkWon"};
for (String s : strs) {
System.out.println(s);
}
System.out.println();
List<String> strList = Arrays.asList(strs);
//for(数据类型 变量名 : 遍历的集合名称)
for (String s : strList) {
System.out.println(s);
}
}反编译后代码如下:
public static void main(String args[]) {
String[] strs;
String[] arrstring = strs = new String[]{"CSDN-ThinkWon", "\u7b80\u4e66-JourWon", "\u535a\u5ba2:https://blog.csdn.net/ThinkWon"};
int n = arrstring.length;
for (int i = 0; i < n; ++i) {
String s = arrstring[i];
System.out.println(s);
}
System.out.println();
List<String> strList = Arrays.asList(strs);
Iterator<String> iterator = strList.iterator();
while (iterator.hasNext()) {
String s = iterator.next();
System.out.println(s);
}
}代码很简单,for-each的实现原理其实就是使用了普通的for循环和迭代器。
糖块十一 、try-with-resource语句
Java里,对于文件操作IO流、数据库连接等开销非常昂贵的资源,用完之后必须及时通过close方法将其关闭,否则资源会一直处于打开状态,可能会导致内存泄露等问题。
关闭资源的常用方式就是在finally块里释放,即调用close方法。比如,我们经常会写这样的代码:
从Java 7开始,jdk提供了一种更好的方式关闭资源,使用try-with-resources语句,改写一下上面的代码,效果如下:
public static void main(String args[]) {
try (BufferedReader br = new BufferedReader(new FileReader("d:\\ hello.xml"))) {
String line;
while ((line = br.readLine()) != null) {
System.out.println(line);
}
} catch (IOException e) {
// handle exception
}
}糖块十二、Lambda表达式
关于Labmda表达式,有人可能会有质疑,因为网上有人说他并不是语法糖。其实我想纠正下这个说法。
Labmda表达式不是匿名内部类的语法糖,但是他也是一个语法糖。实现方式其实是依赖了几个JVM底层提供的Labmda相关api。
先来看一个简单的Labmda表达式。遍历一个list:
public static void main(String[] args) {
List<String> strList = new ArrayList<>();
strList.add("CSDN-ThinkWon");
strList.add("简书-JourWon");
strList.add("博客:https://blog.csdn.net/ThinkWon");
strList.forEach(s -> System.out.println(s));
}1.背景
Lambda表达式是Java SE 8中一个重要的新特性。lambda表达式允许你通过表达式来代替功能接口。 lambda表达式就和方法一样,它提供了一个正常的参数列表和一个使用这些参数的主体(body,可以是一个表达式或一个代码块)。 Lambda 表达式(Lambda expression)可以看作是一个匿名函数,基于数学中的λ演算得名,也可称为闭包(Closure)
2.Lambda表达式的语法
基本语法: (parameters) -> expression 或 (parameters) ->{ statements; }
Lambda表达式由三部分组成:
- paramaters:类似方法中的形参列表,这里的参数是函数式接口里的参数。这里的参数类型可以明确的声明也可不声明而由JVM隐含的推断。另外当只有一个推断类型时可以省略掉圆括号。
- ->:可理解为“被用于”的意思
- 方法体:可以是表达式也可以代码块,是函数式接口里方法的实现。代码块可返回一个值或者什么都不反回,这里的代码块块等同于方法的方法体。如果是表达式,也可以返回一个值或者什么都不反回。
Lambda本质可以对某些匿名内部类的写法进行简化,Lambda表达式只支持函数式接口。也就是只有一个抽象方法的接口。因此,可以对某些匿名内部类进行简化的条件是:
1.是一个接口的匿名内部类
2.这个接口中只有一个抽象方法。
当满足这两个条件,就可以使用Lambda对这个匿名内部类进行简化。
Lambda表达式是一种匿名函数,它可以简化对于单一方法接口(Single Abstract Method,SAM)的实现。
2.1 案例一
匿名内部类实现线程中的Runnable接口
public class Lambda_test01 {
public static void main(String[] args) {
new Thread(new Runnable() {
//实现runnable接口
@Override
public void run() {
System.out.println("匿名Run线程启动");
}
}).start();
}
}
public class Lambda_test01 {
public static void main(String[] args) {
new Thread(run()->{
System.out.println("匿名Run线程启动");
}).start();
}
}使用Lambda表达式
public class Lambda_test01 {
public static void main(String[] args) {
//实现runnable接口
new Thread(() -> System.out.println("匿名Run线程启动")).start();
}
}2.2 案例二
匿名内部类的写法
public class LambdaTest {
public static void main(String[] args) {
//对printNum()方法进行调用
LambdaTest.printNum(new IntPredicate() { //对接口的实现
@Override
public boolean test(int value) {
return value%2==0;
}
});
}
//自定义一个printNum()方法
public static void printNum(IntPredicate predicate){
int[] arr={1,2,3,4,5,6,7,8,9,10};
for (int i:arr){
if(predicate.test(i)){
System.out.println(i);
}
}
}
}采用Lambda表达式的
public class LambdaTest {
public static void main(String[] args) {
LambdaTest.printNum((int value)-> {
return value%2==0;
});
}
public static void printNum(IntPredicate predicate){
int[] arr={1,2,3,4,5,6,7,8,9,10};
for (int i:arr){
if(predicate.test(i)){
System.out.println(i);
}
}
}
}2.4 省略规则
1.参数类型可以省略
2.方法体只有一句代码时大括号{ }、return关键字和唯一语句代码的分号可以省略
3.方法只有一个参数时小括号可以省略
(以上这些规则都记不住也可以省略不记,在idea工具中在匿名内部类的方法名上按alt+enter可以转化为lambda表达式,反之可以再转换成匿名内部类)
总结:
在写lamdba表达式要关注条件是:
1.是一个接口的匿名内部类
2.这个接口中只有一个抽象方法。
当满足这两个条件,就可以使用Lambda对这个匿名内部类进行简化
书写时关注的条件是:
1.方法体参数(返回类型,变量名)
2.代码体
eg.
Javanew Thread(new Runnable() { //实现runnable接口 @Override public void run() { System.out.println("匿名Run线程启动"); } }).start(); /*这个匿名内部类的方法中: 返回值类型:void 参数名是null, 代码为sout(“...”),以及start()方法 */ //简化结果 new Thread(ru() ->System.out.println("匿名Run线程启动") .start();) //在书写代码时不需要时时关注类名的意义重点: 在idea中。可以先写匿名内部类,再在匿名内部类的方法名上按alt+enter可以转化成最简代码
3.方法引用
我们在使用lambda时,如果方法体中只有一个方法的调用的话(包括构造方法),我们可以用方法引用进一步简化代码。
3.1 推荐用法
我们在使用lambda时不需要考虑什么时候用方法引用,用哪种方法引用,方法引用的格式是什么。我们只需要在写完lambda方法发现方法体只有一行代码,并且是方法的调用时使用快捷键尝试是否能够转换成方法引用即可。 当我们方法引用使用的多了慢慢的也可以直接写出方法引用。
3.2基本格式
类名或者对象名 :: 方法名
3.3 语法详解(了解)
3.3.1引用类的静态方法
**格式:**类名::方法名
使用前提: 如果我们在重写方法的时候,方法体中只有一行代码,并且这行代码是调用了某个类的静态方法,并且我们把要重写的抽象方法中所有的参数都按照顺序传入了这个静态方法中,这个时候我们就可以引用类的静态方法。
eg.
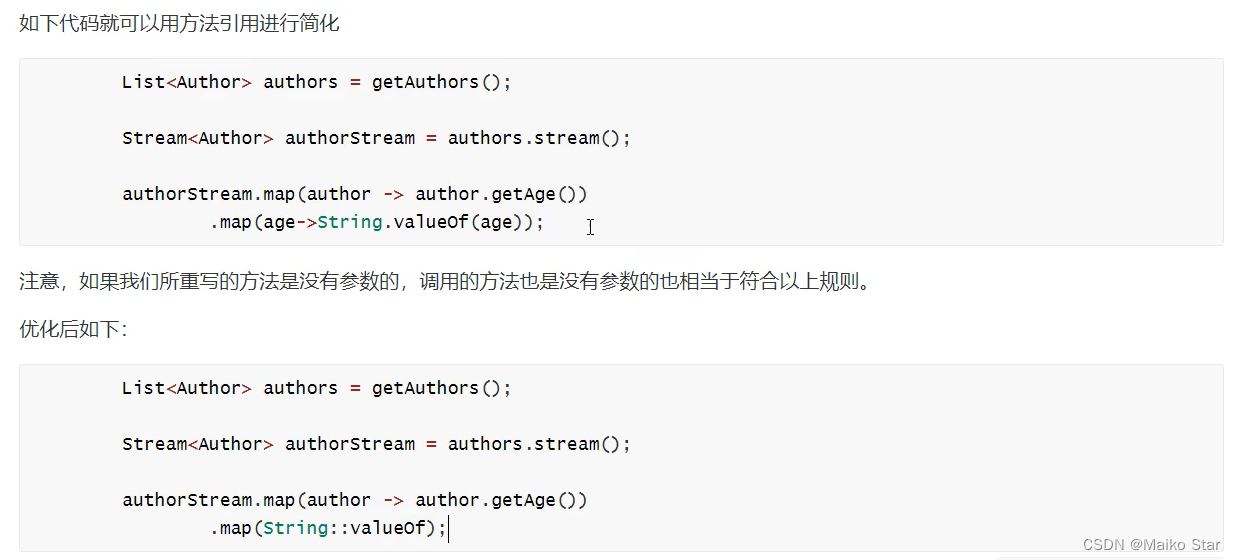
//原代码为输入Interger类型的age转换成String类型的age
//这个匿名内部类符合使用前提,所以我们只要关注调用的类名String及方法名valueOf()
new Function<Interger,String>{
@Override
public String apply(Interger age){
retrun String.valueOf(age);
}
}
//改写成
String::valueOf3.3.2引用对象的实例方法
格式: 对象名::方法名
使用前提: 如果我们在重写方法的时候,方法体中只有一行代码,并且这行代码是调用了某个对象的成员方法,并且我们把要重写的抽象方法中所有的参数都按照顺序传入了这个成员方法中,这个时候我们就可以引用对象的实例方法
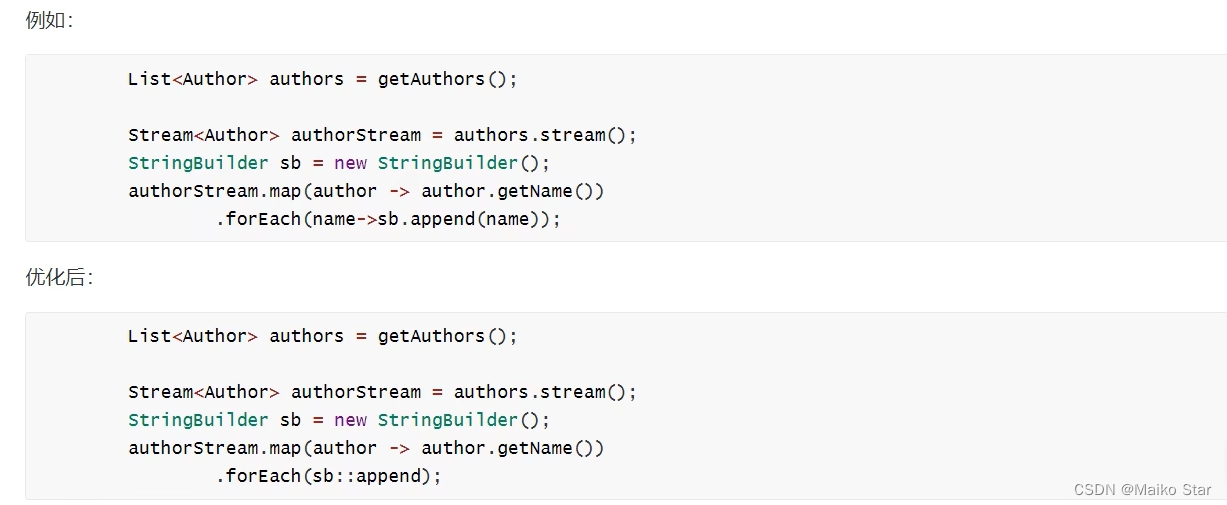
3.3.3引用类的实例方法
格式:类名::方法名
使用前提: 如果我们在重写方法的时候,方法体中只有一行代码,并且这行代码是调用了第一个参数的成员方法,并且我们把要重写的抽象方法中剩余的所有的参数都按照顺序传入了这个成员方法中,这个时候我们就可以引用类的实例方法。
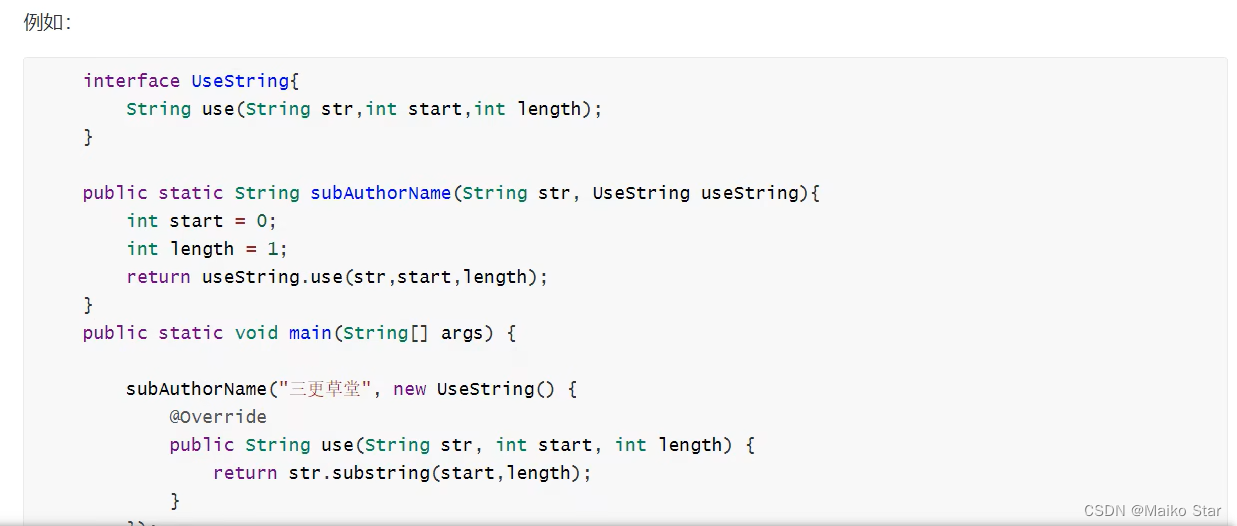
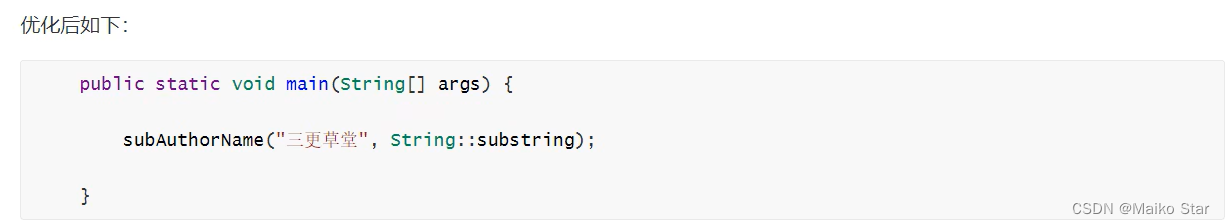
3.3.4 构造器引用
如果方法体中的一行代码是构造器的话就可以使用构造器引用。
格式: 类名::new
使用前提: 如果我们在重写方法的时候,方法体中只有一行代码,并且这行代码是调用了某个类的构造方法,并且我们把要重写的抽象方法中的所有的参数都按照顺序传入了这个构造方法中,这个时候我们就可以引用构造器。
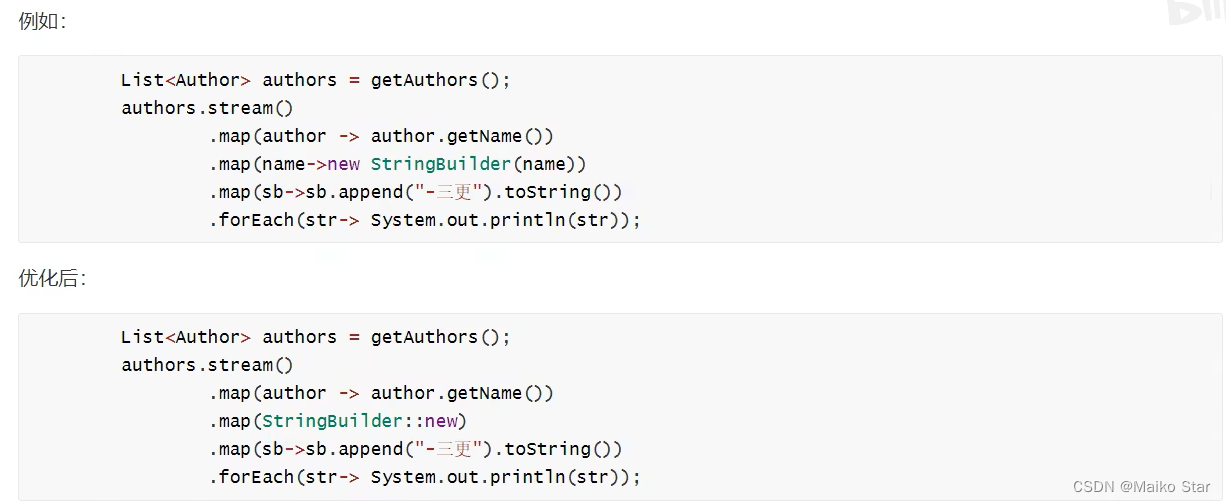
4.Stream流-函数式编程(对集合和数组操作)
4.1 概述
流是Java 8 API添加的一个新的抽象,称为流Stream,以一种声明性方式处理数据集合(侧重对于源数据计算能力的封装,并且支持序列与并行两种操作方式)
Stream流是从支持数据处理操作的源生成的元素序列,源可以是数组、文件、集合、函数。流不是集合元素,它不是数据结构并不保存数据,它的主要目的在于计算
Stream流是对集合(Collection)对象功能的增强,它可以被用来对集合或数组进行链状流式的操作。与Lambda表达式结合,可以提高编程效率、间接性和程序可读性。
Stream流就是对数组和集合的一些操作,相对于在后端进行sql语句。步骤如下:
1.创建对应的流
2.中间操作(调用一些函数)
3.结束操作(相对于结束符,这样Stream才开始启动)
4.2 创建流
(1)单列集合:集合对象.stream()
List<String> list = Arrays.asList("apple", "banana", "orange");
Stream<String> stream = list.stream();
合并操作
Stream<String> stream = Arrays.asList("apple", "banana", "orange").steam();(2)数组:Arrays .stream(数组)或者使用Stream.of 来创建
Integer[] arr = {1,2,3,5};
Stream<Integer> stream = Arrays.stream(arr);
stream.forEach(integer -> System.out.println(integer));
Stream<Integer> arr1 = Stream.of(arr);
arr1.forEach(integer -> System.out.println(integer));(3) 双列集合:转换成单列集合entryset()方法,后再创建
Map<String, Integer> map = new HashMap<>();
map.put("蜡笔小新",19);
map.put("黑子",17);
map.put("日向翔阳",16);
Stream<Map.Entry<String,Integer>> stream = map.entryset().stream() ;
stream.forEach(new Consumer<Map.Entry<String, Integer>>() {
@Override
public void accept(Map.Entry<String, Integer> stringIntegerEntry) {
System.out.println(stringIntegerEntry.getValue());
}
});
// stream.forEach(stringIntegerEntry -> System.out.println(stringIntegerEntry.getValue()));Map的entrySet() 方法返回一个实现Map.Entry接口的对象集合。集合中每个对象都是底层Map中一个特定的键/值对。一般情况下,要输出Map中的key 和 value 是先得到key的集合keySet(),然后再迭代(循环)由每个key得到每个value。values()方法是获取集合中的所有值,不包含键,没有对应关系。而Entry可以一次性获得这两个值。Map.Entry中的常用方法如下所示:
- Object getKey(): 返回条目的关键字
- Object getValue(): 返回条目的值
- Object setValue(Object value): 将相关映像中的值改为value,并且返回旧值
分析源码:
//是Map.Entry接口的对象集合
Set<Map.Entry<K, V>> entrySet();
//Entry接口中的方法有
interface Entry<K,V> {
K getKey();//获取键
V getValue();//获取值
V setValue(V value);//获取旧值
//以及boolean equals(Object o), int hashCode();等方法
}4.3 操作符
流的操作类型主要分为两种:中间操作符、终端操作符
一个java 8的stream是由三部分组成的。
- 数据源,
- 零个或一个或多个中间操作,
- 一个或零个终止操作。
中间操作是对数据的加工,
- 注意,中间操作是lazy操作,并不会立马启动,需要等待终止操作才会执行。
终止操作是stream的启动操作,
- 只有加上终止操作,stream才会真正的开始执行。
4.4 中间操作符(可以存在多个方法)
| 流方法 | 含义 |
|---|---|
| filter | 用于通过设置的条件过滤出元素 |
| map | 接受一个函数作为参数。这个函数会被应用到每个元素上,并将其映射成一个新的元素(使用映射一词,是因为它和转换类似,但其中的细微差别在于它是“创建一个新版本”而不是去“修改”) |
| distinct | 返回一个元素各异(根据流所生成元素的hashCode和equals方法实现)的流 |
| sorted | 返回排序后的流 |
| limit | 会返回一个不超过给定长度的流 |
| skip | 返回一个扔掉了前n个元素的流 |
| flatMap | 使用flatMap方法的效果是,各个数组并不是分别映射成一个流,而是映射成流的内容。所有使用map(Arrays::stream)时生成的单个流都被合并起来,即扁平化为一个流 |
| peek | 对元素进行遍历处理 |
(1)filter
可以对流中的元素进行条件过滤,符合过滤条件的才能继续留在流中。
源码分析:
//接口为Predicate的对象方法
Stream<T> filter(Predicate<? super T> predicate);
//重写Predicate方法,返回的是一个boolean类型
new Predicate<T>() {
@Override
public boolean test(T t) {
return false;
}
}eg.
1.设置String类型的数组
2.添加两个字符串
3.把数组(strings)转换成Stream流,并调用fileter方法
4.重写Predicate方法,返回值判断字符的长度是否大于2
List<String> strings=new ArrayList<>();
strings.add("abcde");
strings.add("ac");
strings.stream().filter(new Predicate<String>() {
@Override
public boolean test(String s) {
//重写方法中把String 类型名称设置为s,外部Strings数组传到重写的Predicate方法中再传到s中,再调用length方法判断是否大于2
return s.length()>2;
}
});
//strings.stream().filter(s -> s.length() > 2);注:因为这里还没有加上流的终结操作,所以实际上是不会生效的(下同),终结操作后面会讲到
(2)map
可以把对流中的元素进行计算或转换。
源代码分析
//接口有apply方法,Function(传入类型,转换类型)
public interface Function<T, R> {
R apply(T t);
}
//重写apply方法
.map(new Function<Author, Object>() {
@Override
//public 转换类型 apply(传入类型)
public Object apply(Author author) {
return null;
}
})Function里第一个泛型参数和集合元素类型是一样的,第二个是要转换成的目标类型。上面一段代码将Author集合转成了只包含Name的String集合。
eg.
1.把静态方法getAuthors()中数据传入数组
2.把数组转化成Stream流
3.使用map方法,把数组的数据转换成String类型并返回
//使用自定义的引用类型Author,静态方法为getAuthors()
List<Author> authors = getAuthors();
authors.stream()
//使用map接口中的Function(传入参数,转换参数)
//这个源码使用了
.map(new Function<Author, String>() {
@Override
public String apply(Author author) {
return author.getName();
}
})
//authors.stream().map(author -> author.getName());(3)distinct
可以去除流中的重复元素,静态方法
注意: distinct方法是依赖object的equals方法来判断是否是相同对象的。所以需要注意重写equals方法。
源码分析:
//distinct方法是依赖Object的equals方法来判断是否是相同对象的。所以需要注意重写equals方法。eg.
1.把静态方法getAuthors()中数据传入数组
2.把数组转化成Stream流
3.使用distinct方法,把数组的数据对比去重
public class StreamDemo_01 {
public static void main(String[] args) {
List<Author> authors = getAuthors();
authors.stream()
.distinct();
}(4)sorted
可以对流中的元素进行排序,(默认升序)
注意:如果调用空参的sorted()方法,需要流中的元素是实现了Comparable。
源码分析:
//1.空参
Stream<T> sorted();
//2.传入接口类型
Stream<T> sorted(Comparator<? super T> comparator);
//2.1接口方法为copare方法
int compare(T o1, T o2);eg1.
@Data
@NoArgsConstructor
@AllArgsConstructor
@EqualsAndHashCode//用于后期的去重使用
//使用空参sorted方法时,要实现对应排序类型的实体类,对应Comparable中compareTo方法
public class Author implements Comparable<Author> {
//id
private Long id;
//姓名
private String name;
//年龄
private Integer age;
//简介
private String intro;
//作品
private List<Book>books;
@Override
public int compareTo(Author o) {
return this.getAge()-o.getAge();
}
} List<Author> authors = getAuthors();
authors.stream()
.distinct()
.sorted()
.forEach(new Consumer<Author>() {
@Override
public void accept(Author author) {
System.out.println(author.getName());
}
});如果调用空参的sorted()方法,需要流中的元素是实现了Comparable接口,否则会抛出java.lang.ClassCastException异常。
eg2.
1.把静态方法getAuthors()中数据传入数组
2.把数组转化成Stream流
3.使用sorted方法,把数组的数据的差值去排序
4.使用foreach方法打印
List<Author> authors = getAuthors();
authors.stream()
.distinct()
.sorted(new Comparator<Author>() {
@Override
public int compare(Author o1, Author o2) {
return o1.getAge()-o2.getAge();
}
})
.forEach(new Consumer<Author>() {
@Override
public void accept(Author author) {
System.out.println(author.getName());
}
});
//lambda表达式
List<Author> authors = getAuthors();
authors.stream()
.distinct()
.sorted((o1, o2) -> o1.getAge()-o2.getAge())
.forEach(author -> System.out.println(author.getName()));(5)limit
可以设置流的最大长度,超出的部分将被抛弃。
源码分析:
Stream<T> limit(long maxSize);//调用方法eg.
1.把静态方法getAuthors()中数据传入数组
2.把数组转化成Stream流
3.使用distinct方法,把数组的数据对比去重
4.使用sorted方法,把数组的数据的差值去排序
5.使用foreach方法打印
authors.stream()
.distinct()
.sorted((o1, o2) -> o1.getAge()-o2.getAge())
.limit(2)
.forEach(author -> System.out.println(author.getName()));
(6)skip
跳过流中的前n个元素,返回剩下的元素(跟排序时使用)
源码分析:
Stream<T> skip(long n);//调用方法eg.
authors.stream()
.distinct()
.sorted((o1, o2) -> o1.getAge()-o2.getAge())
.limit(2)
.skip(2)
.forEach(author -> System.out.println(author.getName()));(7)flatMap
map只能把一个对象转换成另一个对象来作为流中的元素。而flatMap可以把一个对象转换成多个对象作为流中的元素。(简而言之,可以直接将List对象中的指定对象元素转换为流对象来单独使用)
*map将流中的每个元素都映射为一个新的元素;flatmap将流中的每个元素转换为一个流,然后将这些流合并成一个新的流。*
源码分析:
//接口方法为Function而且是继承Stream流的
<R> Stream<R> flatMap(Function<? super T, ? extends Stream<? extends R>> mapper);eg.
//把List集合引用类型Author转换成指定类型String
.flatMap(new Function<Author, Stream<String>>() {
@Override
//重写apply方法,传入List集合,名称为author
public Stream<String> apply(Author author) {
//转换成List集合的book名称并转换成Stream流,一定要转换成流,否则报类型异常
return author.getBook().Stream;
}
})
//简写成lambad式子,只关注重写方法里面的参数名称和方法体中一个方法
.flatMap(author->author.getBook().Stream)4.5 终结操作符(只能存在一个方法)
| 流方法 | 含义 |
|---|---|
| collect | 收集器,将流转换为其他形式 |
| forEach | 遍历流 |
| findFirst | 返回第一个元素 |
| findAny | 将返回当前流中的任意元素 |
| count | 返回流中元素总数 |
| sum | 求和 |
| max | 最大值 |
| min | 最小值 |
| anyMatch | 检查是否至少匹配一个元素,返回boolean |
| allMatch | 检查是否匹配所有元素,返回boolean |
| noneMatch | 检查是否没有匹配所有元素,返回boolean |
| reduce | 可以将流中元素反复结合起来,得到一个值 |
(1)forEach
对流中的元素进行遍历操作,我们通过传入的参数去指定对遍历到的元素进行什么具体操作。
源码分析:
//forEach接口里面有comsumer接口
void forEach(Consumer<? super T> action);
//Consumer接口方法
public interface Consumer<T> {
void accept(T t);
default Consumer<T> andThen(Consumer<? super T> after) {
Objects.requireNonNull(after);
return (T t) -> { accept(t); after.accept(t); };
}
}
//重写accpet方法
.forEach(new Consumer<T>() {
@Override
public void accept(T t) {
//方法体一般是打印语句
}
});
eg.
.forEach(new Consumer<Book>() {
@Override
public void accept(Book book) {
System.out.println(book.getName());
}
});
//lambda表达式
//重写方法中参数名称book
//方法体
.forEach(book->System.out.println(book.getName()));(2)count
可以用来获取当前流中元素的个数。
源码分析:
long count();//直接调用的方法,而且无参eg.
.count()(3)max&min
可以用来查找流中的最值。
源码分析:
//两个方法都是以接口comparator为主
Optional<T> max(Comparator<? super T> comparator);
Optional<T> min(Comparator<? super T> comparator);
//内部实现了compare方法,注意要重写equals方法
public interface Comparator<T> {
int compare(T o1, T o2);
boolean equals(Object obj);
}eg.
List<Author> authors = getAuthors();
//min传出来的类型是Optional类型,需要使用Optional的方法
Optional<Author> min = authors.stream()
.min(new Comparator<Author>() {
@Override
public int compare(Author o1, Author o2) {
return o1.getAge() - o1.getAge();
}
});
System.out.println(min.get());
//简化代码
List<Author> authors = getAuthors();
Optional<Author> min = authors.stream()
.min((o1, o2) -> o1.getAge() - o1.getAge());
System.out.println(min.get());(4)collect
把当前流转换成一个集合。
源码分析:
//collect是一个比较复杂的接口,方便使用设计了一个Collectors工具类,内部有很多方法
.collect(Collectors.方法名)
//经典的为
Collectors.toList()获取List集合。
Collectors.toSet()获取Set集合
Collectors.toMap()获取一个Map集合,map的key为o1,value为o2eg.例子:获取一个存放所有作者名字的List集合。
List<Author> authors = getAuthors();
List<String> nameList = authors.stream()
.map(author -> author.getName())
.collect(Collectors.toList());
System.out.println(nameList);eg.例子:获取一个所有书名的Set集合。
List<Author> authors = getAuthors();
Set<Book> bookSet = authors.stream()
.flatMap(author -> author.getBooks().stream())
.collect(Collectors.toSet());
System.out.println(bookSet);eg.例子:获取一个Map集合,map的key为作者名,value为List<Book>
1.把静态方法getAuthors()中数据传入数组
2.把数组转化成Stream流
3.使用distinct方法,把数组的数据去重
4.使用collect中的Collectors中toMap接口
4.1toMap类似于map接口。内部有Function(传入数据,转换数据)方法。
4.2由于map是键-值的方式,所以还要写一个Function方法,转换成值
//1.
List<Author> authors = getAuthors();
//2.
Map<String, List<Book>> map = authors.stream()
//3.
.distinct()
//4.
.collect(Collectors.toMap(new Function<Author, String>() {
//4.1传入Author数据,转换成getName为key
@Override
public String apply(Author author) {
return author.getName();
}
}
//4.24.1传入Author数据,转换成getBooks为value
, new Function<Author, List<Book>>() {
@Override
public List<Book> apply(Author author) {
return author.getBooks();
}
}));
//把转换成的map数据命名为map并打印
System.out.println(map);
//lambda表达式
.collect(Collectors.toMap(author -> author.getName(), author -> author.getBooks()))(5)匹配-anyMatch
可以用来判断是否有任意符合匹配条件的元素,结果为boolean类型。
源码分析:
//布尔类型的方法,参数为Predicate接口方法。
boolean anyMatch(Predicate<? super T> predicate);
//Predicate接口方法
public interface Predicate<T> {
boolean test(T t);
...//xxxMatch方法不同之处
}
//重写test方法
.anyMatch(new Predicate<T>() {
@Override
public boolean test(T t) {
return false;
}
})eg.例子:判断是否有年龄在29以上的作家
List<Author> authors = getAuthors();
authors.stream()
.anyMatch(new Predicate<Author>() {
@Override
public boolean test(Author author) {
return author.getAge()>29;
}
});
//简写lambda
.anyMatch(author -> author.getAge()>29);(6)匹配-allMatch
可以用来判断是否都符合匹配条件,结果为boolean类型。如果都符合结果为true,否则结果为false。
源码分析:同anyMatch
//布尔类型的方法,参数为Predicate接口方法。
boolean allMatch(Predicate<? super T> predicate);
//Predicate接口方法
public interface Predicate<T> {
boolean test(T t);
...
}
//重写test方法
.anyMatch(new Predicate<T>() {
@Override
public boolean test(T t) {
return false;
}
})eg.
//例子:判断是否所有的作家都是成年人
List<Author> authors = getAuthors();
boolean b = authors.stream()
.allMatch(new Predicate<Author>() {
@Override
public boolean test(Author author) {
return author.getAge() >=18;
}
});
System.out.println(b);
//简化lambda表达式
.allMatch(author -> author.getAge() >=18);(7)匹配-noneMatch
可以判断流中的元素是否都不符合匹配条件。如果都不符合结果为true,否则结果为false
源码分析:
//同anyMath和allMath的源码eg.
//例子:判断作家是否都没有超过100岁的。
List<Author> authors = getAuthors();
boolean b = authors.stream()
.noneMatch(new Predicate<Author>() {
@Override
public boolean test(Author author) {
return author.getAge() > 100;
}
});
System.out.println(b);
//简写lambda表达式
.noneMatch(author->author.getAge()>100)(8)查找-findAny
获取流中的任意一个元素。该方法没有办法保证获取的一定是流中的第一个元素。
源码分析:
//同max和min方法中数据类型为Optional,参数为空参
Optional<T> findAny();
//所以调用该方法后要返回Optional类型的参数,再调用Optional类型的方法
eg.
1.把静态方法getAuthors()中数据传入数组
2.把数组转化成Stream流
3.使用filter方法,把数组的数据过滤
4.使用findAny方法转换成Optional类型,并命名为optionalAuthor
5.使用Optional类型方法中的ifPresent方法并重写Consumer接口中的accept方法,打印出符合的年龄大于18的名字
ifPresent方法源码
Javapublic void ifPresent(Consumer<? super T> consumer) { if (value != null) consumer.accept(value); } public interface Consumer<T> { void accept(T t); ... }
//例子:获取任意一个年龄大于18的作家,如果存在就输出他的名字
List<Author> authors = getAuthors();
Optional<Author> optionalAuthor = authors.stream()
.filter(author -> author.getAge() > 18)
.findAny();
optionalAuthor.ifPresent(new Consumer<Author>() {
@Override
public void accept(Author author) {
System.out.println(author.getName());
}
});(9)查找-findFirst
获取流中的第一个元素。
源码分析:
////同max和min方法中数据类型为Optional,参数为空参
Optional<T> findFirst();
////所以调用该方法后要返回Optional类型的参数,再调用Optional类型的方法eg.
//例子:获取一个年龄最小的作家,并输出他的姓名。
1.先把年龄升序排序
2.再获取第一个元素
3.再调用Optional方法中的ifPresent(是否存在)打印出对应姓名
//例子:获取一个年龄最小的作家,并输出他的姓名。
List<Author> authors = getAuthors();
Optional<Author> first = authors.stream()
.sorted(new Comparator<Author>() {
@Override
public int compare(Author o1, Author o2) {
return o1.getAge() - o2.getAge();
}
})
.findFirst();
first.ifPresent(new Consumer<Author>() {
@Override
public void accept(Author author) {
System.out.println(author.getName());
}
});
//简写lambda表达式
List<Author> authors = getAuthors();
Optional<Author> first = authors.stream()
.sorted((o1, o2) -> o1.getAge() - o2.getAge())
.findFirst();
first.ifPresent(author -> System.out.println(author.getName()));(10)reduce归并
对流中的数据按照你指定的计算方式计算出一个结果。(缩减操作) reduce的作用是把stream中的元素遍历后给组合起来,我们可以传入一个初始值,它会按照我们的计算方式依次拿流中的元素和初始化值进行计算,计算结果再和后面的元素计算。
源码分析:
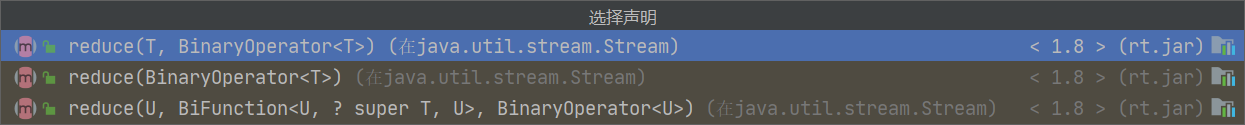
//双参(初始值,BinaryOperator的接口方法)
T reduce(T identity, BinaryOperator<T> accumulator);
//内部计算方法,传入初始值identity命名为result,遍历Stream流中元素,对初始值和流中元素进行操作
T result = identity;
for (T element : this stream)
result = accumulator.apply(result, element)
return result;
//等同于
int[] arr = {1,2,3,4}
T result = 初始值;
for(int i :arr){
result = result*i;
}
//单参,并且返回类型是Optional方法类
Optional<T> reduce(BinaryOperator<T> accumulator);
//内部的计算方式如下: 实际上就是把第一个元素作为初始化值,再拿和这个变量进行相应的计算
boolean foundAny = false;
T result = null;
for (T element : this stream) {
if (!foundAny) {//把第一个值放入result
foundAny = true;
result = element;
}
else
result = accumulator.apply(result, element);
}
return foundAny ? Optional.of(result) : Optional.empty();
//三参,并行流会提及
<U> U reduce(U identity,
BiFunction<U, ? super T, U> accumulator,
BinaryOperator<U> combiner);//返回类型中是BinaryOperator继承BiFunction
@FunctionalInterface
public interface BinaryOperator<T> extends BiFunction<T,T,T> {
//比较器:最小值
public static <T> BinaryOperator<T> minBy(Comparator<? super T> comparator) {
Objects.requireNonNull(comparator);
return (a, b) -> comparator.compare(a, b) <= 0 ? a : b;
}
//比较器:最大值
public static <T> BinaryOperator<T> maxBy(Comparator<? super T> comparator) {
Objects.requireNonNull(comparator);
return (a, b) -> comparator.compare(a, b) >= 0 ? a : b;
}
}eg1.使用reduce求所有作者年龄的和
1.先去重distinct
2.再用map获取对应age的流
3.用reduce来进行遍历,初始值为0,遍历元素为age流中的数据,操作为遍历相加
List<Author> authors = getAuthors();
Integer sum = authors.stream()
.distinct()
.map(author -> author.getAge())
.reduce(0, new BinaryOperator<Integer>() {
@Override
public Integer apply(Integer integer, Integer integer2) {
return integer + integer2;
}
});
System.out.println(sum);
//简写lambda
.reduce(0, (integer, integer2) -> integer + integer2);eg2.
如果用一个参数的重载方法去求最小值代码如下:
1.使用map方法获取author中的age
2.使用reduce方法重写apply,用三元运算符判断流中最小值,并返回
3.由于单参的reduce方法返回的是Optional对象,所以使用Optional对象的方法
4.重写Optional对象,返回age
// 使用reduce求所有作者中年龄的最小值
List<Author> authors = getAuthors();
Optional<Integer> min = authors.stream()
.map(author -> author.getAge())
.reduce(new BinaryOperator<Integer>() {
@Override
public Integer apply(Integer result, Integer element) {
return result > element ? element : result;
}
});
min.ifPresent(new Consumer<Integer>() {
@Override
public void accept(Integer age) {
System.out.println(age);
}
});
//简化lambda
List<Author> authors = getAuthors();
Optional<Integer> min = authors.stream()
.map(author -> author.getAge())
.reduce((result, element) -> result > element ? element : result);
min.ifPresent(age -> System.out.println(age));注意事项
- 惰性求值(如果没有终结操作,没有中间操作是不会得到执行的)
- 流是一次性的(一旦一个流对象经过一个终结操作后。这个流就不能再被使用)
- 不会影响原数据(我们在流中可以多数据做很多处理。但是正常情况下是不会影响原来集合中的元素的。这往往也是我们期望的)
5.Optional
1.引入
我们在编写代码的时候出现最多的就是空指针异常。所以在很多情况下我们需要做各种非空的判断。例如:
Author author = getAuthor();
if(author!=null){
System.out.println(author.getName());
}尤其是对象中的属性还是一个对象的情况下,这种判断会更多。而过多的判断语句会让我们的代码显得臃肿不堪。
所以在JDK8中引入了Optional,养成使用Optional的习惯后你可以写出更优雅的代码来避免空指针异常,并且在很多函数式编程相关的API中也都用到了Optional。
java.util.Optional类是Java8为了解决null值判断问题,借鉴google guava类库的Optional类而引入的一个同名Optional类。java.util.Optional类可以包含或不包含null值的容器对象。如果存在值,则isPresent方法将返回true,而get方法将返回该值。注意:在mybatis3.5以后,传入的数据会自动封装成Optional类
| 方法 | 用途 |
|---|---|
| Optional of(T value) | 创建一个Optional 实例,如果 value 是 null,则抛出 NPE。 |
| Optional empty() | 创建一个空的Optional 实例,返回Optional容器,而不是 null。 |
| Optional ofNullable(T value) | 若value不为null,则创建一个Optional 实例,否则 创建一个空实例 |
| boolean isPresent() | 判断是否包含值 ,如果存在值,则isPresent方法将返回true |
| ifPresent(Consumer<? super T> consumer) | 如果包装对象的值非空,运行Consumer对象的accept()方法 |
| Optional filter(Predicate<? super T> predicate) | 如果符合Predicate的条件,返回Optional对象本身,否则返回一个空的Optional对象。 |
| Optional map(Function<? super T, ? extends U> mapper) | 如果有值对其处理,并返回处理后的Optional,否则返回Optional.empty() |
| Optional flatMap(Function<? super T, Optional> mapper) | 与map类似,要求返回值必须是Optional |
| T orElse(T other) | 如果调用对象包含值,则返回该值,否则返回ohther |
| T orElseGet(Supplier<? extends T> other) | 如果调用对象包含值,则返回该值,否则返回ohther 获取的值 |
2.1 Optional 对象的创建ofNullable()、of()、empty()方法
源码分析:
//该方法和of()方法的作用一样,但value允许为null
public static <T> Optional<T> ofNullable(T value) {
//这里传入的值用三元符判断,如果为空则返回empty静态方法(这样避免了空指针异常),不为空则用of()方法创建Optional类
return value == null ? empty() : of(value);
}
//该方法返回一个value为空的Optional对象,静态方法
public static<T> Optional<T> empty() {
@SuppressWarnings("unchecked")
Optional<T> t = (Optional<T>) EMPTY;
return t;
}
//该方法用于指定value创建一个Optional对象,value不能为null,否则抛出异常
public static <T> Optional<T> of(T value) {
return new Optional<>(value);
}eg.我们一般使用Optional的静态方法ofNullable来把数据封装成一个Optional对象。无论传入的参数是否为null都不会出现问题。
Author author = getAuthor();
Optional<Author> authorOptional = Optional.ofNullable(author);这三种方法的比较:
使用of()方法时,如果传入的数据为null,那么还是会报NPE错误
使用empty()方法时,如果传入的数据为null,会返回一个返回Optional容器
使用ofNullable()方法时,不管传入的数据null与否,都会返回Optional容器
2.2安全消费值ifPresent方法
源码分析:
//ifPresent()方法接受一个Consumer对象(消费函数),如果包装对象的值非空,运行Consumer对象的accept()方法,进行安全消费
public void ifPresent(Consumer<? super T> consumer) {
if (value != null)
consumer.accept(value);
}
//重写accept方法
ifPresent(new Consumer<String>() {
@Override
public void accept(String s) {
}
})eg.
Optional<String> optional = Optional.of("thinkwon");
optional.ifPresent(new Consumer<String>() {
@Override
public void accept(String s) {
System.out.println(s);
}
});
//简写lambda表达式
optional.ifPresent(s -> System.out.println(s));2.3 静态isPresent()方法(非安全消费值)
源码分析:
public boolean isPresent() {
return value != null;
}eg.静态方法,不演示
2.4 获取值
get()方法(非安全获取值)
get()方法主要用于返回包装对象的实际值,但是如果包装对象值为null,会抛出NoSuchElementException异常(不安全)
源码分析:
//空参,调用方法
public T get() {
if (value == null) {
throw new NoSuchElementException("No value present");
}
return value;
}orElse()方法
如果调用对象包含值,则返回该值,否则返回ohther
源码分析:
public T orElse(T other) {
return value != null ? value : other;
}orElseGet()方法
获取数据并且设置数据为空时的默认值。如果数据不为空就能获取到该数据。如果为空则根据你传入的参数来创建对象作为默认值返回。(安全的获取值)
源码分析:
///orElseGet()方法接受一个Supplier对象,如果包装对象的值非空,运行Supplier对象的get()方法,进行安全获取
public T orElseGet(Supplier<? extends T> other) {
return value != null ? value : other.get();
}
//重写空参的get方法
@FunctionalInterface
public interface Supplier<T> {
T get();
}eg.
Optional<String> s = Optional.ofNullable(null);
s.orElseGet(new Supplier<String>() {
@Override
public String get() {
return "我不知道呀";
}
});
System.out.println(s);
//简化lambda
s.orElseGet(() -> "我不知道呀");orElseThrow()方法
orElseThrow()方法其实与orElseGet()方法非常相似了,入参都是Supplier对象,只不过orElseThrow()的Supplier对象必须返回一个Throwable异常,并在orElseThrow()中将异常抛出,orElseThrow()方法适用于包装对象值为空时需要抛出特定异常的场景。
源码分析:
//
public <X extends Throwable> T orElseThrow(Supplier<? extends X> exceptionSupplier) throws X {
if (value != null) {
return value;
} else {
throw exceptionSupplier.get();
}
}eg.
//1.get方法为空参
//2.指定异常类型及提示
Optional.ofNullable(null).orElseThrow(new Supplier<RuntimeException>() {
@Override
public RuntimeException get() {
return new RuntimeException("我不知道的异常呀");
}
});
//简化lambda
Optional.ofNullable(null).orElseThrow(() -> new RuntimeException("我不知道的异常呀"));2.5 过滤数据
filter()方法
filter()方法接受参数为Predicate对象,用于对Optional对象进行过滤,如果符合Predicate的条件,返回Optional对象本身,否则返回一个空的Optional对象。
源码分析:
//filter()方法接受一个Predicate对象,符合过滤条件代码,返回该对象本身,反之返回空的对象
public Optional<T> filter(Predicate<? super T> predicate) {
Objects.requireNonNull(predicate);
if (!isPresent())
return this;
else
return predicate.test(value) ? this : empty();
}
//Predicate接口方法
@FunctionalInterface
public interface Predicate<T> {
boolean test(T t);
}eg.
1.传入thinkwon字符串
2.过滤出字符串长度大于2的
3.使用安全消费的isPresent方法打印输出字符串
Optional.of("thinkwon")
.filter(new Predicate<String>() {
@Override
public boolean test(String s) {
return s.length()>2;
}
}).ifPresent(s -> System.out.println(s));
//简写成lambda表达式
//1.参数名为s(传入的是字符串,所以默认为String类型,名称默认为s)
//2.方法体为s.length()>2
filter(s -> s.length()>2)2.6 数据转换(和Stream中map,flatmap一样的方法,只不过返回的是Optional类型)
Optional还提供了map可以让我们的对数据进行转换,并且转换得到的数据也还是被Optional包装好的,保证了我们的使用安全。例如我们想获取作家的书籍集合。
源码分析:
//和Stream流中map方法一样
public<U> Optional<U> map(Function<? super T, ? extends U> mapper) {
Objects.requireNonNull(mapper);
if (!isPresent())
return empty();
else {
return Optional.ofNullable(mapper.apply(value));
}
}
//和Stream流中flatmap方法一样
public<U> Optional<U> flatMap(Function<? super T, Optional<U>> mapper) {
Objects.requireNonNull(mapper);
if (!isPresent())
return empty();
else {
return Objects.requireNonNull(mapper.apply(value));
}
}6.函数式接口
只有一个抽象方法的接口我们称之为函数接口。 JDK的函数式接口都加上了**@Functionallnterface**注解进行标识。但是无论是否加上该注解只要接口中只有一个抽象方法,都是函数式接口。,这种方法很经典,里面只有一个抽象方法,可以用lambda表达式重写
* @see java.lang.Thread
* @see java.util.concurrent.Callable
*/
@FunctionalInterface
public interface Runnable {
public abstract void run();
}我们看到Runnable接口中只包含一个抽象的run()方法,并且在接口上标注了一个@FuncationInterface注解,此注解就是 Java 8 新增的注解,用来标识一个函数式接口。
常见函数式接口(源码向上查即可)
-
Consumer消费接口,在方法中对传入的参数进行消费
Java@FunctionalInterface public interface Consumer<T> { void accept(T t); } -
Function计算转换接口,对传入的数据进行计算和转换
-
Predicate判断接口,对传入的数据进行条件判断
-
Supplier生产型接口,对传入的对象进行返回
7.高级用法
基本数据类型优化
我们之前用到的很多Stream的方法由于都使用了泛型。所以涉及到的参数和返回值都是引用数据类型。
即使我们操作的是整数小数,但是实际用的都是他们的包装类。JDK5中引入的自动装箱和自动拆箱让我们在使用对应的包装类时就好像使用基本数据类型一样方便。但是你一定要知道装箱和拆箱肯定是要消耗时间的。虽然这个时间消耗很下。但是在大量的数据不断的重复装箱拆箱的时候,你就不能无视这个时间损耗了。
所以为了让我们能够对这部分的时间消耗进行优化。Stream还提供了很多专门针对基本数据类型的方法。
例如: mapTolnt,mapToLong,mapToDouble,flatMapTolnt,flatMaplODounle等。
并行流
当流中有大量元素时,我们可以使用并行流去提高操作的效率。其实并行流就是把任务分配给多个线程去完全。如果我们自己去用代码实现的话其实会非常的复杂,并且要求你对并发编程有足够的理解和认识。而如果我们使用Stream的话,我们只需要修改一个方法的调用就可以使用并行流来帮我们实现,从而提高效率。
parallel() 方法可以把串行流转换成并行流。
源码分析:
S parallel();//直接调用的方法Stream流中中间操作的peek()方法:
peek主要被用在debug用途。因为Stream需要终结操作才能开始启动,所以这样就很被动
使用peek方法可以去调试debug
源码分析:
Stream<T> peek(Consumer<? super T> action);eg.
Stream.of("one", "two", "three","four").peek(u -> u.toUpperCase())
.forEach(System.out::println);
/*结果
one
two
three
four
*/
Stream.of("one", "two", "three","four").map(u -> u.toUpperCase())
.forEach(System.out::println);
/*结果
ONE
TWO
THREE
FOUR
*/parallelStream() 方法直接获取并行流对象。
源码分析:
default Stream<E> parallelStream() {
return StreamSupport.stream(spliterator(), true);
}
//本质上还是转换成Stream流eg.
List<Author> authors = getAuthors();
authors.parallelStream()
.map(author -> author.getAge())
.map(age -> age + 10)
.filter(age->age>18)
.map(age->age+2)
.forEach(System.out::println);十一、java注解
为什么要引入注解?
【XML】被广泛的应用于描述元数据
优点:松耦合
缺点:随着项目越来越庞大,【XML】的内容也越来越复杂,维护成本变高。
过程:于是就有人提出来一种标记式高耦合的配置方式【注解】。方法上可以进行注解,类上也可以注解,字段属性上也可以注解,反正几乎需要配置的地方都可以进行注解。:
(xml和注解)两者的区别:
假如你想为应用设置很多的常量或参数,这种情况下,【XML】是一个很好的选择,因为它不会同特定的代码耦合。如果你想把某个方法声明为服务,那么使用【注解】会更好一些,因为这种情况下需要注解和方法紧密耦合起来,开发人员也必须认识到这点。
同时,【注解】定义了一种标准的描述元数据的方式。
什么是注解
注解也叫元数据,即一种描述数据的数据。例如我们常见的@Override和@Deprecated,注解是JDK1.5版本开始引入的一个特性,用于对代码进行说明,可以对包、类、接口、字段、方法参数、局部变量等进行注解
Annotation接口中有下面这句话来描述注解:Annotation (注解)是所有注解继承的公共接口
The common interface extended by all annotation types.==注解的本质就是一个继承了 Annotation 接口的接口。==
一个注解准确意义上来说,只不过是一种特殊的注释而已,如果没有解析它的代码,它可能连注释都不如。
而解析一个类或者方法的注解往往有两种形式,一种是编译期直接的扫描,一种是运行期反射。
编译器的扫描指的是编译器在对 Java 代码编译成字节码的过程中会检测到某个类或者方法被一些注解修饰,这时它就会对于这些注解进行某些处理。
@Override
public String toString() {
return "Hello Annotation";
}
1234上面的代码中,重写了toString()方法并使用了@Override注解。
@Override告诉编译器这个方法是一个重写方法(描述方法的元数据),如果父类中不存在该方法,编译器便会报错,提示该方法没有重写父类中的方法。
如果我不小心拼写错误,例如将toString()写成了toStrring(),而且我也没有使用@Override注解,那程序依然能编译运行。但运行结果会和我期望的大不相同。使用注解有助于提高代码的可读性。
注解的用途
- 生成文档,通过代码里标识的元数据生成javadoc文档。
- 编译检查,通过代码里标识的元数据让编译器在编译期间进行检查验证。
- 编译时动态处理,编译时通过代码里标识的元数据动态处理,例如动态生成代码。
- (重点)运行时动态处理,运行时通过代码里标识的元数据动态处理,例如使用反射注入实例
注解的分类
- Java自带的标准注解,包括@Override(标明重写某个方法)、@Deprecated(标明某个类或方法过时)和@SuppressWarnings(标明要忽略的警告),使用这些注解后编译器就会进行检查
- 元注解,元注解是用于定义注解的注解,包括@Retention(标明注解被保留的阶段)、@Target(标明注解使用的范围)、@Inherited(标明注解可继承)、@Documented(标明是否生成javadoc文档)
- 自定义注解,可以根据自己的需求定义注解
元注解
要想真正掌握怎么使用注解,还需要先学习一下元注解。
元注解是用于修饰注解的注解
元注解有 @Retention、@Documented、@Target、@Inherited、@Repeatable 5 种。
@Retention
Retention 的英文意为保留期的意思。当 @Retention 应用到一个注解上的时候,它解释说明了这个注解的的存活时间。
它的取值(属性)如下:
- RetentionPolicy.SOURCE 注解只在源码阶段保留,在编译器进行编译时它将被丢弃忽视。
- RetentionPolicy.CLASS 注解只被保留到编译进行的时候,它并不会被加载到 JVM 中。如Java内置注解,@Override、@Deprecated、@SuppressWarnning等
- RetentionPolicy.RUNTIME 注解可以保留到程序运行的时候,它会被加载进入到 JVM 中,所以在程序运行时可以获取到它们。如SpringMvc中的@Controller、@Autowired、@RequestMapping等。
//例子
@Retention(RetentionPolicy.RUNTIME)@Documented
顾名思义,这个元注解肯定是和文档有关。它的作用是能够将注解中的元素包含到 Javadoc 中去。
@Target
Target 是目标的意思,@Target 指定了注解运用的地方。
你可以这样理解,当一个注解被 @Target 注解时,这个注解就被限定了运用的场景。
类比到标签,原本标签是你想张贴到哪个地方就到哪个地方,但是因为 @Target 的存在,它张贴的地方就非常具体了,比如只能张贴到方法上、类上、方法参数上等等。@Target 有下面的取值
- ElementType.ANNOTATION_TYPE 可以给一个注解进行注解
- ElementType.CONSTRUCTOR 可以给构造方法进行注解
- ElementType.FIELD 可以给属性进行注解
- ElementType.LOCAL_VARIABLE 可以给局部变量进行注解
- ElementType.METHOD 可以给方法进行注解
- ElementType.PACKAGE 可以给一个包进行注解
- ElementType.PARAMETER 可以给一个方法内的参数进行注解
- ElementType.TYPE 可以给一个类型进行注解,比如类、接口、枚举
@Inherited
Inherited 是继承的意思,但是它并不是说注解本身可以继承,而是说如果一个超类使用了@Inherited 注解,那么如果它的子类没有被任何注解应用的话,那么这个子类就继承了超类的注解。
@Repeatable
Repeatable 自然是可重复的意思。@Repeatable 是 Java 1.8 才加进来的,所以算是一个新的特性。
Repeatable使用场景:在需要对同一种注解多次使用时,往往需要借助@Repeatable。
注解的属性(自定义注解)
注解的属性也叫做成员变量。注解只有成员变量,没有方法。注解的成员变量在注解的定义中以“无形参的方法”形式来声明,其方法名定义了该成员变量的名字,其返回值定义了该成员变量的类型。
@Target(ElementType.TYPE)
@Retention(RetentionPolicy.RUNTIME)
public @interface TestAnnotation{
int id();
String msg();
}
上面代码定义了 @TestAnnotation 这个注解中拥有 id 和 msg 两个属性。在使用的时候,我们应该给它们进行赋值。
赋值的方式是在注解的括号内以 value="" 形式,多个属性之前用 ,隔开。
@TestAnnotation(id=3, msg="hello annotation")
public class Test {
}快捷方式
所谓的快捷方式就是注解中定义了名为value的元素,并且在使用该注解时,如果该元素是唯一需要赋值的一个元素
那么此时无需使用key=value的语法,而只需在括号内给出value元素所需的值即可。这可以应用于任何合法类型的元素,记住,这限制了元素名必须为value,简单案例如下
@Target(ElementType.FIELD)
@Retention(RetentionPolicy.RUNTIME)
@interface IntegerVaule{
int value() default 0;
String name() default "";
}
public class QuicklyWay {
@IntegerVaule(20)
public int age;
@IntegerVaule(value = 10000, name = "MONEY")
public int money;
}
注解不支持继承
注解是不支持继承的,因此不能使用关键字extends来继承某个@interface,但注解在编译后,编译器会自动继承java.lang.annotation.Annotation接口
Java预置的注解
学习了上面相关的知识,我们已经可以自己定义一个注解了。其实 Java 语言本身已经提供了几个现成的注解。
@Deprecated
这个元素是用来标记过时的元素,想必大家在日常开发中经常碰到。编译器在编译阶段遇到这个注解时会发出提醒警告,告诉开发者正在调用一个过时的元素比如过时的方法、过时的类、过时的成员变量。
@Override
这个大家应该很熟悉了,用于标明此方法覆盖了父类的方法。
@SuppressWarnings
用于有选择的关闭编译器对类、方法、成员变量、变量初始化的警告。之前说过调用被 @Deprecated 注解的方法后,编译器会警告提醒,而有时候开发者会忽略这种警告,他们可以在调用的地方通过 @SuppressWarnings 达到目的。
@SafeVarargs
参数安全类型注解。它的目的是提醒开发者不要用参数做一些不安全的操作,它的存在会阻止编译器产生 unchecked 这样的警告。它是在 Java 1.7 的版本中加入的。
@FunctionalInterface
函数式接口注解,这个是 Java 1.8 版本引入的新特性。函数式编程很火,所以 Java 8 也及时添加了这个特性。
函数式接口 (Functional Interface) 就是一个具有一个方法的普通接口。
我们进行线程开发中常用的 Runnable 就是一个典型的函数式接口,从源码可以看到它使用了@FunctionalInterface 注解。
十二、JSON
概述
JSON(JavaScript Object Notation JavaScript 对象表示法)是一种轻量级的数据交换格式,它基于JavaScript的一个子集,易于人的编写和阅读,也易于机器解析。 JSON采用完全独立于语言的文本格式,但是也使用了类似于C语言家族的习惯(包括C, C++, C#, Java, JavaScript, Perl, Python等)。 这些特性使JSON成为理想的数据交换语言。
结构组成
JSON由两种结构组成:
- 键值对的无序集合——对象(或者叫记录、结构、字典、哈希表、有键列表或关联数组等)
- 值的有序列表——数组
语法规则
- 数据在名称/值对中
- 数据由逗号分隔
- 大括号保存对象
- 中括号保存数组
JSON的形式
对象
一个无序键值对的集合,以"{“开始,同时以”}“结束,键值对之间以”:“相隔,不同的键值对之间以”,"相隔,举例
{
"key1" : 1,
"key2" : "string"
}
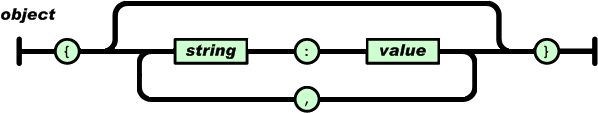
数组
值(value)的有序集合。一个数组以“[”(左中括号)开始,“]”(右中括号)结束。值之间使用“,”(逗号)分隔。
举例
[ "Google", "Runoob", "Taobao" ]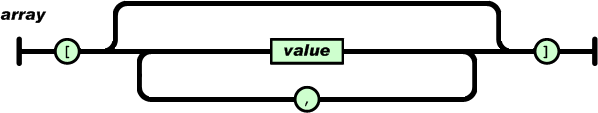
值(value)可以是双引号括起来的字符串(string)、数值(number)、true、false、 null、对象(object)或者数组(array)。这些结构可以嵌套。
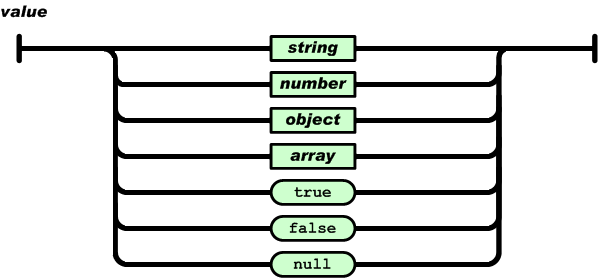
字符串(string)是由双引号包围的任意数量Unicode字符的集合,使用反斜线转义。一个字符(character)即一个单独的字符串(character string)。
字符串(string)与C或者Java的字符串非常相似。
数值(number)也与C或者Java的数值非常相似。除去未曾使用的八进制与十六进制格式。除去一些编码细节。
空白可以加入到任何符号之间。
这里举例一个比较复杂的json
{
//对象
"name":"网站",
"money":3.22,
"status":0,
"valid":true,
"address":null,
//左边是对象,右边是数组
"sites": [
//数组里面再套对象的键值对
{ "name":"Google", "info":[ "Android", "Google 搜索", "Google 翻译" ] },
{ "name":"Runoob", "info":[ "菜鸟教程", "菜鸟工具", "菜鸟微信" ] },
{ "name":"Taobao", "info":[ "淘宝", "网购" ] }
]
}
十三、Properties类简介(经典用法:jdbc的用法)
概述
Properties 继承于 Hashtable。表示一个持久的属性集,属性列表以key-value的形式存在,key和value都是字符串。
Java中有个比较重要的类Properties(Java.util.Properties),主要用于读取Java的配置文件,各种语言都有自己所支持的配置文件,配置文件中很多变量是经常改变的,这样做也是为了方便用户,让用户能够脱离程序本身去修改相关的变量设置。像Python支持的配置文件是.ini文件,同样,它也有自己读取配置文件的类ConfigParse,方便程序员或用户通过该类的方法来修改.ini配置文件。在Java中,其配置文件常为.properties文件,格式为文本文件,文件的内容的格式是“键=值”的格式,文本注释信息可以用"#"来注释。
常用方法
除了从Hashtable中所定义的方法,Properties定义了以下方法:
| 返回值类型 | 方法和描述 |
|---|---|
String |
getProperty(String key) 搜索具有此属性列表中的指定键属性。 |
String |
getProperty(String key, String defaultValue) 搜索具有此属性列表中的指定键属性。 |
void |
list(PrintStream out) 将此属性列表输出到指定的输出流。 |
void |
list(PrintWriter out) 将此属性列表输出到指定的输出流。 |
void |
load(InputStream inStream) 从输入的字节流中读取属性列表 (键和元素对)。 |
void |
load(Reader reader) 属性列表 (键和元素对) 从流中读取的输入的字符在一个简单的面向行的格式。 |
void |
loadFromXML(InputStream in) 加载所有到此属性表所指定的输入流的 XML 文档表示的属性。 |
Enumeration<?> |
propertyNames() 在此属性列表中,如果具有相同名称的密钥不已发现从主要属性列表中的默认属性列表中包括非重复键返回所有键的枚举。 |
void |
save(OutputStream out, String comments) 弃用。 如果发生 I/O 错误,则保存在属性列表中,此方法不会引发时抛出。保存的属性列表的首选的方法是通过 store(OutputStream out, String comments) 方法或 storeToXML(OutputStream os, String comment) 方法。 |
Object |
setProperty(String key, String value) 调用 Hashtable 方法 put。 |
void |
store(OutputStream out, String comments) 此属性列表 (键和元素对) 此 Properties 表中写入输出流中适合装载到 Properties 表中使用 load(InputStream) 方法的格式。 |
void |
store(Writer writer, String comments) 此属性列表 (键和元素对) 此 Properties 表中写入输出字符流格式适合使用 load(Reader) 方法。 |
void |
storeToXML(OutputStream os, String comment) 发出代表所有包含此表中的属性的 XML 文档。 |
void |
storeToXML(OutputStream os, String comment, String encoding) 发出代表所有包含在此表中,使用指定的编码的属性的 XML 文档。 |
Set<String> |
stringPropertyNames() 返回一组键此属性列表中的关键和其对应的值都是字符串,默认属性列表中包括非重复键,如果具有相同名称的密钥不已发现从主要属性列表。 |
常用方法实践
Properties类
下面我们从写入、读取、遍历等角度来解析Properties类的常见用法
项目路径如下
src
main
java
com
jourwon
prop
PropertiesTest
resources
config.properties
prop.properties
PropertiesTest为测试类,prop.properties文件的内容如下
username=root
password=123456写入
Properties类调用setProperty方法将键值对保存到内存中,此时可以通过getProperty方法读取,propertyNames方法进行遍历,但是并没有将键值对持久化到属性文件中,故需要调用store方法持久化键值对到属性文件中。
public static void main(String[] args) throws IOException {
Properties properties = new Properties();
OutputStream output = null;//输出流先设置null值
try {
//创建文件输出流对象
output = new FileOutputStream("src/main/resources/config.properties");
//调用setProperty方法将键值对保存到内存中
properties.setProperty("username", "root");
properties.setProperty("password", "123456");
// 保存键值对到文件中
properties.store(output, "JourWon modify");
} catch (IOException io) {
io.printStackTrace();
} finally {
if (output != null) {
try {
output.close();
} catch (IOException e) {
e.printStackTrace();
}
}
}
}输出结果,在resources目录下多一个文件config.properties,内容如下
#JourWon modify
#Mon Sep 09 14:23:44 CST 2019
password=123456
username=root读取
下面给出常见的六种读取properties文件的方式:
public static void main(String[] args) throws IOException {
// PropertiesTest.getPath1();
// PropertiesTest.getPath2();
// PropertiesTest.getPath3();
// PropertiesTest.getPath4();
// PropertiesTest.getPath5();
PropertiesTest.getPath6();
}
/**
* 一、 使用java.util.Properties类的load(InputStream in)方法加载properties文件
* 主要是需要加上src这个文件夹名。路径配置需要精确到绝对地址级别
*
* @return
*/
public static void getPath1() throws IOException {
InputStream in = new BufferedInputStream(new FileInputStream(
new File("src/main/resources/prop.properties")));
printKeyValue(in);
}
/**
* 二、 使用java.util.ResourceBundle类的getBundle()方法
* 注意:这个getBundle()方法的参数只能写成包路径+properties文件名,注意不需要带上后缀名。
*
* @return
*/
public static void getPath2() {
ResourceBundle rb = ResourceBundle
.getBundle("prop");
printKeyValueRb(rb);
}
/**
* 三、 使用java.util.PropertyResourceBundle类的构造函数
*
* @return
*/
public static void getPath3() throws IOException {
InputStream in = new BufferedInputStream(new FileInputStream("src/main/resources/prop.properties"));
ResourceBundle rb = new PropertyResourceBundle(in);
printKeyValueRb(rb);
}
/**
* 四、 使用class变量的getResourceAsStream()方法
* 注意:getResourceAsStream()方法的参数按格式写到包路径+properties文件名+.后缀
*
* @return
*/
public static void getPath4() throws IOException {
InputStream in = PropertiesTest.class
.getResourceAsStream("/prop.properties");
printKeyValue(in);
}
/**
* 五、
* 使用class.getClassLoader()所得到的java.lang.ClassLoader的
* getResourceAsStream()方法
* getResourceAsStream(name)方法的参数必须是包路径+文件名+.后缀
* 否则会报空指针异常
*
* @return
*/
public static void getPath5() throws IOException {
InputStream in = PropertiesTest.class.getClassLoader()
.getResourceAsStream("./././prop.properties");
printKeyValue(in);
}
/**
* 六、 使用java.lang.ClassLoader类的getSystemResourceAsStream()静态方法
* getSystemResourceAsStream()方法的参数格式也是有固定要求的
*
* @return
*/
public static void getPath6() throws IOException {
InputStream in = ClassLoader
.getSystemResourceAsStream("./././prop.properties");
printKeyValue(in);
}
/**
* 单独抽取的方法,用户检测能否正确操纵Properties
*
* @param inputStream
* @throws IOException
*/
public static void printKeyValue(InputStream inputStream) throws IOException {
Properties properties = new Properties();
properties.load(inputStream);
Set<Object> keys = properties.keySet();
for (Object key : keys) {
System.out.println(key + " = " + properties.get(key));
}
if (inputStream != null) {
inputStream.close();
}
}
public static void printKeyValueRb(ResourceBundle rb) {
Set<String> keys = rb.keySet();
for (String key : keys) {
System.out.println(key + " = " + rb.getString(key));
}
}
其中第一、四、五、六种方式都是先获得文件的输入流,然后通过Properties类的load(InputStream inStream)方法加载到Properties对象中,最后通过Properties对象来操作文件内容。 第二、三中方式是通过ResourceBundle类来加载Properties文件,然后ResourceBundle对象来操做properties文件内容。 其中最重要的就是每种方式加载文件时,文件的路径需要按照方法的定义的格式来加载,否则会抛出各种异常,比如空指针异常。
遍历
下面给出四种遍历Properties中的所有键值对的方法:
/**
* 输出properties的key和value
*/
public static void printProp(Properties properties) {
System.out.println("---------(方式一)------------");
for (String key : properties.stringPropertyNames()) {
System.out.println(key + "=" + properties.getProperty(key));
}
System.out.println("---------(方式二)------------");
//返回属性key的集合
Set<Object> keys = properties.keySet();
for (Object key : keys) {
System.out.println(key.toString() + "=" + properties.get(key));
}
System.out.println("---------(方式三)------------");
Set<Map.Entry<Object, Object>> entrySet = properties.entrySet();
//返回的属性键值对实体
for (Map.Entry<Object, Object> entry : entrySet) {
System.out.println(entry.getKey() + "=" + entry.getValue());
}
System.out.println("---------(方式四)------------");
Enumeration<?> e = properties.propertyNames();
while (e.hasMoreElements()) {
String key = (String) e.nextElement();
String value = properties.getProperty(key);
System.out.println(key + "=" + value);
}
}
十四、XML
什么是 XML
- XML 是可扩展标记语言(EXtensible Markup Language)。
- XML 是一种很像HTML的标记语言。
- XML 的设计宗旨是传输数据,而不是显示数据。
- XML 标签没有被预定义。您需要自行定义标签。
- XML 被设计为具有自我描述性。
- XML 是 W3C 的推荐标准。
XML 用途
XML 应用于 Web 开发的许多方面,常用于简化数据的存储和传输。
存放数据栗子
<?xml version="1.0" encoding="UTF-8"?>
<persons>
<person id="p001">
<name>张三</name>
</person>
<person id="p002">
<name>李四</name>
</person>
</persons>
配置文件栗子
<?xml version="1.0" encoding="UTF-8"?>
<web-app version="2.5">
<servlet>
<servlet-name>HelloMyServlet</servlet-name>
<servlet-class>com.jourwon.HelloMyServlet</servlet-class>
</servlet>
<servlet-mapping>
<servlet-name>HelloMyServlet</servlet-name>
<url-pattern>/hello</url-pattern>
</servlet-mapping>
</web-app>
XML 语法
XML文件主要由XML文档声明,元素,属性,注释,转义字符,CDATA区,处理指令组成。
XML文档声明
<?xml version="1.0" encoding="UTF-8"?>- 文档声明必须为
<?xml开头,以?>结束; - 文档声明必须从文档的0行0列位置开始;
- 文档声明只有三个属性:
- versioin:指定XML文档版本。必须属性,因为我们不会选择1.1,只会选择1.0;
- encoding:指定当前文档的编码。可选属性,默认值是utf-8;
- standalone:指定文档独立性。可选属性,默认值为yes,表示当前文档是独立文档。如果为no表示当前文档不是独立的文档,会依赖外部文件。
元素
<servlet>- 元素是XML文档中最重要的组成部分,
- 普通元素的结构开始标签、元素体、结束标签组成。例如:大家好
- 元素体:元素体可以是元素,也可以是文本,例如:你好
- 空元素:空元素只有开始标签,而没有结束标签,但元素必须自己闭合,例如:
- 元素命名: a) 区分大小写 b) 不能使用空格,不能使用冒号: c) 不建议以XML、xml、Xml开头
- 良好的XML文档,必须有一个根元素。
属性
<web-app version="2.5">- 属性是元素的一部分,它必须出现在元素的开始标签中
- 属性的定义格式:属性名=属性值,其中属性值必须使用单引或双引
- 一个元素可以有0~N个属性,但一个元素中不能出现同名属性
- 属性名不能使用空格、冒号等特殊字符,且必须以字母开头
注释
-
XML 文件中注释采用:" " 这样的格式
-
XML 声明之前不能有注释
-
注释不能嵌套,比如下面不合规范:
转义字符
XML中的转义字符与HTML一样。 因为很多符号已经被XML文档结构所使用,所以在元素体或属性值中想使用这些符号就必须使用转义字符,例如:“<”、“>”、“’”、“””、“&”。
转义字符 特殊字符 含义 < < 小于 > > 大于 & & 和号 ' ’ 单引号 " " 引号
CDATA区
<![CDATA[
任意内容
]]>当大量的转义字符出现在xml文档中时,会使xml文档的可读性大幅度降低。这时如果使用CDATA段就会好一些。 在CDATA段中出现的“<”、“>”、“””、“’”、“&”,都无需使用转义字符。这可以提高xml文档的可读性。 在CDATA段中不能包含“]]>”,即CDATA段的结束定界符。
处理指令
用来解析引擎如何解析 XML 文档内容
比如:在 XML 文档中可以使用 xml-stylesheet 指令,通知 XML 解析引擎,应用 CSS 文件显示 XML 文档内容
<?xml-stylesheet type="text/css" href="a.css"?>
处理指令必须以<? 开头,以 > 结尾
XML的解析
开发中比较常见的解析方式有三种
- DOM:要求解析器把整个XML文档装载到内存,并解析成一个Document对象。 a) 优点:元素与元素之间保留结构关系,故可以进行增删改查操作。 b) 缺点:XML文档过大,可能出现内存溢出显现。
- SAX:是一种速度更快,更有效的方法。它逐行扫描文档,一边扫描一边解析。并以事件驱动的方式进行具体解析,每执行一行,都将触发对应的事件。(了解) a) 优点:处理速度快,可以处理大文件 b) 缺点:只能读,逐行后将释放资源。
- PULL:Android内置的XML解析方式,类似SAX。(了解)
解析器
根据不同的解析方式提供的具体实现。有的解析器操作过于繁琐,为了方便开发人员,有提供易于操作的解析开发包。
常见的解析开发包
- JAXP:sun公司提供支持DOM和SAX开发包
- JDom:dom4j兄弟
- jsoup:一种处理HTML特定解析开发包
- dom4j:比较常用的解析开发包,hibernate底层采用。
DOM解析原理及结构模型
XML DOM 和 HTML DOM类似,XML DOM 将 整个XML文档加载到内存,生成一个DOM树,并获得一个Document对象,通过Document对象就可以对DOM进行操作
<?xml version="1.0" encoding="UTF-8"?>
<web-app version="2.5">
<servlet>
<servlet-name>HelloMyServlet</servlet-name>
<servlet-class>com.jourwon.HelloMyServlet</servlet-class>
</servlet>
<servlet-mapping>
<servlet-name>HelloMyServlet</servlet-name>
<url-pattern>/hello</url-pattern>
</servlet-mapping>
</web-app>
DOM中的核心概念就是节点,在XML文档中的元素、属性、文本等,在DOM中都是节点!
dom4j技术栗子
引入dom4j依赖
<dependency>
<groupId>org.dom4j</groupId>
<artifactId>dom4j</artifactId>
<version>2.1.1</version>
</dependency>
将xml文件放到指定位置,这里放的是XML 用途配置文件栗子的内容,然后读取这个位置的xml文件,测试代码如下
public class Dome4jTest {
public static void main(String[] args) throws DocumentException {
// 1 创建核心对象(new 方式)
SAXReader saxReader = new SAXReader();
//2 加载xml文档 获得dom树(核心对象调用read读取xml文件)
Document doc = saxReader.read("E:\\IdeaProjects\\demo1\\src\\main\\resources\\demo.xml");
//3 获得根元素(文档对象下面就是根元素)
Element root = doc.getRootElement();
//4 获得子元素(根节点下所有子元素)
List<Element> list = root.elements();
for (Element e : list) {
// elementText("标签名") 获得指定名称元素的文本值 (指定标签的文本值)
// getName() 获得当前元素名
if ("servlet".equals(e.getName())) {
System.out.println(e.elementText("servlet-name"));
System.out.println(e.getName());
}
}
}
}
输出结果
HelloMyServlet
servletXML的约束
作用
规定xml中可以出现哪些元素及哪些属性,以及他们出现的顺序
约束的分类
- DTD约束:struts hiebernate等等(会用到)
- SCHEMA约束:tomcat spring等等(会用到)
约束详解
既然是约束就和xml有联系,所以约束要和xml关联,xml的相关限制才能生效。
方式1:内部关联
格式:
<!DOCTYPE 根元素名 [dtd语法]>
12方式2:外部关联-系统关联
格式:
<!DOCTYPE 根元素名 SYSTEM "约束文件的位置">
例如:
<!DOCTYPE web-app SYSTEM "web-app_2_3.dtd">
1234举例web-app_2_3.dtd文件
<?xml version="1.0" encoding="UTF-8" ?>
<!ELEMENT web-app (servlet*, servlet-mapping* , welcome-file-list?) >
<!ELEMENT servlet (servlet-name, description?, (servlet-class|jsp-file))>
<!ELEMENT servlet-mapping (servlet-name, url-pattern) >
<!ELEMENT servlet-name (#PCDATA)>
<!ELEMENT servlet-class (#PCDATA)>
<!ELEMENT url-pattern (#PCDATA)>
<!ELEMENT welcome-file-list (we1come-fi1e+)>
<!ELEMENT welcome-file (#PCDATA)>
<!ATTLIST web-app version CDATA #IMPLIED>
12345678910接下来xml中只能出现dtd文件中规定的特有的标签了(不能自定义自己随便写了)
ps:idea中你输入< 便会提示能够输入的标签
方式3:外部关联-公共关联
格式:
<!DOCTYPE 根元素名 PUBLIC "约束文件的名称" "约束文件的位置">
如mybatis中mapper的约束
<?xml version="1.0" encoding="UTF-8" ?>
<!DOCTYPE mapper PUBLIC "-//mybatis.org//DTD Mapper 3.0//EN" "http://mybatis.org/dtd/mybatis-3-mapper.dtd" >
12345dtd约束
无论是单独的dtd文件还是写在xml中(参考上面方式一)都需要按照语法要求写
再次强调下语dtd文件约束的作用:
规定xml中可以出现哪些元素及哪些属性,以及他们出现的顺序
标签(元素)语法:
<!Element 元素名称 数据类型|包含内容>
数据类型:#PCDATA:普通文本 使用的时候一般用()引起来
功能:能出现那些标签,以及出现顺序
包含内容:该元素下可以出现哪些元素 用()引起来
符号:
* 出现任意次
? 出现1次或者0次
+ 出现至少1次
| 或者
() 分组
, 顺序(元素出现先后顺序,按照都好标记顺序出现)
栗子如下:(上图约束图中的代码)
<!ELEMENT web-app (servlet*,servlet-mapping* , welcome-file-list?) >
<!ELEMENT servlet-name (#PCDATA)>
ps:元素名就是xml中能够出现的元素标签名
属相的约束语法:
属性:
格式:
<!ATTLIST 元素名 属性名 属性类型 属性是否必须出现>
属性类型:
ID:唯一
CDATA:普通文本
属性是否必须出现
REQUIRED:必须出现
IMPLIED:可以不出现
例如:
<!ATTLIST web-app version CDATA #IMPLIED>
12345678910111213141516171819202122232425262728293031323334353637注意:一个xml文档中只能添加一个DTD约束
schema约束
一个xml文档中可以添加多个schema约束
xml和schema的关联.
格式:
<根标签 xmlns="..." ...>
<根标签 xmlns:别名="..." ...>
名称空间:
关联约束文件
规定元素是来源于那个约束文件的
例如:
一个约束文件中规定 table(表格) 表格有属性 row和col
还有一个约束文件规定 table(桌子) 桌子有属性 width和height
在同一个xml中万一我把两个约束文件都导入了,
在xml中我写一个table,这个table有什么属性????
我们为了避免这种情况的发生,可以给其中的一个约束起个别名
使用的时候若是没有加别名那就代表是来自于没有别名的约束文件
例如 table(表格) 给他起个别名 xmlns:a="..."
在案例中使用 a:table 代表的是表格
若在案例中直接使用 table 代表的是桌子
ps:在一个xml文件中只能有一个不起别名;
注意:
schema约束本身也是xml文件.
12345678910111213141516171819202122如下一个xml scheam的约束文档,我们创建xml时如果有相应的约束 直接引进约束就行。
<?xml version="1.0" encoding="UTF-8"?>
<!--
模拟servlet2.5规范,如果开发人员需要在xml使用当前Schema约束,必须包括指定命名空间。
格式如下:
<web-app xmlns="http://www.example.org/web-app_2_5"
xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
xsi:schemaLocation="http://www.example.org/web-app_2_5 web-app_2_5.xsd"
version="2.5">
-->
<xsd:schema xmlns="http://www.w3.org/2001/XMLSchema"
targetNamespace="http://www.example.org/web-app_2_5"
xmlns:xsd="http://www.w3.org/2001/XMLSchema"
xmlns:tns="http://www.example.org/web-app_2_5"
elementFormDefault="qualified">
<xsd:element name="web-app">
<xsd:complexType>
<xsd:choice minOccurs="0" maxOccurs="unbounded">
<xsd:element name="servlet">
<xsd:complexType>
<xsd:sequence>
<xsd:element name="servlet-name"></xsd:element>
<xsd:element name="servlet-class"></xsd:element>
</xsd:sequence>
</xsd:complexType>
</xsd:element>
<xsd:element name="servlet-mapping">
<xsd:complexType>
<xsd:sequence>
<xsd:element name="servlet-name"></xsd:element>
<xsd:element name="url-pattern"></xsd:element>
</xsd:sequence>
</xsd:complexType>
</xsd:element>
<xsd:element name="welcome-file-list">
<xsd:complexType>
<xsd:sequence>
<xsd:element name="welcome-file" maxOccurs="unbounded"></xsd:element>
</xsd:sequence>
</xsd:complexType>
</xsd:element>
</xsd:choice>
<xsd:attribute name="version" type="double" use="optional"></xsd:attribute>
</xsd:complexType>
</xsd:element>
</xsd:schema>十五、YML
在接触springboot的时候遇到了一种特殊的配置文件 .yml,本文对yml作简单介绍,快速入手yml。
一、YML是什么
YAML (YAML Aint Markup Language)是一种标记语言,通常以.yml或者.yaml为后缀的文件,是一种直观的能够被电脑识别的数据序列化格式,并且容易被人类阅读,容易和脚本语言交互的,可以被支持YAML库的不同的编程语言程序导入,一种专门用来写配置文件的语言。可用于如: Java,C/C++, Ruby, Python, Perl, C#, PHP等。
二、YML的优点
- YAML易于人们阅读。
- YAML数据在编程语言之间是可移植的。
- YAML匹配敏捷语言的本机数据结构。
- YAML具有一致的模型来支持通用工具。
- YAML支持单程处理。
- YAML具有表现力和可扩展性。
- YAML易于实现和使用。
三、YML语法
1.约定
- k: v 表示键值对关系,冒号后面必须有一个空格
- 使用空格的缩进表示层级关系,空格数目不重要,只要是左对齐的一列数据,都是同一个层级的
- 大小写敏感
- 缩进时不允许使用Tab键,只允许使用空格。
- 松散表示,Java中对于驼峰命名法,可用原名或使用-代替驼峰,如java中的lastName属性,在yml中使用lastName或 last-name都可正确映射。
2.键值关系
(以Java语言为例,其它语言类似)对于键与值主要是看能否表示以下内容。普通的值(数字、字符串、布尔)、日期、对象、数组、集合等。
1) 普通值(字面量)
k: v:字面量直接写;
字符串默认不用加上单引号或者双绰号;
“”: 双引号;不会转义字符串里面的特殊字符;特殊字符会作为本身想表示的意思
name: “zhangsan \n lisi”:输出;zhangsan 换行 lisi
‘’:单引号;会转义特殊字符,特殊字符最终只是一个普通的字符串数据
name1: zhangsan
name2: 'zhangsan \n lisi'
name3: "zhangsan \n lisi"
age: 18
flag: true
123452)日期
date: 2019/01/01
13)对象(属性和值)、Map(键值对)
在下一行来写对象的属性和值的关系,注意缩进
people:
name: zhangsan
age: 20
123行内写法:
people: {name:zhangsan,age: 20}
14)数组、list、set
用- 值表示数组中的一个元素
pets:
- dog
- pig
- cat
1234行内写法
pets: [dog,pig,cat]
15)数组对象、list对象、set对象
peoples:
- name: zhangsan
age: 22
- name: lisi
age: 20
- {name: wangwu,age: 18}
1234566)Java代码示例
Java代码(省略get,set方法)
public class Person {
private String lastName;
private Integer age;
private Boolean boss;
private Date birth;
private Map<String,Object> maps;
private List<Dog> lists;
private Dog dog;
private String[] arr;
}
public class Dog {
private String name;
private Integer age;
}
12345678910111213141516对应的yml
person:
boss: false
maps:
k1: v1
k2: 14
lists:
- name: d1
age: 2
- name: d2
age: 3
- {name: d3,age: 4}
birth: 2017/12/15
dog:
name: p_dog
age: 15
age: 13
last-name: 张三
arr: [s1,s2,s3]
1234567891011121314151617183.文档块
对于测试环境,预生产环境,生产环境可以使用不同的配置,如果只想写到一个文件中,yml与是支持的,每个块用----隔开
server:
port: 8081
spring:
profiles:
active: prod #激活对应的文档块
---
server:
port: 8083
spring:
profiles: dev #指定属于哪个环境
---
server:
port: 8084
spring:
profiles: prod #指定属于哪个环境