
Java集合(总框架篇)
这里个人的笔记与图文不符,这是坑。导致自己看的难受。
这里说一下:
图片上对应的集合是常用的,其他笔记写的,有部分是很偏的。
Java集合分为Collection(单列表) 和 Map(双列表)两个接口
其中Collection接口如下:有 3 个接口 List、Set、Queue
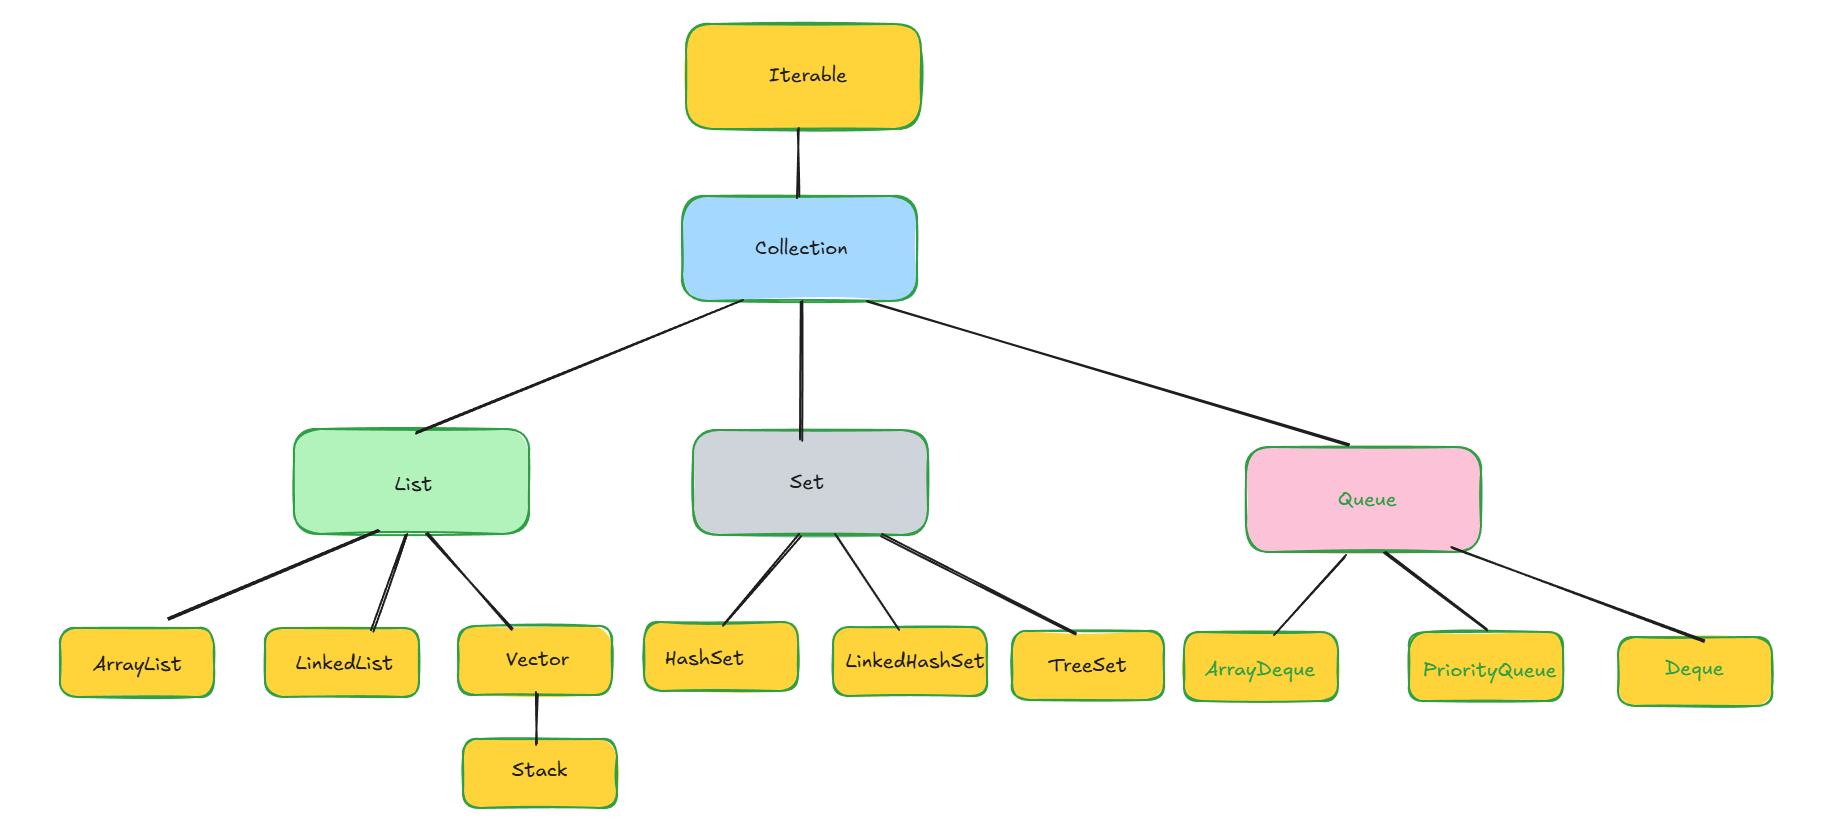
| 接口/类 | 是否有序 | 是否允许重复 | 底层数据结构 | 特点 |
|---|---|---|---|---|
| List | 有序(索引) | 允许重复 | 动态数组 / 双向链表 | 随机访问快(ArrayList)、插入删除快(LinkedList) |
| ArrayList | 有序 | 允许重复 | 动态数组 | 访问 O(1),插入删除 O(n) |
| LinkedList | 有序 | 允许重复 | 双向链表 | 插入删除 O(1),可做队列/栈 |
| Vector | 有序 | 允许重复 | 动态数组(线程安全) | 基本弃用,性能差 |
| Stack | 有序 | 允许重复 | 继承 Vector | LIFO 栈 |
| Set | 无序(HashSet)、有序(TreeSet) | 不允许重复 | 哈希表 / 红黑树 | 不允许重复元素 |
| HashSet | 无序 | 不允许重复 | HashMap(哈希表 + 链表 + 红黑树) | 允许 null,一个 null |
| LinkedHashSet | 插入顺序 | 不允许重复 | LinkedHashMap(哈希表 + 双向链表) | 维护插入顺序 |
| TreeSet | 有序(排序) | 不允许重复 | TreeMap(红黑树) | 可自定义比较器 |
| Queue | FIFO | 允许重复 | 数组 / 链表 / 堆 | 典型用作队列 |
| PriorityQueue(优先队列) | 按优先级排序 | 允许重复 | 最小堆(二叉堆,数组存储) | 非线程安全 |
| Deque(双端队列) | 双端队列 | 允许重复 | 数组 / 链表 | 可作栈或队列 |
| ArrayDeque | 双端队列 | 允许重复 | 循环数组 | 高效,不支持 null |
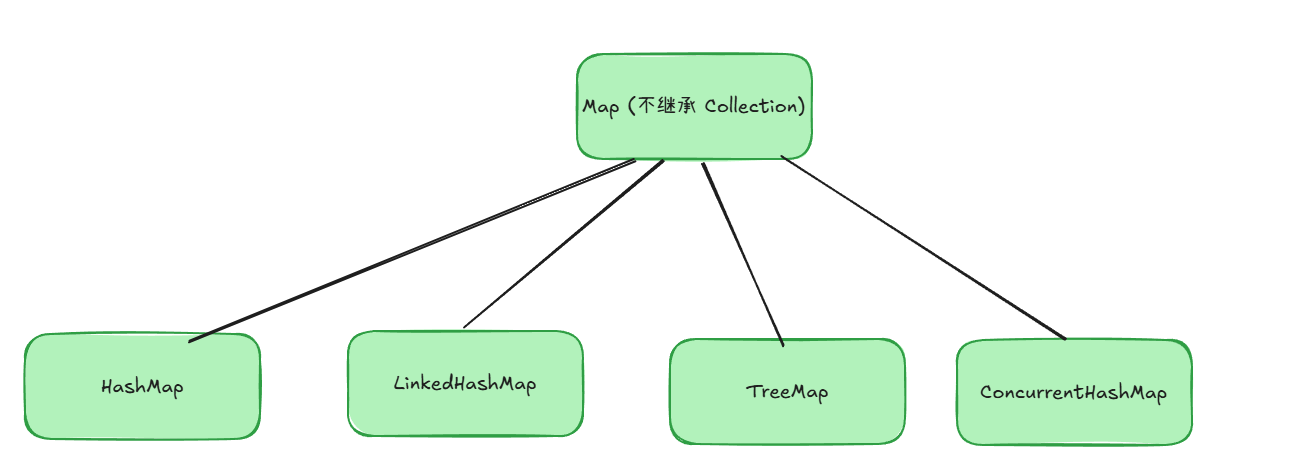
| 接口/类 | 是否有序 | 是否允许重复 | 底层数据结构 | 特点 |
|---|---|---|---|---|
| Map | key 无序(HashMap)、有序(TreeMap) | key 不重复,value 可重复 | 哈希表 / 红黑树 | Key-Value 映射 |
| HashMap | 无序 | key 不重复 | 哈希表 + 链表 + 红黑树(JDK 1.8+) | 默认 load factor=0.75 |
| LinkedHashMap | 插入顺序 | key 不重复 | 哈希表 + 双向链表 | 支持 LRU 缓存实现 |
| TreeMap | key 有序 | key 不重复 | 红黑树 | 按 key 排序 |
| ConcurrentHashMap | 无序 | key 不重复 | 分段锁(JDK 7)/ CAS + 红黑树(JDK 8) | 高并发 |
Collection接口是存储对象的集合类,属于存储单列元素,接下来挨个分析:
1. List接口:有序(顺序存储)、可重复、
- ArrayList:动态数组
- LikedList:双向链表
- Vector:动态数组+线程安全
2. Set接口:无序(随机存储)、不重复
- HashSet:
**HashMap**(哈希表 + 红黑树 + 链表),但仅用 键(Key)存储元素,值(Value)统一为静态空对象PRESENT。 - LinkeHashSet:双向循环链表+哈希表(拉链法)+维护插入顺序
- TreeSet:红黑树+有序
TreeSet是有序的,所以不能无脑说set集合无序,LinkedHashSet就利用了双向链表维护插入顺序。
反问?LinkedHashSet 的双向链表与哈希表的关系是什么?
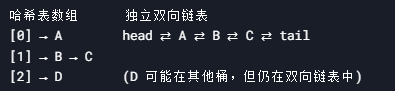
双向链表独立于哈希表的冲突链表,二者是平行共存的关系:
- 哈希表的链表:用于解决哈希冲突(JDK8 后可能转为红黑树),仅关注桶内元素存储
- 双向链表:全局维护所有元素的插入/访问顺序,与哈希冲突无关
这个双向链表是通过链接到全局链表尾部的,示意图如下:
额外的问题 1:
-
为什么需要额外双向链表? 哈希表的冲突链表无法维护全局顺序,双向链表通过
before/after指针实现顺序追踪。 -
哈希表扩容会影响双向链表吗? 不会。扩容仅重组哈希表桶结构,双向链表顺序保持不变。
-
遍历性能对比:
-
HashSet:遍历无序,依赖哈希表桶顺序(性能不稳定) -
LinkedHashSet:按双向链表顺序遍历(稳定 O(n))
// LinkedHashMap.Entry 继承 HashMap.Node,并扩展双向指针
static class Entry<K,V> extends HashMap.Node<K,V> {
Entry<K,V> before, after; // 独立的双向链表指针
Entry(int hash, K key, V value, Node<K,V> next) {
super(hash, key, value, next);
}
}
// 哈希表的桶结构(冲突处理)
Node<K,V>[] table; // 数组 + 链表/红黑树3. Queue:单向队列,FIFO,先进先出
- PriorityQueue:加入顺序按照元素大小排序
- Deque:双端队列
- LinkedList:这个是重复的,也可以作为队列使用(双向链表)
接下来讲一下Map接口:k-v结构,k部分无序不可重复(set集合),v部分
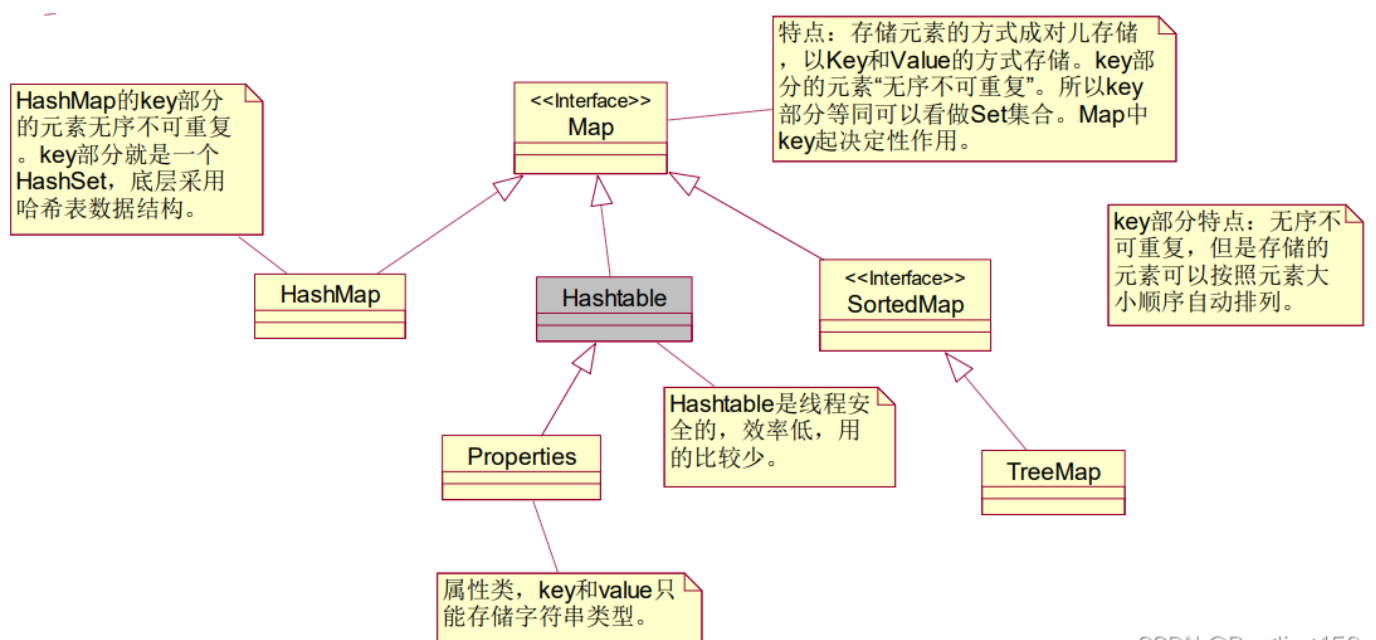
4. PS:(其他结构)基础数据结构都是哈希表+链表+红黑树
- HashMap:很经典了**(基础数据结构)**
- Hashtable:线程安全+k和v不 能为null
- TreeMap:(靠红黑树排序,可让 key实现 Comparable 接口或传 comparator。)
- LinkedHashMap:继承 hashmap+ 双链表指针,保留 k-v 查找和插入的顺序
- ConcurrentHashMap:多线程安全+k和v不能为null
- Collections.synchronizedMap:对普通 Map 方法的封装,可自定义 map 集合
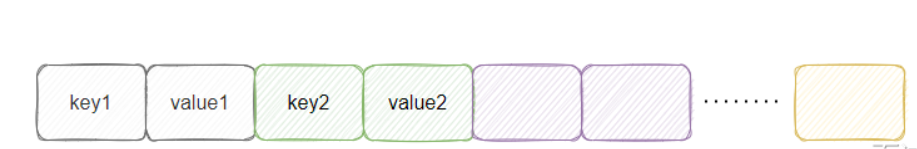
- IdentityHashMap:不使用 equal(),hashcode()方法,使用引用相等性和 System.IdentityHashCode()方法,允许 k 和 v 有 null 值,非线程安全,k-v 相邻存储。
- WeakHashMap :是 java 特殊的 Map 实现,使用弱引用为键,方便内存回收。适合 java 动态代理生成多个代理类,后续无法被回收;也适合 Event Listener 管理,可移除不再使用的监听器。
Hashtable只是单纯的在put()方法上加上synchronized。保证插入时阻塞其他线程的插入操作。虽然安全,但因为设计简单,所以性能低下。
ConcurrentHashMap:有CAS操作+在链表头加锁,性能有所提升
详细分析:
List 集合篇
List 接口包含 ArrayList、LinkList、Vector、Stack、CopyOnWriteArrayList
1、ArrayList 是基于动态数组实现的,特点与数组一样,随机访问 O(1),插入和删除慢 O(n)
2、LinkedList 是基于双链表实现的,遍历慢 O(n),插入和删除快 O(1)。分别实现了 List 接口和 Deque 接口(双向链表也可当队列)
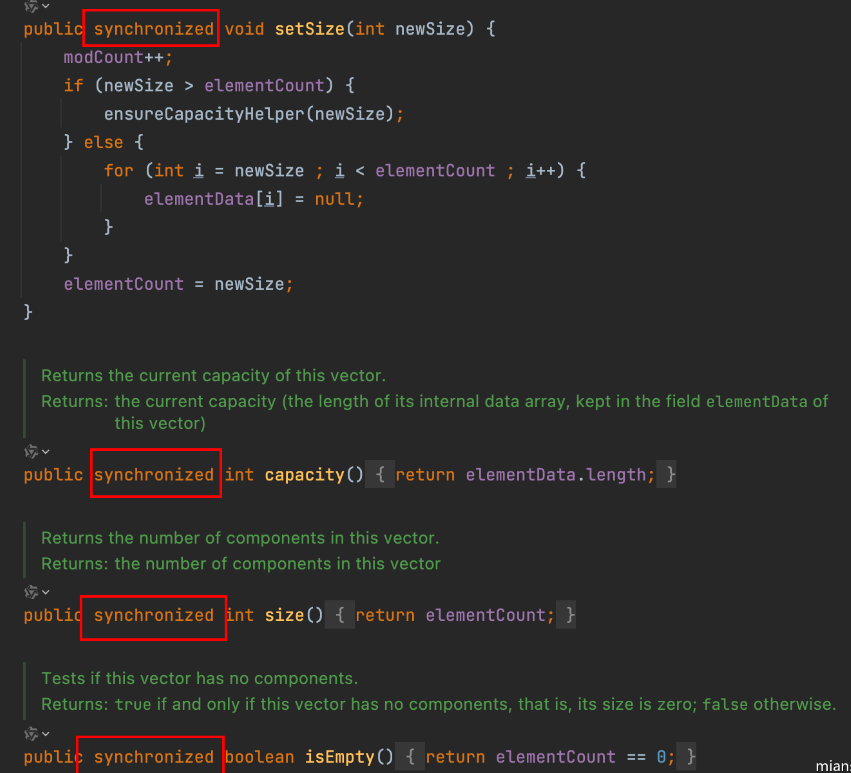
3、Vector 是基于动态数组+线程安全。方法前都加了 synchronized 锁,缺点就是加锁并发性差,性能低。如下图:
4、CopyOnWriteArrayList 是基于动态数组+写时复制。适合多线程读多写少的情况,写会复制新数组,反而增大开销。
详解:线程安全的 List,特点是写时复制。写时会创建并复制新数组,读操作不加锁,写操作加锁。这样读写不冲突,并发效率高。但是写时复杂度大,性能低。适合读多写少的场景,充分利用并发效率。
源码分析:
public class CopyOnWriteArrayList<E>
implements List<E>, RandomAccess, Cloneable, java.io.Serializable {
private transient volatile Object[] array;
//写操作
public boolean add(E e) {
final ReentrantLock lock = this.lock;
// 写时加锁,保证复制不出问题
lock.lock();
try {
Object[] elements = getArray();
int len = elements.length;
// 通过copyof方法复制
Object[] newElements = Arrays.copyOf(elements, len + 1);
newElements[len] = e;
setArray(newElements);
return true;
} finally {
lock.unlock();
}
}
//读操作,无锁机制
private E get(Object[] a, int index) {
return (E) a[index];
}
}具体读写的过程:**先读取当前数组,加锁复制数组,在副本上修改,使用新数组替换旧数组,无锁读新数组。**类比 Redis 中的写时复制 (异步 fork 进程全量复制 RDB 文件,中途修改用 AOF 增量追加)
5、Collection.synchronizedList 是封装方法,将任意 List 中访问方法(如 get,set,add,remove)加synchronized 锁。这样保证保证线程安全,但是 synchronized 简单,细粒度很高,读写都加锁,高并发下性能低。
6、 自定义 list:AbstractList。抽象类,实现 List 接口大部分方法,提供基本 List 功能,可自定义 List 集合
Q:ArrayList 扩容机制和步骤
默认 ArrayList 初始容量为 10,超过创建新数组,触发固定扩容机制 oldCapacity+(oldCapacity>>1),即扩容 1.5 倍,然后复制(Arrays.copyOf())值到新数组newCapacity中。
扩容过程源码:
//在add方法中,会先使用ensureCapacityInternal()判定增加元素+1是否会超过容量
public boolean add(E e) {
ensureCapacityInternal(size + 1); // Increments modCount!!
elementData[size++] = e;
return true;
}
//判定是否超过数组容量
private void ensureExplicitCapacity(int minCapacity) {
modCount++;
// overflow-conscious code if最小容量-当前数组长度>0,则启动grow方法,即扩容方法
if (minCapacity - elementData.length > 0)
grow(minCapacity);
}
//扩容方法
private void grow(int minCapacity) {
// overflow-conscious code
int oldCapacity = elementData.length;
// 扩容1.5倍
int newCapacity = oldCapacity + (oldCapacity >> 1);
// 容错机制
if (newCapacity - minCapacity < 0)
newCapacity = minCapacity;
// 容错机制,防止扩容超过数组最大值
if (newCapacity - MAX_ARRAY_SIZE > 0)
newCapacity = hugeCapacity(minCapacity);
// minCapacity is usually close to size, so this is a win: 使用copyOf方法复制值到新数组
elementData = Arrays.copyOf(elementData, newCapacity);
}
// 防溢出方法,
private static int hugeCapacity(int minCapacity) {
if (minCapacity < 0) // overflow
throw new OutOfMemoryError();
return (minCapacity > MAX_ARRAY_SIZE) ? //若超过,则控制下大小
Integer.MAX_VALUE :
MAX_ARRAY_SIZE;
}Q:ArrayList 和 LinkList 性能比较
在理论分析中,ArrayList 扩容机制和插入删除慢,LinkList 查找慢,结点内存大。
在实际过程中,增加,删除操作 ArrayList 比 LinkList 快几倍,遍历快将近百倍。ArrayList 在不追求链表的头尾的增删改操作,大可不必选择 LinkList
Map 集合
HashSet(Set 集合)与 HashMap(Map 集合)的区别?
HashSet 是基于 HashMap实现的集合类,K 值唯一不重复,V 值使用常量对象 PRESENT。本质上就是使用 HashMap中的 K 值,V 值不使用。
HashSet 源码:
// HashSet构造方法,本质是使用HashMap
public HashSet(){ map = new HashMap<>();}
// HashSet的add方法,v值就是PRESENT
public boolean add(E e){return map.put(e,PRESENT)==nuLl;}
//Dummy value to associate with an 0bject in the backing Map
//Dummy value 是虚值的意思,PRESENT仅仅是一个对象
private static final Object PRESENT = new Object();LinkedHashMap 是什么?
LinkedHashMap 继承于 HashMap,在父类上做了些扩展。内部使用双向链表记录 k-v 元素的访问,插入顺序。这样可以保存元素插入顺序、根据访问顺序使用最久未使用算法 LRU 移除元素。基本操作(get/put)的时间复杂度为 O(1)。
LinkedHashMap 通过这种巧妙的组合,在保持 HashMap 高效查找的同时,提供了有序性支持
实现源码:
HashMap 结构:
[数组] -> [链表/红黑树]
LinkedHashMap 额外结构:
head ↔ 节点1 ↔ 节点2 ↔ ... ↔ 节点N ↔ tail
//1、Entry数据结构
static class Entry<K,V> extends HashMap.Node<K,V> {
Entry<K,V> before, after; // +双向链表指针
Entry(int hash, K key, V value, Node<K,V> next) {
super(hash, key, value, next);
}
}
//2、然后内部构造函数设置 accessOrder=true,维护元素访问顺序维护
new LinkedHashMap<>(16, 0.75f, true) {
//3、重写put方法
///3.1、插入新节点后调用
void afterNodeInsertion(boolean evict) {
// 可能移除最老的节点(用于实现固定大小的缓存)
}
// 创建新节点时调用
Node<K,V> newNode(int hash, K key, V value, Node<K,V> e) {
// 创建特殊链表节点并链接到链表尾部
}
public V get(Object key) {
Node<K,V> e;
if ((e = getNode(hash(key), key)) == null)
return null;
if (accessOrder) // 如果按访问顺序排序
afterNodeAccess(e); // 将被访问节点移到链表尾部
return e.value;
}
// 实现 LRU 缓存、最大容量为100的LRU缓存
Map<String, Object> lruCache = new LinkedHashMap<>(16, 0.75f, true) {
@Override
protected boolean removeEldestEntry(Map.Entry eldest) {
return size() > 100;
}
};TreeMap 是什么?
TreeMap 是通过红黑树实现,基本操作为O(log n),**key 通过 Comparable 接口或自定义 comparator 传入函数,默认自然排序。k 不为 null,v 可为 null。****非线程安全。**可以用在加密字母排序上。
是按照String 的 compareTo 方法进行自然排序(a<b<c)
import java.util.Comparator;
import java.util.TreeMap;
public class TreeMapExample {
public static void main(String[] args) {
// 使用自然顺序
TreeMap<Integer, String> treeMap = new TreeMap<>();
treeMap.put(3, "Three");
treeMap.put(1, "One");
treeMap.put(2, "Two");
System.out.println("TreeMap: " + treeMap);
// 使用自定义比较器
TreeMap<Integer, String> reverseTreeMap = new TreeMap<>(Comparator.reverseOrder());
reverseTreeMap.put(3, "Three");
reverseTreeMap.put(1, "One");
reverseTreeMap.put(2, "Two");
System.out.println("Reverse TreeMap: " + reverseTreeMap);
// 获取子映射
System.out.println("SubMap (1, 3): " + treeMap.subMap(1, 3));
// 获取前缀映射
System.out.println("HeadMap (2): " + treeMap.headMap(2));
// 获取后缀映射
System.out.println("TailMap (2): " + treeMap.tailMap(2));
}
}IdentityHashMap 是什么?
是 Java 中 map 的一个实现,使用双等号(引用相等性==)作为键的比较方式。不用 equal()单等于比较键值。**一般用在对象身份区分(对象标识映射),相同内容不同对象的场景下(深度拷贝实现),**序列化/反序列化(保持对象引用关系),不适合存储可变对象。
区别对比:不使用 equal(),hashcode()方法,使用引用相等性和 System.IdentityHashCode()方法,允许 k 和 v 有 null 值,非线程安全。
源码分析:
//hash算法:1、使用 System.identityHashCode() 而非对象的 hashCode()
// 2、计算出的哈希码会经过二次处理
private static int hash(Object x, int length) {
int h = System.identityHashCode(x);
// 乘以一个魔数确保低位有足够的随机性
return ((h << 1) - (h << 8)) & (length - 1);
}
//put方法,重点在使用==判断,而不是equals()
public V put(K key, V value) {
final Object k = maskNull(key);
Object[] tab = table;
int len = tab.length;
int i = hash(k, len);
// 线性探测
while (true) {
Object item = tab[i];
if (item == null) {
// 找到空槽
modCount++;
tab[i] = k;
tab[i + 1] = value;
if (++size >= threshold)
resize(len); // 扩容
return null;
}
if (item == k) { // 引用相等判断
V oldValue = (V) tab[i + 1];
tab[i + 1] = value;
return oldValue;
}
i = nextKeyIndex(i, len); // 下一个位置
}
}
// 同put方法
public V get(Object key) {
Object k = maskNull(key);
Object[] tab = table;
int len = tab.length;
int i = hash(k, len);
while (true) {
Object item = tab[i];
if (item == k) // 引用相等判断
return (V) tab[i + 1];
if (item == null)
return null;
i = nextKeyIndex(i, len); // 线性探测
}
}还有就是存储方式是 k-v 相邻的存储方式(如下图),hashmap 是数组+红黑树的方式。
对比一下IdentityHashMap 和HashMap 的区别:
| 特性 | IdentityHashMap | HashMap |
|---|---|---|
| 键比较方式 | == | equals() |
| 哈希计算 | System.identityHashCode() | hashCode() |
| 冲突解决 | 线性探测 | 链表/红黑树 |
| 内存布局 | 键值相邻数组 | Node/KV对象 |
| 典型用途 | 对象拓扑保持 | 常规映射需求 |
集合中的一些机制
ConcurrentModificationException 什么时候会发生?
集合在多并发情况下,会出现多次修改的情况。类似 CAS 中的 ABA 问题使用版本号实现,这是 JUC 底层实现,但是在 API 高层用什么方法解决类似 ABA 问题呢?
在多并发集合中,会出现多次修改导致数据丢失的情况,怎么解决呢?
java 集合中解决一致性问题方法:**modCount**机制分析(Fail-Fast迭代器)
源码介绍:外部创建一个modCount 计数器,然后内部迭代器Iterator 记录expectedModCount。每次集合迭代发生修改会检查修改,即checkForComodification()方法。当modCount != expectedModCount,快速抛出异常。
// 以ArrayList为例
protected transient int modCount = 0;
public Iterator<E> iterator() {
return new Itr(); // 内部类Itr会记录expectedModCount
}
private class Itr implements Iterator<E> {
int expectedModCount = modCount;
public E next() {
checkForComodification(); // 检查修改
// ...
}
final void checkForComodification() {
if (modCount != expectedModCount)
throw new ConcurrentModificationException();
}
}特点
- 设计目的:检测并发修改,保证迭代过程的一致性
- 粒度:针对整个集合的结构性修改(add/remove等)
- 响应方式:快速失败(Fail-Fast),直接抛出异常
ConcurrentModificationException - 实现成本:只需维护一个整数计数器
CAS中的ABA问题解决方案
典型实现(版本号方案)
// AtomicStampedReference的实现
public class AtomicStampedReference<V> {
private static class Pair<T> {
final T reference;
final int stamp; // 版本号
// ...
}
public boolean compareAndSet(
V expectedReference,
V newReference,
int expectedStamp,
int newStamp) {
// 同时比较引用和版本号
}
}特点
- 设计目的:解决CAS操作中的ABA问题
- 粒度:针对单个变量的状态变化
- 响应方式:CAS失败后重试或执行备用逻辑
- 实现成本:需要为每个需要保护的对象维护版本号
关键差异对比
| 特性 | modCount机制 | ABA解决方案 |
|---|---|---|
| 应用场景 | 集合迭代的一致性 | 无锁编程中的状态更新 |
| 检测目标 | 结构性修改 | 中间状态变化 |
| 并发级别 | 乐观检测(事后检查) | 乐观锁(事前预防) |
| 解决方案 | 快速失败 | 版本控制+重试 |
| 开销 | 单个计数器 | 每个对象需要版本号 |
| 典型实现 | Java集合框架 | 原子类(AtomicStampedReference) |
虽然modCount和ABA解决方案都使用了类似"版本号"的概念,但它们是不同的设计模式:
- 不是相同机制:
modCount是单版本号的简单检查- ABA解决方案需要维护完整的状态历史
- 不同设计目标:
modCount保证迭代一致性- 版本号CAS解决状态完整性
- 不同应用层面:
modCount在集合API层面- ABA解决方案在底层并发原语层面
这两种机制展示了在不同抽象层次上解决并发问题的设计思路:高层API倾向于快速失败保证安全,底层原语则通过更复杂的状态管理来保证正确性。