
Java设计模式
比较好的文章:未在文章中表现
[TOC]
1、设计模式七大原则
单一职责原则: 每个类只负责自己的事情,而不是变成万能的
接口隔离原则:各个类建立自己的专用接口,而不是建立万能接口
依赖倒转原则:面向接口编程,而不是面向实现类
基本介绍:
高层模块不应该依赖低层模块,二者都应该依赖其抽象 抽象不应该依赖细节,细节(实现)应该依赖抽象 依赖倒转(倒置)的中心思想是面向接口编程 依赖倒转原则是基于这样的设计理念:相对于细节的多变性,抽象的东西要稳定的多。以抽象为基础搭建的架构比以细节为基础的架构要稳定的多。在java中,抽象指的是接口或抽象类,细节就是具体的实现类 使用接口或抽象类的目的是制定好规范,而不涉及任何具体的操作,把展现细节的任务交给他们的实现类去完成 总结: 我们使用依赖倒转原则的目的就是使用接口或者抽象类去定义规范。我们只需要依赖接口就行了。需要实现拓展的功能直接交给子类去完成,接口可以实现统一管理。如下:
里氏替换原则:继承父类而不去改变父类
TEXT1. 所有引用基类的地方必须能透明地使用其子类的对象。 2. 在使用继承时,遵循里氏替换原则,在子类中尽量不要重写父类的方法。 3. 里氏替换原则告诉我们,继承实际上让两个类耦合性增强了,在适当的情况下,可以通过聚合,组合,依赖 来解决问题。(策略模式)
开闭原则:拓展新类而不是修改旧类
- 开闭原则是编程中最基础、最重要的设计原则。
- 一个软件实体类,模块和函数应该对扩展开放(对提供方),对修改关闭(对使用方)。用抽象构建框架,用实现扩展细节。
- 当软件需要变化时,尽量通过扩展软件实体的行为来实现变化,而不是通过修改已有的代码来实现变化。
- 编程中遵循其它原则,以及使用设计模式的目的就是遵循开闭原则。
总结: 使用开闭原则,就是要灵活使用抽象类和接口。
迪米特法则:无需直接交互的两个类,如果需要交互,使用中间者
- 一个对象应该对其他对象保持最少的了解。
- 类与类关系越密切,耦合度越大。
- 迪米特法则又叫最少知道原则,即一个类对自己依赖的类知道的越少越好。也就是说,对于被依赖的类不管多么复杂,都尽量将逻辑封装在类的内部。对外除了提供的public方法,不对外泄露任何信息。
- 迪米特法则还有一个更简单的定义: 只与直接的朋友通信。
- 直接的朋友: 每个对象都会与其他对象有耦合关系,只要两个对象之间有耦合关系,我们就说这两个对象之间是朋友关系。耦合的方式很多,依赖,关联,组合,聚合等。其中,我们称出现在成员变量,方法参数,方法返回值中的类为直接的朋友,而出现在局部变量中的类不是直接的朋友。也就是说,陌生的类最好不要以局部变量的形式出现在类的内部。
总结: 如何很好的实现迪米特法则,把握核心点。
类的直接朋友:出现在成员变量、方法参数、方法返回值中的类。 类的非直接朋友:出现在局部变量中的类。 因此,迪米特法则就是要优化类的非直接朋友,一个类里面最好就是只有直接朋友,而没有非直接朋友,所以,遵守迪米特法则,直接将非直接朋友进行优化即可。
合成复用原则:优先组合,其次继承
2、UML图画法
参考:
可见性:
- +public
-
-private
-
#protected
表示方式:
- 属性:可见性 名称:类型[=默认值]
- 方法:可见性 名称(参数)[:返回类型]
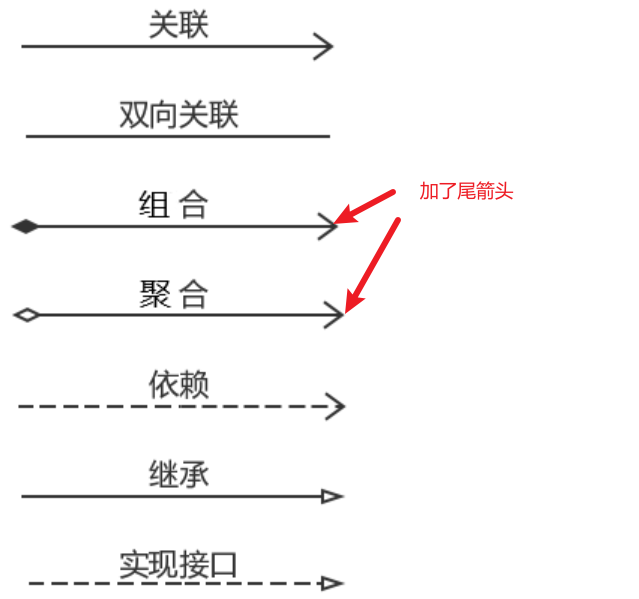
关系:
- 关联关系:实线,引用关系,类属性里有另一个类
- 聚合关系:空心菱形,表示整体和部分,类属性是另一个类的集合
- 组合关系:实心菱形,强烈聚合关系,类属性是另一个类,控制它的存在
- 依赖关系:虚线,类方法参数里有另一个类,(耦合度最低)
- 继承(泛化)关系:空心实线三角,泛化关系,表示一般与特殊,(耦合度最高)
- 实现接口关系:空心虚线三角,接口和实现类关系
主要是画类图
网上的类图知识点在小细节上奇奇怪怪,如: 数据类型:名称
名称:数据类型
==选后者==
在聚集中有组合和聚合
其中聚合是非同生共死
组合是同生共死
所以组合的实心的菱形,聚合的空心的菱形
但是很多网上教程教出来,屁股后面加尾箭头,还是以《软件工程》第六版为主,==不加,别记混了==
3、设计模式的分类
设计模式分为3种类型,共23种
1)创建型模式:
==4.1单例模式==
4.2抽象工厂模式
4.3原型模式
4.4建造者模式
==4.2工厂模式==
2)结构型模式:
5.1适配器模式
桥接模式
==装饰模式==
组合模式
外观模式
享元模式
==5.2代理模式==
3)行为型模式:
模版方法模式
命令模式
访问者模式
迭代器模式
==观察者模式==
中介者模式
备忘录模式
解释器模式(Interpreter模式)
状态模式
策略模式
职责链模式(责任链模式)
注意:不同的书籍上对分类和名称略有差别
4.1、单例模式
https://blog.csdn.net/weixin_41949328/article/details/107296517
面试官问什么是单例模式时,千万不要答非所问,给出单例模式有两种类型之类的回答,要围绕单例模式的定义去展开。
单例模式是指在内存中只会创建且仅创建一次对象的设计模式。在程序中多次使用同一个对象且作用相同时,为了防止频繁地创建对象使得内存飙升,单例模式可以让程序仅在内存中创建一个对象,让所有需要调用的地方都共享这一单例对象。
4.1.1. 单例模式的类型
单例模式有两种类型:
- 懒汉式:在真正需要使用对象时才去创建该单例类对象
- 饿汉式:在类加载时已经创建好该单例对象,等待被程序使用
懒汉式创建单例对象
懒汉式创建对象的方法是在程序使用对象前,先判断该对象是否已经实例化**(判空),**若已实例化直接返回该类对象。,否则则先执行实例化操作。
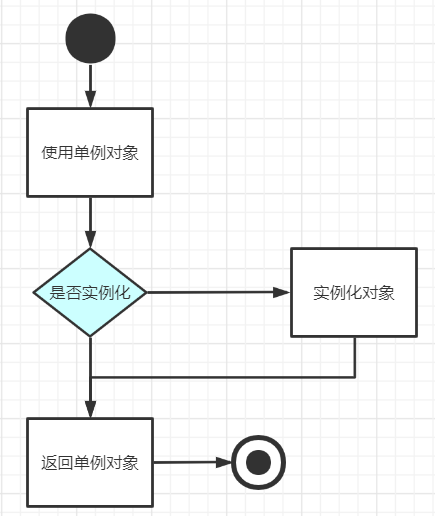
单例模式中懒汉式有2大问题:
①根据其定义:根据需求,要的时候来创建,那么多线程同时创建这个对象,会出现线程安全问题
②在JVM中,创建对象有3小步**,a)先分配空间,b)再初始化,c)最后指向地址;后2步不是严格顺序执行的。所以if(singleton == null)的过程中,线程A执行a—>c,没有初始化对象,但线程B执行if(singleton == null)发现singleton已经有地址了,去使用singleton对象。但是机器并没有初始化singleton对象,会报错NPE**。
解决方法:
①线程安全:加锁——>导致并发性差。使用double check和lock
public static Singleton getInstance() {
if (singleton == null) { // 线程A和线程B同时看到singleton = null,如果不为null,则直接返回singleton
synchronized(Singleton.class) { // 线程A或线程B获得该锁进行初始化
if (singleton == null) { // 其中一个线程进入该分支,另外一个线程则不会进入该分支
singleton = new Singleton();
}
}
}
return singleton;
}
}上面的代码已经完美地解决了并发安全+性能低效问题:
- 第2行代码,如果singleton不为空,则直接返回对象,不需要获取锁;而如果多个线程发现singleton为空,则进入分支;
- 第3行代码,多个线程尝试争抢同一个锁,只有一个线程争抢成功,第一个获取到锁的线程会再次判断singleton是否为空,因为singleton有可能已经被之前的线程实例化
- 其它之后获取到锁的线程在执行到第4行校验代码,发现singleton已经不为空了,则不会再new一个对象,直接返回对象即可
- 之后所有进入该方法的线程都不会去获取锁,在第一次判断singleton对象时已经不为空了
使用两次if,达到**Double Check(双重校验) **的目的
使用synchronized加上锁
②JVM创建对象顺序错乱:使用volatile防止指令重排
public class Singleton {
private static volatile Singleton singleton;//volatile是保证创建对象是线性执行
private Singleton(){}//无参构造方法
public static Singleton getInstance() {
if (singleton == null) { // 线程A和线程B同时看到singleton = null,如果不为null,则直接返回singleton
synchronized(Singleton.class) { // 线程A或线程B获得该锁进行初始化
if (singleton == null) { // 其中一个线程进入该分支,另外一个线程则不会进入该分支
singleton = new Singleton();
}
}
}
return singleton;
}
}①使用volatile防止指令重排
创建一个对象,在JVM中会经过三步:
(1)为singleton分配内存空间
(2)初始化singleton对象
(3)将singleton指向分配好的内存空间
指令重排序是指:JVM在保证最终结果正确的情况下,可以不按照程序编码的顺序执行语句,尽可能提高程序的性能
在这三步中,第2、3步有可能会发生指令重排现象,创建对象的顺序变为1-3-2,会导致多个线程获取对象时,有可能线程A创建对象的过程中,执行了1、3步骤,线程B判断singleton已经不为空,获取到未初始化的singleton对象,就会报NPE异常。
使用volatile关键字可以防止指令重排序,其原理较为复杂,可以这样理解:使用volatile关键字修饰的变量,可以保证其指令执行的顺序与程序指明的顺序一致,不会发生顺序变换,这样在多线程环境下就不会发生NPE异常了。
volatile还有第二个作用:使用volatile关键字修饰的变量,可以保证其内存可见性,即每一时刻线程读取到该变量的值都是内存中最新的那个值,线程每次操作该变量都需要先读取该变量。
饿汉式创建单例对象
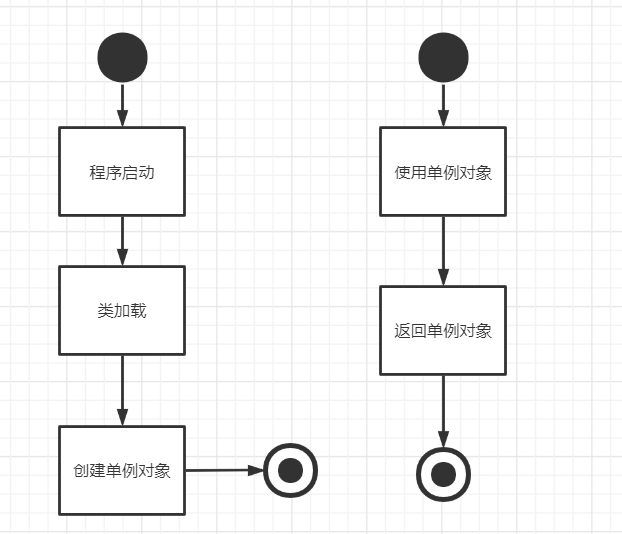
饿汉式在类加载时已经创建好该对象,在程序调用时直接返回该单例对象即可,即我们在编码时就已经指明了要马上创建这个对象,不需要等到被调用时再去创建。
关于类加载,涉及到JVM的内容,我们目前可以简单认为在程序启动时,这个单例对象就已经创建好了。
public class Singleton{
private static final Singleton singleton = new Singleton();//实例化对象
private Singleton(){}
public static Singleton getInstance() {
return singleton;
}
}类在加载时会在堆内存中创建一个Singleton对象,当类被卸载时,Singleton对象也随之消亡了。
破坏懒汉式、饿汉式:
但是就算就这样还有两个问题:
不防反射,可以利用反射,
强制访问类的私有构造器,去创建另一个对象
使用序列化和反序列化会破坏单例模式
如:IO流中,先把对象输出,在读该对象,使用readObject()方法会重新创建对象,必然产生了新地址
使用枚举实现
public enum Singleton {
INSTANCE;
public void doSomething() {
System.out.println("这是枚举类型的单例模式!");
}
}需要思考:使用枚举实现单例模式的优势在哪里?
我们从最直观的地方入手,第一眼看到这几行代码,就会感觉到“少”,没错,就是少,虽然这优势有些牵强,但写的代码越少,越不容易出错。
**优势1:**代码对比饿汉式与懒汉式来说,更加地简洁
其次,既然是实现单例模式,那这种写法必定满足单例模式的要求,而且使用枚举实现时,没有做任何额外的处理。
**优势2:**它不需要做任何额外的操作去保证对象单一性与线程安全性
我们可以简单地理解枚举实现单例的过程:在程序启动时,会调用Singleton的空参构造器,实例化好一个Singleton对象赋给INSTANCE,之后再也不会实例化
4.2 、工厂模式
参考文章:
https://blog.csdn.net/weixin_45203607/article/details/120237989
在工厂模式中,我们在创建对象时不会对客户端暴露创建逻辑,并且是通过使用一个共同的接口来指向新创建的对象。
实例: 1、您需要一辆奥迪汽车,可以直接从奥迪工厂里面提货,而不用去管这辆奥迪汽车是怎么做出来的,以及这个汽车里面的具体实现。
优点:
1、一个调用者想创建一个对象,只要知道其名称就可以了。
2、扩展性高,如果想增加一个新的产品,只要扩展一个新工厂类就可以。
3、屏蔽产品的具体实现,调用者只关心产品的接口。
缺点: 每次增加一个产品时,都需要增加一个具体类和对象实现工厂,使得系统中类的个数成倍增加,在一定程度上增加了系统的复杂度,同时也增加了系统具体类的依赖。这并不是什么好事。
注意事项: 在任何需要生成复杂对象的地方,都可以使用工厂方法模式。有一点需要注意的地方就是复杂对象适合使用工厂模式,而简单对象,特别是只需要通过 new 几次对象就不用了, 这种情况,无需使用工厂模式。如果使用工厂模式,就需要引入一个工厂类,会增加系统的复杂度。
一共有3种方法,也有书上有2种方法,认为简单工厂模式为普通工厂方法的特例
简单工厂模式:将一个工厂作为入口,将多个对象的创建和使用分离,根据传入的参数不同来创建并返回不同类型的对象实例
Java// 产品接口 public interface Product { void use(); } // 具体产品A public class ConcreteProductA implements Product { @Override public void use() { System.out.println("Using ConcreteProductA"); } } // 具体产品B public class ConcreteProductB implements Product { @Override public void use() { System.out.println("Using ConcreteProductB"); } } // 简单工厂类,其实就根据参数的不同选择创建不同的类 public class SimpleFactory { public static Product createProduct(String type) { switch (type) { case "A": return new ConcreteProductA(); case "B": return new ConcreteProductB(); default: throw new IllegalArgumentException("Unknown product type"); } } } // 客户端代码 public class Client { public static void main(String[] args) { Product productA = SimpleFactory.createProduct("A"); productA.use(); // Output: Using ConcreteProductA Product productB = SimpleFactory.createProduct("B"); productB.use(); // Output: Using ConcreteProductB } }优点:将创建具体的子类放在工厂类中,方便管理和维护,不用维护底层产品的代码
缺点:如果产品类复杂,工厂类判断创建产品类也复杂,不符合单一职责原则。而且产品类的增删改查,需要修改工厂类。不符合开闭原则。
4.2.1 普通工厂方法
定义:定义一个创建对象的接口,但让实现这个接口的类来决定实例化哪个类,工厂方法让类的实例化推迟到子类中进行,而不是和简单工厂将创建的实现
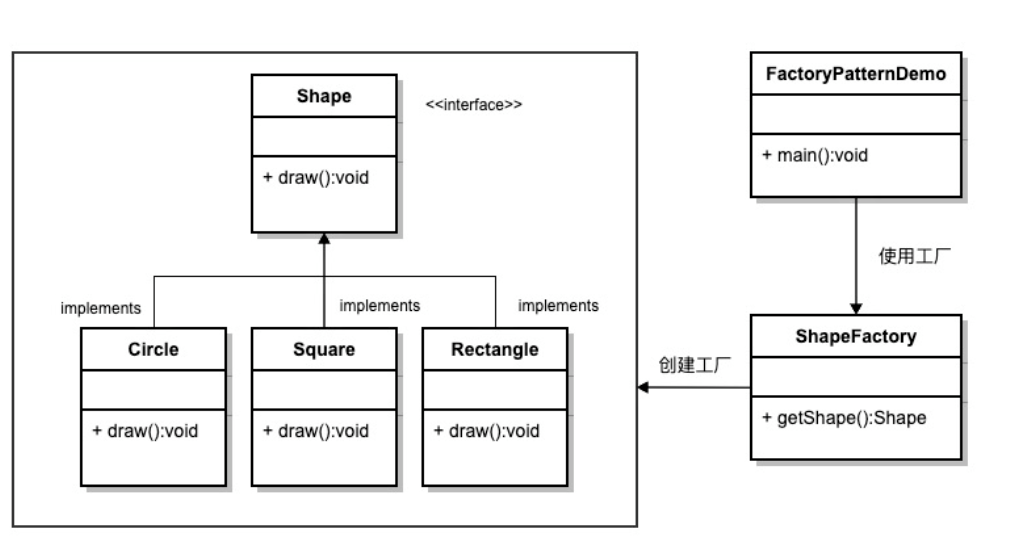
我们将创建一个 Shape 接口和实现 Shape 接口的实体类。下一步是定义工厂类 ShapeFactory。
然后使用FactoryPatternDemo类,来访问 ShapeFactory 来获取 Shape 对象。 以便获取它所需对象的类型。
public interface Shape{
void draw();
}实现类Circle
public class Circle implements Shape{
@Override
public void draw(){
System.out.print("形状工厂里面执行画‘Circle’的方法");
}
}实现类Square
public class Square implements Shape{
@Override
public void draw(){
System.out.print("形状工厂里面执行画‘Square’的方法")
}
}实现类Rectangle
public class Rectangle implements Shape{
@Overrdie
public void draw(){
Sysetem.out.print("形状工厂里面执行画‘Square’的方法");
}
}工厂类ShapeFactory汇总接口
public class ShapeFactory{
//返回值类型为Shape,自定义方法名称getShape,传入参数shapeType
public static Shape getShape(String shapeType){
//如果传入参数为空,
if(shapeType == null == shapeType.trim().equals(""))
return null;
//传入可以使用的名称
if(shapeType.equalsIgnoreCase("CIRCLE")){
return new Circle();
}else if(shapeType.equalsIgnoreCase("Square")){
return new Rectangle();
}else if(shapeType.equalsIgnoreCase("Rectangle")){
return new Square();
}
return null;
}
}外部客户类调用工厂的方法
public class FactoryPatternDemo{
public static void main(String[] args){
//使用工厂类方法,获取Shape引用类型的对象,并且调用其draw方法
Shape shape1 = ShapeFactory.getShape("CIRCLE");
//这里是隐藏了new Circle,因为在工厂类做好了。
shape1.draw();
//使用工厂类方法,获取Shape引用类型的对象,并且调用其draw方法
Shape shape2 = ShapeFactory.getShape("Square");
shape2.draw();
//使用工厂类方法,获取Shape引用类型的对象,并且调用其draw方法
Shape shape3 = ShapeFactory.getShape("Rectangle");
shape3.draw();
}
}
形状工厂里面执行画‘Circle’的方法
形状工厂里面执行画‘Square’的方法
形状工厂里面执行画‘Square’的方法适用场景:
工厂类负责创建的对象较少。 客户端只需要传入工厂类的参数,对于如何创建的对象的逻辑不需要关心。 优点:
只需要传入一个正确的参数,就可以获取你所需要的对象,无须知道创建的细节。 缺点:
工厂类的职责相对过重,增加新的产品类型的时需要修改工厂类的判断逻辑,违背了开闭原则。 不易于扩展过于复杂的产品结构。
4.2.2 抽象工厂
从上面案例中我们可以发现 工厂模式是 挺好用的 但是会暴露一个问题就是 随着业务的增多 那么工厂也对应增多 造成了难以管理
如何解决这个问题呢 ? 可以使用 抽象工厂来管理所有的工厂
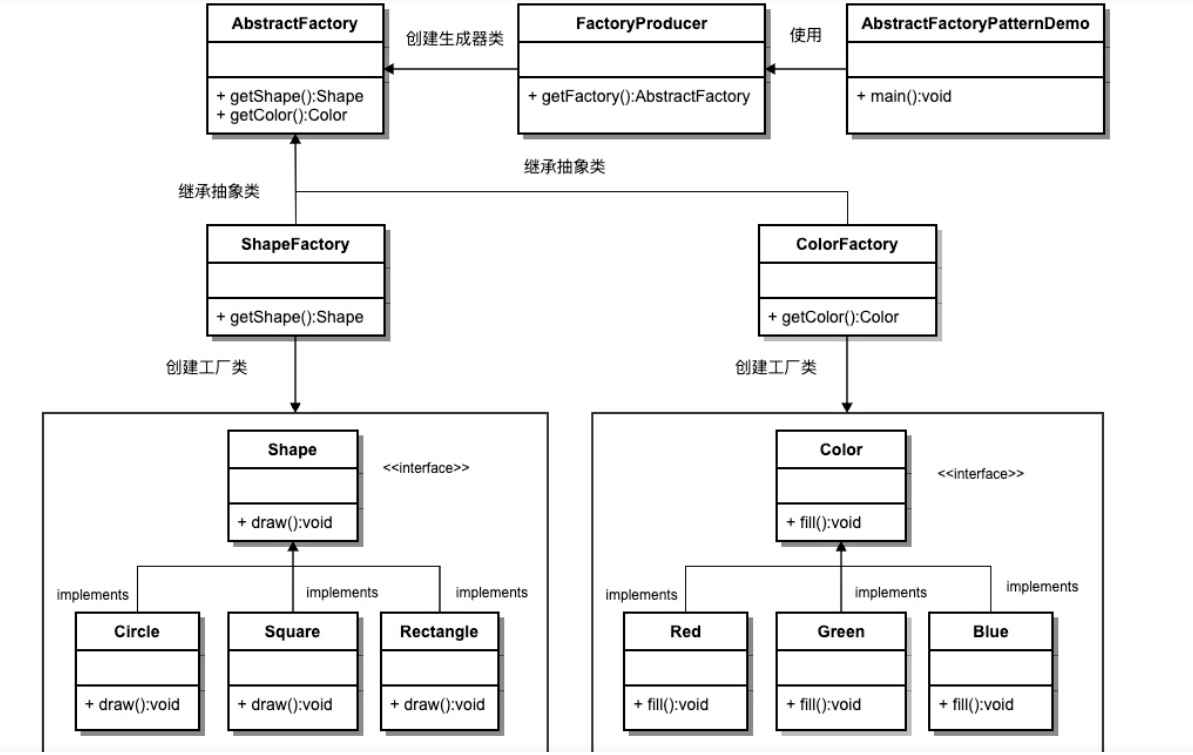
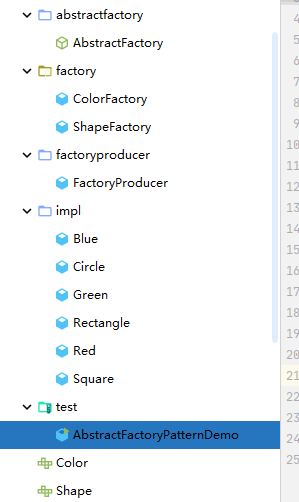
抽象工厂AbstractFactory
public abstract class AbstractFactory {
public abstract Color getColor(String color);
public abstract Shape getShape(String shape) ;
}形状工厂
接口Shape
public interface Shape {
void draw();
}实现类 Circle
public class Circle implements Shape {
@Override
public void draw() {
System.out.println("Inside Circle::draw() method.");
}
}
实现类Rectangle
public class Rectangle implements Shape {
@Override
public void draw() {
System.out.println("Inside Rectangle::draw() method.");
}
}
实现类 Square
public class Square implements Shape {
@Override
public void draw() {
System.out.println("Inside Square::draw() method.");
}
}
工厂 ShapeFactory
public class ShapeFactory extends AbstractFactory {
//使用 getShape 方法获取形状类型的对象
@Override
public Shape getShape(String shapeType){
//如果传入的字符串为空
if(shapeType == null||shapeType.trim().equals("")){
return null;
}
// 更具 传进来的 名称 来获取 对应的对象
if(shapeType.equalsIgnoreCase("CIRCLE")){
return new Circle();
} else if(shapeType.equalsIgnoreCase("RECTANGLE")){
return new Rectangle();
} else if(shapeType.equalsIgnoreCase("SQUARE")){
return new Square();
}
return null;
}
@Override
public Color getColor(String color) {
return null;
}
}颜色工厂
接口Color
public interface Color {
void fill();
}实现类Red
public class Red implements Color {
@Override
public void fill() {
System.out.println("Inside Red::fill() method.");
}
}实现类Green
//绿色
public class Green implements Color {
@Override
public void fill() {
System.out.println("Inside Green::fill() method.");
}
}实现类Blue
public class Blue implements Color {
@Override
public void fill() {
System.out.println("Inside Blue::fill() method.");
}
}工厂ColorFactory
public class ColorFactory extends AbstractFactory {
@Override
public Color getColor(String color) {
if(color == null||color.trim().equals("")){
return null;
}
if(color.equalsIgnoreCase("RED")){
return new Red();
} else if(color.equalsIgnoreCase("GREEN")){
return new Green();
} else if(color.equalsIgnoreCase("BLUE")){
return new Blue();
}
return null;
}
@Override
public Shape getShape(String shape) {
return null;
}
}生产工厂类 FactoryProducer
public class FactoryProducer {
public static AbstractFactory getFactory(String choice){
if(choice.equalsIgnoreCase("SHAPE")){
return new ShapeFactory();
} else if(choice.equalsIgnoreCase("COLOR")){
return new ColorFactory();
}
return null;
}
}测试AbstractFactoryPatternDemo
public class AbstractFactoryPatternDemo {
public static void main(String[] args) {
//获取形状工厂
AbstractFactory shapeFactory = FactoryProducer.getFactory("SHAPE");
//获取形状为 Circle 的对象
Shape shape1 = shapeFactory.getShape("CIRCLE");
//调用 Circle 的 draw 方法
shape1.draw();
//获取颜色工厂
AbstractFactory colorFactory = FactoryProducer.getFactory("COLOR");
//获取颜色为 Blue 的对象
Color color1 = colorFactory.getColor("BLUE");
//调用 Blue 的 fill 方法
color1.fill();
}
}
Inside Circle::draw() method. Inside Blue::fill() method.
适用场景:
客户端(应用层)不依赖于产品类实例如何被创建和实现等细节。 强调一系列相关的产品对象(属于同一产品族)一起使用创建对象需要大量重复的代码。 提供一个产品类的库,所有的产品以同样的接口出现,从而使客户端不依赖于具体实现。 优点:
当一个产品族中的多个对象被设计成一起工作时,它能保证客户端始终只使用同一个产品族中的对象。 缺点:
当产品族中需要增加一个新的产品时,所有的工厂类都需要进行修改。
4.2.3 源码应用
工厂模式在JDK-Calendar 应用的源码分析
4.3、原型模式(Prototype Pattern)
参考文章:
https://blog.csdn.net/weixin_45692705/article/details/121647915
https://blog.csdn.net/pyy542718473/article/details/127248128
模式简介 原型模式(Prototype Pattern)是用于创建重复的对象,同时又能保证性能。这种类型的设计模式属于创建型模式,它提供了一种创建对象的最佳方式。
在软件系统中,有时候需要多次创建某一类型的对象,为了简化创建过程,可以只创建一个对象,然后再通过克隆的方式复制出多个相同的对象,这就是原型模式的设计思想。
原型模式的基本工作原理是通过将一个原型对象传给那个要发动创建的对象,这个要发动创建的对象通过请求原型对象复制原型自己来实现创建过程。
模式结构 原型模式包含如下角色 👇
1.Prototype(抽象原型类) 抽象原型类是定义具有克隆自己的方法的接口,是所有具体原型类的公共父类,可以是抽象类,也可以是接口。
2.ConcretePrototype(具体原型类) 具体原型类实现具体的克隆方法,在克隆方法中返回自己的一个克隆对象。
3.Client(客户类) 客户类让一个原型克隆自身,从而创建一个新的对象。在客户类中只需要直接实例化或通过工厂方法等方式创建一个对象,再通过调用该对象的克隆方法复制得到多个相同的对象。
==原型模式的克隆分为浅克隆和深克隆。==
浅克隆:两个引用对象地址地址是相同的,相当于复制了地址,所以修改容易一个属性,会一起改变
深克隆:创建新对象,地址是新地址
1、浅克隆概念:
是指创建一个新对象,该对象的字段与原始对象相同,但字段引用的对象仍然是原始对象引用的对象。简而言之,浅克隆只复制了对象的字段值,而没有复制字段引用所指向的对象。
对于基本数据类型和String类型的数据,直接赋值一份给新的对象,但是对于其他类型的属性,仅仅是复制一份引用给新的对象,所以原始兑现和新的对象中的非基本数据类型的属性指向的是同一个对象。 两个对象在有非基本数据类型和String类型之外的类型的属性时,是无法完全独立的。
在 Java 中,可以通过实现 Cloneable 接口,并重写 clone() 方法来实现浅克隆。Object 类中的 clone() 方法会创建新的对象,并将原始对象的字段值复制到新对象中,包括基本类型和对其他对象的引用。这意味着克隆对象的字段引用与原始对象的字段引用指向相同的对象。
以下是一个浅克隆的示例:
@Data
public class Clazz implements Cloneable {
private String name;
private Student student;
@Override
protected Object clone() throws CloneNotSupportedException {
return super.clone();
}
}
@Data
@AllArgsConstructor
@NoArgsConstructor
public class Student implements Serializable {
private String name;
private String sex;
private Integer age;
}
public static void main(String[] args) throws Exception{
Clazz clazz1 = new Clazz();
clazz1.setName("高三一班");
Student stu1 = new Student("张三", "男", 18);
clazz1.setStudent(stu1);
System.out.println(clazz1); // Clazz(name=高三一班, student=Student(name=张三, sex=男, age=18))
Clazz clazz2 = (Clazz)clazz1.clone();
Student stu2 = clazz2.getStudent();
stu2.setName("李四");
System.out.println(clazz1); // Clazz(name=高三一班, student=Student(name=李四, sex=男, age=18))
System.out.println(clazz2); // Clazz(name=高三一班, student=Student(name=李四, sex=男, age=18))
}可以看到,当修改了stu2的姓名时,stu1的姓名同样也被修改了,这说明stu1和stu2是同一个对象,这就是浅克隆的特点,对具体原型类中的引用类型的属性进行引用的复制。同时,这也可能是浅克隆所带来的弊端,因为结合该例子的原意,显然是想在班级中新增一名叫李四的学生,而非让所有的学生都改名叫李四,于是我们这里就要使用深克隆。
2、深克隆(Deep cloning)
是指创建一个新对象,该对象的字段值与原始对象相同,但对于字段引用的对象,新对象和原始对象都引用了不同的对象。
实现deep cloning 有两种方法,一个是实现cloneable,完全重写clone;二是利用序列化和反序列化
一:是实现cloneable,完全重写clone
在 Java 中,可以通过实现 Cloneable 接口,并重写 clone() 方法来实现深克隆。与浅克隆不同,深克隆需要递归地克隆所有字段引用对象,以确保拷贝对象和原始对象之间没有共享引用关系。
class Person implements Cloneable {
private String name;
private Address address;
public Person(String name, Address address) {
this.name = name;
this.address = address;
}
public String getName() {
return name;
}
public Address getAddress() {
return address;
}
public void setName(String name) {
this.name = name;
}
public void setAddress(Address address) {
this.address = address;
}
@Override
//递归的把属性克隆
//如果是浅克隆那就直接: return super.clone();不用把所有属性递归克隆
protected Object clone() throws CloneNotSupportedException {
Person cloned = (Person) super.clone();
cloned.address = (Address) address.clone();
return cloned;
}
}
class Address implements Cloneable {
private String city;
public Address(String city) {
this.city = city;
}
public String getCity() {
return city;
}
public void setCity(String city) {
this.city = city;
}
@Override
protected Object clone() throws CloneNotSupportedException {
return super.clone();
}
}
public class Main {
public static void main(String[] args) throws CloneNotSupportedException {
Address address = new Address("London");
Person person1 = new Person("Alice", address);
Person person2 = (Person) person1.clone();
System.out.println(person1.getName()); // Alice
System.out.println(person1.getAddress().getCity()); // London
System.out.println(person2.getName()); // Alice
System.out.println(person2.getAddress().getCity()); // London
person2.setName("Bob");
person2.getAddress().setCity("New York");
System.out.println(person1.getName()); // Alice
System.out.println(person1.getAddress().getCity()); // London
System.out.println(person2.getName()); // Bob
System.out.println(person2.getAddress().getCity()); // New York
}
}二:是利用序列化和反序列化
@Data
public class Clazz implements Cloneable, Serializable {
private String name;
private Student student;
@Override
protected Object clone() throws CloneNotSupportedException {
return super.clone();
}
protected Object deepClone() throws IOException, ClassNotFoundException {
//先把对象以对象流的方式输出
ByteArrayOutputStream bos = new ByteArrayOutputStream();
ObjectOutputStream oos = new ObjectOutputStream(bos);
oos.writeObject(this);//序列化
//在以对象流输入,这样一起进出
ByteArrayInputStream bis = new ByteArrayInputStream(bos.toByteArray());
ObjectInputStream ois = new ObjectInputStream(bis);
return ois.readObject();//反序列化
}
}
public static void main(String[] args) throws Exception{
Clazz clazz1 = new Clazz();
clazz1.setName("高三一班");
Student stu1 = new Student("张三", "男", 18);
clazz1.setStudent(stu1);
Clazz clazz3 = (Clazz)clazz1.deepClone();
Student stu3 = clazz3.getStudent();
stu3.setName("王五");
System.out.println(clazz1); // Clazz(name=高三一班, student=Student(name=张三, sex=男, age=18))
System.out.println(clazz3); // Clazz(name=高三一班, student=Student(name=王五, sex=男, age=18))
}可以看到,当修改了stu3的姓名时,stu1的姓名并没有被修改了,这说明stu3和stu1已经是不同的对象了,说明Clazz中的Student也被克隆了,不再指向原有对象地址,这就是深克隆。这里需要注意的是,Clazz类和Student类都需要实现Serializable接口,否则会抛出NotSerializableException异常。
3、浅克隆和深克隆的区别
浅克隆(Shallow cloning)和深克隆(Deep cloning)是两种不同的对象克隆机制,它们在复制对象时处理字段引用的方式不同。下面
是它们的区别:
1.复制的程度: 浅克隆:创建一个新对象,该对象的字段与原始对象相同,但字段引用的对象仍然是原始对象引用的对象。换句话说,只复制了对象的字
段值,而没有复制字段引用所指向的对象。
深克隆:创建一个新对象,该对象的字段值与原始对象相同,但对于字段引用的对象,新对象和原始对象都引用了不同的对象。换句话
说,递归地复制了所有字段引用所指向的对象。
2.对象关联性:
浅克隆:克隆对象与原始对象共享对同一引用对象的引用,即字段引用的对象是相同的。
深克隆:克隆对象与原始对象拥有对不同引用对象的引用,即字段引用的对象是不同的。
3.性能:
浅克隆:由于只复制了对象的字段值,所以浅克隆的性能较好,时间和资源开销较小。
深克隆:由于递归地复制了所有字段引用所指向的对象,所以深克隆的性能较差,时间和资源开销较大。
4.实现方式:
浅克隆:可以通过实现 Cloneable 接口,并重写 clone() 方法来实现浅克隆。
深克隆:需要在实现 Cloneable 接口,并重写 clone() 方法时,递归地对所有字段引用对象进行克隆。或者利用序列化和反序列化
需要根据具体的应用场景来选择使用浅克隆还是深克隆。如果对象中的字段引用对象不包含可变状态,或者对共享状态并不关注变化,那
么可以使用浅克隆。而如果字段引用对象包含可变状态,并且对拷贝对象和原始对象之间的变化敏感,那么必须使用深克隆来确保复制的
对象是完全独立的。
4、总结
适用场景:
类初始化消耗资源较多。 new产生的一个对象需要非常繁琐的过程(数据准备、访问权限等)。 构造函数比较复杂。 循环体中生产大量对象时。 优点:
性能优良,Java自带的原型模式是基于内存二进制流的拷贝,比直接new一个对象性能上提升了许多。 可以使用深克隆方式保存对象的状态,使用原型模式将对象复制一份并将其状态保存起来,简化了创建的过程。 缺点:
必须配备克隆(或者可拷贝)方法。 当对已有类进行改造的时候,需要修改代码,违反了开闭原则。 深克隆、浅克隆需要运用得当。
4.4、建造者模型
参考文章:
这个github文章更贴近需求,但是我看不懂一些高级写法
https://blog.csdn.net/pyy542718473/article/details/127248128
建造者模式是将一个复杂对象的构建与它的表示分离,使得同样的构建过程可以创建不同的表示。用户只需指定需要建造的类型就可以获得对象,建造过程及细节不需要了解。
建造者(Builder)模式包含如下角色:
抽象建造者类(Builder):这个接口规定要实现复杂对象的那些部分的创建,并不涉及具体的部件对象的创建。 具体建造者类(ConcreteBuilder):实现 Builder 接口,完成复杂产品的各个部件的具体创建方法。在构造过程完成后,提供产品的实例。 产品类(Product):要创建的复杂对象。 指挥者类(Director):调用具体建造者来创建复杂对象的各个部分,在指导者中不涉及具体产品的信息,只负责保证对象各部分完整创建或按某种顺序创建。
4.4.1 常规写法
//产品类 电脑
@Data
public class Computer {
private String motherboard;
private String cpu;
private String memory;
private String disk;
private String gpu;
private String power;
private String heatSink;
private String chassis;
}
// 抽象 builder类(接口) 组装电脑
public interface ComputerBuilder {
Computer computer = new Computer();
void buildMotherboard();
void buildCpu();
void buildMemory();
void buildDisk();
void buildGpu();
void buildHeatSink();
void buildPower();
void buildChassis();
Computer build();
}
// 具体 builder类 华硕ROG全家桶电脑(手动狗头)
public class AsusComputerBuilder implements ComputerBuilder {
@Override
public void buildMotherboard() {
computer.setMotherboard("Extreme主板");
}
@Override
public void buildCpu() {
computer.setCpu("Inter 12900KS");
}
@Override
public void buildMemory() {
computer.setMemory("芝奇幻峰戟 16G*2");
}
@Override
public void buildDisk() {
computer.setDisk("三星980Pro 2T");
}
@Override
public void buildGpu() {
computer.setGpu("华硕3090Ti 水猛禽");
}
@Override
public void buildHeatSink() {
computer.setHeatSink("龙神二代一体式水冷");
}
@Override
public void buildPower() {
computer.setPower("雷神二代1200W");
}
@Override
public void buildChassis() {
computer.setChassis("太阳神机箱");
}
@Override
public Computer build() {
return computer;
}
}
// 指挥者类 指挥该组装什么电脑
@AllArgsConstructor
public class ComputerDirector {
private ComputerBuilder computerBuilder;
public Computer construct() {
computerBuilder.buildMotherboard();
computerBuilder.buildCpu();
computerBuilder.buildMemory();
computerBuilder.buildDisk();
computerBuilder.buildGpu();
computerBuilder.buildHeatSink();
computerBuilder.buildPower();
computerBuilder.buildChassis();
return computerBuilder.build();
}
}
// 测试
public static void main(String[] args) {
ComputerDirector computerDirector = new ComputerDirector(new AsusComputerBuilder());
// Computer(motherboard=Extreme主板, cpu=Inter 12900KS, memory=芝奇幻峰戟 16G*2, disk=三星980Pro 2T, gpu=华硕3090Ti 水猛禽, power=雷神二代1200W, heatSink=龙神二代一体式水冷, chassis=太阳神机箱)
System.out.println(computerDirector.construct());
}上面示例是建造者模式的常规用法,指挥者类ComputerDirector在建造者模式中具有很重要的作用,它用于指导具体构建者如何构建产品,控制调用先后次序,并向调用者返回完整的产品类,但是有些情况下需要简化系统结构,可以把指挥者类和抽象建造者进行结合,于是就有了下面的简化写法。
4.4.2 简化写法
// 把指挥者类和抽象建造者合在一起的简化建造者类
public class SimpleComputerBuilder {
private Computer computer = new Computer();
public void buildMotherBoard(String motherBoard){
computer.setMotherboard(motherBoard);
}
public void buildCpu(String cpu){
computer.setCpu(cpu);
}
public void buildMemory(String memory){
computer.setMemory(memory);
}
public void buildDisk(String disk){
computer.setDisk(disk);
}
public void buildGpu(String gpu){
computer.setGpu(gpu);
}
public void buildPower(String power){
computer.setPower(power);
}
public void buildHeatSink(String heatSink){
computer.setHeatSink(heatSink);
}
public void buildChassis(String chassis){
computer.setChassis(chassis);
}
public Computer build(){
return computer;
}
}
// 测试
public static void main(String[] args) {
SimpleComputerBuilder simpleComputerBuilder = new SimpleComputerBuilder();
simpleComputerBuilder.buildMotherBoard("Extreme主板");
simpleComputerBuilder.buildCpu("Inter 12900K");
simpleComputerBuilder.buildMemory("芝奇幻峰戟 16G*2");
simpleComputerBuilder.buildDisk("三星980Pro 2T");
simpleComputerBuilder.buildGpu("华硕3090Ti 水猛禽");
simpleComputerBuilder.buildPower("雷神二代1200W");
simpleComputerBuilder.buildHeatSink("龙神二代一体式水冷");
simpleComputerBuilder.buildChassis("太阳神机箱");
// Computer(motherboard=Extreme主板, cpu=Inter 12900K, memory=芝奇幻峰戟 16G*2, disk=三星980Pro 2T, gpu=华硕3090Ti 水猛禽, power=雷神二代1200W, heatSink=龙神二代一体式水冷, chassis=太阳神机箱)
System.out.println(simpleComputerBuilder.build());
}可以看到,对比常规写法,这样写确实简化了系统结构,但同时也加重了建造者类的职责,也不是太符合单一职责原则,如果construct() 过于复杂,建议还是封装到 Director 中。
4.4.3 链式写法
// 链式写法建造者类
public class SimpleComputerBuilder {
private Computer computer = new Computer();
public SimpleComputerBuilder buildMotherBoard(String motherBoard){
computer.setMotherboard(motherBoard);
return this;
}
public SimpleComputerBuilder buildCpu(String cpu){
computer.setCpu(cpu);
return this;
}
public SimpleComputerBuilder buildMemory(String memory){
computer.setMemory(memory);
return this;
}
public SimpleComputerBuilder buildDisk(String disk){
computer.setDisk(disk);
return this;
}
public SimpleComputerBuilder buildGpu(String gpu){
computer.setGpu(gpu);
return this;
}
public SimpleComputerBuilder buildPower(String power){
computer.setPower(power);
return this;
}
public SimpleComputerBuilder buildHeatSink(String heatSink){
computer.setHeatSink(heatSink);
return this;
}
public SimpleComputerBuilder buildChassis(String chassis){
computer.setChassis(chassis);
return this;
}
public Computer build(){
return computer;
}
}
// 测试
public static void main(String[] args) {
Computer asusComputer = new SimpleComputerBuilder().buildMotherBoard("Extreme主板")
.buildCpu("Inter 12900K")
.buildMemory("芝奇幻峰戟 16G*2")
.buildDisk("三星980Pro 2T")
.buildGpu("华硕3090Ti 水猛禽")
.buildPower("雷神二代1200W")
.buildHeatSink("龙神二代一体式水冷")
.buildChassis("太阳神机箱").build();
System.out.println(asusComputer);
}可以看到,其实链式写法与普通写法的区别并不大,只是在建造者类组装部件的时候,同时将建造者类返回即可,使用链式写法使用起来更方便,某种程度上也可以提高开发效率。从软件设计上,对程序员的要求比较高。比较常见的mybatis-plus中的条件构造器就是使用的这种链式写法。
4.4.4 总结
适用场景:
适用于创建对象需要很多步骤,但是步骤顺序不一定固定。 如果一个对象有非常复杂的内部结构(属性),把复杂对象的创建和使用进行分离。 优点:
封装性好,创建和使用分离。 扩展性好,建造类之间独立、一定程度上解耦。 缺点:
产生多余的Builder对象。 产品内部发生变化,建造者都要修改,成本较大。 与工厂模式的区别:
建造者模式更注重方法的调用顺序,工厂模式更注重创建对象。 创建对象的力度不同,建造者模式创建复杂的对象,由各种复杂的部件组成,工厂模式创建出来的都一样。 关注点不同,工厂模式只需要把对象创建出来就可以了,而建造者模式中不仅要创建出这个对象,还要知道这个对象由哪些部件组成。 建造者模式根据建造过程中的顺序不一样,最终的对象部件组成也不一样。 与抽象工厂模式的区别:
抽象工厂模式实现对产品族的创建,一个产品族是这样的一系列产品:具有不同分类维度的产品组合,采用抽象工厂模式则是不需要关心构建过程,只关心什么产品由什么工厂生产即可。 建造者模式则是要求按照指定的蓝图建造产品,它的主要目的是通过组装零配件而产生一个新产品。 建造者模式所有函数加到一起才能生成一个对象,抽象工厂一个函数生成一个对象
7种结构型模式:适配器模式、装饰模式、代理模式、外观模式、桥接模式、组合模式、享元模式。其中对象的适配器模式是各种模式的起源,我们看下面的图:
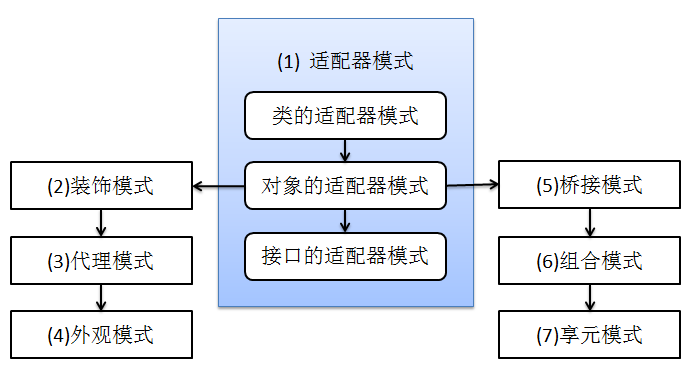
5.1、适配器模式(Adapter)
参考文章:
https://blog.csdn.net/zhangerqing/article/details/8239539
适配器模式将某个类的接口转换成客户端期望的另一个接口表示,目的是消除由于接口不匹配所造成的类的兼容性问题。主要分为三类:类的适配器模式、对象的适配器模式、接口的适配器模式。
类的适配器模式
首先,我们来看看类的适配器模式,先看类图:
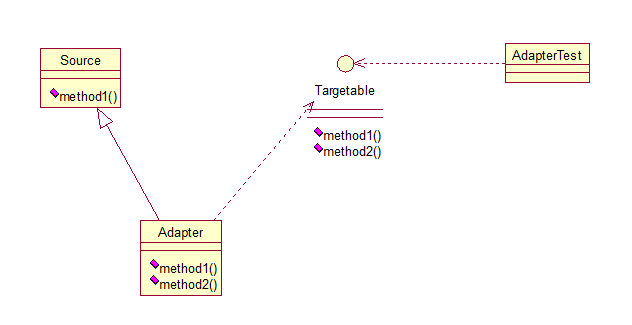
核心思想就是:有一个Source类,拥有一个方法,待适配,目标接口时Targetable,通过Adapter类,将Source的功能扩展到Targetable里,看代码:
public class Source {
public void method1() {
System.out.println("this is original method!");
}
}public interface Targetable {
/* 与原类中的方法相同 */
public void method1();
/* 新类的方法 */
public void method2();
}//核心就是Adapter继承Source的method1方法,再通过接口的方式去重写method2
达到拥有method1和method2的目的
public class Adapter extends Source implements Targetable {
@Override
public void method2() {
System.out.println("this is the targetable method!");
}
}Adapter类继承Source类,实现Targetable接口,下面是测试类:
public class AdapterTest {
public static void main(String[] args) {
Targetable target = new Adapter();
target.method1();
target.method2();
}
}输出:
this is original method! this is the targetable method!
这样Targetable接口的实现类就具有了Source类的功能。
对象的适配器模式
基本思路和类的适配器模式相同,只是将Adapter类作修改,这次不继承Source类,而是持有Source类的实例,以达到解决兼容性的问题。看图:
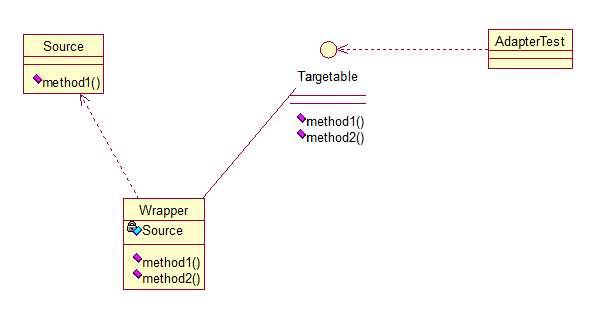
类的适配器是基于类的继承来实现方法的统一使用
对象的适配器,是通过创建对象的实例,免去了继承
只需要修改Adapter类的源码即可:
public class Wrapper implements Targetable {
private Source source;
public Wrapper(Source source){
super();
this.source = source;
}
@Override
public void method2() {
System.out.println("this is the targetable method!");
}
@Override
public void method1() {
source.method1();
}
}测试类:
public class AdapterTest {
public static void main(String[] args) {
Source source = new Source();
Targetable target = new Wrapper(source);
target.method1();
target.method2();
}
}输出与第一种一样,只是适配的方法不同而已。
接口的适配器模式
第三种适配器模式是接口的适配器模式,接口的适配器是这样的:有时我们写的一个接口中有多个抽象方法,当我们写该接口的实现类时,必须实现该接口的所有方法,这明显有时比较浪费,因为并不是所有的方法都是我们需要的,有时只需要某一些,此处为了解决这个问题,我们引入了接口的适配器模式,借助于一个抽象类,该抽象类实现了该接口,实现了所有的方法,而我们不和原始的接口打交道,只和该抽象类取得联系,所以我们写一个类,继承该抽象类,重写我们需要的方法就行。看一下类图:
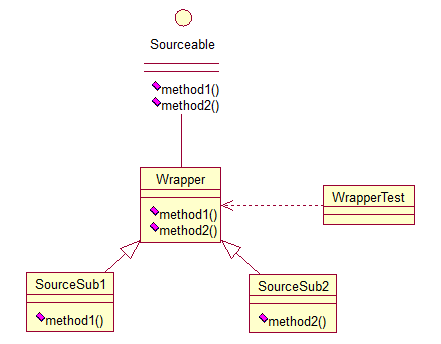
这个很好理解,在实际开发中,我们也常会遇到这种接口中定义了太多的方法,以致于有时我们在一些实现类中并不是都需要。看代码:
public interface Sourceable {
public void method1();
public void method2();
}抽象类Wrapper2:
public abstract class Wrapper2 implements Sourceable{
public void method1(){}
public void method2(){}
}public class SourceSub1 extends Wrapper2 {
public void method1(){
System.out.println("the sourceable interface's first Sub1!");
}
}public class SourceSub2 extends Wrapper2 {
public void method2(){
System.out.println("the sourceable interface's second Sub2!");
}
}public class WrapperTest {
public static void main(String[] args) {
Sourceable source1 = new SourceSub1();
Sourceable source2 = new SourceSub2();
source1.method1();
source1.method2();
source2.method1();
source2.method2();
}
}测试输出:
the sourceable interface's first Sub1! the sourceable interface's second Sub2!
达到了我们的效果!
讲了这么多,总结一下三种适配器模式的应用场景:
类的适配器模式:当希望将一个类转换成满足另一个新接口的类时,可以使用类的适配器模式,创建一个新类,继承原有的类,实现新的接口即可。
对象的适配器模式:当希望将一个对象转换成满足另一个新接口的对象时,可以创建一个Wrapper类,持有原类的一个实例,在Wrapper类的方法中,调用实例的方法就行。
接口的适配器模式:当不希望实现一个接口中所有的方法时,可以创建一个抽象类Wrapper,实现所有方法,我们写别的类的时候,继承抽象类即可。
5.2、代理模式(Proxy)
参考文章
5.2.1 概述
由于某些原因需要给某对象提供一个代理以控制对该对象的访问。这时,访问对象不适合或者不能直接引用目标对象,代理对象作为访问对象和目标对象之间的中介。
Java中的代理按照代理类生成时机不同又分为静态代理和动态代理。静态代理代理类在编译期就生成,而动态代理代理类则是在Java运行时动态生成。动态代理又有JDK代理和CGLib代理两种。
5.2.2 结构
代理(Proxy)模式分为三种角色:
- 抽象主题(Subject)类: 通过接口或抽象类声明真实主题和代理对象实现的业务方法。
- 真实主题(Real Subject)类: 实现了抽象主题中的具体业务,是代理对象所代表的真实对象,是最终要引用的对象。
- 代理(Proxy)类 : 提供了与真实主题相同的接口,其内部含有对真实主题的引用,它可以访问、控制或扩展真实主题的功能。
5.2.3 静态代理
我们通过案例来感受一下静态代理。
【例】火车站卖票
如果要买火车票的话,需要去火车站买票,坐车到火车站,排队等一系列的操作,显然比较麻烦。而火车站在多个地方都有代售点,我们去代售点买票就方便很多了。这个例子其实就是典型的代理模式,火车站是目标对象,代售点是代理对象。类图如下:
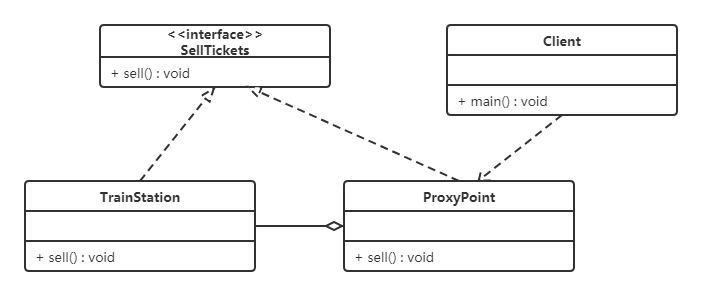
代码:
//接口
public interface SellTickets {
void sell(); // 卖票方法
}
//直接实现类
public class TrainStation implements SellTickets{
@Override
public void sell() {
System.out.println("Sell方法执行");
}
}
//代理实现类,把直接实现类作为成员变量
public class ProxyPoint implements SellTickets{
private TrainStation trainStation = new TrainStation();
@Override
public void sell() {
System.out.println("静态代理");
trainStation.sell();
}
}
//测试
public class Client {
public static void main(String[] args) {
//先创建代理类对象,在使用对应方法
ProxyPoint proxyPoint = new ProxyPoint();
proxyPoint.sell();
}
}
缺点:
仅仅是可以在创建的代理类上添加需要的方法(切面方法)
从静态代理的代码中可以发现,静态代理的缺点显而易见,那就是当真实类的方法越来越多的时候,这样构建的代理类的代码量是非常大的,所以就引进动态代理.
5.2.4JDK动态代理
动态代理允许使用一种方法的单个类(代理类)为具有任意数量方法的任意类(真实类)的多个方法调用提供服务,看到这句话,可以容易的联想到动态代理的实现与反射密不可分。 JAVA 反射机制是在运行状态中,对于任意一个类,都能够知道这个类的所有属性和方法;对于任意一个对象,都能够调用它的任意一个方法和属性;这种动态获取的信息以及动态调用对象的方法的功能称为 java 语言的反射机制。
《重要》
jdk动态代理过程中实际上代理的是接口,是因为在创建代理实例的时候,依赖的是java.lang.reflect包中Proxy类的newProxyInstance方法,该方法的生效就恰恰需要这个参数;
public static Object newProxyInstance(ClassLoader loader,
Class<?>[] interfaces,
InvocationHandler h)
throws IllegalArgumentException{
……
}
//使用Proxy获取代理对象
/*
newProxyInstance()方法参数说明:
ClassLoader loader : 类加载器,用于加载代理类,使用真实对象的类加载器即可
Class<?>[] interfaces : 真实对象所实现的接口,代理模式真实对象和代理对象实现相同的接口
InvocationHandler h : 代理对象的调用处理程序
*/
//其中InvocationHander h为下
/*
InvocationHandler中invoke方法参数说明:
proxy : 代理对象
method : 对应于在代理对象上调用的接口方法的 Method 实例
args : 代理对象调用接口方法时传递的实际参数
*/代码:
接口:
public interface SellTickets {
void sell(); // 卖票方法
}实现类:
public class TrainStation implements SellTickets{
@Override
public void sell() {
System.out.println("Sell方法执行");
}
}代理工厂:
public class ProxyFactory {
//将实现类作为成员变量
private TrainStation trainStation = new TrainStation();
//实现获取SellTickets方法,返回类型是SellTickets。这样就用一个代理方法得到接口SellTickets所有的方法
public SellTickets getSellTickets() {
//封装成SellTickets类型,
/*
左边使用Proxy中的创建代理类方法,
*/
SellTickets sellTickets = (SellTickets) Proxy.newProxyInstance(
trainStation.getClass().getClassLoader(),
trainStation.getClass().getInterfaces(),
(proxy, method, args) -> {
System.out.println("JDK代理");
Object invoke = method.invoke(trainStation, args);
return invoke;
});
return sellTickets;///最后得到接口中所有方法
}
}测试:
public class Client1 {
public static void main(String[] args) {
//创建工厂类对象
ProxyFactory proxyFactory = new ProxyFactory();
//使用工厂中获取方法
SellTickets sellTickets = proxyFactory.getSellTickets();
//调用该方法中的sell()方法
sellTickets.sell();
}
}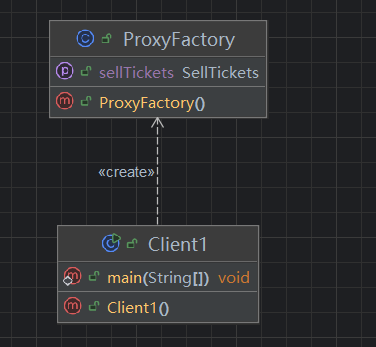
把接口和具体实现类全隐藏了
总结对比:
1.静态代理中,代理类和真实类实现的是同一个接口,重写同样的方法;jdk动态代理中,代理类和真实类关系不大,代理类实现无侵入式的代码扩展。 2.静态代理中当接口中方法增加的时候,在代理类代码量也会增加,显然是不妥的;jdk动态代理解决了这个问题,当业务增加,代理类的代码不会增加。 3.jdk动态代理实现的是jdk自带InvocationHandler接口,实现了这个接口的类也叫拦截器类,也叫代理类。
5.2.5 CGLIB动态代理
概述
从上面可以看出,jdk动态代理的前提条件是,要有接口存在,那还有许多场景是没有接口的,这个时候就需要cglib动态代理了,CGLIB(Code Generation Library)是一个基于ASM的字节码生成库,它允许我们在运行时对字节码进行修改和动态生成。CGLIB通过继承方式实现代理。 以下案例中所用到的被代理类和和上面jdk动态代理一样
cglib动态代理过程中生成的是实现类的子类,cglib是如何凭空创造的实现类的子类的,下面是测试代码
CGLIB是第三方提供的包,所以需要引入jar包的坐标:
<dependency>
<groupId>cglib</groupId>
<artifactId>cglib</artifactId>
<version>2.2.2</version>
</dependency>代码如下:
普通的类:(实现了很多方法)
public class TrainStation1 {
public void sell() {
System.out.println("火车站卖票");
}
}创建Cglib代理对象
public class ProxyFactory_Cglib implements MethodInterceptor {
private TrainStation1 station1 = new TrainStation1();
//创建代理类对象,
public TrainStation1 getStation1() {
//创建Enhancer对象,类似JDK代理中的proxy类
Enhancer enhancer = new Enhancer();
// 设置父类
enhancer.setSuperclass(TrainStation1.class);
// 设置回调函数
enhancer.setCallback(this);
// 创建代理类
return (TrainStation1) enhancer.create();
}
//重写方法
public Object intercept(Object o, Method method, Object[] objects, MethodProxy methodProxy) throws Throwable {
System.out.println("CGlib: intercept");
return (TrainStation1)methodProxy.invokeSuper(o,objects);
}
}
测试
public class Client2 {
public static void main(String[] args) {
ProxyFactory_Cglib proxyFactoryCglib = new ProxyFactory_Cglib();
TrainStation1 station1 = proxyFactoryCglib.getStation1();
station1.sell();
}
}总结
总结:cglib动态代理和jdk动态代理的区别显而易见,但是实现逻辑差不多,cglib代理类是通过实现MethodInterceptor,重写intercept
方法,通过生成被代理类的子类来达到代理增强代码的目的;而Jdk代理是通过实现InvocationHandler,重写invoke方法,通过生成接口
的代理类来达到代码增强的目的,所以jdk动态代理的实现需要接口,cglib则不需要,spring5.0以上以及springboot2.0以上默认采用
cglib动态来实现AOP。
三种代理的对比
-
jdk代理和CGLIB代理
使用CGLib实现动态代理,CGLib底层采用ASM字节码生成框架,使用字节码技术生成代理类,在JDK1.6之前比使用Java反射效率要
高。唯一需要注意的是,CGLib不能对声明为final的类或者方法进行代理,因为CGLib原理是动态生成被代理类的子类。
在JDK1.6、JDK1.7、JDK1.8逐步对JDK动态代理优化之后,在调用次数较少的情况下,JDK代理效率高于CGLib代理效率,只有当进行
大量调用的时候,JDK1.6和JDK1.7比CGLib代理效率低一点,但是到JDK1.8的时候,JDK代理效率高于CGLib代理。所以如果有接口
使用JDK动态代理,如果没有接口使用CGLIB代理。
-
动态代理和静态代理
动态代理与静态代理相比较,最大的好处是接口中声明的所有方法都被转移到调用处理器一个集中的方法中处理
(InvocationHandler.invoke)。这样,在接口方法数量比较多的时候,我们可以进行灵活处理,而不需要像静态代理那样每一个方
法进行中转。
如果接口增加一个方法,静态代理模式除了所有实现类需要实现这个方法外,所有代理类也需要实现此方法。增加了代码维护的复杂
度。而动态代理不会出现该问题
5.3、桥接模式
5.3.1 定义:桥接模式(Bridge Pattern):将抽象部分与它的实现部分分离,使它们都可以独立地变化。
问题: 这里的抽象与实现是什么意思呢?先来看一个例子:
假如你有一个几何形状Shape类,从它能扩展出两个子类: 圆形Circle和 方形Square 。 你希望对这样的类层次结构进行扩展以使其包含颜色,所以你打算创建名为红色Red和蓝色Blue的形状子类。 但是, 由于你已有两个子类, 所以总共需要创建四个类才能覆盖所有组合, 例如 蓝色圆形BlueCircle和 红色方形RedSquare 。
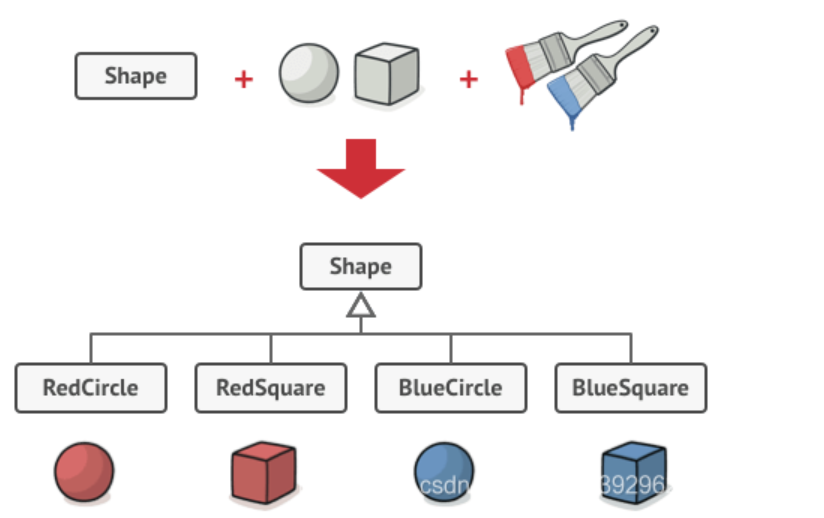
在层次结构中新增形状和颜色将导致代码复杂程度指数增长。 例如添加三角形状, 你需要新增两个子类, 也就是每种颜色一个; 此后新增一种新颜色需要新增三个子类, 即每种形状一个。 照这样下去,所有组合类的数量将以几何级数增长,情况会越来越糟糕。
解决方案: 问题的根本原因在于我们试图在两个独立的维度——形状与颜色上进行扩展。这在处理继承时是很常见的问题。
桥接模式 通过将继承改为组合的方式来解决这个问题。 具体来说, 就是抽取其中一个维度并使之成为独立的类层次, 这样就可以在初始类中引用这个新层次的对象, 从而使得一个类不必拥有所有的状态和行为。
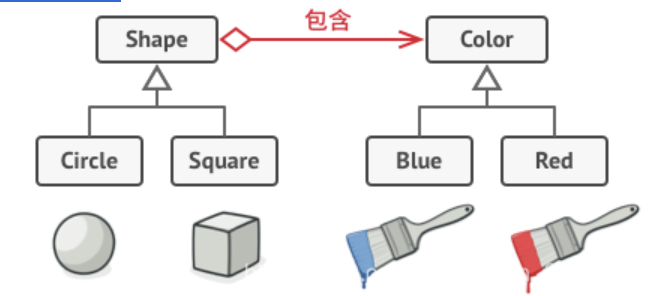
根据该方法, 我们可以将颜色相关的代码抽取到拥有 红色和 蓝色两个子类的颜色类中, 然后在 形状类中添加一个指向某一颜色对象的引用成员变量。 现在, 形状类可以将所有与颜色相关的工作委派给连入的颜色对象。 这样的引用就成为了 形状和 颜色之间的桥梁。 此后, 新增颜色将不再需要修改形状的类层次, 反之亦然。
5.3.2 使用场景
- 一个类有多个存在独立变化的维度,这两个维度都需要扩展
一个类A原始是单继承关系,在此基础上又要实现一种方法,如果还使用继承,那么这个类会无限扩大。
使用单独的一个类接口B,去实现,再将这个类接口B作为类A的成员构造变量
去实现B的时候,只需要去调用类A中的成员构造变量即可
- 如果一个系统需要在构件的抽象化角色和具体化角色之间增加更多的灵活性,避免在两个层次之间建立静态的继承联系,通过桥接模式可以使它们在抽象层建立一个关联关系。
- 对于那些不希望使用继承或因为多层次继承导致系统类的个数急剧增加的系统,桥接模式尤为适用。
5.3.3 模式结构图:
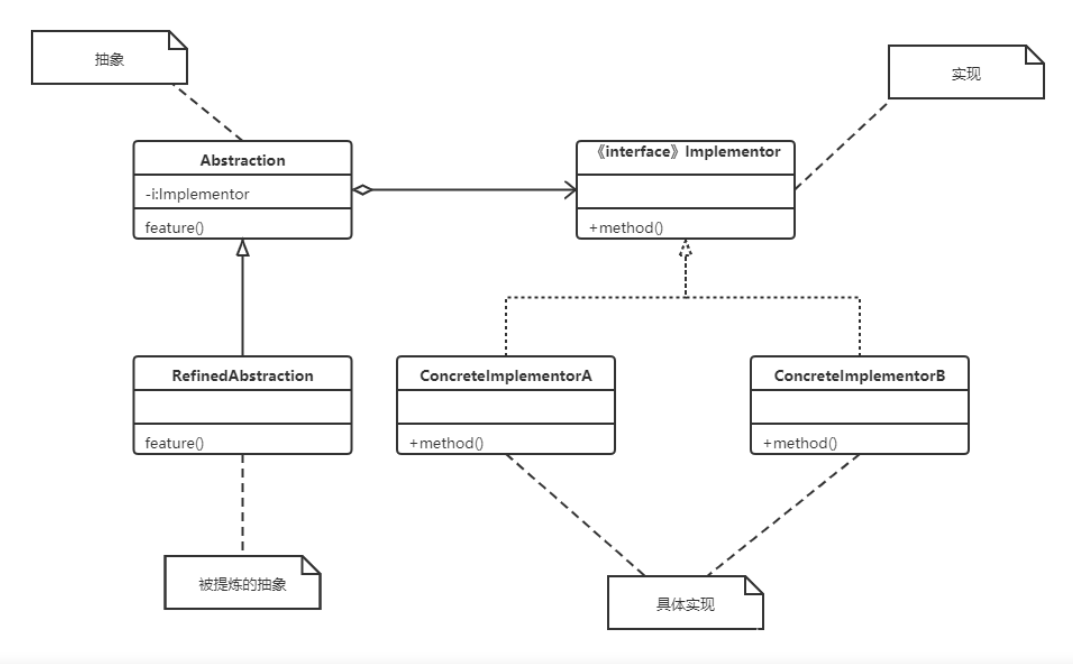
其中包含如下角色:
- Abstraction(抽象类):用于定义抽象类的接口,它一般是抽象类而不是接口,其中定义了一个 Implementor(实现类接口)类型的对象并可以维护该对象,它与 Implementor 之间具有关联关系。
- RefinedAbstraction(提炼抽象类):扩充由 Abstraction 定义的接口,通常情况下它不再是抽象类而是具体类,它实现了在 Abstraction 中声明的抽象业务方法,在 RefinedAbstraction 中可以调用在 Implementor 中定义的业务方法。
- Implementor(实现类接口):定义实现类的接口,这个接口不一定要与 Abstraction 的接口完全一致,事实上这两个接口可以完全不同,一般而言,Implementor 接口仅提供基本操作,而 Abstraction 定义的接口可能会做更多更复杂的操作。Implementor 接口对这些基本操作进行了声明,而具体实现交给其子类。通过关联关系,在 Abstraction 中不仅拥有自己的方法,还可以调用到 Implementor 中定义的方法,使用关联关系来替代继承关系。
- ConcreteImplementor(具体实现类):具体实现 Implementor 接口,在不同的 ConcreteImplementor 中提供基本操作的不同实现,在程序运行时,ConcreteImplementor 对象将替换其父类对象,提供给抽象类具体的业务操作方法。
抽象,看不下去就不看了
5.3.4 实例1
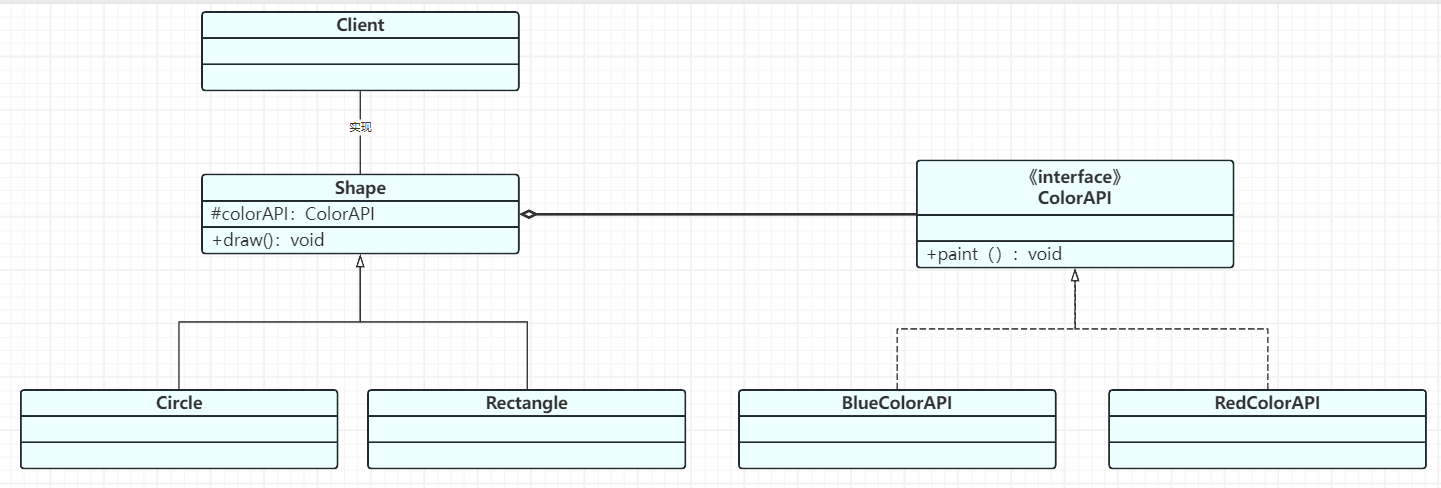
我们就以上述形状与颜色这两个独立的维度来实现给不同的形状刷上不同颜色的例子来讲解: ColorAPI :用于画各种颜色的接口
public interface ColorAPI {
public void paint();
}BlueColorAPI :画蓝色的实现类
public class BlueColorAPI implements ColorAPI {
@Override
public void paint() {
System.out.println("画上蓝色");
}
}RedColorAPI :画红色的实现类
public class RedColorAPI implements ColorAPI
{
@Override
public void paint() {
System.out.println("画上红色");
}
}Shape :抽象形状类\
这里才是重点:
把接口变成成员变量,同时添加setter方法
public abstract class Shape {
protected ColorAPI colorAPI; //添加一个颜色的成员变量以调用ColorAPI 的方法来实现给不同的形状上色
public void setDrawAPI(ColorAPI colorAPI) { //注入颜色成员变量
this.colorAPI= colorAPI;
}
public abstract void draw();
}
Circle :圆形类
在具体的基础类里放上对应的接口方法
public class Circle extends Shape {
@Override
public void draw() {
System.out.print("我是圆形");
colorAPI.paint();
}
}Rectangle :长方形类
public class Rectangle extends Shape {
@Override
public void draw() {
System.out.print("我是长方形");
colorAPI.paint();
}
}Client:客户端
在实现的时候,根据想法,实现对应接口的setter方法,只需要调用一个方法,就可以达到组合的目的
public class Client {
public static void main(String[] args) {
//创建一个圆形
Shape shape = new Circle();
//给圆形蓝色的颜料
shape.setDrawAPI(new BlueColorAPI());
//上色
shape.draw();
//创建一个长方形
Shape shape1 = new Rectangle();
//给长方形红色的颜料
shape1.setDrawAPI(new RedColorAPI());
//上色
shape1.draw();
}
}
5.4、 装饰模式
1.前言
我们通常在编码的时候为了扩展一个类的功能往往用的是继承来实现,但是继承的缺点主要是单继承的局限性和可能产生类爆炸的后果。
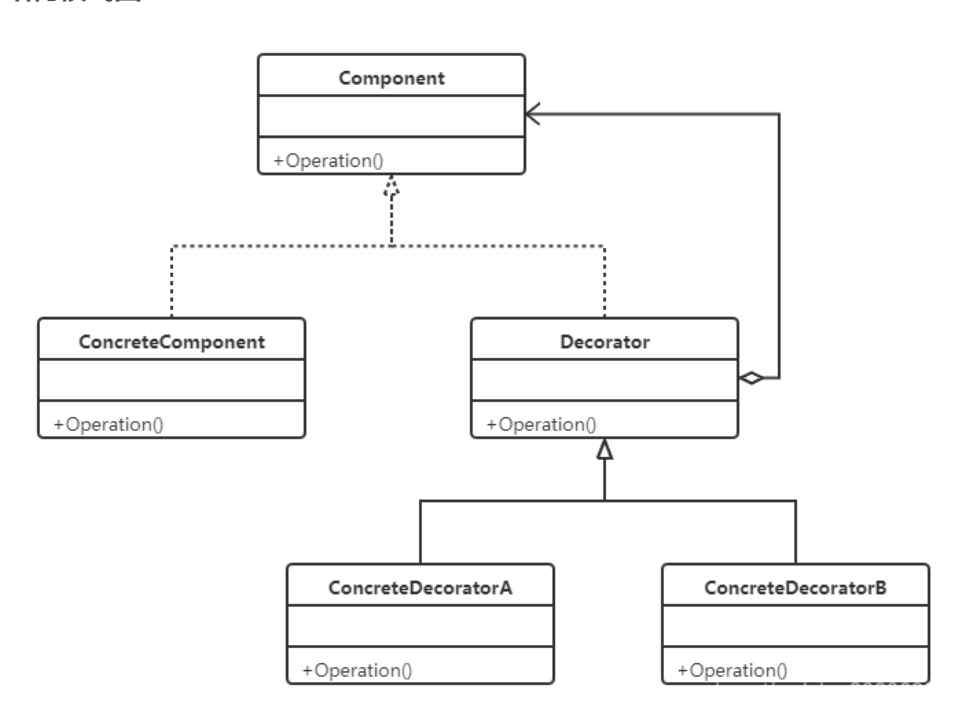
装饰模式(Decorator),动态地给一个对象添加一些额外的职责,就增加功能来说,装饰模式比生成子类更为灵活。装饰模式属于结构型模式,它是作为现有的类的一个包装。
解析:
装饰器主要解决的是直接继承下因功能的不断横向扩展导致子类膨胀的问题,而是用装饰器模式后就会比直接继承显得更加灵活同时这样也就不再需要考虑子类的维护。
在装饰器模式中有四个比较重要点抽象出来的点:
- 抽象构件角色(Component) -
定义抽象接口 - 具体构件角色(ConcreteComponent) -
实现抽象接口,可以是一组 - 装饰角色(Decorator) -
定义抽象类并继承接口中的方法,保证一致性 - 具体装饰角色(ConcreteDecorator) -
扩展装饰具体的实现逻辑
2.核心:
装饰器的核心就是在不改原有类的基础上给类新增功能。不改变原有类,可能有的小伙伴会想到继承、AOP切面,当然这些方式都可以实现,但是使用装饰器模式会是另外一种思路更为灵活,可以避免继承导致的子类过多,也可以避免AOP带来的复杂性。
3.案例分析:
在现实中我们做饭,用接口实现做饭方法即可。但是我们要在这基础上扩展方法。怎么办?
这个时候我们就可以使用装饰器模式,扩充原有的做饭服务。但同时也保证原有功能不受破坏,可以继续使用。
支付接口:
public interface INodes {
public void cook();
}基础实现方法:
public class Noodles implements INodes {
@Override
public void cook() {
System.out.println("基本方法:做饭");
}
}- 重点的类是
NoodlesDecorator,这个类是一个抽象类主要完成了对接口INodes继承。 - 当装饰角色继承接口后会提供构造函数,入参就是继承的接口实现类即可,这样就可以很方便的扩展出不同功能组件。
扩展类:
public abstract class NoodlesDecorator implements INodes {
private Noodles noodles;
public NoodlesDecorator() {
}
public NoodlesDecorator(Noodles noodles) {
this.noodles = noodles;
}
public void cook(){
noodles.cook();
}
}- 在装饰类中有三个重点的地方是:1)继承了处理接口、2)提供了构造函数、3)覆盖了方法
cook。 - 以上三个点是装饰器模式的核心处理部分,这样可以踢掉对子类继承的方式实现逻辑功能扩展。
装饰角色逻辑实现:
public class EggNoodles extends NoodlesDecorator{
public EggNoodles(Noodles noodles) {
super(noodles);
}
@Override
public void cook() {
System.out.println("加鸡蛋");
super.cook();
}
}- 在具体的装饰类实现中,继承了装饰类
NoodlesDecorator,那么现在就可以扩展方法;cook - 在
cook的实现中可以看到,这里只关心扩展部分的功能,同时不会影响原有类的核心服务,也不会因为使用继承方式而导致的多余子类,增加了整体的灵活性。
测试:
public class Test {
@org.junit.Test
public void testCook(){
//在EggNoodles中直接super了noodls对象,并且参数为noodles,所以在调用时,创建Eggnooles对象,调用父类参数,然
//然后再后
EggNoodles eggNoodles = new EggNoodles(new Noodles());
//等价于
Noodles nooles = new Noodles();
Noodles new EggNooles()
eggNoodles.cook();
}
}- 这里测试了对装饰器模式的使用,通过透传原有做饭类
new Noodles(),传递给装饰器,让装饰器可以执行扩充的功能。 - 同时对于传递者和装饰器都可以是多组的,在一些实际的业务开发中,往往也是由于太多类型的子类实现而导致不易于维护,从而使用装饰器模式替代。
4.总结
- 使用装饰器模式满足单一职责原则,你可以在自己的装饰类中完成功能逻辑的扩展,而不影响主类,同时可以按需在运行时添加和删除这部分逻辑。另外装饰器模式与继承父类重写方法,在某些时候需要按需选择,并不一定某一个就是最好。
- 装饰器实现的重点是对抽象类继承接口方式的使用,同时设定被继承的接口可以通过构造函数传递其实现类,由此增加扩展性并重写方法里可以实现此部分父类实现的功能。
- 就像夏天热你穿短裤,冬天冷你穿棉裤,雨天挨浇你穿雨衣一样,你的根本本身没有被改变,而你的需求却被不同的装饰而实现。生活中往往比比皆是设计,当你可以融合这部分活灵活现的例子到代码实现中,往往会创造出更加优雅的实现方式。
5.5、组合模式
参考文章:
1.前言
例如你有三个原子校验功能(A:身份证、B:银行卡、C:手机号)服务并对外提供调用使用。有些调用方需要使用AB组合,有些调用方需要使用到CBA组合,还有一些可能只使用三者中的一个。那么这个时候你就可以使用组合模式进行构建服务,对于不同类型的调用方配置不同的组织关系树,而这个树结构你可以配置到数据库中也可以不断的通过图形界面来控制树结构。
所以不同的设计模式用在恰当好处的场景可以让代码逻辑非常清晰并易于扩展,同时也可以减少团队新增人员对项目的学习成本。
2.核心
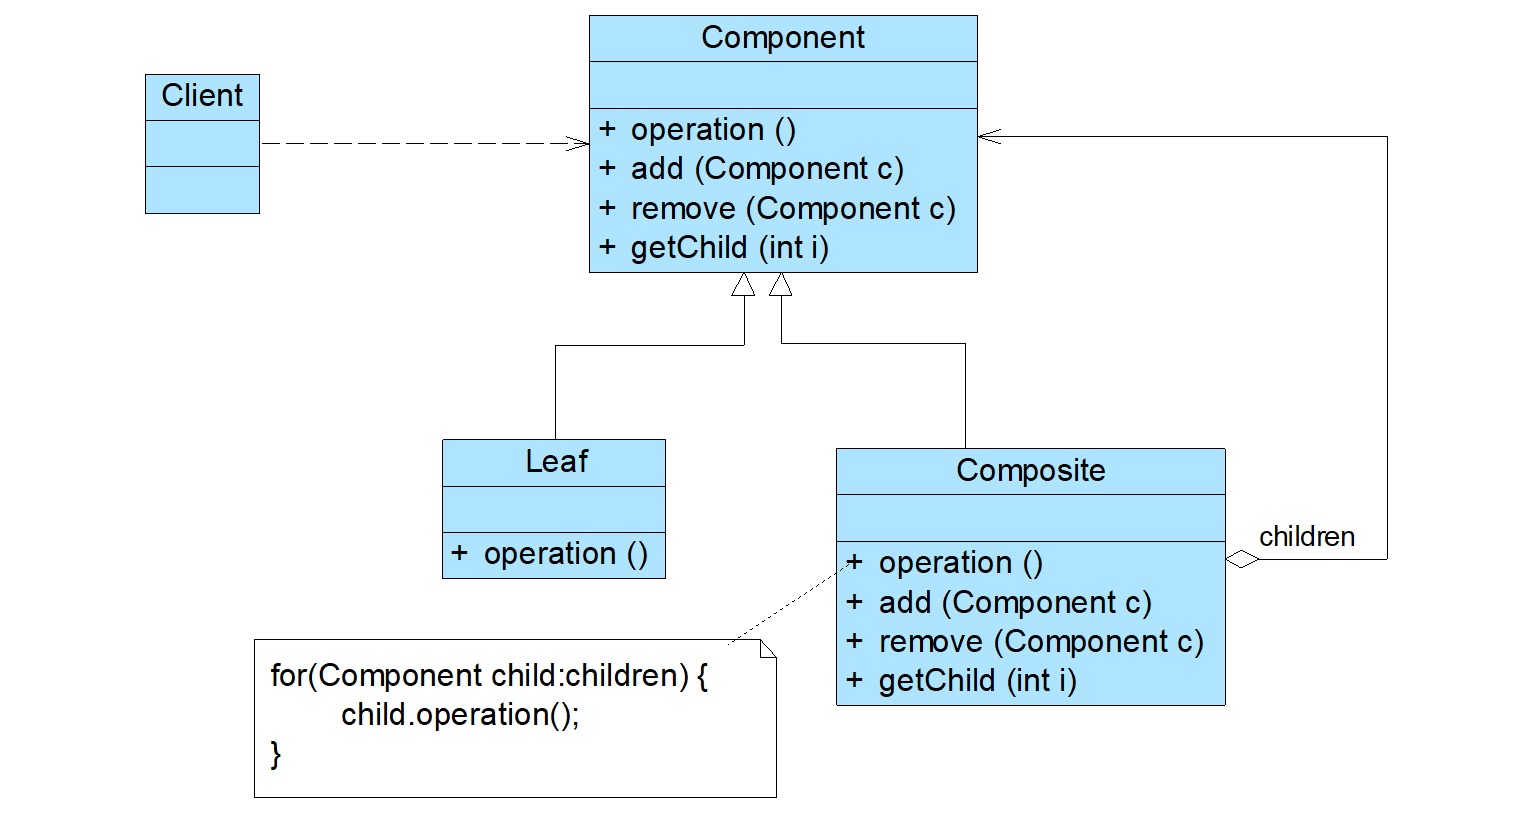
- 组合模式(Composite Pattern),又叫
部分整体模式,它创建了对象组的树形结构,将对象组合成树状结构以表示“整体-部分”的层次关系。 - 组合模式依据树状结构来组合对象,用来表示部分以及整体层次。
- 这种设计模式属于
结构性模式 - 组合模式使得用户对单个对象和组合对象的访问具有一致性,即:组合能让客户以一致的方式处理个别对象以及组合对象。
-
Component为抽象构件;抽象的组件对象,为参与组合的对象声明接口,让客户端可以通过这个接口来访问和管理整个对象结构,可以定义一些默认的行为或属性。
-
Composite 组合对象,通常会存储子组件,形成一个树形结构。
-
Leaf 叶子节点对象,其下不再包含其它的子节点,也就是遍历的最小单位。
叶子没有孩子,不能操作方法
3.案例分析
-
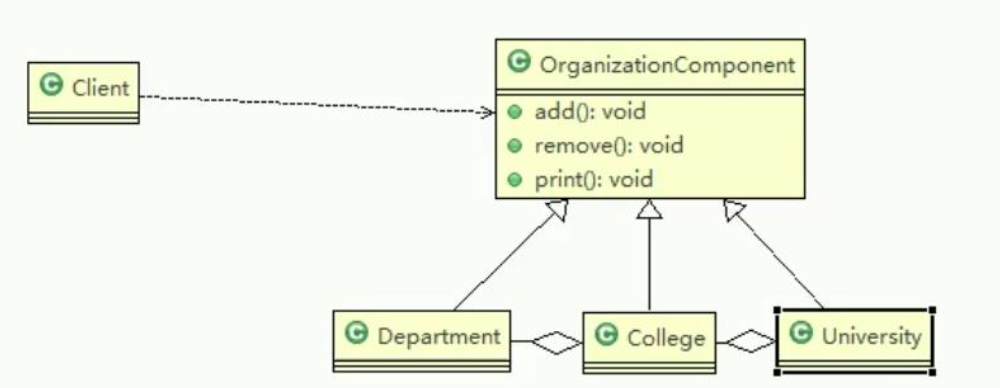
应用实例要求 编写程序展示一个学校院系结构:需求是这样,要在一个页面中展示出学校的院系组 成,一个学校有多个学院,一个学院有多个系。
分析:
- 抽象构件设置对应方法,add(),remove()方法为基础的重写方法,print()方法为抽象方法,让子类去重写
- 组合对象University,College:重写add和remove方法即可,同时重写的print()方法为来显示自身的属性
- 叶子结点Department:不能重写add和remove方法再去获取叶子结点,重写print方法,来显示自身属性
调用:
从第一层结点University开始创建结点,依次从下创建对象College、Department。最后将叶子结点的方法,数据添加到第一层结点University中,就可以把所有数据一键添加到顶层结点中。
Component:OrganizationComponent类
Java@Data @NoArgsConstructor @AllArgsConstructor public abstract class OrganizationComponent { private String name; private String des; protected void add(OrganizationComponent organizationComponent) { throw new UnsupportedOperationException("Not supported yet"); } protected void remove(OrganizationComponent organizationComponent) { throw new UnsupportedOperationException("Not supported yet"); } protected abstract void print(); }Composite:University
Javapublic class University extends OrganizationComponent{ List<OrganizationComponent> organizationComponentList = new ArrayList<OrganizationComponent>(); //构造方法 public University(String name, String des) { super(name, des); } @Override protected void add(OrganizationComponent organizationComponent) { organizationComponentList.add(organizationComponent); } @Override protected void remove(OrganizationComponent organizationComponent) { organizationComponentList.remove(organizationComponent); } @Override protected void print() { //获取自己的name System.out.println("===================="+getName()+"============================================"); //通过getter获取university的学院 for (OrganizationComponent organizationComponent :organizationComponentList){ organizationComponent.print(); } } @Override public String getName() { return super.getName(); } @Override public String getDes() { return super.getDes(); } }Composite:College
Javapublic class College extends OrganizationComponent { List<OrganizationComponent> organizationComponentList = new ArrayList<OrganizationComponent>(); public College(String name, String des) { super(name, des); } @Override protected void add(OrganizationComponent organizationComponent) { organizationComponentList.add(organizationComponent); } @Override protected void remove(OrganizationComponent organizationComponent) { organizationComponentList.remove(organizationComponent); } @Override protected void print() { //获取自己的name System.out.println("===================="+getName()+"============================================"); for (OrganizationComponent organizationComponent : organizationComponentList) { organizationComponent.print(); } } @Override public String getName() { return super.getName(); } @Override public String getDes() { return super.getDes(); } }Leaf:Department
Javapublic class Department extends OrganizationComponent { public Department(String name, String des) { super(name, des); } @Override protected void print() { System.out.println(getName()); } @Override public String getName() { return super.getName(); } @Override public String getDes() { return super.getDes(); } }Test:OrganizationComponentTest
Javapublic class OrganizationComponentTest { @Test public void testAddOrganization() { //从大到小创建对象 学校 OrganizationComponent university = new University("上海理工大学", "还不错"); //创建 学院 OrganizationComponent college1 = new College("光电学院", "A+"); OrganizationComponent college2 = new College("计算机学院","C-"); //创建各个学院下面的系(专业) college1.add(new Department("光工专业", " NB ")); //创建各个学院下面的系(专业) college2.add(new Department("软件工程", " 软件工程不错 ")); //将学院加入到 学校 university.add(college1); university.add(college2); // 打印学校 university.print(); } } 结果: ====================上海理工大学============================================ ====================光电学院============================================ 光工专业 ====================计算机学院============================================ 软件工程
4.总结
优点:
-
统一了组合对象和叶子节点对象。
-
简化了客户端调用。 客户端在使用的时候,不需要区分各个组件。
-
更容易扩展。 新增一个Component节点的子类时,很容易与已有结构一起工作,客户端不需要跟着做改变。
缺点:
- 很难限制组合中的组件类型。 在需要检测组件类型的时候,无法依靠编译器的类型约束来完成,必须在运行期间动态检测。
适用场景:
- 从以上的决策树场景来看,组合模式主要解决的是一系列简单逻辑节点或者扩展的复杂逻辑节点在不同结构的组织下,对于外部的调用是仍然可以非常简单的。
- 这部分设计模式保证了开闭原则,无需更改模型结构你就可以提供新的逻辑节点的使用并配合组织出新的关系树。但如果是一些功能差异化非常大的接口进行包装就会变得比较困难,但也不是不能很好的处理,只不过需要做一些适配和特定化的开发。
- 维护和展示"部分-整体"结构的场景,如树形菜单、文件目录、组织架构等。
5.6、享元模式(FlyWeight)
https://blog.csdn.net/weixin_45433817/article/details/131335574
1.前言
2.核心
3.案例分析
4.总结
5.7 外观模式
参考文章: 外观模式(Facade)
1.前言
**外观模式(门面模式)**是一种结构型设计模式。它提供一个统一的接口,用于访问子系统中的一组接口,隐藏了系统的复杂性。最简单的应用就是,当controller层的逻辑处理比较复杂,就可以考虑把这些逻辑封装成一个外观类。
外观模式:主要解决的是降低调用方的使用接口的复杂逻辑组合。这样调用方与实际的接口提供方提供方提供了一个中间层,用于包装逻
辑提供API接口。有些时候外观模式也被用在中间件层,对服务中的通用性复杂逻辑进行中间件层包装,让使用方可以只关心业务开发。
生活场景
那这就太多了,比如
- 外卖:当我们点外卖时,可以直接在某外卖平台直接下单,经过一系列的子系统接口,通知店家备餐,通知外卖小哥取餐再送到你手里,这里某外卖平台就可以看作是一个外观对象,隐藏了买饭的复杂性。
- 快递:我们需要寄送包裹时,可以通过快递代理公司提供的外观接口来进行操作。我们只需要提供包裹的信息,快递代理公司会负责处理包裹的取件、运输和投递等,而不需要我们直接与各个快递公司进行交互。
- 旅行社:我们计划去旅行时,可以选择找一家旅行社来帮助我们安排旅行的各种事,如订机票、预定酒店、预定门票等。旅行社可以看作是一个外观对象,它为客户提供了一个统一的接口,隐藏了许多复杂的流程和细节,并与各个供应商进行协调。
java场景
这也太多了,就随便举几个吧。
- Java IO:IO库中,InputStream、OutPutStream、Reader和Writer等,都可以看作是外观类,它们封装了底层的复杂的IO操作,提供了简单的接口。
- JDBC:JDBC提供了一组统一的接口,用于访问和操作不同类型的数据库。DriverManager类,封装了底层的数据库连接细节,可以通过一个简单的接口就能操作不同的数据库。
- Spring框架:很多功能都是通过外观模式来设计的。如,BeanFactory,封装了底层的IOC和Bean的创建过程,提供了简单的接口供开发者使用。
2.核心
类图:
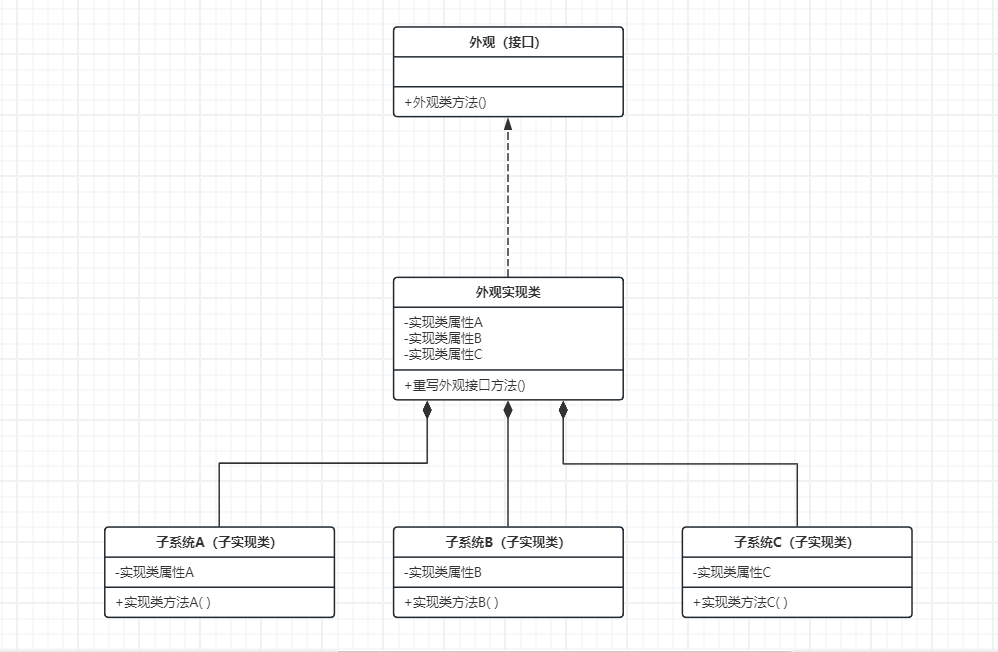
这个图可以跟我们在写平常service层一样,在这个基础上做修改。就是把重写子实现类,就是聚合到实现类上(作为成员方法)
3.案例分析
下面以旅行社为例,解释一下外观模式。
在旅行社中,我们可以将后台的一些复杂的子系统类,比如酒店、机票、门票预定等封装成一个旅行社预定服务,也就是外观类,最后提供一个简单的接口来处理客户端的请求。
- 外观:TravelFacade
- 子系统:FlightService、HotelService、TicketService
- 外观实现类:TravelFacadeImpl
UML类图
从UML类图上往下写
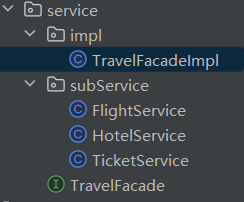
外观(Facade)——旅行社预定服务
public interface TravelFacade {
void dePart();
}外观实现类(这部分前期只能撘个框架,要等到子实现写完,才能把所有接口放到这个实现类里面一起实现)
public class TravelFacadeImpl implements TravelFacade{
private HotelService hotelService;
private FlightService flightService;
private TicketService ticketService;
public TravelFacadeImpl(){
hotelService=new HotelService();
flightService=new FlightService();
ticketService=new TicketService();
}
@Override
public void dePart(){
hotelService.bookHotel();
flightService.bookFlight();
ticketService.bookTicket();
}
}子系统(SubSystem)
public class FlightService {
public void bookFLight(){
System.out.println("去预定航班");
}
}public class HotelService {
public void bookHotel(){
System.out.println("预定酒店成功");
}
}public class TicketService {
public void bookTicket(){
System.out.println("预定门票成功");
}
}客户端
@Test
public void dePart() {
TravelFacade travelFacade= new TravelFacadeImpl();
travelFacade.dePart();
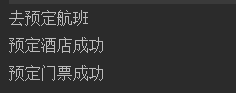
}
4.总结
优缺点
优点:
**简化接口:**隐藏了一系列复杂的子系统接口,使得客户端更加方便的使用。
**解耦:**外观模式讲客户端和子系统之间进行解耦。客户端只需要跟外观类交互,降低了客户端与子系统之间的依赖性。
**灵活:**通过引入外观类,可以灵活地调整子系统的实现细节,而不会影响客户端调用。
缺点:
**不符合开闭原则:**如果需要新增或者修改子系统的功能,可能需要修改外观类。
**不适合大规模系统:**当子系统很复杂且分散,或者子系统之间的交互方式频繁变化,使用外观模式可能导致外观类变得庞大且复杂。
外观模式应用非常广泛,主要适用于需要简化和封装复杂性、解耦和提供统一接口的情况,具体的使用场景如下:
**简化复杂的子系统:**当一个子系统非常复杂,包含多个组件或模块,并且它们之间的交互相对复杂时,可以使用外观模式将复杂性封装起来。外观类作为一个简单的接口,将复杂的子系统隐藏起来,对外提供简洁清晰的接口。
**隐藏底层实现细节:**当底层系统或第三方库的实现细节复杂且易变时,可以使用外观模式将其封装起来。外观类提供一组简单的接
口,封装了底层实现细节,错误处理和兼容性问题都可以在外观类中处理。
**提供统一的接口:**当一个复杂系统需要向外部提供一组简单易用的接口时,可以使用外观模式。外观类作为一个门面,将对内部各个
组件的调用转化为对外提供的接口调用。
**应用层和底层系统的解耦:**当应用层和底层系统之间存在紧耦合时,可以使用外观模式将它们解耦。外观类作为中间层,可以将底层
系统的接口整合并提供一个干净的接口给应用层使用,从而降低彼此之间的耦合度。
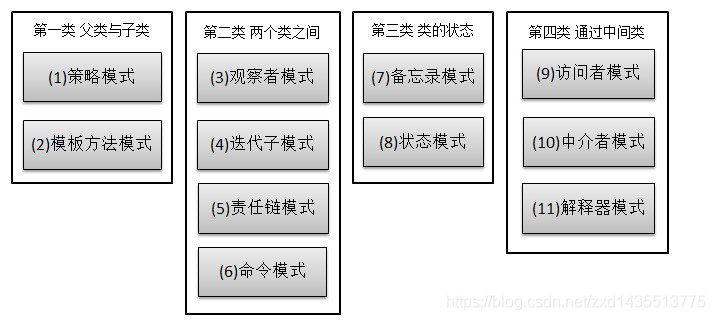
6.1 模版方法模型
1.前言
- 模板方法模式(Template Method Pattern),又叫模板模式(Template Pattern),在一个抽象类公开定义了执行它的方法的模板。它的子类可以按需要重写方法实现,但调用将以抽象类中定义的方式进行。
- 简单说,模板方法模式,定义一个操作中的算法的骨架,而将一些步骤延迟到子类中,使得子类可以不改变一个算法的结构,就可以重定义该算法的某些特定步骤,这种类型的设计模式属于行为型模式。
2.核心
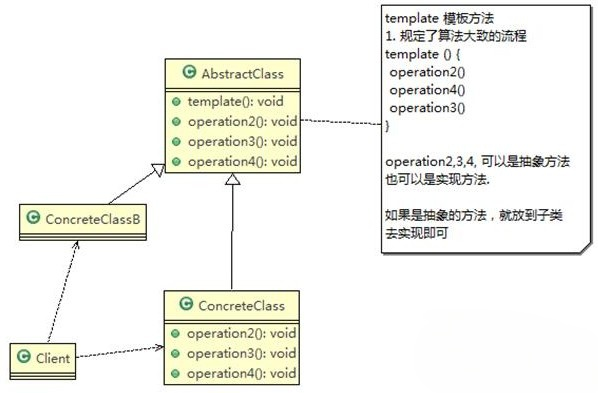
核心在AbstractClass中,这是一个抽象类,这个类包含两部分:1.算法流程(模版方法);2.抽象方法(子类按需实现)
ConcreteClass,这是子类的实现类,将父类的方法按需重写
3.案例分析
1.豆浆制作
编写制作豆浆的程序,说明如下:
-
制作豆浆(make)的流程:
- 1、选材selcet()
- 2、添加配料addCondiment();
- 3、浸泡soak();
- 4、放到豆浆机打碎beat();
上述4个方法构成一个make()模版方法,其中方法1、3、4都是固定的方法,不会变的。
而方法2的变化会导致豆浆的口味不同,这是个抽像方法,根据实现的不同导致结果不同。
即:
-
通过添加不同的配料,可以制作出不同口味的豆浆
-
选材、浸泡和放到豆浆机打碎这几个步骤对于制作每种口味的豆浆都是一样的
那么我们可大致的写出类图
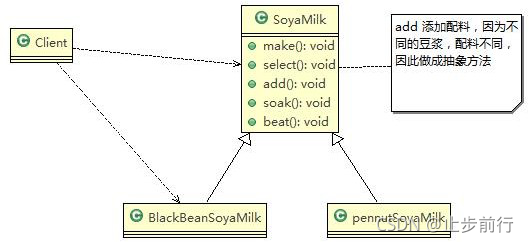
抽象类:SayaMilk类,包含make()即方法执行模版;以及执行的方法
BlackBeanSoyaMilk红豆豆浆,去重写add方法
PennutSoyaMilk花生豆浆,重写add方法
2.具体实现:
// 抽象类,表示豆浆 SoyaMilk.java
public abstract class SoyaMilk {
// 模板方法:可以做成final,不让子类去覆盖
final void make() {
select();
addCondiment();
soak();
beat();
}
//选材料
void select() { System.out.println("第一步:选择新鲜的豆子"); }
//添加不同的配料:抽象方法,由子类具体实现
abstract void addCondiment();
//浸泡
void soak() { System.out.println("第三步:豆子和配料开始浸泡3H"); }
//榨汁
void beat() { System.out.println("第四步:豆子和配料放入豆浆机榨汁"); }
}
// RedBeanSoyaMilk.java
public class ReadBeanSoyaMilk extends SoyaMilk {
@Override
void addCondiment() {
System.out.println("第二步:加入上好的红豆");
}
}
// PeanutSoyMilk.java
public class PeanutSoyaMilk extends SoyaMilk {
@Override
void addCondiment() {
System.out.println("第二步:加入上好的花生");
}
}
// Client.java
public class Client {
public static void main(String[] args) {
System.out.println("=======制作红豆豆浆=======");
SoyaMilk redBeanSoyaMilk = new ReadBeanSoyaMilk();
redBeanSoyaMilk.make();
System.out.println("=======制作花生豆浆=======");
SoyaMilk peanutSoyaMilk = new PeanutSoyaMilk();
peanutSoyaMilk.make();
}
}
3.模板方法模式的钩子方法
在模板方法模式的父类中,可以定义一个方法,它默认不做任何事,子类可以视情况要不要覆盖它,该方法称为“钩子”。还是用上面做豆浆的例子来讲解,比如,我们还希望制作纯豆浆,不添加任何的配料,请使用钩子方法对前面的模板方法进行改造。代码实现如下:
// RedBeanSoyaMilk.java/PeanutSoyaMilk.java同上,略
//抽象类,表示豆浆,SoyaMilk
public abstract class SoyaMilk {
//模板方法:可以做成final,不让子类去覆盖
final void make() {
select();
if(customerWantCondiment()) {
addCondiment();
}
soak();
beat();
}
//1.选材料
void select() { System.out.println("第一步:选择新鲜的豆子"); }
//2.添加不同的配料:抽象方法,由子类具体实现
abstract void addCondiment();
//3.浸泡
void soak() { System.out.println("第三步:豆子和配料开始浸泡3H"); }
//4.榨汁
void beat() { System.out.println("第四步:豆子和配料放入豆浆机榨汁"); }
//钩子方法:决定是否需要添加配料
boolean customerWantCondiment() {
return true;//默认情况下是要加配料的
}
}
// PureSoyaMilk.java
public class PureSoyaMilk extends SoyaMilk {
@Override
void addCondiment() {
// 添加配料的方法 空实现 即可
}
@Override
boolean customerWantCondiment() {
return false;
}
}
// Client.java
public class Client {
public static void main(String[] args) {
System.out.println("=制作纯豆浆=");
SoyaMilk pureSoyMilk = new PureSoyaMilk();
pureSoyMilk.make();
}
}
注意:一般模板方法都加上 final 关键字, 防止子类重写模板方法
4.总结
-
基本思想是:算法只存在于一个地方,也就是在父类中,容易修改。需要修改算法时,只要修改父类的模板方法或者已经实现的某些步骤,子类就会继承这些修改
-
好处:
- 实现了最大化代码复用。父类的模板方法和已实现的某些步骤会被子类继承而直接使用;
- 既统一了算法,也提供了很大的灵活性。父类的模板方法确保了算法的结构保持不变,同时由子类提供部分步骤的实现
-
该模式的不足之处:每一个不同的实现都需要一个子类实现,导致类的个数增加,使得系统更加庞大
-
模板方法模式使用场景:
-
当要完成在某个过程,该过程要执行一系列步骤 ,这一系列的步骤基本相同,但其个别步骤在实现时可能不同,通常考虑用模板方法模式来处理
- 统计某一段代码的执行时间也可以用模板方法模式:在前面打印出代码执行前的时间,后面再打印出代码执行后的时间,中间部分就是不同的执行代码
-
6.2策略模式
参考文章:
前言:
现实中一个目标的实现往往有很多种实现的方法;
例如1:现实生活中有动植物大纲分支有很多种,每类下属的具体动物又有不同的行为属性。
如鸭子:水鸭、野鸭、北京鸭
鸭子有各种行为:叫、飞等
设计展现出每种鸭子的信息
例如2:游戏难度调整
游戏的难度往往需要根据玩家的技能水平和游戏进度进行调整。通过使用策略模式,我们可以为不同的难度级别定义不同的策略对象,包括敌人的行为、奖励的分配等。这样,我们就可以根据玩家的表现或选择,动态地调整游戏的难度,提供更好的游戏体验。
对应还有角色行为管理等
传统的方法:
使用继承的方法
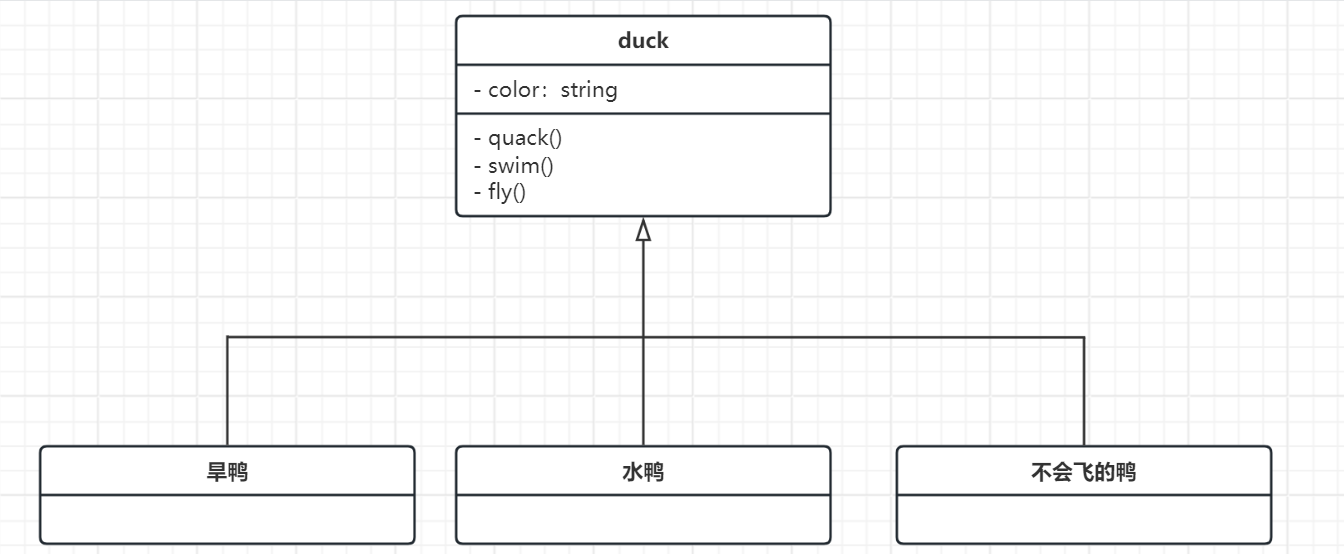
抽象类Duck
public abstract class Duck {
public Duck() {
}
public abstract void display();
public void quack(){
System.out.println("鸭子叫");
}
public void fly(){
System.out.println("鸭子飞");
}
public void swim(){
System.out.println("鸭子游泳");
}
}
实现类:旱鸭
public class DryDuck extends Duck{
@Override
public void display() {
System.out.println("这是旱鸭");
}
@Override
public void swim() {
System.out.println("不会游泳");
}
}实现类:水鸭
public class Teal extends Duck{
@Override
public void display() {
System.out.println("这是水鸭");
}
//水鸭不会飞,所以要重写这个方法
@Override
public void fly() {
System.out.println("水鸭不会飞");
}
}实现类:不会飞的鸭
public class NoflyDuck extends Duck{
@Override
public void display() {
System.out.println("这是不会飞的鸭");
}
@Override
public void fly() {
System.out.println("不会飞的鸭"); }
}传统解决方法: 让所有类都继承Duck类,而且在父类实现所有fly(),swim()等行为。但是并不是所有子类都能使用父类的行为的。
为了解决父类行为溢出的行为,使用覆盖来重写该方法。而且如果进入某个类,需要重写所有方法
策略模式实现原理
该模式定义了一系列算法,并将每个算法封装起来,使它们可以相互替换,且算法的变化不会影响使用算法的客户。策略模式属于对象行为模式,它通过对算法进行封装,把使用算法的责任和算法的实现分割开来,并委派给不同的对象对这些算法进行管理。
优点:
把算法的责任和实现分割
针对接口编程而不是具体类
使用组合/聚合,少使用继承
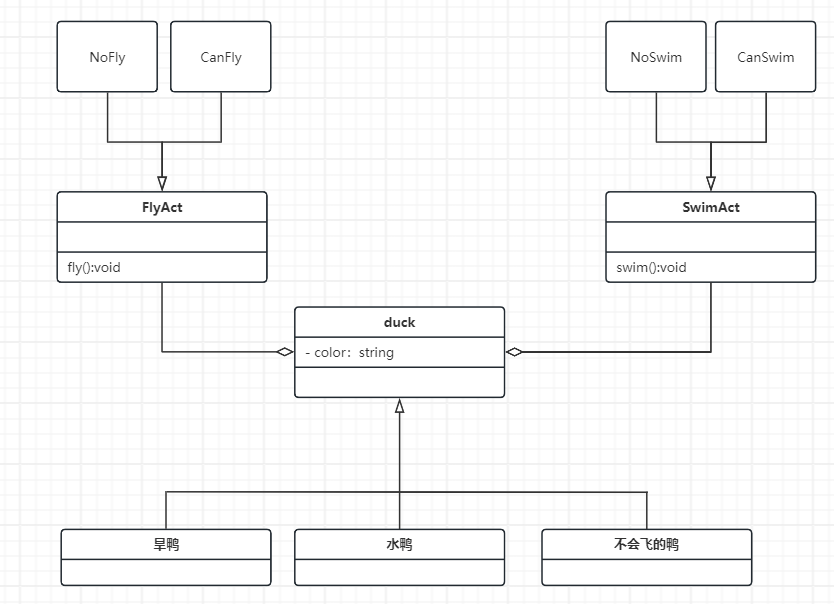
例1:改进部分代码
接口类:
public interface FlyAct {
void fly();
}接口的实现类:
public class CanFly implements FlyAct{
@Override
public void fly() {
System.out.println("可以飞");
}
}public class NoFly implements FlyAct {
@Override
public void fly() {
System.out.println("不会飞");
}
}旱鸭重写类:
public class DryDuck extends Duck{
@Override
public void display() {
System.out.println("这是旱鸭");
}
public DryDuck() {
NoFly noFly = new NoFly();
}
}测试类:
public class Test {
public static void main(String[] args) {
DryDuck dryDuck = new DryDuck();
dryDuck.setFlyAct(new NoFly());
dryDuck.fly();
dryDuck.setFlyAct(new CanFly());
dryDuck.fly();
}
}
/*
不会飞
可以飞
*/这样只需要在调用时,只需要调用新的接口方法,达到改写的目的
例子2:
实体类:
public class GameUser {
private SwitchRoles user;//创建引用数据类型
public void SwitchRoles(){//切换角色的方法
user.Switch();
}
public GameUser() {//无参构造方法
}
public GameUser(SwitchRoles user) {//有参构造方法
this.user = user;
}
public void setUser(SwitchRoles user) {//setter方法
this.user = user;
}
}接口:
package Interface;
public interface SwitchRoles {
void Switch();//写入Swtich方法
}接口的实现类1:
public class A implements SwitchRoles {
@Override
public void Switch() {
System.out.println("切换战士角色");
}
}接口的实现类2:
public class B implements SwitchRoles {
@Override
public void Switch() {
System.out.println("切换法师角色");
}
}使用:
public class Test1 {
public static void main(String[] args) {
//使用策略A
GameUser gameUser = new GameUser(new A());//创建对象,参数使用A的实现
gameUser.SwitchRoles();
//使用策略B
GameUser gameUser1 = new GameUser(new B());//创建对象,参数使用B的实现
gameUser1.SwitchRoles();
//由切换策略B
gameUser.setUser(new B());//利用set方法修改为实现类B
gameUser.SwitchRoles();
}
}public enum Strategy {
A{
@Override
public void exe() {
System.out.println("执行具体策略A");
}
},
B{
@Override
public void exe() {
System.out.println("执行具体策略B");
}
};
public abstract void exe();//抽象策略
}
public class Test {
public static void main(String[] args) {
Map<String, Strategy> map=new LinkedHashMap<>();
map.put("A",Strategy.A);
map.put("B",Strategy.B);
String str="A";
map.get(str).exe();
}
}例子3:
//促销策略(包含抽象策略和具体策略)
public enum PromotionStrategy {
/**
* 促销活动
*/
MJPS{
@Override
public void doPromotion() {
System.out.println("满减促销 , 满 100 减 20");
}
},
FXPS{
@Override
public void doPromotion() {
System.out.println("返现促销 , 返优惠券 10 元");
}
},
EMPS{
@Override
public void doPromotion() {
System.out.println("原价出售");
}
};
public abstract void doPromotion();
}
//促销策略工厂类
public class PromotionStrategyFactory {
private static HashMap<String, PromotionStrategy> ps = new HashMap<>();
static {
ps.put(PromotionKey.MANJIAN, PromotionStrategy.MJPS);
ps.put(PromotionKey.FANXIAN, PromotionStrategy.FXPS);
}
//使用这种方式声明常量 , 可以起到逻辑上分组的作用
public interface PromotionKey {
String MANJIAN = "ManJian";
String FANXIAN = "FanXian";
}
//构造函数不能被外界访问
private PromotionStrategyFactory() {
}
//根据传入的键值获取相应的促销策略
public static PromotionStrategy getPromotionStrategy(String promotionKey) {
PromotionStrategy promotionStrategy = ps.get(promotionKey);
return promotionStrategy != null ? promotionStrategy : PromotionStrategy.EMPS;
}
}
/**
* 促销活动
*/
public class PromotionActivity {
/**
* 促销策略 , 通过构造器注入
*/
private PromotionStrategy promotionStrategy;
public PromotionActivity(PromotionStrategy promotionStrategy) {
this.promotionStrategy = promotionStrategy;
}
/**
* 执行促销策略
*/
public void executePromotionStrategy() {
this.promotionStrategy.doPromotion();
}
}
public class Main {
public static void main(String[] args) {
// 获取促销策略
PromotionStrategy promotionStrategy = PromotionStrategyFactory.
getPromotionStrategy(PromotionStrategyFactory.PromotionKey.FANXIAN);
// 创建促销活动 , 并执行促销策略
PromotionActivity promotionActivity = new PromotionActivity(promotionStrategy);
// 执行促销策略
promotionActivity.executePromotionStrategy();
}
}
6.3 命令模式
参考文章:
1.前言
命令模式 : 将 <font color =red>不同的请求</font> 封装成 <font color =green>不同的请求对象</font> , 以便 <font color =red>不同的 请求</font>使用 ; 对于接收者来说 , 可以识别 不同的 请求对象类型 , 然后执行 不同的操作 ;
命令模式 , 解决了 应用程序 中 , <font color =“red">对象的职责 ( 发送请求 / 执行请求 )</font> , 以及它们之间的 通信方式 ;
命令模式 可以使 命令的 <font color =“red">发送者 和 接收者 完全解耦 </font> ; 发送者 和 接收者 之间 , 并没有直接的关系 , 二者靠 <font color =“red">命令</font> 进行交互 ;
<font color =red>命令发送者</font> 只需要知道发送 请求对象 , 不需要知道如何完成请求 ;
<font color =red>命令执行者 </font>只需要知道如何 完成请求 , 不需要知道请求的发送过程 ;
2.核心
命令模式的核心在于对命令、实现、调用者这三个内容的拆分。
命令:接口
实现:对接口的实现
调用者:对命令的调用
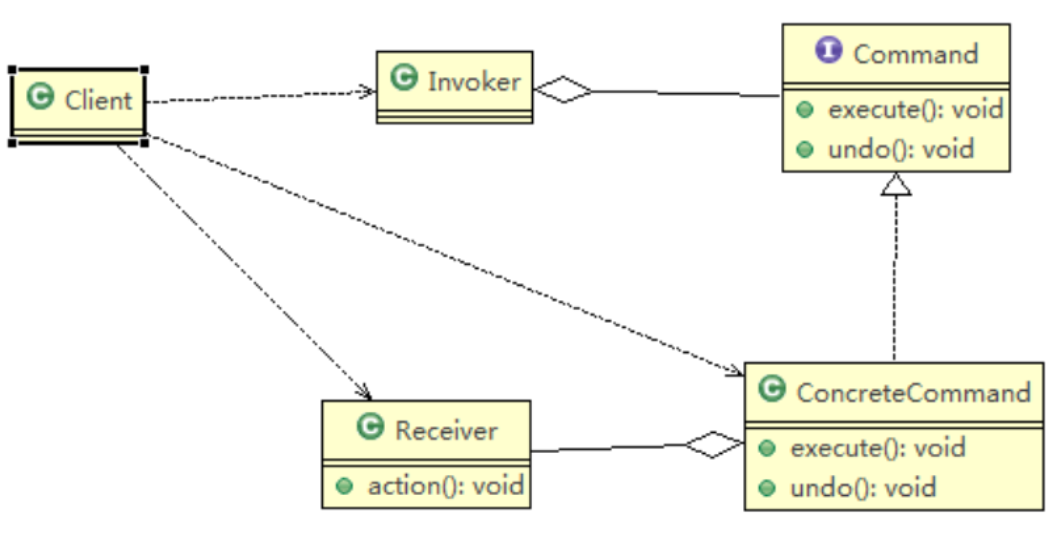
核心就是:将军发布命令,士兵去执行。
Invoker是调用者(将军),Receiver是被调用者(士兵), Command是命令,实现了Command接口,持有接收对象
-
Invoker 是调用者角色
-
Command: 是命令角色,需要执行的所有命令都在这里,可以是接口或抽象类
-
Receiver: 接受者角色,知道如何实施和执行一个请求相关的操作
-
ConcreteCommand: 将一个接受者对象与一个动作绑定,调用接受者相应的操作,实现execute
3.案例分析
业务场景 :
游戏的 发布 和 关闭 , 使用命令模式实现 , 分别针对 发布 , 关闭 , 各自定义一个命令类 ;
步骤:
1、游戏实体类Game:包含属性和方法
public class Game {
private String name;
public Game(String name) {
this.name = name;
}
public void open() {
System.out.println(this.name + " 开放");
}
public void close() {
System.out.println(this.name + " 关闭");
}
}
2、Command接口及其xxxCommand方法:命令接口及其实现
command接口
public interface Command {
void execute();
}Closecommand
/**
* @program: 设计模式
* @description: 关闭命令
* @author: WMS
* @create: 2024-11-19 20:36
**/
public class CloseCommand implements Command {
private Game game;
public CloseCommand(Game game) {
this.game = game;
}
@Override
public void execute() {
this.game.close();
}
}Opencommand
/**
* @program: 设计模式
* @description: 实现命令
* @author: WMS
* @create: 2024-11-19 20:34
**/
public class OpenCommand implements Command {
private Game game;
public OpenCommand(Game game) {
this.game = game;
}
@Override
public void execute() {
this.game.open();
}
}3、Manger:接受者,去循环执行命令
public class Manager {
private ArrayList<Command> commands = new ArrayList<Command>();
public void addCommand(Command command) {
commands.add(command);
}
public void executeCommand() {
for (Command c : commands) {
c.execute();
}
commands.clear();
}
}4、MangerTest:是Client,也是调用者,实现对命令的创建及调用
@Test
public void addCommand() {
//创建实体
Game test1 = new Game("test1");
//创建命令
OpenCommand openCommand = new OpenCommand(test1);
CloseCommand closeCommand = new CloseCommand(test1);
//发送命令
Manager manager = new Manager();//创建执行者
manager.addCommand(openCommand);//添加命令
manager.addCommand(closeCommand);//添加命令
manager.executeCommand();//执行命令
}4.总结
命令模式 优点 :
降低耦合 : 将 请求 调用者 与 请求 接收者 进行 解耦 ;
扩展性高 : 如果要 扩展新命令 , 直接 定义 新的命令对象 即可 ; 如果要 执行一组命令 , 发送一组命令 给接收者 即可 ;
命令模式 缺点 :
增加复杂度 : 扩展命令 会 导致 类的数量增加 , 增加了 系统实现的复杂程度 ;
需要针对每个命令 , 都要开发一个与之对应的命令类
命令模式的注意事项和细节
-
将<font color=red>发起请求的对象与执行请求的对象解耦</font>。发起请求的对象是调用者,调用者只要 调用命令对象的execute()方法就可以让接收者工
作,而不必知道具体的接收者对 象是谁、是如何实现的,命令对象会负责让接收者执行请求的动作,也就是说:” 请求发起者”和“请
求执行者”之间的解耦是通过命令对象实现的,命令对象起到 了纽带桥梁的作用。
-
容易设计一个命令队列。只要把命令对象放到列队,就可以多线程的执行命令
-
容易实现对请求的撤销和重做
-
命令模式不足:可能导致某些**系统有过多的具体命令类,增加了系统的复杂度,**这 点在在使用的时候要注意
-
**空命令也是一种设计模式,它为我们省去了判空的操作。**在上面的实例中,如果没有用空命令,我们每按下一个按键都要判空,这给我们编码带来一定的麻烦。
-
命令模式经典的应用场景:界面的一个按钮都是一条命令、模拟CMD(DOS命令) 订单的撤销/恢复、触发-反馈机制
6.4 责任链模式
6.4.1 概述
在现实生活中,常常会出现这样的事例:一个请求有多个对象可以处理,但每个对象的处理条件或权限不同。例如,公司员工请假,可批假的领导有部门负责人、副总经理、总经理等,但每个领导能批准的天数不同,员工必须根据自己要请假的天数去找不同的领导签名,也就是说员工必须记住每个领导的姓名、电话和地址等信息,这增加了难度。这样的例子还有很多,如找领导出差报销、生活中的“击鼓传花”游戏等。
定义:
又名职责链模式,为了避免请求发送者与多个请求处理者耦合在一起,将所有请求的处理者通过前一对象记住其下一个对象的引用而连成一条链;当有请求发生时,可将请求沿着这条链传递,直到有对象处理它为止。
6.4.2 结构
职责链模式主要包含以下角色:
- 抽象处理者(Handler)角色:定义一个处理请求的接口,包含抽象处理方法和一个后继连接。
- 具体处理者(Concrete Handler)角色:实现抽象处理者的处理方法,判断能否处理本次请求,如果可以处理请求则处理,否则将该请求转给它的后继者。
- 客户类(Client)角色:创建处理链,并向链头的具体处理者对象提交请求,它不关心处理细节和请求的传递过程。
使用步骤:
1、创建实体
2、创建抽象处理者,实现处理者属性、抽象树立方法
6.4.3 案例实现
现需要开发一个请假流程控制系统。请假一天以下的假只需要小组长同意即可;请假1天到3天的假还需要部门经理同意;请求3天到7天还需要总经理同意才行。
类图如下:
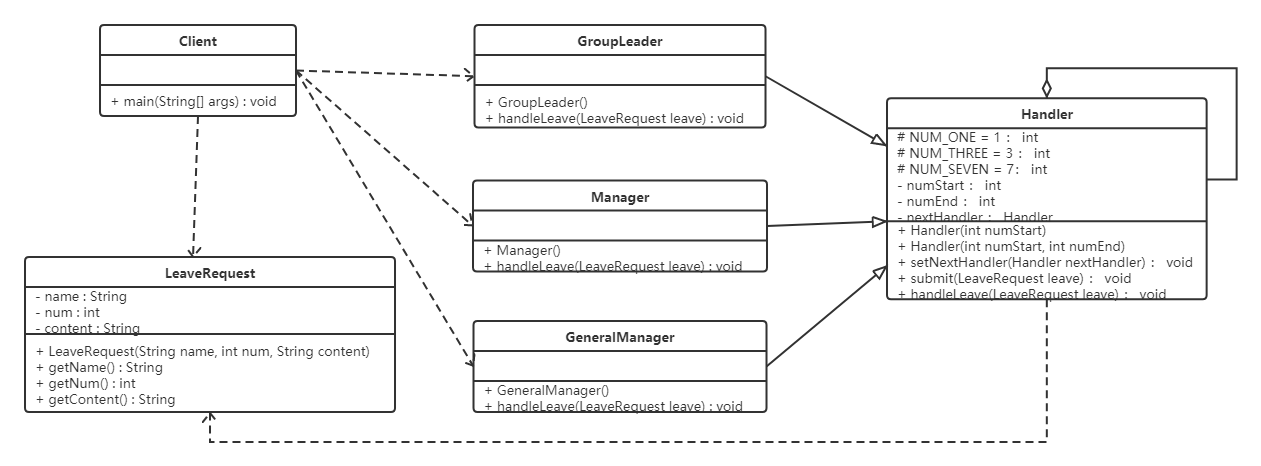
代码如下:
//请假条实体数据
public class LeaveRequest {
private String name;//姓名
private int num;//请假天数
private String content;//请假内容
public LeaveRequest(String name, int num, String content) {
this.name = name;
this.num = num;
this.content = content;
}
public String getName() {
return name;
}
public int getNum() {
return num;
}
public String getContent() {
return content;
}
}
//处理者抽象类
public abstract class Handler {
protected final static int NUM_ONE = 1;
protected final static int NUM_THREE = 3;
protected final static int NUM_SEVEN = 7;
//该领导处理的请假天数区间
private int numStart;
private int numEnd;
//领导上面还有领导(处理链)
private Handler nextHandler;
//设置上级领导(处理链的连接)
public void setNextHandler(Handler nextHandler){
this.nextHandler = nextHandler;
}
//设置请假天数范围 上不封顶
public Handler(int numStart) {
this.numStart = numStart;
}
//设置请假天数范围
public Handler(int numStart, int numEnd) {
this.numStart = numStart;
this.numEnd = numEnd;
}
//提交请假条
public final void submit(LeaveRequest leave){
if(0 == this.numStart){
return;
}
//如果请假天数达到该领导者的处理要求
if(leave.getNum() >= this.numStart){
this.handleLeave(leave);
//如果还有上级 并且请假天数超过了当前领导的处理范围
if(null != this.nextHandler && leave.getNum() > numEnd){
this.nextHandler.submit(leave);//继续提交
} else {
System.out.println("流程结束");
}
}
}
//各级领导处理请假条方法(抽象处理方法)
protected abstract void handleLeave(LeaveRequest leave);
}
//小组长(具体处理器A)
public class GroupLeader extends Handler {
public GroupLeader() {
//小组长处理1-3天的请假
super(Handler.NUM_ONE, Handler.NUM_THREE);
}
@Override
protected void handleLeave(LeaveRequest leave) {
System.out.println(leave.getName() + "请假" + leave.getNum() + "天," + leave.getContent() + "。");
System.out.println("小组长审批:同意。");
}
}
//部门经理(具体处理器B)
public class Manager extends Handler {
public Manager() {
//部门经理处理3-7天的请假
super(Handler.NUM_THREE, Handler.NUM_SEVEN);
}
@Override
protected void handleLeave(LeaveRequest leave) {
System.out.println(leave.getName() + "请假" + leave.getNum() + "天," + leave.getContent() + "。");
System.out.println("部门经理审批:同意。");
}
}
//总经理(具体处理器C)
public class GeneralManager extends Handler {
public GeneralManager() {
//部门经理处理7天以上的请假
super(Handler.NUM_SEVEN);
}
@Override
protected void handleLeave(LeaveRequest leave) {
System.out.println(leave.getName() + "请假" + leave.getNum() + "天," + leave.getContent() + "。");
System.out.println("总经理审批:同意。");
}
}
//测试类(调用方法)
public class Client {
public static void main(String[] args) {
//请假条来一张(创建实体)
LeaveRequest leave = new LeaveRequest("小花",5,"身体不适");
//各位领导(调用具体的处理器)
GroupLeader groupLeader = new GroupLeader();
Manager manager = new Manager();
GeneralManager generalManager = new GeneralManager();
//设置处理链顺序
groupLeader.setNextHandler(manager);//小组长的领导是部门经理
manager.setNextHandler(generalManager);//部门经理的领导是总经理
//之所以在这里设置上级领导,是因为可以根据实际需求来更改设置,如果实战中上级领导人都是固定的,则可以移到领导实现类中。
//提交申请
groupLeader.submit(leave);
}
}关键代码模版
// 处理器接口
abstract class Handler {
// 创建具体责任链实体
protected Handler nextHandler;
// setter方法
public void setNextHandler(Handler nextHandler) {
this.nextHandler = nextHandler;
}
// 责任链的抽象方法
public abstract void handleRequest(String request);
}
// 具体处理器A
class ConcreteHandlerA extends Handler {
// 具体处理器重写责任链方法
@Override
public void handleRequest(String request) {
if ("A".equals(request)) {
System.out.println("ConcreteHandlerA handled request: " + request);
} else if (nextHandler != null) {
nextHandler.handleRequest(request);
} else {
System.out.println("No handler for request: " + request);
}
}
}
// 具体处理器B
class ConcreteHandlerB extends Handler {
@Override
public void handleRequest(String request) {
if ("B".equals(request)) {
System.out.println("ConcreteHandlerB handled request: " + request);
} else if (nextHandler != null) {
nextHandler.handleRequest(request);
} else {
System.out.println("No handler for request: " + request);
}
}
}
// 客户端
public class Main {
public static void main(String[] args) {
// 创建具体责任链子链
Handler handlerA = new ConcreteHandlerA();
Handler handlerB = new ConcreteHandlerB();
// 设置责任链顺序
handlerA.setNextHandler(handlerB);
// 调用责任链顺序方法
handlerA.handleRequest("A"); // Output: ConcreteHandlerA handled request: A
handlerA.handleRequest("B"); // Output: ConcreteHandlerB handled request: B
handlerA.handleRequest("C"); // Output: No handler for request: C
}
}6.4.4 优缺点
1,优点:
-
降低了对象之间的耦合度
该模式降低了请求发送者和接收者的耦合度。
-
增强了系统的可扩展性
可以根据需要增加新的请求处理类,满足开闭原则。
-
增强了给对象指派职责的灵活性
当工作流程发生变化,可以动态地改变链内的成员或者修改它们的次序,也可动态地新增或者删除责任。
-
责任链简化了对象之间的连接
一个对象只需保持一个指向其后继者的引用,不需保持其他所有处理者的引用,这避免了使用众多的 if 或者 if···else 语句。
-
责任分担
每个类只需要处理自己该处理的工作,不能处理的传递给下一个对象完成,明确各类的责任范围,符合类的单一职责原则。
2,缺点:
- 不能保证每个请求一定被处理。由于一个请求没有明确的接收者,所以不能保证它一定会被处理,该请求可能一直传到链的末端都得不到处理。
- 对比较长的职责链,请求的处理可能涉及多个处理对象,系统性能将受到一定影响。
- 职责链建立的合理性要靠客户端来保证,增加了客户端的复杂性,可能会由于职责链的错误设置而导致系统出错,如可能会造成循环调用。
6.4.5 源码解析
在javaWeb应用开发中,FilterChain是职责链(过滤器)模式的典型应用,以下是Filter的模拟实现分析:
-
模拟web请求Request以及web响应Response
Javapublic interface Request{ } public interface Response{ } -
模拟web过滤器Filter
Javapublic interface Filter { public void doFilter(Request req,Response res,FilterChain c); } -
模拟实现具体过滤器
Javapublic class FirstFilter implements Filter { @Override public void doFilter(Request request, Response response, FilterChain chain) { System.out.println("过滤器1 前置处理"); // 先执行所有request再倒序执行所有response chain.doFilter(request, response); System.out.println("过滤器1 后置处理"); } } public class SecondFilter implements Filter { @Override public void doFilter(Request request, Response response, FilterChain chain) { System.out.println("过滤器2 前置处理"); // 先执行所有request再倒序执行所有response chain.doFilter(request, response); System.out.println("过滤器2 后置处理"); } } -
模拟实现过滤器链FilterChain
Javapublic class FilterChain { private List<Filter> filters = new ArrayList<Filter>(); private int index = 0; // 链式调用 public FilterChain addFilter(Filter filter) { this.filters.add(filter); return this; } public void doFilter(Request request, Response response) { if (index == filters.size()) { return; } Filter filter = filters.get(index); index++; filter.doFilter(request, response, this); } } -
测试类
Javapublic class Client { public static void main(String[] args) { Request req = null; Response res = null ; FilterChain filterChain = new FilterChain(); filterChain.addFilter(new FirstFilter()).addFilter(new SecondFilter()); filterChain.doFilter(req,res); } }
6.5 观察者模式
1.前言
观察者模式(又被称为发布-订阅(Publish/Subscribe)模式,属于行为型模式的一种,它定义了一种一对多的依赖关系,让多个观察者对象同时监听某一个主题对象。这个主题对象在状态变化时,会通知所有的观察者对象,使他们能够自动更新自己。
2.核心
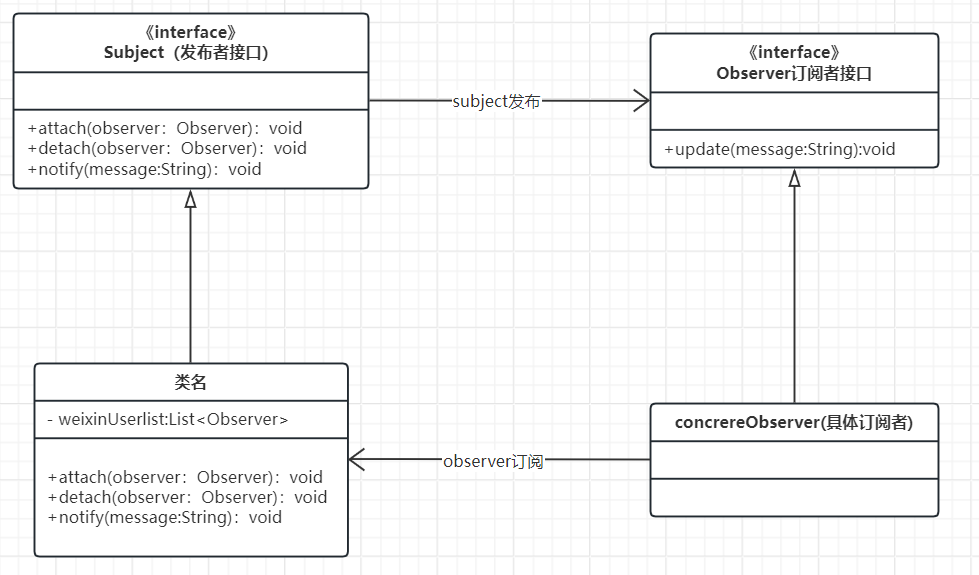
在观察者模式中有如下角色:
- Subject:抽象主题(抽象被观察者),抽象主题角色把所有观察者对象保存在一个集合里,每个主题都可以有任意数量的观察者,抽象主题提供一个接口,可以增加和删除观察者对象。
- ConcreteSubject:具体主题(具体被观察者),该角色将有关状态存入具体观察者对象,在具体主题的内部状态发生改变时,给所有注册过的观察者发送通知。
- Observer:抽象观察者,是观察者者的抽象类,它定义了一个更新接口,使得在得到主题更改通知时更新自己。
- ConcrereObserver:具体观察者,实现抽象观察者定义的更新接口,以便在得到主题更改通知时更新自身的状态。
3.案例分析
观察者模式这种发布-订阅的形式我们可以拿微信公众号来举例,假设微信用户就是观察者,微信公众号是被观察者,有多个的微信用户关注了程序猿这个公众号,当这个公众号更新时就会通知这些订阅的微信用户。好了我们来看看用代码如何实现:
抽象观察者(Observer)
里面定义了一个更新的方法:
public interface Observer {
public void update(String message);
}具体观察者(ConcrereObserver)
微信用户是观察者,里面实现了更新的方法:
public class WeixinUser implements Observer {
// 微信用户名
private String name;
public WeixinUser(String name) {
this.name = name;
}
@Override
public void update(String message) {
System.out.println(name + "-" + message);
}
}抽象被观察者(Subject)
抽象主题,提供了attach、detach、notify三个方法:
public interface Subject {
/**
* 增加订阅者
* @param observer
*/
public void attach(Observer observer);
/**
* 删除订阅者
* @param observer
*/
public void detach(Observer observer);
/**
* 通知订阅者更新消息
*/
public void notify(String message);
}
具体被观察者(ConcreteSubject)
微信公众号是具体主题(具体被观察者),里面存储了订阅该公众号的微信用户,并实现了抽象主题中的方法:
public class SubscriptionSubject implements Subject {
//储存订阅公众号的微信用户
private List<Observer> weixinUserlist = new ArrayList<Observer>();
@Override
public void attach(Observer observer) {
weixinUserlist.add(observer);
}
@Override
public void detach(Observer observer) {
weixinUserlist.remove(observer);
}
@Override
public void notify(String message) {
for (Observer observer : weixinUserlist) {
observer.update(message);
}
}
}客户端调用
public class Client {
public static void main(String[] args) {
SubscriptionSubject mSubscriptionSubject=new SubscriptionSubject();
//创建微信用户
WeixinUser user1=new WeixinUser("杨影枫");
WeixinUser user2=new WeixinUser("月眉儿");
WeixinUser user3=new WeixinUser("紫轩");
//订阅公众号
mSubscriptionSubject.attach(user1);
mSubscriptionSubject.attach(user2);
mSubscriptionSubject.attach(user3);
//公众号更新发出消息给订阅的微信用户
mSubscriptionSubject.notify("刘望舒的专栏更新了");
}
}结果
杨影枫-刘望舒的专栏更新了 月眉儿-刘望舒的专栏更新了 紫轩-刘望舒的专栏更新了
4.总结
用场景
- 关联行为场景,需要注意的是,关联行为是可拆分的,而不是“组合”关系。
- 事件多级触发场景。
- 跨系统的消息交换场景,如消息队列、事件总线的处理机制。
优点
解除耦合,让耦合的双方都依赖于抽象,从而使得各自的变换都不会影响另一边的变换。
缺点
在应用观察者模式时需要考虑一下开发效率和运行效率的问题,程序中包括一个被观察者、多个观察者,开发、调试等内容会比较复杂,而且在Java中消息的通知一般是顺序执行,那么一个观察者卡顿,会影响整体的执行效率,在这种情况下,一般会采用异步实现。
Android中的观察者模式
android源码中也有很多使用了观察者模式,比如OnClickListener、ContentObserver、android.database.Observable等;还有组件通讯库RxJava、RxAndroid、EventBus;在这里将拿我们最常用的Adapter的notifyDataSetChanged()方法来举例: 当我们用ListView的时候,数据发生变化的时候我们都会调用Adapter的notifyDataSetChanged()方法,这个方法定义在BaseAdaper中,我们来看看BaseAdaper的部分源码:
public abstract class BaseAdapter implements ListAdapter, SpinnerAdapter {
//数据集观察者
private final DataSetObservable mDataSetObservable = new DataSetObservable();
public boolean hasStableIds() {
return false;
}
public void registerDataSetObserver(DataSetObserver observer) {
mDataSetObservable.registerObserver(observer);
}
public void unregisterDataSetObserver(DataSetObserver observer) {
mDataSetObservable.unregisterObserver(observer);
}
/**
* 当数据集变化时,通知所有观察者
*/
public void notifyDataSetChanged() {
mDataSetObservable.notifyChanged();
}很明显BaseAdapter用的是观察者模式,BaseAdapter是具体被观察者,接下来看看mDataSetObservable.notifyChanged():
public class DataSetObservable extends Observable<DataSetObserver> {
public void notifyChanged() {
synchronized(mObservers) {
for (int i = mObservers.size() - 1; i >= 0; i--) {
mObservers.get(i).onChanged();
}
}
}我们看到了mObservers,这就是观察者的集合,这些观察者是在ListView通过setAdaper()设置Adaper时产生的:
@Override
public void setAdapter(ListAdapter adapter) {
if (mAdapter != null && mDataSetObserver != null) {
mAdapter.unregisterDataSetObserver(mDataSetObserver);
}
...
super.setAdapter(adapter);
if (mAdapter != null) {
mAreAllItemsSelectable = mAdapter.areAllItemsEnabled();
mOldItemCount = mItemCount;
mItemCount = mAdapter.getCount();
checkFocus();
//创建数据观察者
mDataSetObserver = new AdapterDataSetObserver();
//注册观察者
mAdapter.registerDataSetObserver(mDataSetObserver);
...
}接下来看看观察者AdapterDataSetObserver中处理了什么:
class AdapterDataSetObserver extends AdapterView<ListAdapter>.AdapterDataSetObserver {
@Override
public void onChanged() {
super.onChanged();
if (mFastScroller != null) {
mFastScroller.onSectionsChanged();
}
}
@Override
public void onInvalidated() {
super.onInvalidated();
if (mFastScroller != null) {
mFastScroller.onSectionsChanged();
}
}
}从上面的代码看不出什么,再看看AdapterDataSetObserver的父类AdapterView的AdapterDataSetObserver:
class AdapterDataSetObserver extends DataSetObserver {
private Parcelable mInstanceState = null;
@Override
public void onChanged() {
mDataChanged = true;
mOldItemCount = mItemCount;
mItemCount = getAdapter().getCount();
if (AdapterView.this.getAdapter().hasStableIds() && mInstanceState != null
&& mOldItemCount == 0 && mItemCount > 0) {
AdapterView.this.onRestoreInstanceState(mInstanceState);
mInstanceState = null;
} else {
rememberSyncState();
}
checkFocus();
//重新布局
requestLayout();
}
...
public void clearSavedState() {
mInstanceState = null;
}
}我们看到在onChanged()方法中调用了requestLayout()方法来重新进行布局。好了,看到这里我们都明白了,当ListView的数据发生变化时,我们调用Adapter的notifyDataSetChanged()方法,这个方法又会调用观察者们(AdapterDataSetObserver)的onChanged()方法,onChanged()方法又会调用requestLayout()方法来重新进行布局。
6.6 迭代子模式
1.前言
定义:
Provide a way to access the elements of an aggregate object sequentially without exposing its underlying representation. 提供一种顺序访问聚集/容器对象元素的方法,而又无须暴露聚集内部表象。
迭代器模式(Iterator Pattern)又称为 游标(Cursor)模式,是对象的行为模式。 迭代器模式 可以顺序地访问一个聚集中的元素,而又不会暴露聚集内部表象。也即 迭代器模式 可以为不同的容器提供一致的遍历行为,而不用关心容器内容元素组成结构。 迭代器模式 本质:抽离聚集对象迭代行为到迭代器种,提供一致访问接口。
2.核心
迭代子模式包含以下角色:
抽象迭代子(Iterator):这是一个抽象角色,它定义了遍历元素所需的接口。迭代器的主要职责是提供一种方法来访问聚合对象中的元素,同时隐藏了聚合对象的内部表示。迭代器通常包含诸如获取下一个元素、判断是否还有更多元素等操作。 具体迭代子(ConcreteIterator):这个角色实现了迭代器接口,负责具体的遍历逻辑。它通常维护一个指向当前元素的游标,并在遍历过程中更新该游标的位置。具体迭代器需要了解聚合对象的内部结构,以便正确遍历其元素。 聚合对象(Aggregate):这也是一个抽象角色,它定义了创建迭代器对象的接口。聚合对象通常包含一组元素,并提供一个方法来获取一个迭代器对象,以便外部可以遍历这些元素。聚合对象不需要暴露其内部表示,只需提供获取迭代器的接口即可。 具体聚合对象(ConcreteAggregate):这个角色实现了聚合接口,负责创建具体的迭代器对象。具体聚合通常包含一组具体的元素,并实现了获取迭代器的方法,该方法返回一个与具体聚合对象相匹配的迭代器实例。
3.案例分析
抽象聚合对象(定义集合的操作以及获取迭代器)
Aggregate
public interface Aggregate {
//添加元素
public void add(String str);
//删除元素
public void remove(String str);
//获取迭代器
public Iterator getIterator();
}抽象迭代对象(定义迭代器的操作)
Iterator
public interface Iterator {
//获取第一个元素
String first();
//获取下一个元素
String next();
//判定集合是否为空
boolean hasNext();
}具体聚合对象
ConcreteAggregate
public class ConcreteAggregate implements Aggregate{
private List<String> list = new ArrayList<String>();
@Override
public void add(String str) {
list.add(str);
}
@Override
public void remove(String str) {
list.remove(str);
}
//获取迭代器(核心部分)
@Override
public Iterator getIterator() {
return (new ConcreteIterator(list));
}
}具体迭代对象
ConcreteIterator
public class ConcreteIterator implements Iterator {
private List<String> list;
private int index;
public ConcreteIterator(List<String> list) {
this.list = list;
}
@Override
public String first() {
index =0;
String str = list.get(index);
return str;
}
@Override
public String next() {
String str = null;
if (this.hasNext()){
str = list.get(index++);
}
return str;
}
//判空
@Override
public boolean hasNext() {
if (index<list.size()) {
return true;
}
return false;
}
}客户端Client
public static void main(String[] args) {
Aggregate aggregate = new ConcreteAggregate();
aggregate.add("user1");
aggregate.add("user2");
aggregate.add("user3");
aggregate.add("user4");
Iterator iterator = aggregate.getIterator();
while (iterator.hasNext()) {
System.out.println(iterator.next());
}
System.out.println("get first element");
System.out.println("iterator.first() = " + iterator.first());
}4.总结
迭代子模式优缺点: 优点:
**多态迭代:**它为不同的聚合结构提供了一致的遍历接口,使得一个迭代接口可以访问不同的聚集对象。
简化聚集对象接口:通过将遍历逻辑封装在迭代器中,聚合对象的接口可以更加简洁和专一。聚合对象只需要提供一个创建迭代器的方
法,而无需暴露其内部结构和遍历逻辑。
**元素迭代功能多样化:**每个聚集对象都可以提供一个或多个不同的迭代器,这使得同种元素聚合结构可以有不同的迭代行为。
提高代码的可读性和可维护性:使用迭代子模式可以使代码更加清晰和易于理解。遍历逻辑被封装在迭代器中,使得聚合对象的代码更加
专注于其数据结构和核心功能。同时,由于迭代器的独立性,修改遍历逻辑时不会影响到聚合对象的代码,提高了代码的可维护性。
**支持多种遍历方式:**迭代子模式允许在不修改聚合对象的前提下增加新的遍历方式。通过实现不同的迭代器,可以方便地支持正序、逆
序、过滤等多种遍历需求。
缺点:
**实现复杂性:**对于简单的遍历,如数组或有序列表,使用迭代子模式可能会增加实现的复杂性。所以对于小型项目或简单的数据结构,使
用迭代子模式可能过于复杂和繁琐。
**类的数量增加:**每次新增一个集合类,都需要增加相应的迭代器类,这可能会导致类的个数成对增加,增加了系统的复杂性,增加代码的
复杂性和管理成本。
**性能开销:**在某些情况下,使用迭代子模式可能会引入一些性能开销。由于每次遍历都需要创建新的迭代器对象,这可能会增加内存消耗
和对象创建/销毁的开销。然而,这种开销通常是可以接受的,尤其是在需要灵活遍历聚合对象的情况下。
使用场景
**访问聚合对象内容而不暴露内部表示:**当需要访问一个聚合对象的内容,但不希望直接暴露其内部数据结构时,可以使用迭代子模式。通
过迭代器,可以在不了解聚合对象内部实现细节的情况下,遍历并访问其元素。
为聚合对象提供多种遍历方式:当需要为聚合对象提供不同的遍历方式时,如正向遍历、逆向遍历、跳跃遍历等,迭代子模式非常适用。
通过实现不同的迭代器,可以轻松支持多种遍历需求。
**统一遍历不同聚合结构:**当需要为不同类型的聚合结构提供一个统一的遍历接口时,迭代子模式可以发挥作用。无论是列表、栈、树还是
图等数据结构,都可以通过迭代器进行统一的遍历操作,从而简化代码和提高可维护性。
隐藏集合对象的内部结构:当需要隐藏集合对象的内部结构,只提供统一的遍历接口时,迭代子模式非常有用。这样,外部代码可以透明
地访问集合内部的数据,而无需了解集合的具体实现细节。
6.7 备忘录模式
1.前言
备忘录模式是一个非常简单的设计模式,简单到已经让我们忽略了这种设计模式的存在了。备忘录模式这个名字可能还是有人会觉得稍微有点陌生,但是它的另一个名字快照模式听起来可能心里就会有点明白这到底是一种什么设计模式了。接下来就让我们看看备忘录模式吧
什么是备忘录模式
备忘录模式(Memento Pattern)又称之为快照模式(Snapshop Pattern)或者令牌模式(Token Pattern),是指在不破坏封装的前提下,捕获一个对象的内部状态,并在对象之外保存这个状态,这样我们就可以在需要的时候将该对象恢复到原先保存的状态了,备忘录模式属于行为型模式。
备忘录模式可以为我们提供一种“后悔药”的机制,它通过存储系统中各个历史状态的快照,使得我们可以在任一时刻将系统回滚到历史状态。
2.核心
备忘录模式主要有3个角色:
发起人角色(Originator):负责创建一个备忘录,记录自身需要保存的状态,而且需要具备状态的回滚功能。
备忘录角色(Memento):用于存储Originator角色的内部状态,且可以防止Originator以外的对象进行访问。
备忘录管理员角色(Caretaker):负责存储,管理备忘录功能。且其本身应该无法对备忘录的内容进行访问。
3.案例分析
下面我们就以常见的富文本编辑器来编辑文章的功能为例来写一个简单的示例来看看备忘录模式是如何实现的。 1、首先建立一个类来保存最新文章信息:
@Data
@AllArgsConstructor
public class ArticleText {
private String title;
private String content;
private Date createTime;
//保存历史信息,将ArticleText的信息传入的副本中
public ArticleMemento saveText(){
ArticleMemento articleMemento = new ArticleMemento(this.title,this.title,this.createTime);
return articleMemento;
}
//获取历史信息
public void getArticleMemento(ArticleMemento articleMemento){
this.title = articleMemento.getTitle();
this.content = articleMemento.getContent();
this.createTime = articleMemento.getCreateTime();
}
}注意:这里面除了getter/setter方法之外还有一个方法用来备份,一个方法用来还原。
2、建立一个类用来保存历史数据,这个类的信息必须要和原始类一样,否则无法完全备份:
@Data
@AllArgsConstructor
public class ArticleMemento {
private String title;
private String content;
private Date createTime;
}3、然后还需要一个类来管理历史快照信息:
public class ArticleCaretaker {
//保存历史版本列表
private final List<ArticleMemento> mementos = new ArrayList<>();
//获取指定版本
public ArticleMemento getArticle(int index) {
return mementos.get(index);
}
//添加历史版本
public String setMementos(ArticleMemento memento){
mementos.add(memento);
return memento.toString();//返回添加的版本
}
}4、最后来一个测试类测试一下:
@Test
public void Demo_1(){
//创建管理版本工具类
ArticleCaretaker articleCaretaker = new ArticleCaretaker();
//创建原本
ArticleText text1 = new ArticleText("01", "我是小北", new Date());
System.out.println(String.format("原来的标题为【%s】,内容为【%s】",text1.getTitle(),text1.getContent()));
/*
1.先保存到副本中
2.再存入管理器的list集合中
*/
ArticleMemento articleMemento = text1.saveText();
articleCaretaker.setMementos(articleMemento);
//修改原本
text1 = new ArticleText("02", "我是小新", new Date());
System.out.println(String.format("修改后的标题为【%s】,内容为【%s】",text1.getTitle(),text1.getContent()));
//原本回滚
text1.getArticleMemento(articleCaretaker.getArticle(0));
System.out.println(String.format("回滚的标题为【%s】,内容为【%s】",text1.getTitle(),text1.getContent()));
}
/*
结果:
原来的标题为【01】,内容为【我是小北】
修改后的标题为【02】,内容为【我是小新】
回滚的标题为【01】,内容为【01】
*/4.总结
备忘录模式应用场景
备忘录模式作为一个程序员应该没有没使用过的,像比如svn,git等都是提供了历史版本的管理功能,这些就是备忘录模式的体现,像还
有富文本的编辑之类的都可以使用备忘录模式来进行实现,还有服务器的快照功能也可以是我们回退到历史状态。备忘录模式一般用于以
下场景:
1、需要保存历史快照的场景 2、希望在对象之外保存状态,且除了自己其他对象无法访问状态的具体保存内容
备忘录模式优缺点
优点:
1、简化了发起人的的职责,将状态的存储和获取进行了隔离,而且客户端无需关心状态的保存细节。
缺点:
1、消耗资源,如果每个快照的内容都非常大,会消耗大量内存。
6.8 状态模式
1.前言
状态模式在日常开发中是一个非常实用的模式,可以将你的代码逼格迅速提升一个档次,所以让我们开始今天的卓越之旅吧。
定义
当一个对象内在状态改变时允许改变其行为,这个对象看起来像是改变了其类。
定义对于初学者没啥用,因为字都认识却无法理解其中的含义。必须等学完了,回过头来看才能更加深刻的理解其含义
使用场景
你发现你的代码里面存在一个很长的if else列表,而这些分支都是因为不同状态下执行的操作不一样时考虑使用此模式
2.核心
类图
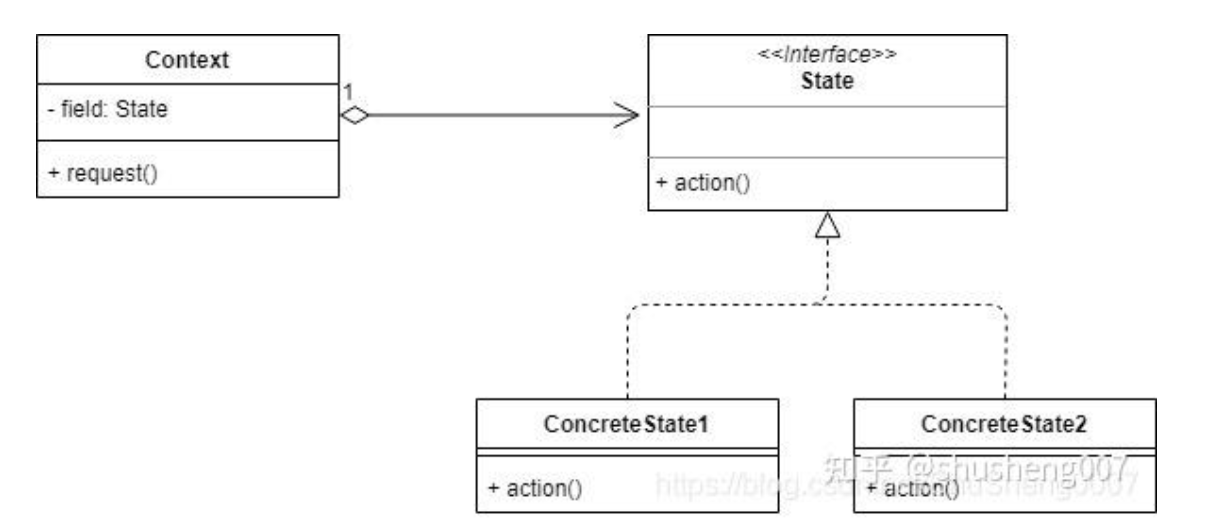
从上图可见,状态模式共有3个角色
State 是一个接口,封装了状态及其行为
ConcreteState X State的实现类,表示具体的状态
Context :保持并切换各个状态,其持有一个State的引用。它将依赖状态的各种操作委托给不同的状态对象执行。其负责与客户端交互
3.案例分析
最近王二狗又要过生日了,近两年他内心中是非常抗拒过生日的,因为每过一个生日就意味着自己又老一岁,离被辞退的35岁魔咒又近了一步。可惜时间是不以人的意志为转移的,任何人都阻止不了时间的流逝,所以该过还的过。令二狗比较欣慰的时,这次过生日老婆送了他一个自己一直想要的机械键盘作为生日礼物... 翠花于是在二狗生日前3天在京东上下了一个单...
自从下单以来,二狗天天看物流状态信息,心心念念着自己的机械键盘快点到...
这个物流系统就很适合使用状态模式来开发,因为此过程存在很多不同的状态,例如接单,出库,运输,送货,收货,评价等等。而订单在每个不同的状态下的操作可能都不一样,例如在接单状态下,商家就需要通知仓库拣货,通知用户等等操作,其他状态类似
下面是实例的UML类图
京东购买商品的商品状态信息,其中状态有很多种
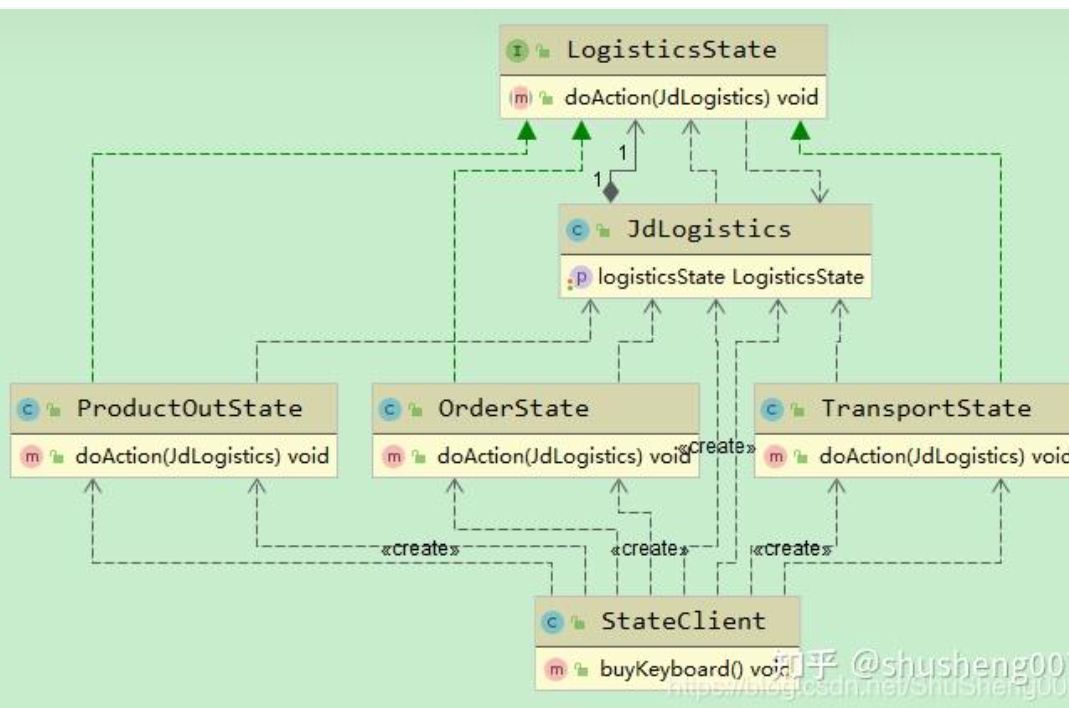
第一,定义一个状态接口
此接口定义各个状态的统一操作接口
public interface LogisticsState {
void doAction(JdLogistics context);
}第二,定义一个物流Context类
此类持有一个LogisticsState 的引用,负责在流程中保持并切换状态
@Data
public class JdLogistics {
private LogisticsState logisticsState;//将接口方法作为变量,达到聚合的目的,同时可以进行切换
public void doAction(){
//考虑到订单转态的行为有null行为,所以使用until工具包下的objects类中的requireNoNUll来返回NPE
/*源码
* public static <T> T requireNonNull(T obj) {
if (obj == null)
throw new NullPointerException();
return obj;
}
* */
Objects.requireNonNull(logisticsState);
logisticsState.doAction(this);
}
}第三,实现各种状态类
- 接单状态类,其需要实现
LogisticsState接口
public class OrderState implements LogisticsState {
@Override
public void doAction(JdLogistics context) {
System.out.println("商家已经接单,正在处理中...");
}
}- 出库状态类
public class ProductOutState implements LogisticsState {
@Override
public void doAction(JdLogistics context) {
System.out.println("商品已经出库...");
}
}依次类推,可以建立任意多个状态类
第四, 客户端使用
@Test
public void test() {
//模拟用户下单的过程
//1、后端先启动:创建订单管理类JdLogistics
//2、前端发送请求查看订单状态:创建各种订单类。达到if else的目的
/* 状态1*/
//1.
JdLogistics jdLogistics = new JdLogistics();
//2.
OrderState orderState = new OrderState();
//传入到管理器。切换状态
jdLogistics.setLogisticsState(orderState);
//管理器统一调动状态
jdLogistics.doAction();
/* 状态2*/
ProductOutState productOutState = new ProductOutState();
jdLogistics.setLogisticsState(productOutState);
jdLogistics.doAction();
}结果:
商家包装货物中 商家出库中
可见,我们将每个状态下要做的具体动作封装到了每个状态类中,我们只需要切换不同的状态即可。如果不使用状态模式,我们的代码中可能会出现很长的if else列表,这样就不便于扩展和修改了
4.总 结
技术要点总结
- 必须要有一个Context类,这个类持有State接口,负责保持并切换当前的状态。
- 状态模式没有定义在哪里进行状态转换,本例是在Context类进行的,也有人在具体的State类中转换
当使用Context类切换状态时,状态类之间互相不认识,他们直接的依赖关系应该由客户端负责。 例如,只有在接单状态的操作完成后才应该切换到出库状态,那么出库状态就对接单状态有了依赖,这个依赖顺序应该由客户端负责,而不是在状态内判断。
当使用具体的State类切换时,状态直接就可能互相认识,一个状态执行完就自动切换到了另一个状态去了
优缺点
优点
- 增强了程序的可扩展性,因为我们很容易添加一个State
- 增强了程序的封装性,每个状态的操作都被封装到了一个状态类中
缺点
类变多了
状态模式与策略模式
状态模式与策略模式的UML类图都是一样的,从表面上看他们非常相似。特别是将状态切换任务放在Context中做的时候就更像了,但是其背后的思想却非常不同。
- 策略模式定义了一组可互相代替的算法,这一组算法对象完成的是同一个任务,只是使用的方式不同,例如同样是亿万富翁,马云通过卖东西实现,而王思聪通过继承实现。
- 状态模式不同的状态完成的任务完全不一样。
6.9 访问者模式(Visitor Pattern)
1.前言
访问者模式可以说是GOF23中设计模式中最复杂的一个,但日常开发中使用频率却不高,所以说上帝喜欢简洁!增删改查虽然简单,却是大部分程序员日常主要工作,是可以混饭吃的家伙式。你技术再牛逼,企业用不到,那对于企业来说也没屌用,所以说合适的才是最好的。但不常用不等于没有用,这一点的认识到。
访问者模式试图解决如下问题: 一个类农场里面包含各种元素,例如有大雁,狗子,鸭子。而每个元素的操作却经常变换,一会让大雁排成一字,一会让大雁排成人字。当大雁排成一字的时候狗子要排成S形状,鸭子要排成B形状,当大雁排成人字时候狗子要叫两声,鸭子要跳起来...。但对农场这类有要求,第一:可以迭代这些元素,第二:里面的元素不能频繁变动,你不能一会把鸭子杀了吃了,一会又买回一匹马...,如果是这样的话就不适合使用Visitor模式
如果我们不采用设计模式,那么就要频繁的修改这些元素类,违背了开闭原则,降低代码的可维护和扩展性。
和策略模式很像
2.核心
定义
封装一些作用于某种数据结构中的各元素的操作,它可以在不改变这个数据结构的前提下定义作用于其内部各个元素的新操作
使用场景
当你有个类,里面的包含各种类型的元素,这个类结构比较稳定,不会经常增删不同类型的元素。而需要经常给这些元素添加新的操作的时候,考虑使用此设计模式。
3.案例分析
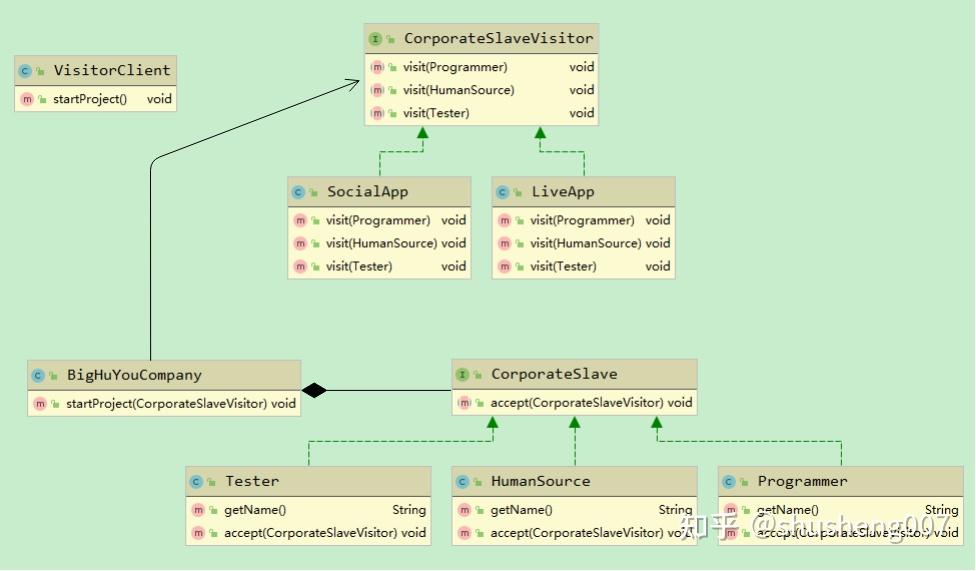
Visitor包含5个角色
- ObjectStructure
这个角色就是我们的对象结构,对应上面的大忽悠科技有限公司:BigHuYouCompany。此对象结构包含各种元素,而且要求元素稳定且可以迭代访问这些元素。
- Visitor
大名鼎鼎的访问者,它是一个接口。里面定义了与元素对应的visite(Element)方法,一般是有几个元素就相应的有几个visite方法。
- ConcreteVisitor
visitor的实现类
- Element
是一个接口,代表在ObjectStructure里面的元素。里面定义了一个accept(Visiotr)的方法,通过此方法元素可以将自己交给Visitor访问。
- ConcreteElement
element 的实现类
这个例子可以理解为:一个公司(visitor)有一个部门(element)及部门人员(ConcreteElement),这个部门的行为(ConcreteVisitor)可以进行组合(ObjectStructure)
实例
王二狗刚参加工作那会由于社会经验不足误入了一个大忽悠公司,公司老板不舍得花钱就给公司招了3个人,一个Hr,一个程序员,一个测试,但关键是老板总想追风口,啥都想做,一会社交,一会短视频。二狗多次提出说人太少,申请加几个人,至少加个保洁阿姨啊,每天都自己打扫卫生,累屁了。每到此时老板就画大饼:你现在刚毕业正是要奋斗的时候,此时不奋斗什么时候奋斗?过两年公司上市了,你作为元老就财富自由拉...balabala
这个场景就很适合使用访问者模式:
大忽悠公司结构很稳定,老板舍不得花钱招人,总共就那么3个人,还是3种角色,即只有3个元素。 大忽悠公司老板想法多,这就要求这3个人承担各种新技能,即不断的给元素增加新的算法。
第一步:构建Element
毕竟改变的是元素的算法,所以这里我们先构建元素。
社畜类只有一个accept方法,它需要一个访问者接口类型的参数
public interface CorporateSlave {
void accept(CorporateSlaveVisitor visitor);
}构建3个社畜的实现类:
- 程序员:
public class Programmer implements CorporateSlave {
private String name;
public Programmer(String name) {
this.name = name;
}
public String getName() {
return name;
}
@Override
public void accept(CorporateSlaveVisitor visitor) {
visitor.visit(this);
}
}- 测试:
public class Tester implements CorporateSlave {
private String name;
public Tester(String name) {
this.name = name;
}
public String getName() {
return name;
}
@Override
public void accept(CorporateSlaveVisitor visitor) {
visitor.visit(this);
}
}- 人力
同上,省略
...注意在element类里面将自己传递给visitor的visit()方法
@Override
public void accept(CorporateSlaveVisitor visitor) {
visitor.visit(this);
}第二步:构建ObjectStructure
BigHuYouCompany 类里面需要包含相对稳定的元素(大忽悠老板就招这3个人,再也不肯招人),而且要求可以对这些元素迭代访问。此处我们以集合存储3位员工。
/**
* Copyright (C) 2021 ShuSheng007
* 完全享有此软件的著作权
*
* @author ShuSheng007
* @time 2021/6/7 23:01
* @description
*/
public class BigHuYouCompany {
private List<CorporateSlave> employee= new ArrayList<>();
public BigHuYouCompany() {
employee.add(new Programmer("王二狗"));
employee.add(new HumanSource("上官无需"));
employee.add(new Tester("牛翠花"));
}
public void startProject(CorporateSlaveVisitor visitor){
for (CorporateSlave slave : employee) {
slave.accept(visitor);
}
}
}第三步:构建Visitor
Visitor 接口里面一般会存在与各元素对应的visit方法,例如此例我们有3个角色,所以这里就有3个方法。
/**
* Copyright (C) 2021 ShuSheng007
* 完全享有此软件的著作权
*
* @author ShuSheng007
* @time 2021/6/7 21:54
* @description
*/
public interface CorporateSlaveVisitor {
void visit(Programmer programmer);
void visit(HumanSource humanSource);
void visit(Tester tester);
}Visitor实现类
因为老板觉得社交是人类永恒的需求,所以开始想做社交App,他觉得他能成为微信第二。
这就相当于要为每一个元素定义一套新的算法,让程序员仿照微信开发设计app,让测试完成即时通信的测试,让人力发软文。
public class SocialApp implements CorporateSlaveVisitor {
@Override
public void visit(Programmer programmer) {
System.out.println(String.format("%s: 给你一个月,先仿照微信搞个类似的APP出来,要能语音能发红包,将来公司上市了少不了你的,好好干...",programmer.getName()));
}
@Override
public void visit(HumanSource humanSource) {
System.out.println(String.format("%s: 咱现在缺人,你暂时就充当了陪聊吧,在程序员开发APP期间,你去发发软文,积攒点粉丝...",humanSource.getName()));
}
@Override
public void visit(Tester tester) {
System.out.println(String.format("%s: 这是咱创业的第一炮,一定要打响,测试不能掉链子啊,不能让APP带伤上战场,以后给你多招点人,你就是领导了...",tester.getName()));
}
}过了一段时间,老板又觉的短视频很火,又要做短视频,这就要求给每一员工增加一套新的算法。
public class LiveApp implements CorporateSlaveVisitor {
@Override
public void visit(Programmer programmer) {
System.out.println(String.format("%s: 最近小视频很火啊,咱能不能抄袭下抖音,搞他一炮,将来公司上市了,你的身价至少也是几千万,甚至上亿...",programmer.getName()));
}
@Override
public void visit(HumanSource humanSource) {
System.out.println(String.format("%s: 咱公司就数你长得靓,哪天化化妆,把你的事业线适当露一露,要是火了你在北京买房都不是梦...",humanSource.getName()));
}
@Override
public void visit(Tester tester) {
System.out.println(String.format("%s: 你也开个账户,边测试边直播,两不耽误...",tester.getName()));
}
}再过段时间老板可能要开KTV,程序员王二狗可能要下海当鸭子,其他两位也需要解锁新技能...
客户端使用
public class VisitorClient {
public void startProject(){
BigHuYouCompany bigHuYou= new BigHuYouCompany();
//可以很轻松的更换Visitor,但是要求BigHuYouCompany的结构稳定
System.out.println("-----------------启动社交APP项目--------------------");
bigHuYou.startProject(new SocialApp());
System.out.println("-----------------启动短视频APP项目--------------------");
bigHuYou.startProject(new LiveApp());
}
}输出:
-----------------启动社交APP项目--------------------
王二狗: 给你一个月,先仿照微信搞个类似的APP出来,要能语音能发红包,将来公司上市了少不了你的,好好干...
上官无需: 咱现在缺人,你暂时就充当了陪聊吧,在程序员开发APP期间,你去发发软文,积攒点粉丝...
牛翠花: 这是咱创业的第一炮,一定要打响,测试不能掉链子啊,不能让APP带伤上战场,以后给你多招点人,你就是领导了...
-----------------启动短视频APP项目--------------------
王二狗: 最近小视频很火啊,咱能不能抄袭下抖音,搞他一炮,将来公司上市了,你的身价至少也是几千万,甚至上亿...
上官无需: 咱公司就数你长得靓,哪天化化妆,把你的事业线适当露一露,要是火了你在北京买房都不是梦...
牛翠花: 你也开个账户,边测试边直播,两不耽误...你看虽然大忽悠老板的需求变化这么快,但至始至终我们只是在增加新的Visitor实现类,而没有去修改任何一个Element类,这就很好的符合了开闭原则。
4.总结
小结:
- 准确识别出Visitor实用的场景,如果一个对象结构不稳定决不可使用,不然在增删元素时改动将非常巨大。
- 对象结构中的元素要可以迭代访问
- Visitor里一般存在与元素个数相同的visit方法。
- 元素通过
accept方法通过this将自己传递给了Visitor。
双分派(dispatch)
访问者模式存在一个叫"伪动态双分派”的技术,这个还是比较难懂的,访问者模式之所以是最复杂的设计模式与其有很大的关系。
什么叫分派?根据对象的类型而对方法进行的选择,就是分派(Dispatch)。
发生在编译时的分派叫静态分派,例如重载(overload),发生在运行时的分派叫动态分派,例如重写(overwrite)。
单分派与多分派
- 单分派
依据单个宗量进行方法的选择就叫单分派,Java 动态分派只根据方法的接收者一个宗量进行分配,所以其是单分派
- 多分派
依据多个宗量进行方法的选择就叫多分派,Java 静态分派要根据方法的接收者与参数这两个宗量进行分配,所以其是多分派
好了,理论的只是罗列出来了,那具体到访问者模式是个什么情况呢?
先看在BigHuYouCompany类里的分派代码:slave.accept(visitor); 中accept方法的分派是由slave的运行时类型决定的。若slave是Programer就执行Programer的accept方法。若slave是Tester那么就执行Tester的accept方法。
public void startProject(CorporateSlaveVisitor visitor){
for (CorporateSlave slave : employee) {
slave.accept(visitor);
}
}通过此步骤就完成了一次动态单分派。
再看一下具体的Element里的分派代码:visitor.visit(this); 中visit方法的分派是由参数 this的运行时类型决定的。若this是Programer就执行Visitor中的visit(Programer)方法。若slave是Tester那么就执行Visitor的visit(Tester)方法。
@Override
public void accept(CorporateSlaveVisitor visitor) {
visitor.visit(this);
}通过这一步又完成了一次动态单分派。
两次动态单分派结合起来就完成了一次伪动态双分派,为什么叫伪动态装派呢?因为在Java中动态分派是单分派的,而此处是通过两次动态单分派达到了双分派的效果,所以说是伪的!
优缺点
优点
- 使得给结构稳定的对象增加新算法变得容易,提搞了代码的可维护性,可扩展性。
缺点
- 太复杂,特别是伪动态双分派,不仔细理解很难想清楚。
6.10 中介模式(Mediator)
参考文章:https://blog.csdn.net/m0_51176516/article/details/138089256
1.前言
概念
- 中介者模式(Mediator Pattern),是一种对象行为型模式。该模式的主要目的是定义一个中介对象来封装一系列对象之间的交互,使原有对象之间的耦合变得松散,并且可以独立地改变它们之间的交互。
本质就是将多个对象用一个“中介对象”统一管理,管理什么呢?注册服务,注销服务,发送命令服务。
现实的例子:智能家居管理系统,统一管理子设备,并且发送命令
2.核心
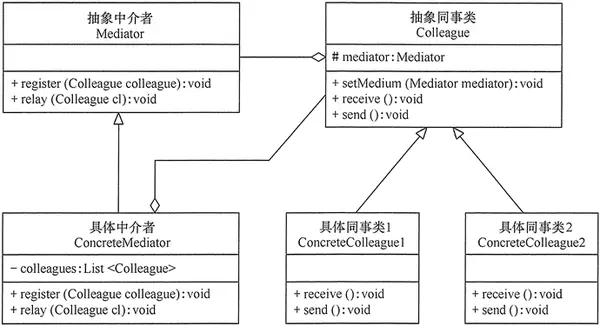
抽象中介者(Mediator):这是中介者模式的核心接口,它定义了同事对象注册和信息转发的抽象方法。这个角色的主要职责是声明并
规范中介者的操作,以便具体中介者能够实现这些操作来协调同事对象之间的交互。
具体中介者(Concrete Mediator):这个角色实现了抽象中介者接口,并具体定义了一个管理同事对象的列表。它负责协调各个同事角
色之间的交互关系,因此依赖于同事角色。
抽象同事类(Colleague):这个角色定义了同事类的接口,它包含了保存中介者对象的方法和提供同事对象交互的抽象方法。这个角色
的目的是实现所有相互影响的同事类的公共功能。
具体同事类(Concrete Colleague):这是抽象同事类的实现者。当具体同事类需要与其他同事对象交互时,它会通过中介者对象来进
行后续的交互,而不是直接与其他同事对象通信。
本质就是两个接口:中介和同事
其中同事是拥有相同注册、发送命令的方法。所以用抽象接口统一管理
中介就是使用list集合来统一管理同事接口,然后add同事,转发同事的命令
使用接口的本质就是:中介和同事可以有多个,那么用接口的方法来扩展最好不过
3.案例分析
3.1 示例1-聊天室系统
- 在这个场景中,每个用户(客户端)都可以看作是一个同事类,而聊天室服务器则充当中介者的角色。用户之间不需要直接通信,而是通过服务器来转发消息。
import java.util.ArrayList;
import java.util.List;
// 聊天室服务器,作为中介者
class ChatRoom {
private List<User> users = new ArrayList<>();
// 用户加入聊天室
public void registerUser(User user) {
users.add(user);
user.setChatRoom(this);
System.out.println(user.getName() + " has joined the chat room.");
}
// 用户离开聊天室
public void unregisterUser(User user) {
users.remove(user);
System.out.println(user.getName() + " has left the chat room.");
}
// 发送消息给所有用户
public void broadcast(User sender, String message) {
for (User user : users) {
if (!user.equals(sender)) {
user.receive(sender.getName() + ": " + message);
}
}
}
}
// 用户(同事类)
class User {
private String name;
private ChatRoom chatRoom;
public User(String name) {
this.name = name;
}
public String getName() {
return name;
}
public void setChatRoom(ChatRoom chatRoom) {
this.chatRoom = chatRoom;
}
// 用户发送消息
public void send(String message) {
chatRoom.broadcast(this, message);
}
// 用户接收消息
public void receive(String message) {
System.out.println(this.name + " received: " + message);
}
}
// 聊天室客户端模拟
public class ChatRoomDemo {
public static void main(String[] args) {
ChatRoom chatRoom = new ChatRoom();
User user1 = new User("Alice");
User user2 = new User("Bob");
User user3 = new User("Charlie");
chatRoom.registerUser(user1);
chatRoom.registerUser(user2);
chatRoom.registerUser(user3);
// Alice 发送消息
user1.send("Hello everyone!");
// Bob 发送消息
user2.send("Hi Alice, how are you?");
// Charlie 离开聊天室
chatRoom.unregisterUser(user3);
// Alice 再次发送消息,Charlie 不再接收
user1.send("Charlie, are you there?");
}
}
将看到如下输出:
Alice has joined the chat room. Bob has joined the chat room. Charlie has joined the chat room. Bob received: Alice: Hello everyone! Charlie received: Alice: Hello everyone! Alice received: Bob: Hi Alice, how are you? Charlie received: Bob: Hi Alice, how are you? Charlie has left the chat room. Bob received: Alice: Charlie, are you there?
在这个例子中,ChatRoom 类充当了中介者的角色,它维护了一个用户列表,并提供了注册用户、注销用户以及广播消息的方法。User 类代表了聊天室中的用户,每个用户都有一个名字,并且可以发送和接收消息。用户通过调用 send 方法来发送消息,而消息则通过 ChatRoom 的 broadcast 方法广播给所有其他用户。 在 main 方法中,我们创建了一个 ChatRoom 实例和三个 User 实例,并模拟了用户加入聊天室、发送消息以及离开聊天室的过程。 这个简单的例子展示了中介者模式在聊天室系统中的应用,通过中介者(聊天室服务器)来管理用户之间的通信,降低了用户之间的耦合度,使得系统更加灵活和易于维护。在实际应用中,聊天室系统会更加复杂,可能需要处理更多的功能,如用户身份验证、消息历史记录、私有聊天等,但中介者模式的基本思想仍然适用。
4.总结
优缺点
主要作用
降低对象之间的耦合性,并简化它们之间的通信。
优点
**实现解耦合:**各个对象不再直接相互依赖,而只依赖于中介者,这显著降低了类之间的耦合性。
**简化交互:**中介者模式简化了对象之间的交互过程。在复杂的系统中,对象之间可能存在大量的交互关系,如果直接进行通信,将导致代
码复杂且难以维护。通过中介者进行集中管理,可以将复杂的交互逻辑封装在中介者内部,简化了对象之间的通信过程,使得代码更加清
晰和易于理解。
**可扩展性:**中介者模式使得系统更加易于扩展。当需要添加新的对象或新的交互关系时,只需要修改中介者的代码,而无需修改其他对象
的代码。这降低了系统的扩展难度,提高了系统的可扩展性。
**统一控制:**中介者模式实现了对交互关系的统一控制。通过中介者,可以对对象之间的交互进行全局的管理和协调,确保交互的正确性和
一致性。这有助于避免由于对象之间的直接通信而导致的混乱和错误。
缺点
**中介者可能变得过于复杂:**随着系统中同事类数量的增加,中介者需要管理的交互关系也会变得更为复杂。这可能导致中介者类的逻辑变
得庞大且难以维护,增加了系统的复杂性。
可能导致系统性能下降:由于所有对象间的交互都需要通过中介者进行,当交互频繁或涉及大量数据时,中介者可能成为性能瓶颈,导致
系统响应速度变慢。
**降低了系统的透明度:**由于交互逻辑被封装在中介者内部,外部对象无法直接了解其他对象的交互细节。这降低了系统的透明度,使得理
解和调试系统变得更加困难。
**对中介者的依赖性强:**同事类依赖于中介者进行交互,如果中介者出现问题或无法正常工作,整个系统可能会受到影响。这增加了系统的
风险,需要确保中介者的稳定性和可靠性。
6.11 解释器模式
1.前言
在软件开发中,会遇到有些问题多次重复出现,而且有一定的相似性和规律性。如果将它们归纳成一种简单的语言,那么这些问题实例将
是该语言的一些句子,这样就可以用“编译原理”中的解释器模式来实现了。
虽然使用解释器模式的实例不是很多,但对于满足以上特点,且对运行效率要求不是很高的应用实例,如果用解释器模式来实现,其效果
是非常好的,本文将介绍其工作原理与使用方法。
2.核心
Java解释器模式是一种行为设计模式,它定义了一种语言和该语言的解释器,使得可以使用该语言来表达一些特定的操作。该模式适用于
需要解释一些特定语言的场景,例如编译器、表达式计算器等。给分析对象定义一个语言,并定义该语言的文法表示,再设计一个解析器
来解释语言中的句子。也就是说,用编译语言的方式来分析应用中的实例。这种模式实现了文法表达式处理的接口,该接口解释一个特定
的上下文。 在Java中,可以使用抽象语法树(AST)来表示语言表达式,并使用解释器来执行这些表达式。解释器模式通常包括以下几个组件:
- 抽象表达式(Abstract Expression):定义了一个抽象的解释器接口,该接口包含了解释器需要实现的方法。
- 终结符表达式(Terminal Expression):实现了抽象表达式接口的终结符,用于表示语言中的基本操作或值。
- 非终结符表达式(Non-Terminal Expression):实现了抽象表达式接口的非终结符,用于表示语言中的复杂操作。
- 上下文(Context):包含了解释器需要的一些全局信息,例如变量、函数等。
- 解释器(Interpreter):使用上述组件来解释语言表达式,并执行相应的操作。
3.案例分析
// 抽象表达式角色
interface Expression {
int interpret(Context context);
}
// 终结符表达式角色
class TerminalExpression implements Expression {
private int value;
public TerminalExpression(int value) {
this.value = value;
}
@Override
public int interpret(Context context) {
return value;
}
}
// 非终结符表达式角色
class NonterminalExpression implements Expression {
private Expression left;
private Expression right;
public NonterminalExpression(Expression left, Expression right) {
this.left = left;
this.right = right;
}
@Override
public int interpret(Context context) {
// 实现相应的逻辑,例如加法
return left.interpret(context) + right.interpret(context);
}
}
// 环境角色
class Context {
// 可能包含解释器运行需要的全局信息
}
// 客户端代码
public class InterpreterPatternExample {
public static void main(String[] args) {
// 创建表达式对象
Expression expr = new NonterminalExpression(
new TerminalExpression(10),
new TerminalExpression(20)
);
// 执行解释操作
Context context = new Context();
int result = expr.interpret(context);
System.out.println("解释器计算结果: " + result); // 输出 30
}
}4.总结
场景:
- 解释器模式适用场景 : 某个 特定类型问题 发生频率 足够高 ;
- 日志处理 : 使用 脚本语言 或 编程语言 处理日志时 , 有很多服务 会产生 大量的日志 , 需要 对日志进行解析 , 生成报表 ;各个服务的日志格式不同 , 数据中的要素相同 , 这种情况下 , 通过程序解决上述问题 , 主要的解决方案就是使用解释器模式 ;
Spring 框架中 SpelExpressionParser 就使用解释器模式。日常项目中 , 解释器模式使用情况很少 ;解释器一般是 开源包 , 如 Express4J , JEP ;
优点:
- 1.扩展性好。由于在解释器模式中使用类来表示语言的文法规则,因此可以通过继承等机制来改变或扩展文法
- 2.容易实现。在语法树中的每个表达式节点类都是相似的,所以实现其文法较为容易
不足:
- 1.执行效率较低。解释器模式中通常使用大量的循环和递归调用,当要解释的句子较复杂时,其运行速度很慢,且代码的调试过程也比较麻烦。
- 2.会引起类膨胀。解释器模式中的每条规则至少需要定义一个类,当包含的文法规则很多时,类的个数将急剧增加,导致系统难以管理与维护。
- 3.可应用的场景比较少。在软件开发中,需要定义语言文法的应用实例非常少,所以这种模式很少被使用到